-
-
Home
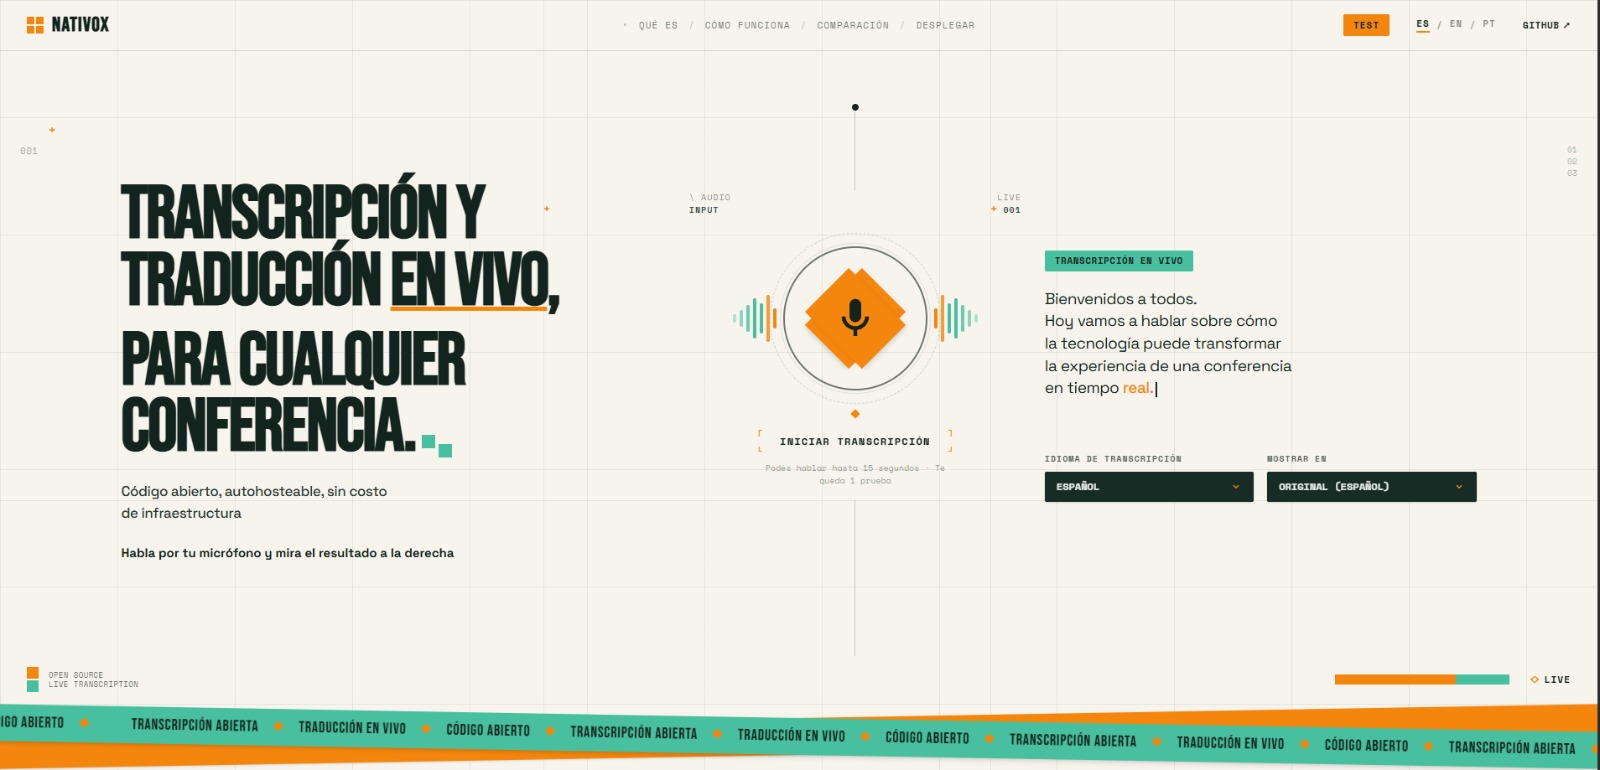
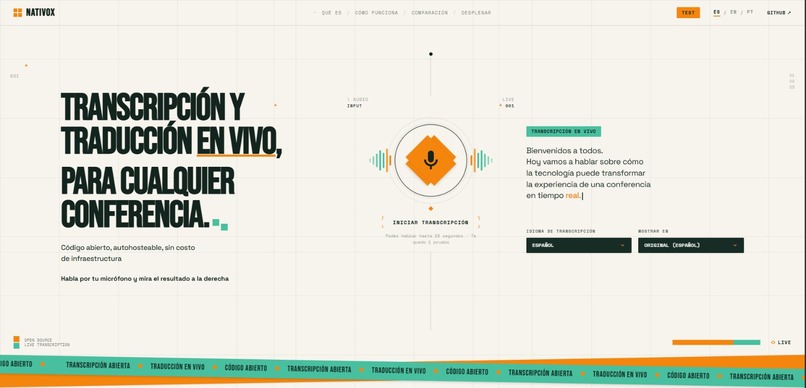
Nativox: subtítulos y traducción en vivo para conferencias, en tu propia cuenta de Cloudflare
Qué me inspiró
En las conferencias con varias salas e idiomas, los subtítulos y la traducción son caros o directamente no existen. Los intérpretes cuestan, los servicios de IA piden API keys y cobran por hora, y casi todo depende de que alguien esté al lado de cada computadora. Quise algo que un organizador pueda desplegar con un clic, sin claves y sin pagar por sala.
Qué hace
- Transcribe y traduce en vivo entre español, inglés y portugués.
- Muestra los subtítulos en la pantalla del escenario, en vMix/OBS (fondo transparente) y en el celular de la audiencia.
- Corre en el navegador, gratis y sin internet. Usa Whisper large-v3 turbo y Bergamot (o TranslateGemma) sobre la placa de video, con WebGPU. Como opción, hay un modo en la nube con Workers AI.
- "Evaluar esta computadora" mide el equipo y recomienda versión de Whisper, nivel de velocidad y si conviene la nube.
- Glosario técnico en tres capas: guía a Whisper, corrige lo transcripto y protege los términos al traducir.
- Calendario por sala: cada charla guarda su transcripción, que se exporta a
.txt,.srto.vtt. - Corrección a mano en vivo: se puede corregir una frase mientras se transcribe, y las correcciones se recuerdan en el glosario.
- Avisos a Discord con un botón para reiniciar la sala desde el celular.
- Cada organizador despliega su propia instancia, y nada de sus eventos pasa por mí.
Cómo lo construí
- Interfaz y servidor: React 19, Vite y TypeScript estricto. El servidor es un solo Worker de Cloudflare con D1, Durable Objects (WebSocket Hibernation) y Workers AI.
- Transcripción y traducción: el audio se corta en pausas, se transcribe con contexto y se traduce con el glosario protegido. Los subtítulos se generan una vez por sala y el Durable Object los reparte, así que cada espectador extra no suma costo de IA.
- Arquitectura: módulos reutilizables con reglas de importación que hace cumplir el lint, cero código duplicado y más de 290 pruebas automáticas.
- Dos repositorios: el producto open source (MIT) y una landing aparte.
Lo que aprendí
- Cuántas salas aguanta una computadora se estima así:
$$ N_{\text{salas}} \approx \left\lfloor \frac{T_{\text{frase}}}{T_{\text{pasada}}} \right\rfloor $$
Con frases de unos 6 s y una pasada de ~1 s, entran varias salas. Con ~3 s, entran una o dos.
- El costo en la nube es lineal:
$$ \text{costo} \approx h_{\text{sala}} \times \$0{,}037 $$
con una cuota gratis diaria.
- Lo medido en una placa AMD sin f16, con un guion sintético: WER de 1,4 %, 56 de 56 términos técnicos bien traducidos con el glosario protegido, y unos 5,4 s hasta ver el subtítulo traducido.
Desafíos
- Whisper inventa texto en los silencios. Lo resolví con un filtro de alucinaciones y un corte de audio en pausas.
- Una placa modesta no llega con texto provisorio. Armé la barra de velocidad y la evaluación del equipo para elegir el nivel según la máquina.
- Cortes de frase en medio de un término ("Workers Day" / "de AI"). Los corrige una unión con la línea anterior.
- Cloudflare no enciende la dirección pública al desplegar. Lo dejé documentado como un paso a mano en el README.
- El límite de pedidos de Workers AI. En la nube se trabaja por frases de 4 a 8 s para cuidarlo.
- Seguridad: separé el link de la audiencia del acceso de administración, protegí las ramas del repo y no dejé secretos en ningún archivo.


Log in or sign up for Devpost to join the conversation.