Nerdearla es una de las conferencias open source más grandes de Latinoamérica, y desde hace años trabajan para que el evento sea accesible. Hoy lo resuelven con herramientas comerciales: una para transcripción español→español y otra para traducción en vivo inglés→español.
Pero este año tienen más de 30 sesiones en inglés, muchas en simultáneo, y esa solución ya no escala. Es cara, depende de operación manual (un operador por sala), y no se puede replicar en otros eventos. El audio de cada charla viaja a servidores de terceros, lo que no todos los speakers aceptan.
Casi todas las conferencias del mundo tienen este mismo problema y ninguna tiene una solución abierta. Vimos la oportunidad de construir la mejor solución open source para que cualquier conferencia sea accesible — no para reemplazar a los intérpretes humanos en todos los contextos, sino para que el acceso no dependa de poder pagar por minuto. Se la ofrecemos a Nerdearla, pero el código es MIT y cualquier evento puede usarlo.
Cómo lo construimos Arquitectura El pipeline corre íntegramente en hardware local, en una sola máquina:
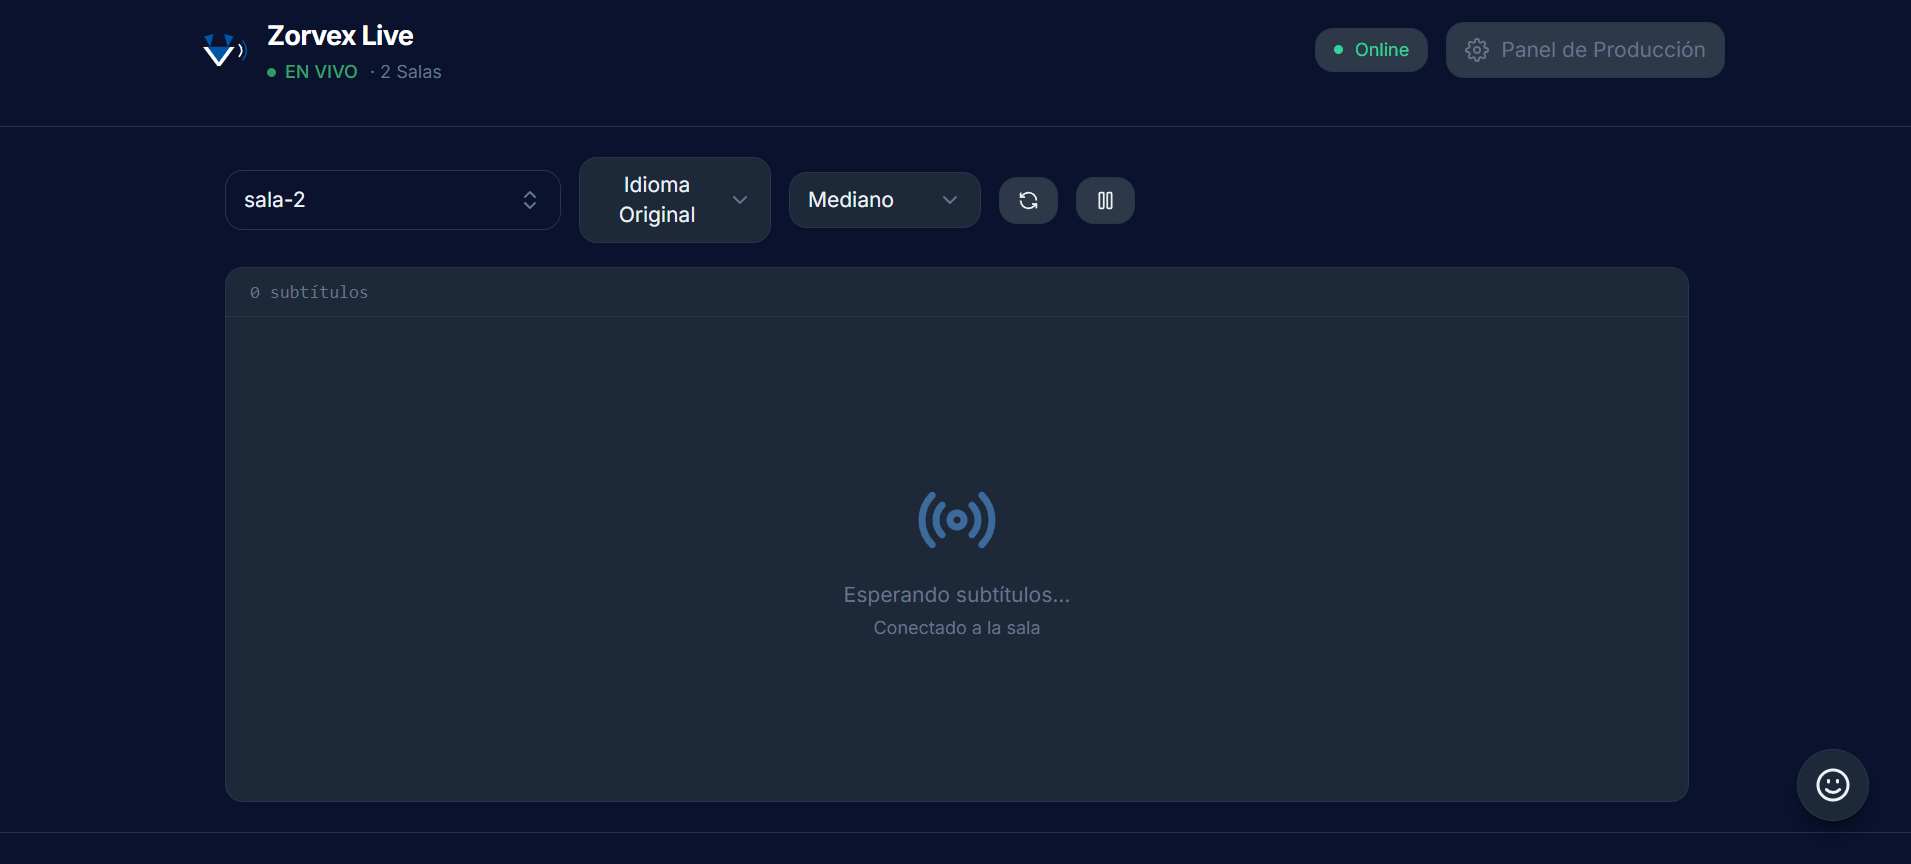
Captura: el panel admin captura audio del micrófono vía Web Audio API, lo trocea en chunks de 3s con solapamiento de 0.5s, y los envía por HTTP al backend. Transcripción: faster-whisper con modelo large-v3 en GPU (float16, beam_size=5, VAD filter). Un singleton compartido entre todas las salas con procesamiento round-robin. Traducción: gemma2:2b vía Ollama traduce a ES/EN/PT en paralelo según lo que pida cada cliente por WebSocket. El prompt incluye un glosario técnico para mantener términos como "WebSocket", "API", "GPU" sin traducir. Broadcast: los subtítulos se emiten por WebSocket a todos los clientes de la sala, con latencias de Whisper y Gemma para monitoreo. Decisiones de diseño clave Zero-Lag: si el procesamiento se atrasa (cola con ≥3 chunks), se descarta el audio viejo y se prioriza el tiempo real. En un evento en vivo, un subtítulo con 15s de delay es peor que no tener subtítulo. Dedup de overlap: como los chunks se solapan 0.5s para no cortar palabras, el backend detecta y corta el texto duplicado entre chunks consecutivos. Multi-idioma por demanda: cada cliente pide su idioma por WebSocket. El backend traduce solo a los idiomas solicitados + el default, sin desperdiciar GPU. Overlay transparente para OBS: una vista /overlay con fondo transparente y chroma key opcional, lista para capturar como Browser Source. El indicador de conexión se puede ocultar con ?status=false para producción. Stack Backend: Python, FastAPI, faster-whisper, Ollama (gemma2:2b), WebSockets Frontend: React, TypeScript, Vite, Radix UI, Tailwind CSS Infra: WSL2/Ubuntu 24.04, NVIDIA RTX 3060 (6GB VRAM) Lo que aprendimos Tunear Whisper es un arte de equilibrios El filtro de repetición de Whisper es un arma de doble filo. Nuestra primera versión descartaba texto con unique_ratio < 0.4 y más de 2 palabras — esto filtraba "hola hola hola" (ratio 0.25) como alucinación, pero era una repetición legítima del speaker. Lo ajustamos a unique_ratio < 0.25 con más de 6 palabras, para que solo descarte alucinaciones reales de Whisper (que típicamente repiten la misma palabra 8+ veces).
El VAD (Voice Activity Detection) también era demasiado agresivo: con min_silence_duration_ms=300 cortaba frases a mitad de palabra. Los logs mostraban "VAD filter removed 00:02.389 of audio" en un chunk de 2.4s — removió casi todo. Subirlo a 700ms con speech_pad_ms=400 resolvió el corte de palabras como "probando" que se alucinaba como "Rohan".
Un bug de paréntesis puede ser sutil Al ajustar el filtro de repetición, escribí: len(set(w.lower().strip(".,;:!?")) for w in words) Python lo parsea como len((set(...) for w in words)) — len() sobre un generador, no sobre un set. El error fue TypeError: object of type 'generator' has no len(). La versión correcta: len({w.lower().strip(".,;:!?") for w in words}) La diferencia: {... for w in words} es un set comprehension que produce un set; set(...) con el for afuera produce un generador de sets de una palabra cada uno.
Los desafíos Latencia vs. precisión Whisper large-v3 con beam_size=5 da mejor precisión pero más latencia. En una RTX 3060, un chunk de 3s toma ~1.2s de Whisper + ~0.1s de Gemma. Con solapamiento de 0.5s, el subtítulo llega ~2.5s después del habla — aceptable para un evento en vivo. La política Zero-Lag asegura que si se acumula delay, se descarta audio viejo en lugar de acumularse indefinidamente.
Memoria VRAM large-v3 en float16 ocupa ~3GB de VRAM. Gemma 2B vía Ollama corre en CPU o GPU compartida. En 6GB de VRAM no podemos correr Whisper + Gemma ambos en GPU simultáneamente sin OOM. La solución: Whisper en GPU (float16), Gemma en Ollama que puede usar CPU. Para producción con 30 salas, la arquitectura separa Whisper (GPU T4/L4 dedicado por sala) de Gemma (tier separado, CPU o vLLM batch).
Privacidad como feature, no como afterthought El que el audio no salga de la sala no es solo una restricción técnica — es un requerimiento de los speakers. Algunos no aceptan que su voz viaje a servidores de terceros. Que todo corra local hace que nuestra herramienta sea usable en contextos donde las soluciones comerciales no lo son, y eso es justamente lo que la hace viable para Nerdearla.
Qué sigue El MVP procesa 2 salas en una GPU de consumo. Para las 30 salas simultáneas de Nerdearla, la arquitectura migra a workers con GPU dedicados (T4/L4), colas Redis Pub/Sub, y un cluster de WebSockets con fan-out. El RoomManager ya modela salas independientes con colas separadas — migrar es cambiar queue.Queue en memoria por topics de Redis.
El objetivo final: que cualquier conferencia open source del mundo pueda clonar este repo, levantarlo en una máquina con GPU, y tener subtitulación y traducción en vivo sin pagar un centavo por minuto.
Built With
- faster-whisper
- gemma
- ollama
- python
- react
- tailwind
- typescript


Log in or sign up for Devpost to join the conversation.