-
-
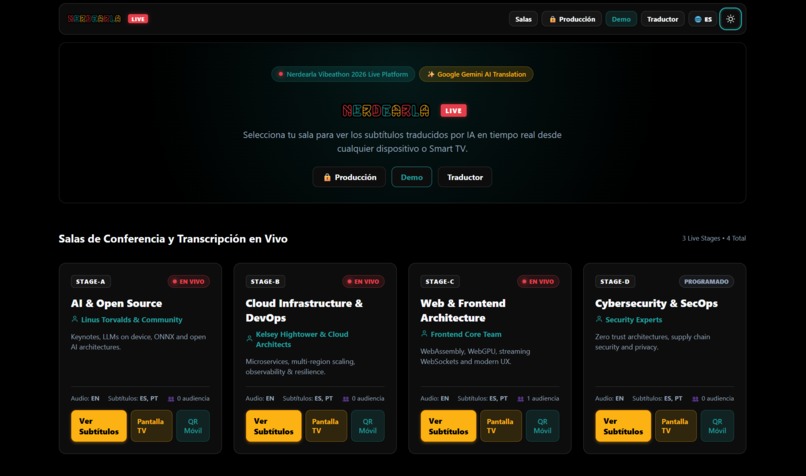
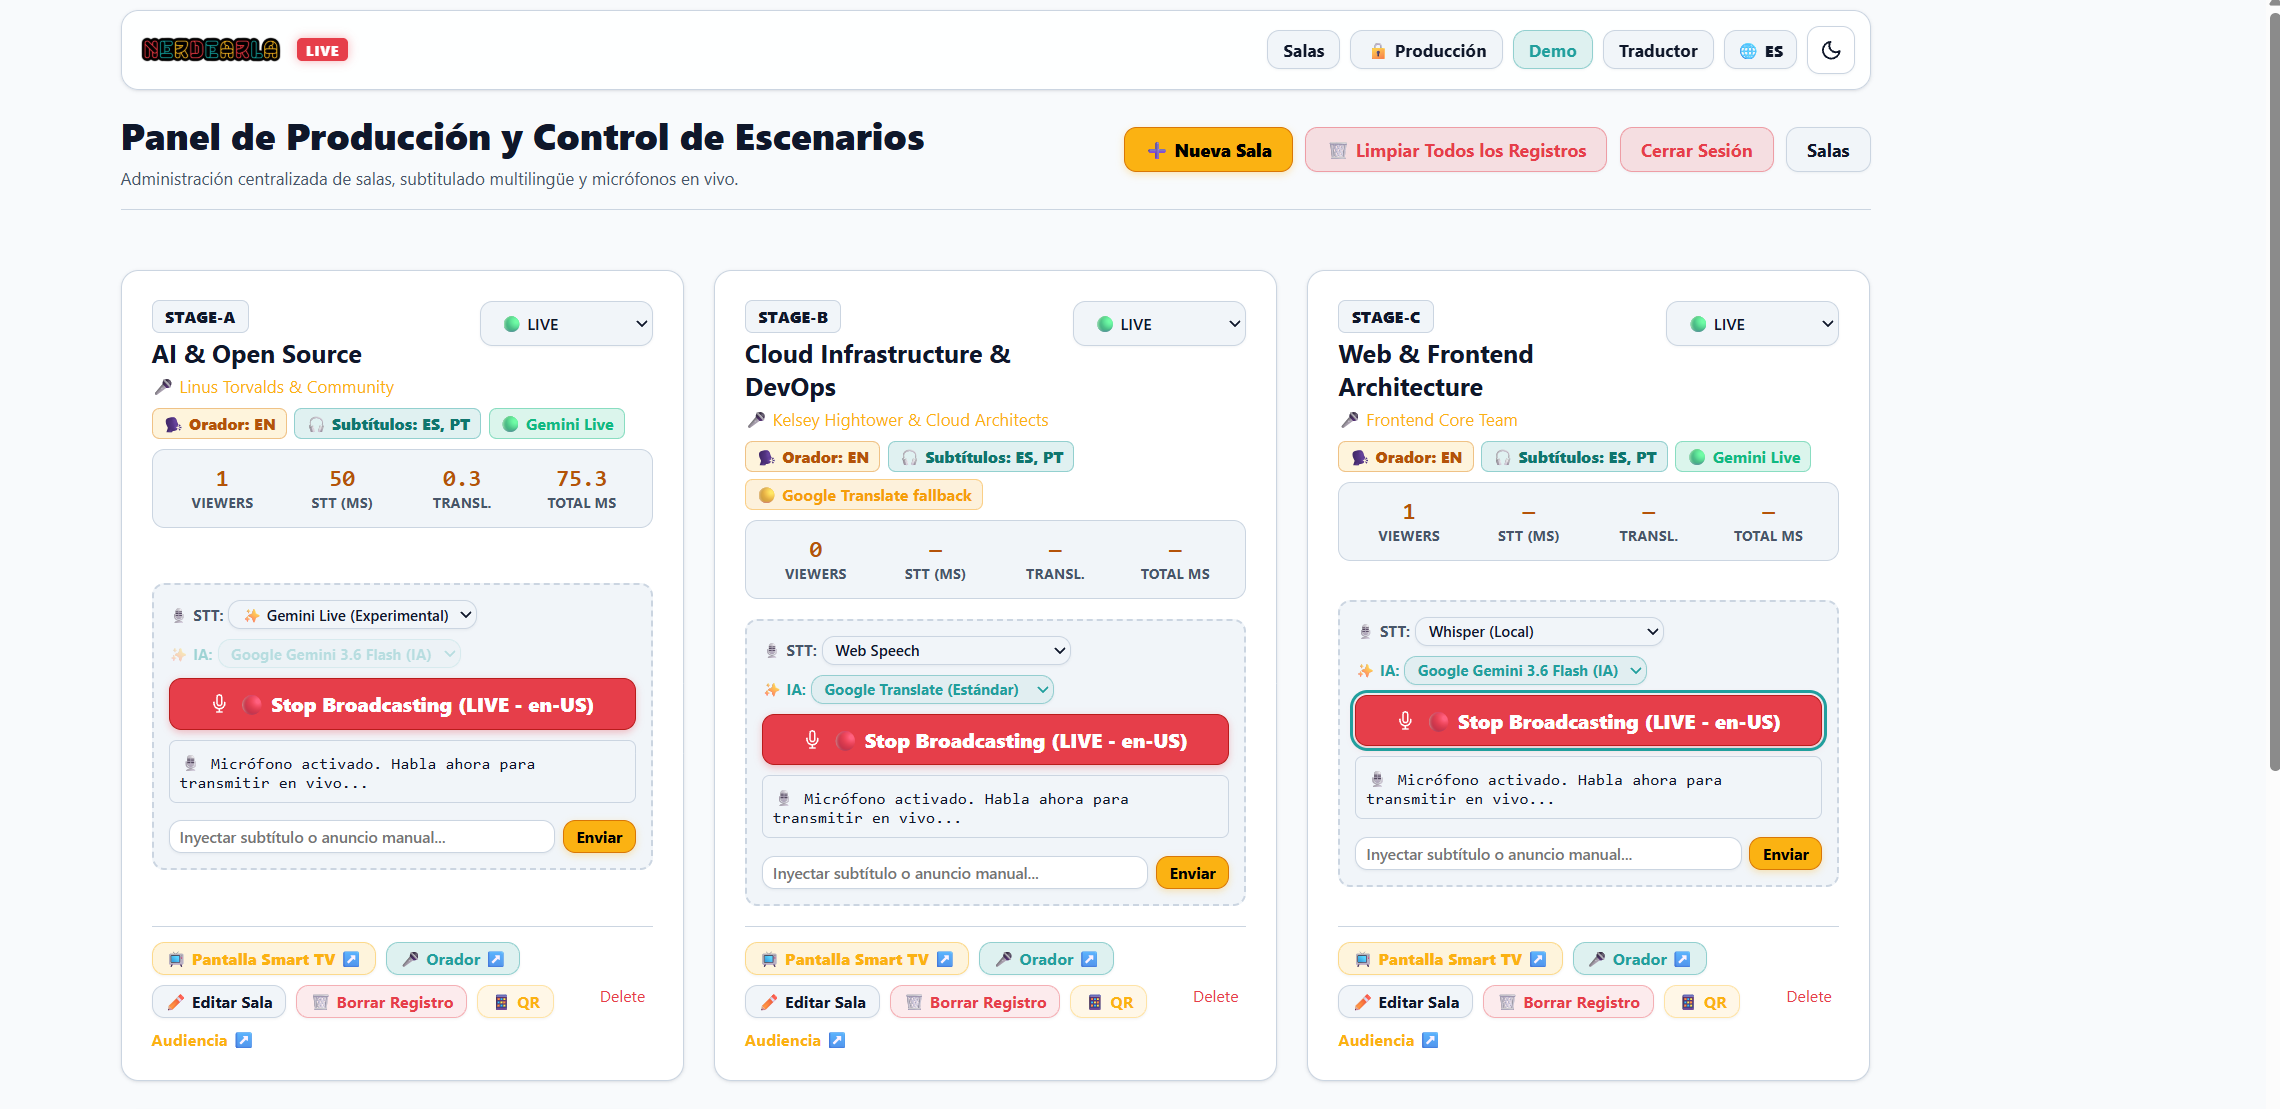
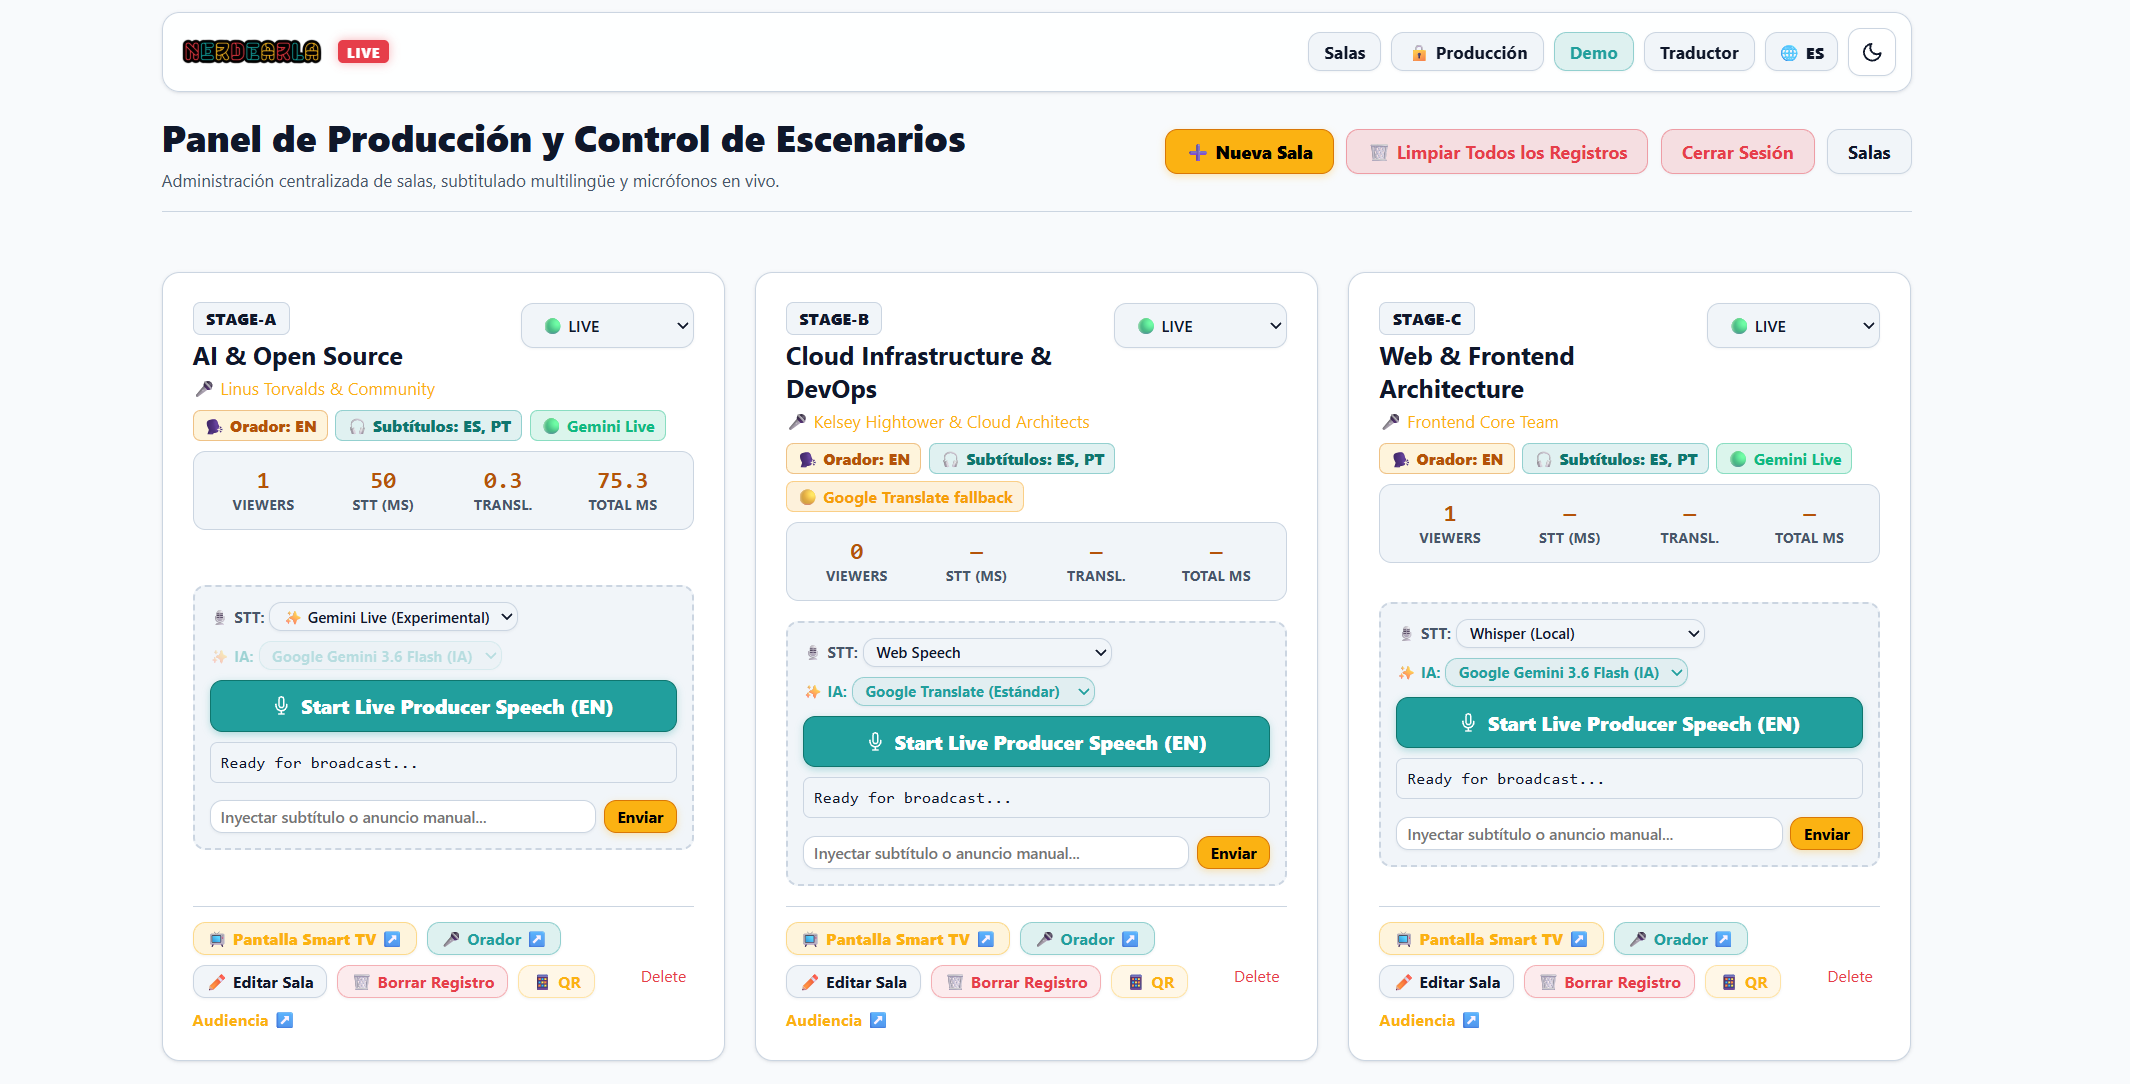
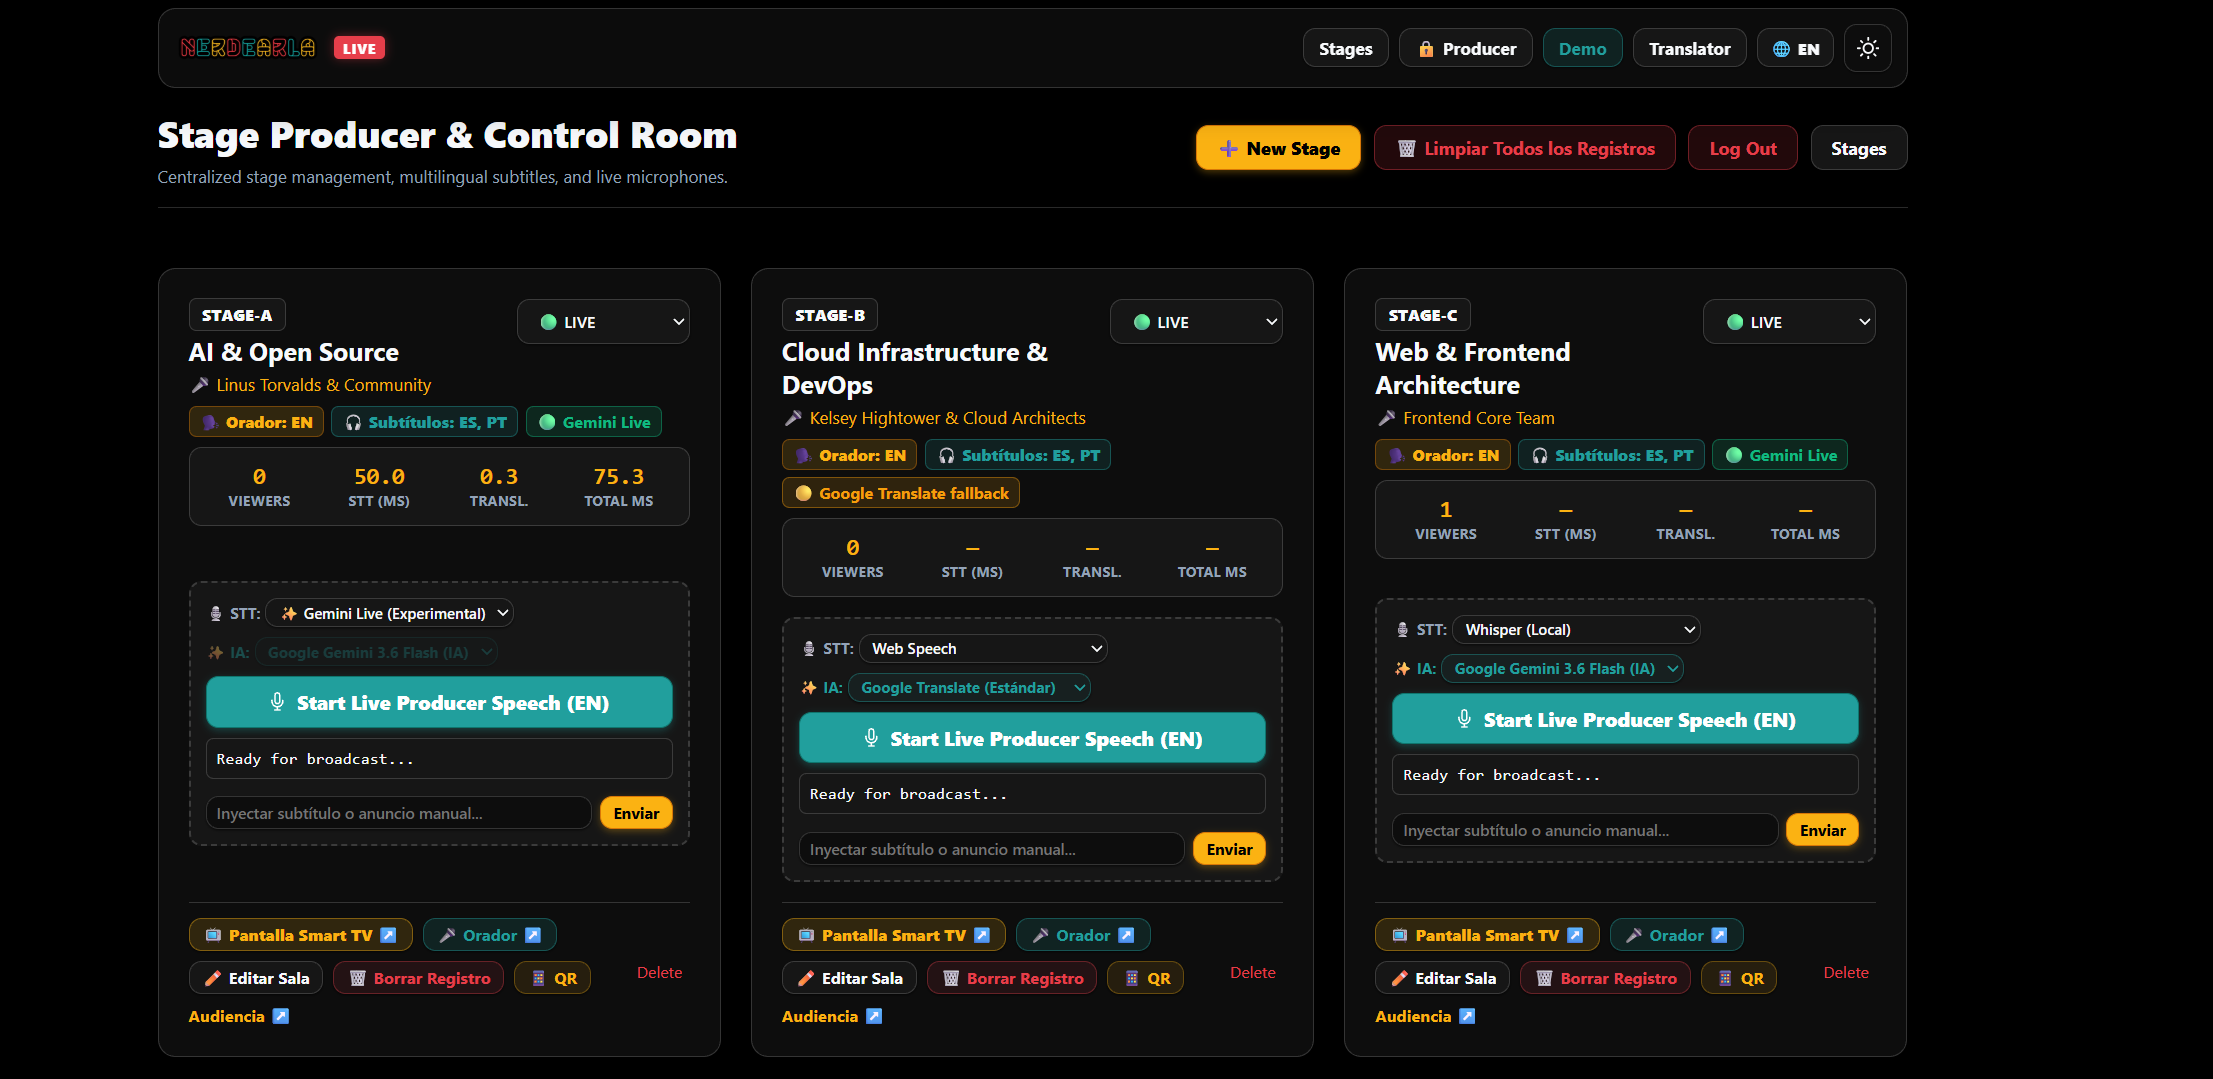
El productor tiene un panel de control donde puede editar la informacion de la charla, el modelo de voz a texto que desea utilizar
-
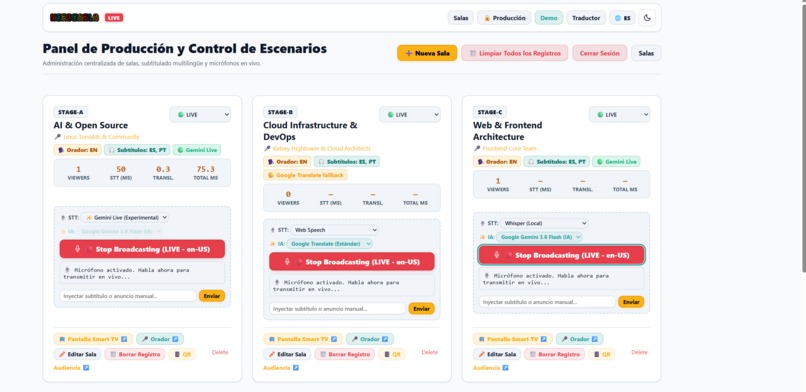
soporta mas de 50 transmisiones simultaneas en vivo en 2 o mas idiomas
-
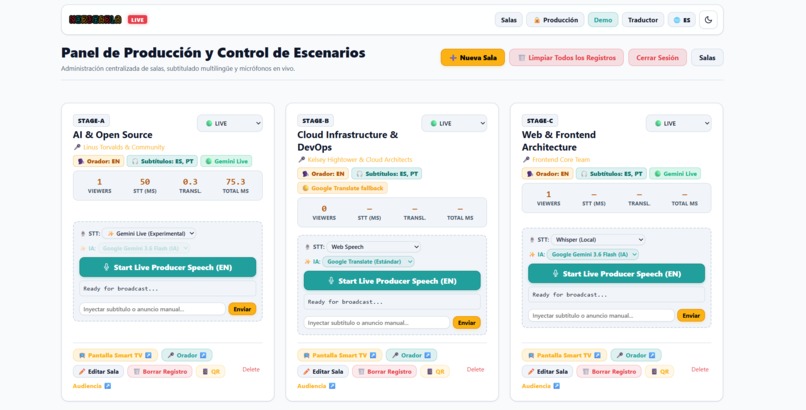
disponible modo claro
-
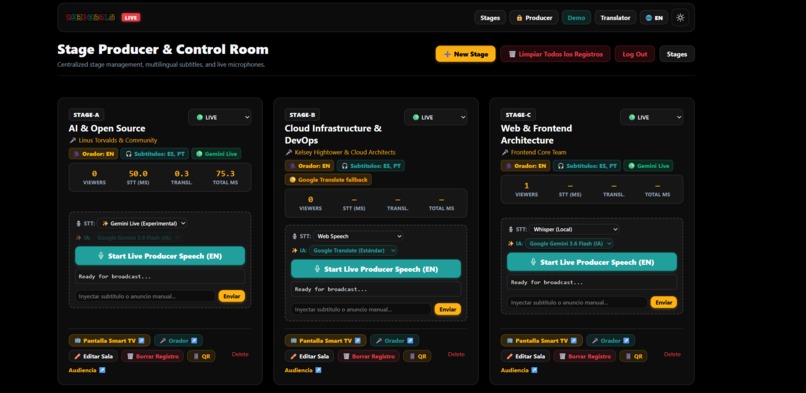
y oscuro
-
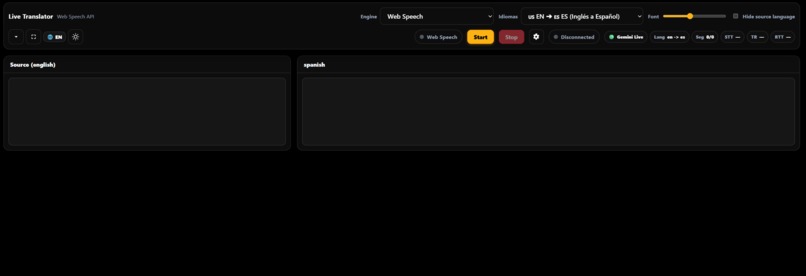
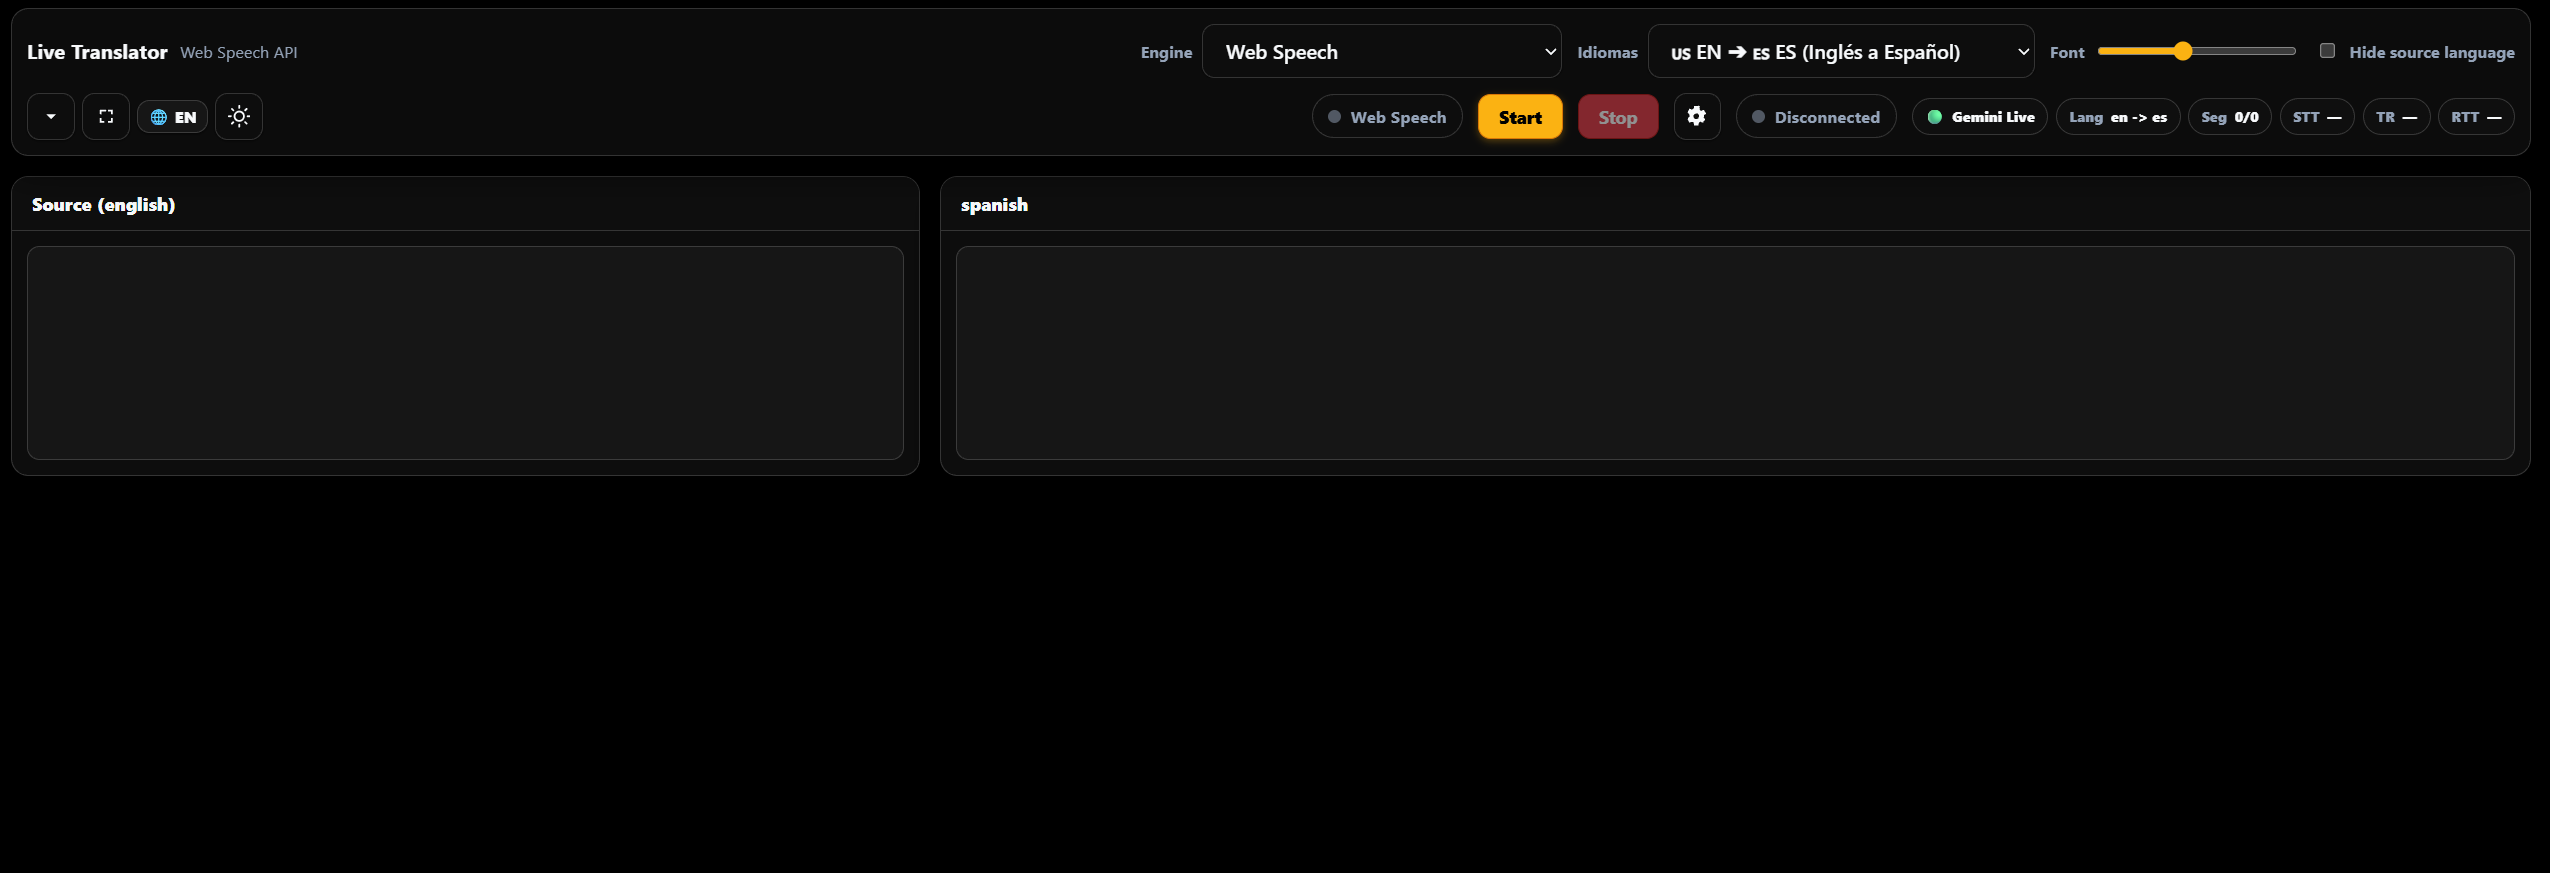
posee un espacio aislado para pruebas de modelos y sonido
-
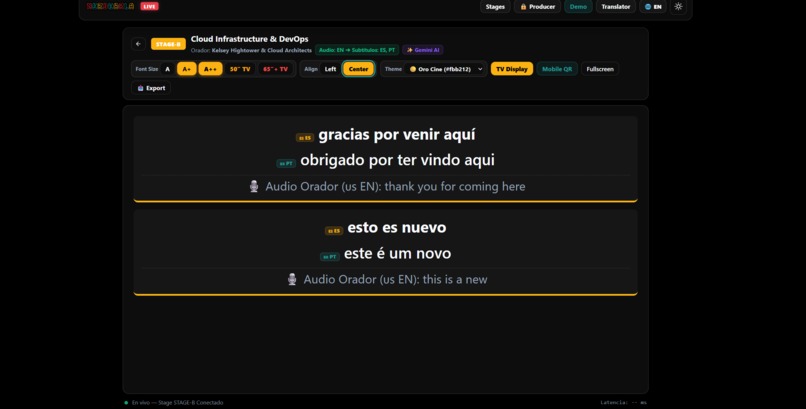
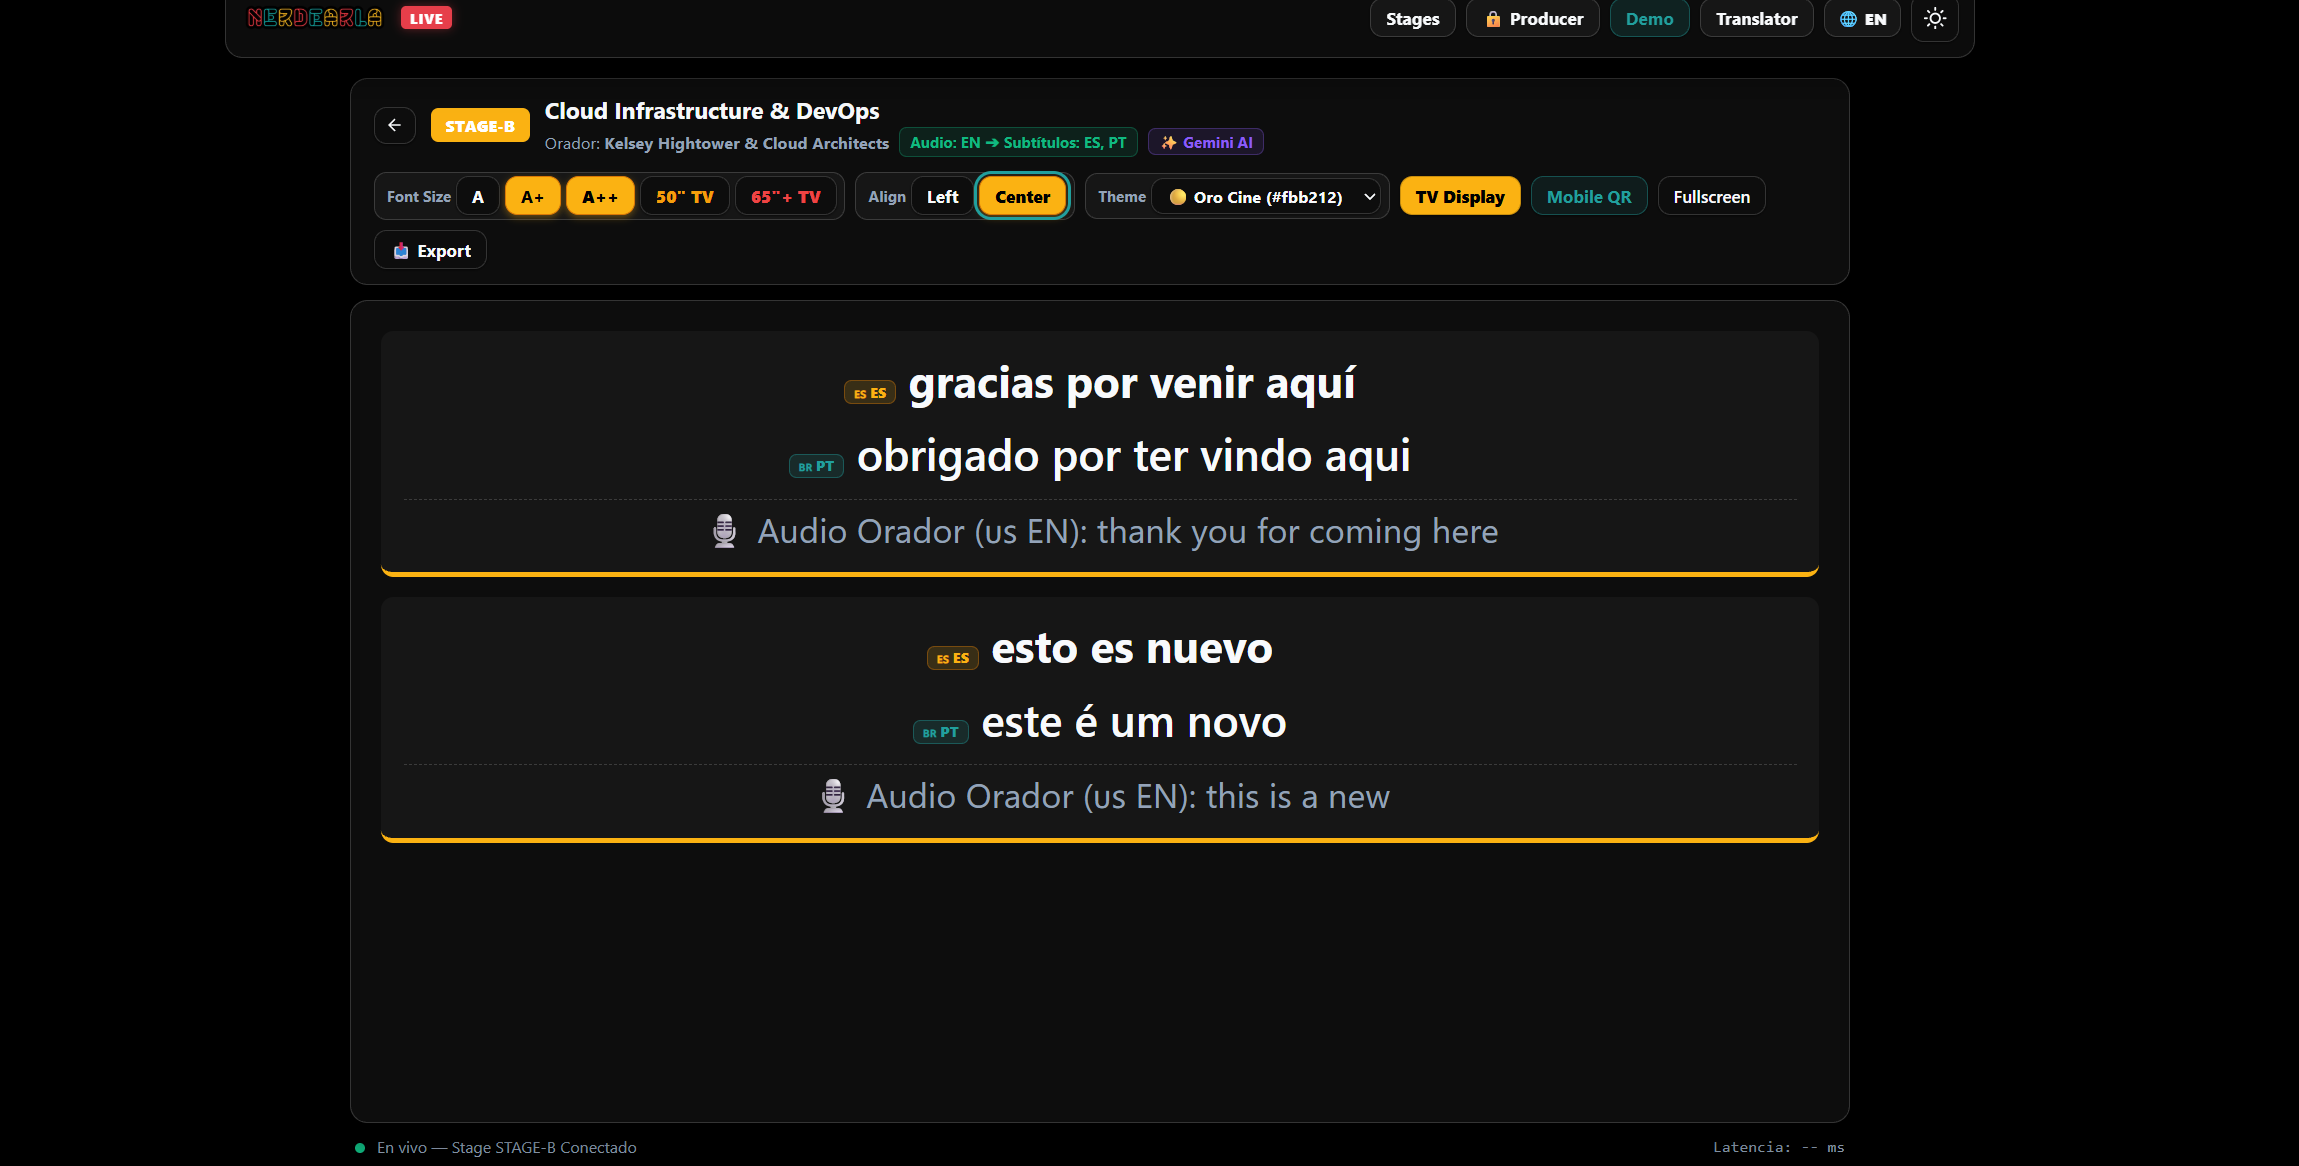
posee varias salidas de texto TVs o monitores de 50 a +65 pulgadas
-
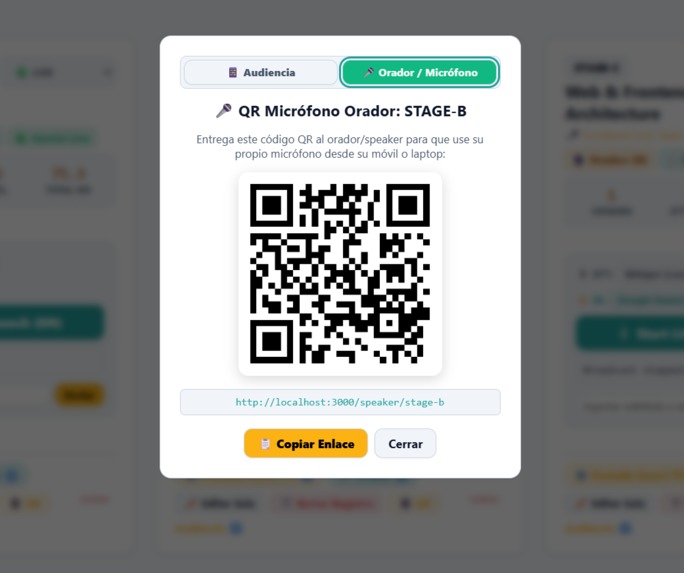
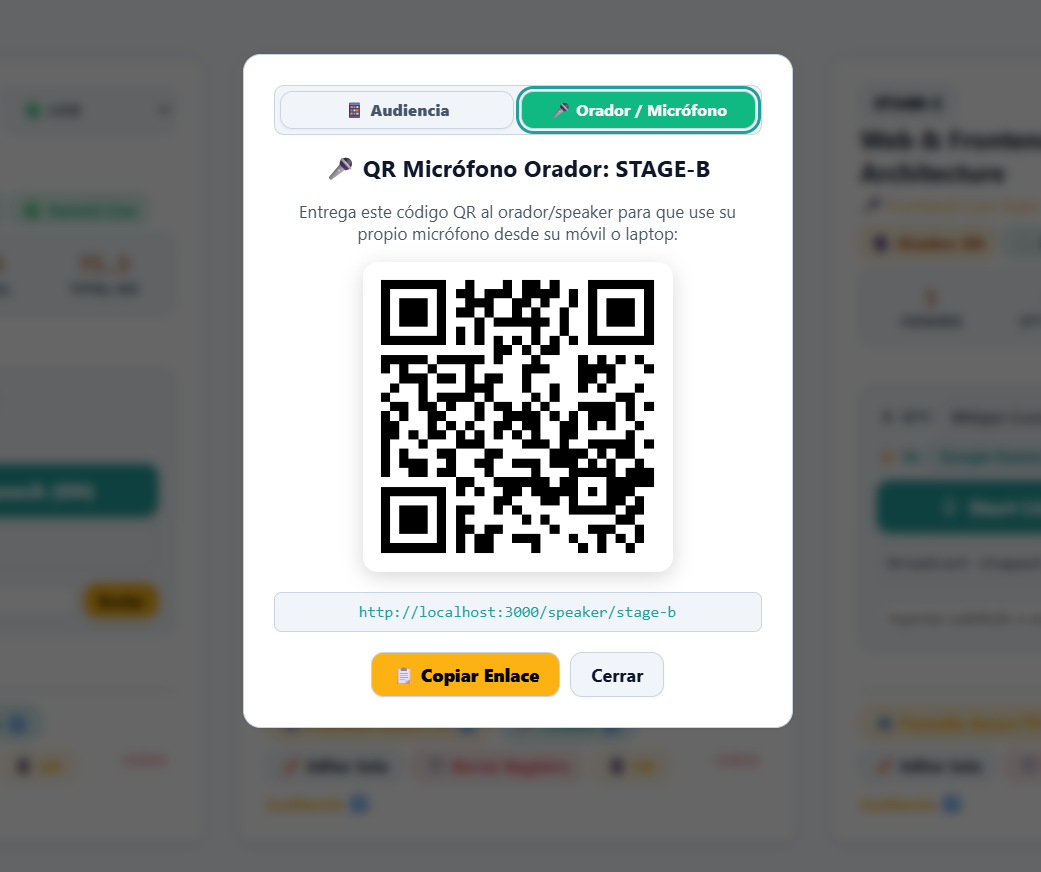
el productor le entrega un QR a cada Speake para que ejecute el servicio de audio en su propia pc o la pc que tenga asignado el microfono
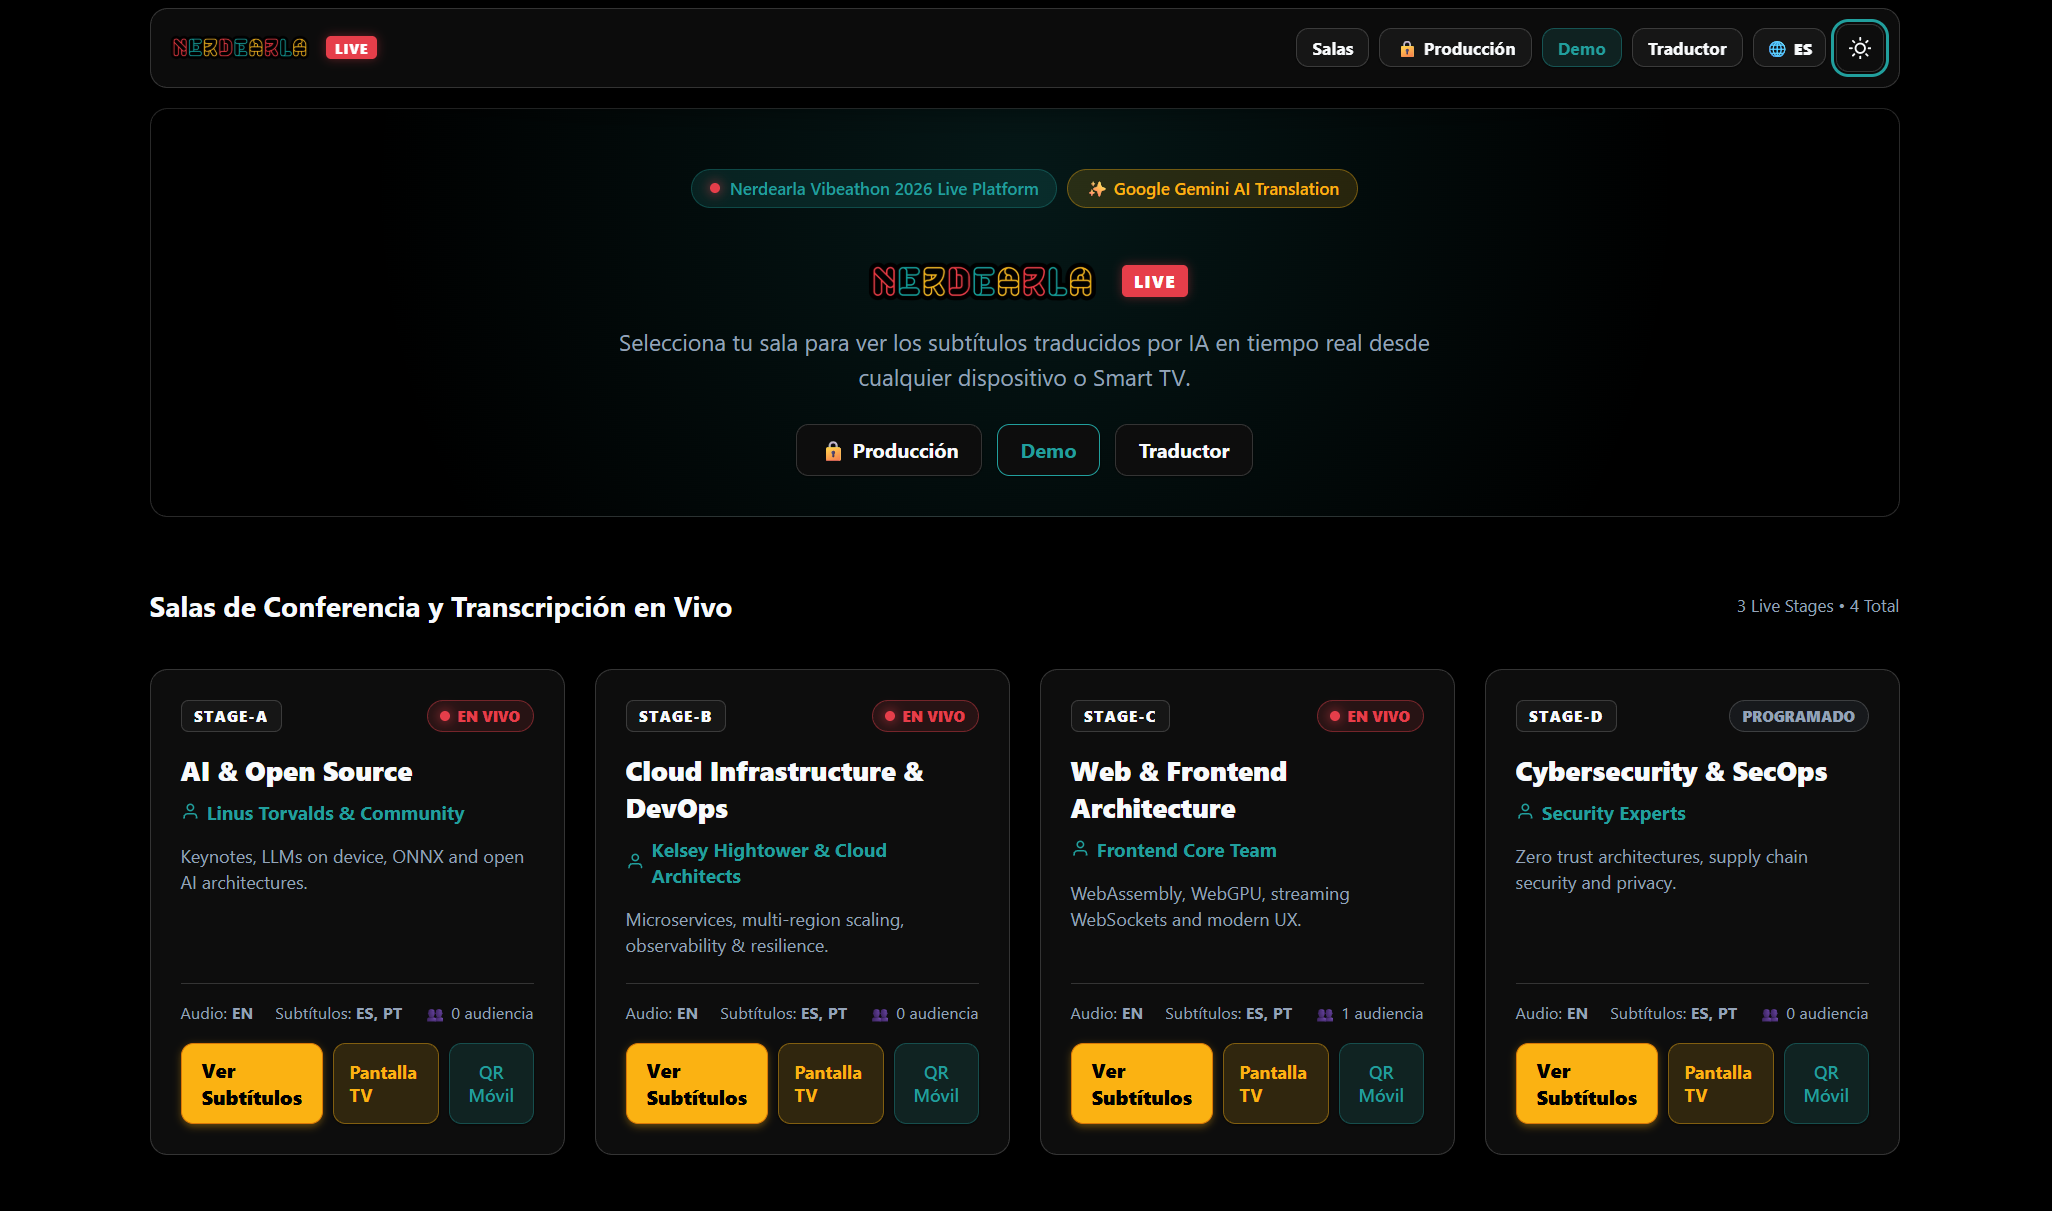
Nerdearla Live Transcribely 🎙️🌐
Accesibilidad y Traducción Simultánea en Tiempo Real para Conferencias Multi-Escenario
💡 Inspiración
Las conferencias masivas de tecnología como Nerdearla reúnen a más de 10.000 desarrolladores, estudiantes y líderes de la industria en decenas de escenarios en paralelo. Sin embargo, este volumen introduce una barrera crítica: el idioma y la accesibilidad.
Oradores internacionales de primer nivel suelen presentar en inglés o portugués, mientras que gran parte de la audiencia local prefiere o necesita subtítulos en español para comprender tecnicismos avanzados. La interpretación humana tradicional mediante cabinas y receptores de radio es extremadamente costosa e inviable de coordinar en 5, 10 o 30 salas en simultáneo. Al mismo tiempo, los asistentes con hipoacusia o dificultades auditivas quedan completamente excluidos sin subtítulos textuales inmediatos.
Nos inspiramos en este desafío para crear Nerdearla Live Transcribely: una plataforma modular, autosoportada (self-hosted) y de código abierto que democratiza la accesibilidad y la traducción simultánea para conferencias de cualquier escala, sin costos de servidores GPU.
🎯 ¿Qué problema soluciona?
- Elimina la Barrera Idiomática: Traducción simultánea fluida entre inglés, español y portugués con latencia imperceptible ( < 700ms).
- Accesibilidad Universal para Asistentes con Discapacidad Auditiva: Subtítulos grandes, de alto contraste y tamaño personalizable directamente en los teléfonos de los asistentes y en proyectores de escenario.
- Speech-Biasing y Corrección de Jerga Técnica: Los transcriptores genéricos suelen destrozar los nombres propios (traduciendo "Nerdearla" como "nerd de habla" o "merdearla"). Diseñamos normalización fonética y priorización acústica para garantizar precisión exacta en términos como Nerdearla, Kubernetes, Pull Requests, DevOps y Open Source.
- Cero Costo en Infraestructura de Servidor (GPU): Mediante WebGPU en el cliente (Whisper y NVIDIA Nemotron ejecutándose directamente en el navegador del orador con ONNX Runtime y Transformers.js), el audio nunca abandona su dispositivo para transcribirse, ahorrando miles de dólares en servidores dedicados.
⚙️ Cómo lo construimos
Nerdearla Live Transcribely está construida sobre una arquitectura asíncrona de alto rendimiento pensada para soportar cientos de conexiones simultáneas:
  [ Micrófono Orador ] ──────► [ STT WebGPU / Cloud ] ──────► [ Gemini Live WS ]
  (Monitor AudioContext)       (Whisper, Nemotron, WebSpeech,   (Traducción Bidireccional
                               Deepgram, ElevenLabs)            y Fallback Automático)
                                       │                                  │
                                       ▼                                  ▼
                             [ Session Manager ] ◄────────────────────────┘
                             (Aislamiento Multi-Sala)
                                       │
            ┌──────────────────────────┼──────────────────────────┐
            ▼                          ▼                          ▼
   [ Vista Audiencia ]        [ Pantalla Escenario ]      [ Sala de Control ]
   (/session/stage-a)         (/stage/stage-a)            (/producer)
Built With
- accesibilidad
- css3
- deepgram
- docker
- docker-compose
- elevenlabs
- fastapi
- gemini-live
- google-genai
- html5
- javascript
- jinja
- nemotron
- onnx-runtime
- python
- subtitulos
- transformers-js
- webaudio-api
- webgpu
- websockets
- whisper


Log in or sign up for Devpost to join the conversation.