Inspiración
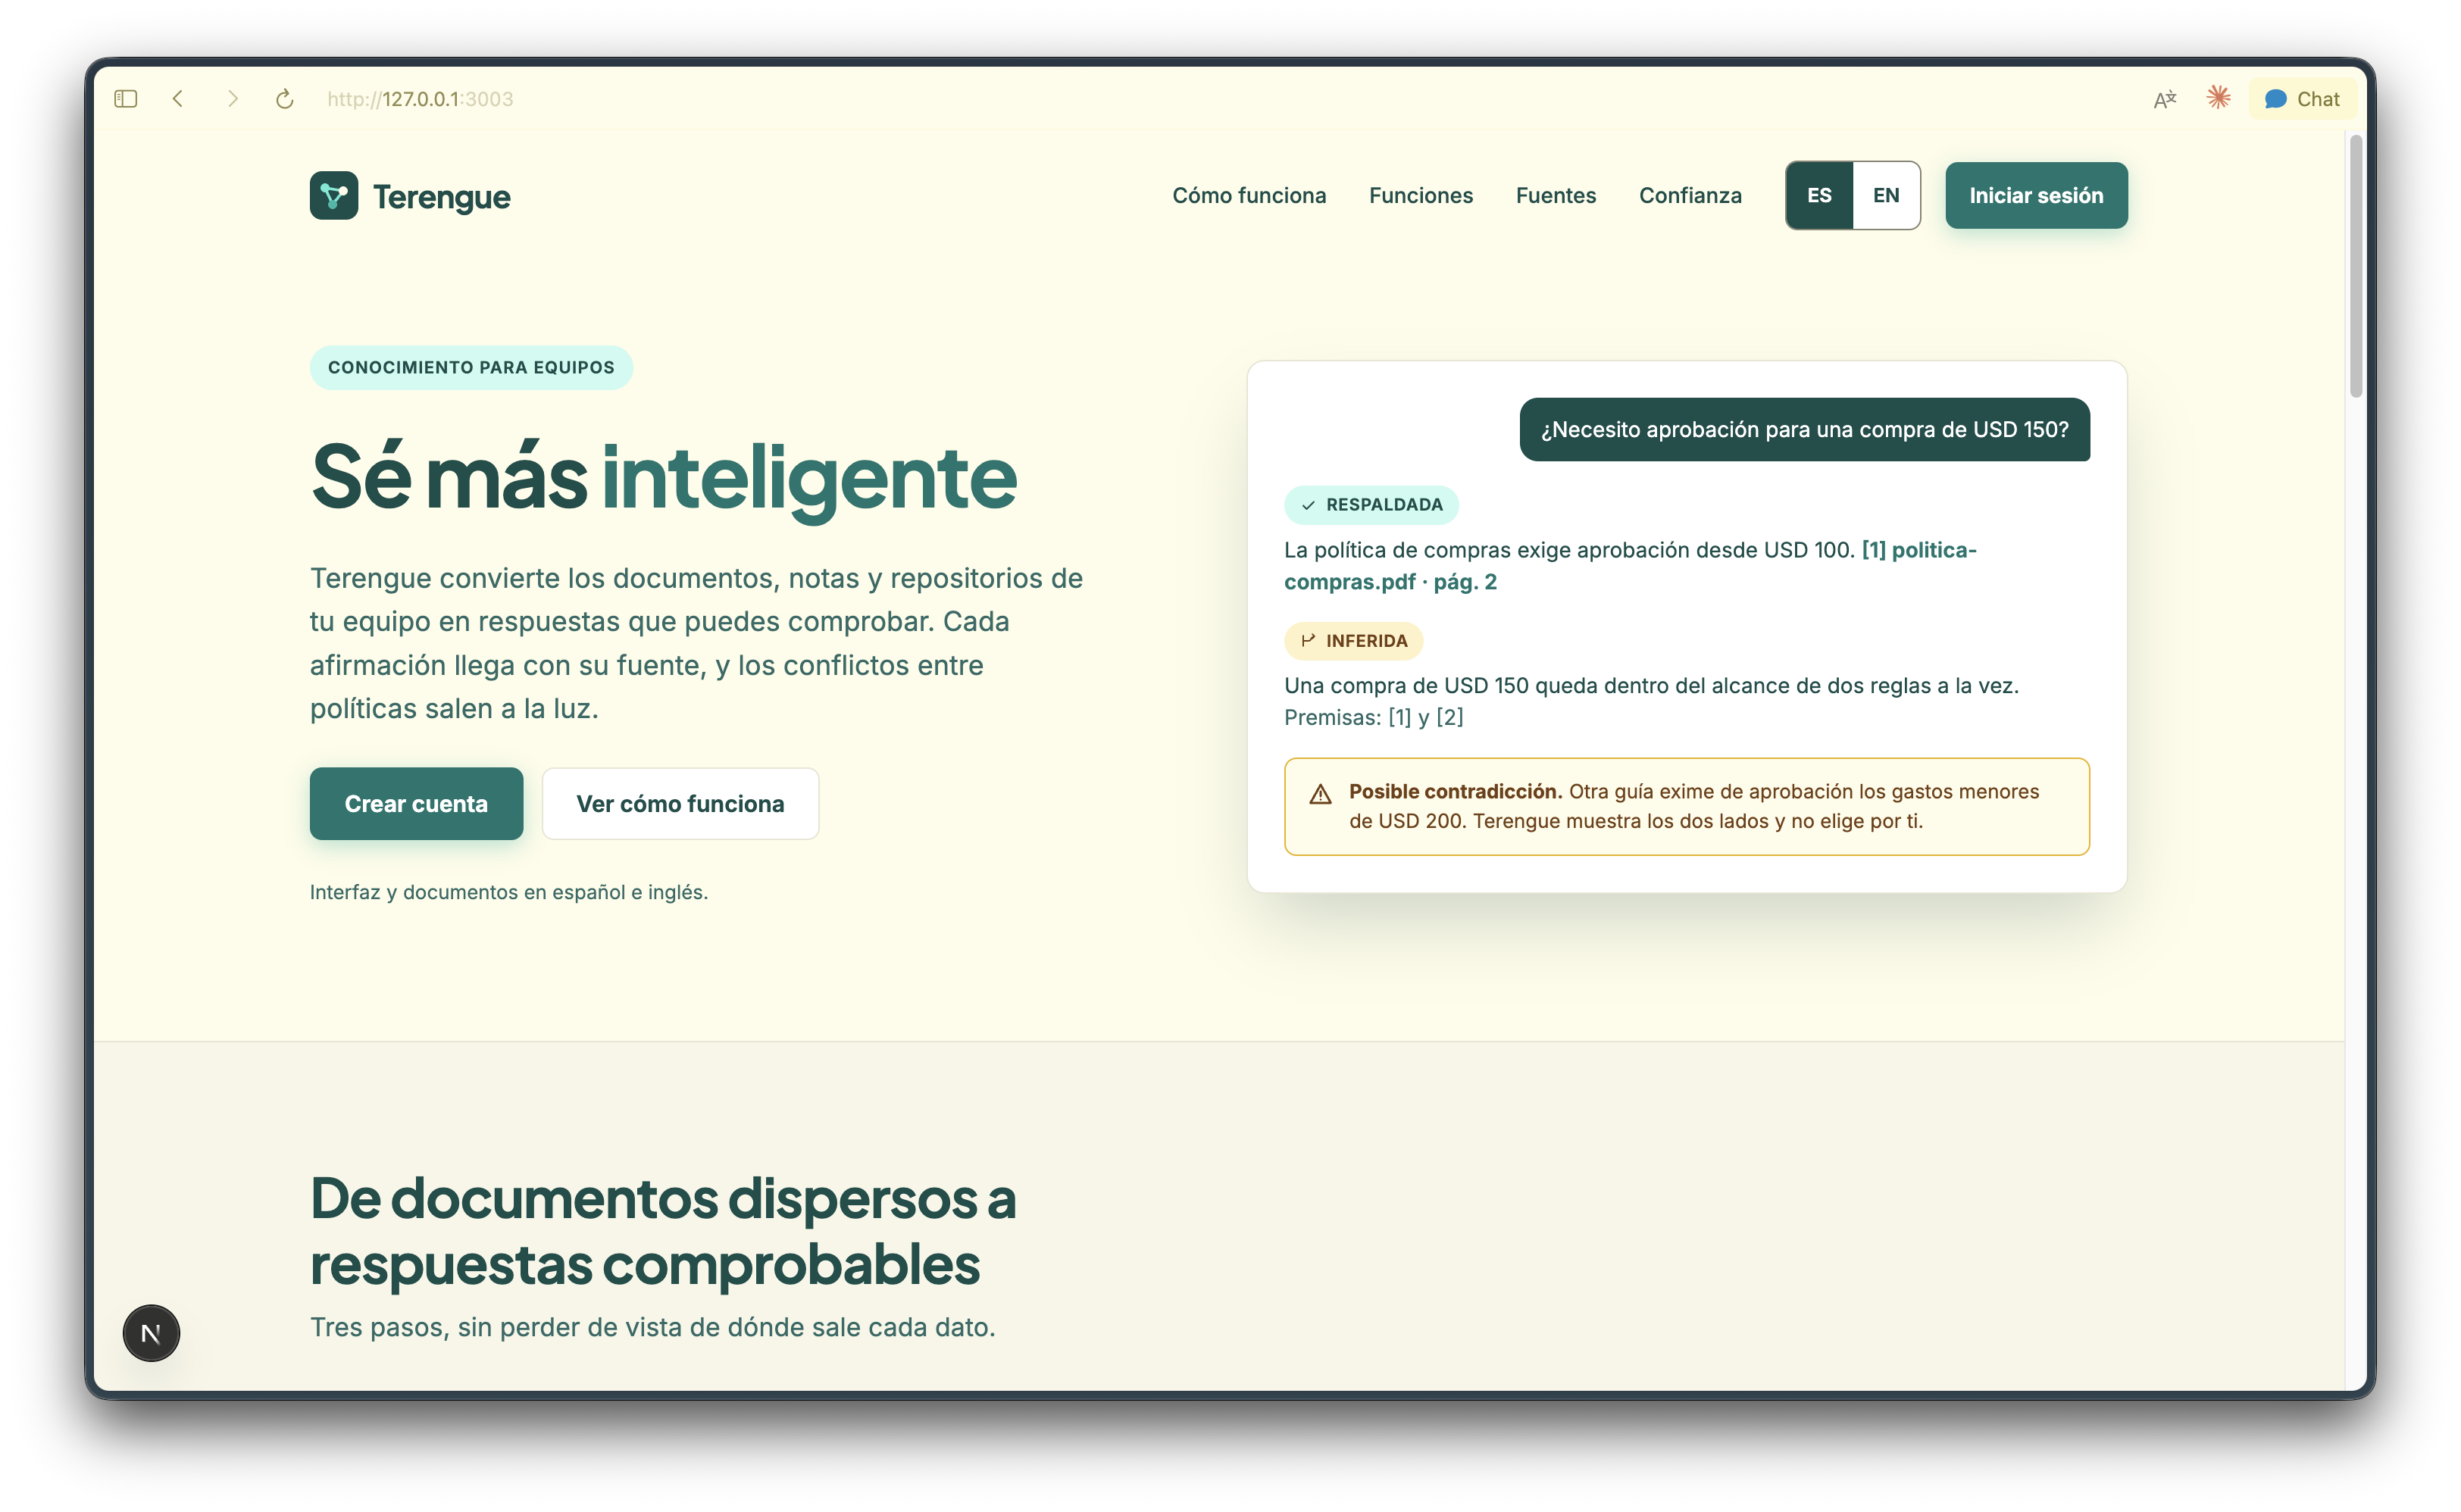
En cualquier equipo, las políticas y los procedimientos viven repartidos entre PDFs, hojas de cálculo, notas y repositorios, y a veces dicen cosas incompatibles. Una regla exige aprobación para todo gasto desde USD 100; otra exime los gastos menores de USD 200. ¿Qué pasa con una compra de USD 150?
Un asistente de IA corriente respondería con seguridad y elegiría una de las dos. Nosotros queríamos lo contrario: una herramienta que muestre los dos lados con su evidencia, que distinga lo que dicen las fuentes de lo que deduce, y que reconozca cuándo no sabe. De ahí nace Terengue y su lema: Sé más inteligente.
Qué hace
Terengue es un segundo cerebro para equipos (reto 07, «Second Brain»):
- Espacios compartidos con roles de administrador, editor y lector, y conocimiento aislado por espacio.
- Biblioteca de documentos con estados honestos: un archivo guardado no se presenta como indexado.
- Respuestas con evidencia: cada afirmación se etiqueta como respaldada, inferida o incierta, con cita a la página, línea, campo o celda exactos.
- Posibles contradicciones con ambas afirmaciones, su contexto y sin ganador automático.
- Grafo de documentos y conceptos, e interfaz en español e inglés.
Cómo lo construimos
- Núcleo en Pure BoxLang, reutilizable e independiente de la interfaz, con BoxLang AI para embeddings, recuperación y respuestas.
- PostgreSQL con pgvector como única base: cuentas, metadatos y vectores, sin base vectorial ni de grafos adicional.
- Next.js y TypeScript para la web, que solo delega en BoxLang; la lógica de negocio y los permisos viven en el backend.
- Docker Compose para todo, sin instalar runtimes en el equipo.
Trabajamos con un plan de diez fases (00–09), cada una con pruebas de cierre y una matriz de requisitos verificables. Dividimos el trabajo en tres roles en paralelo —plataforma y seguridad, núcleo de conocimiento y web— unidos por contratos explícitos.
Una decisión de diseño atraviesa todo el proyecto: las ubicaciones de las citas salen de la extracción del documento, nunca del modelo, y el filtro por espacio se aplica antes de recuperar, no después. Así, un fragmento de otro espacio no llega jamás al contexto del proveedor, por parecido que sea.
Retos
- Citas precisas en ocho formatos. Extraer texto es fácil; conservar página, línea, ruta JSON o celda no lo es. Para DOCX y XLSX no había un loader disponible que preservara coordenadas y tuvimos que leer el OOXML directamente.
- Presupuesto con concurrencia. El límite de USD 20 diarios exige reservar el coste antes de cada llamada y conciliarlo después, para que dos operaciones simultáneas no gasten el mismo saldo.
- Trabajo en paralelo. La pantalla de biblioteca se construyó antes que su backend, contra un contrato y un doble de pruebas. Al comparar ramas descubrimos que el backend y la web usaban vocabularios distintos para los estados de un documento.
- Honestidad como requisito. Distinguir un fallo del documento de un presupuesto agotado o de un proveedor caído obliga a clasificar cada error, no a mostrar un genérico «algo salió mal».
Qué aprendimos
- Que validar la viabilidad antes de diseñar tablas ahorra reescrituras: varias capacidades que dábamos por hechas no existían tal como las imaginábamos.
- Que una métrica global no basta. Nuestra suite de aceptación exige $\frac{18}{20} = 90\,\%$ de casos correctos, pero cero fallos de abstención y cero falsos conflictos: una media favorable no compensa una cita inventada.
- Que «no lo sé» es una respuesta válida, y a menudo la más útil.
Estado actual y próximos pasos
Hoy funcionan las cuentas, los espacios con roles y la biblioteca de documentos, junto con el control de presupuesto de IA. El chat con citas, la detección de contradicciones y el grafo están especificados y planificados, y son lo siguiente en construirse.
Built With
- boxlang
- nextjs
- openai
- postgress


Log in or sign up for Devpost to join the conversation.