Search Query Anomaly Detector
Created By: Sanjay SEmail: [email protected]
Overview
The Search Query Anomaly Detector is a Streamlit-based web app that analyzes search query performance data from Queries.csv to identify anomalies using an Isolation Forest model. It processes a dataset of 614 programming-related queries with metrics like Clicks, Impressions, CTR, and Position, delivering interactive visualizations to help SEO analysts optimize strategies. By combining exploratory data analysis (EDA) and unsupervised machine learning, the app highlights unusual query behaviors, such as high CTRs or low impressions, that may indicate optimization opportunities or issues.
What the App Does
The app performs the following functions:
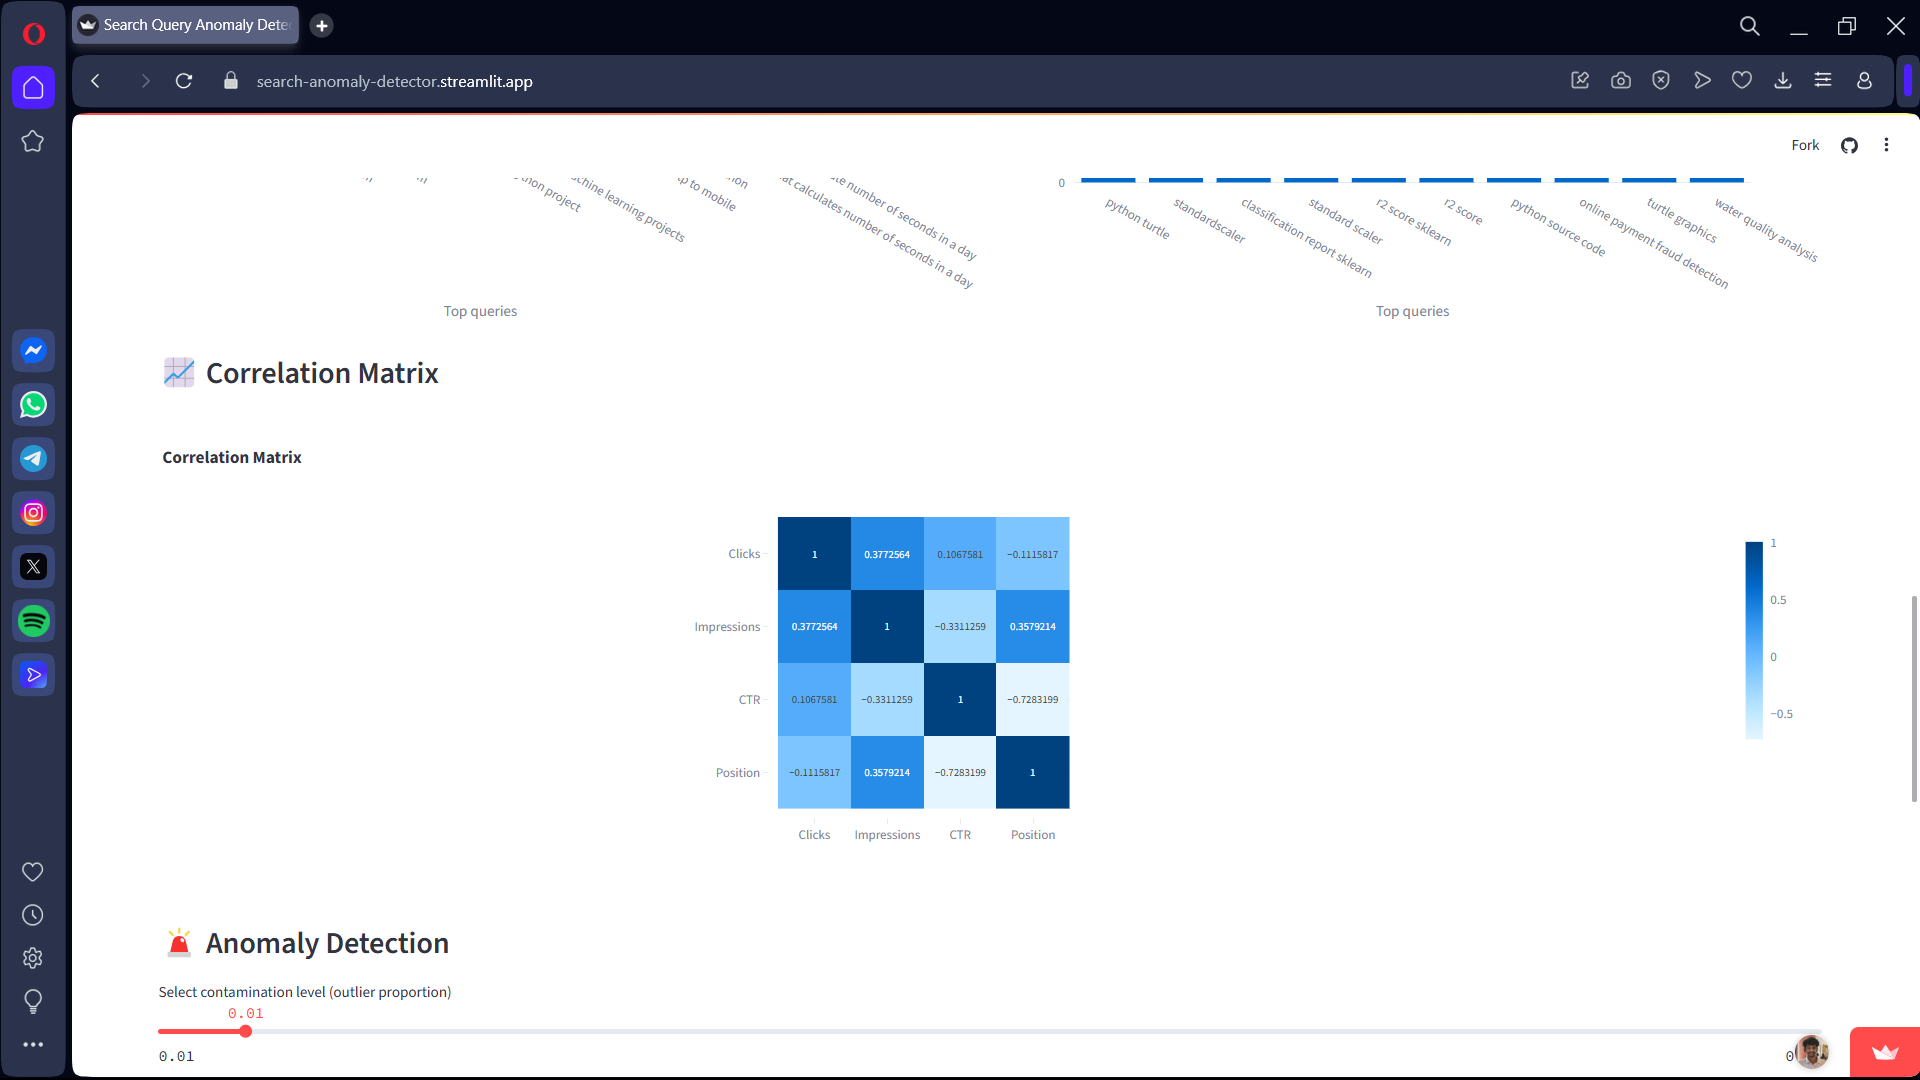
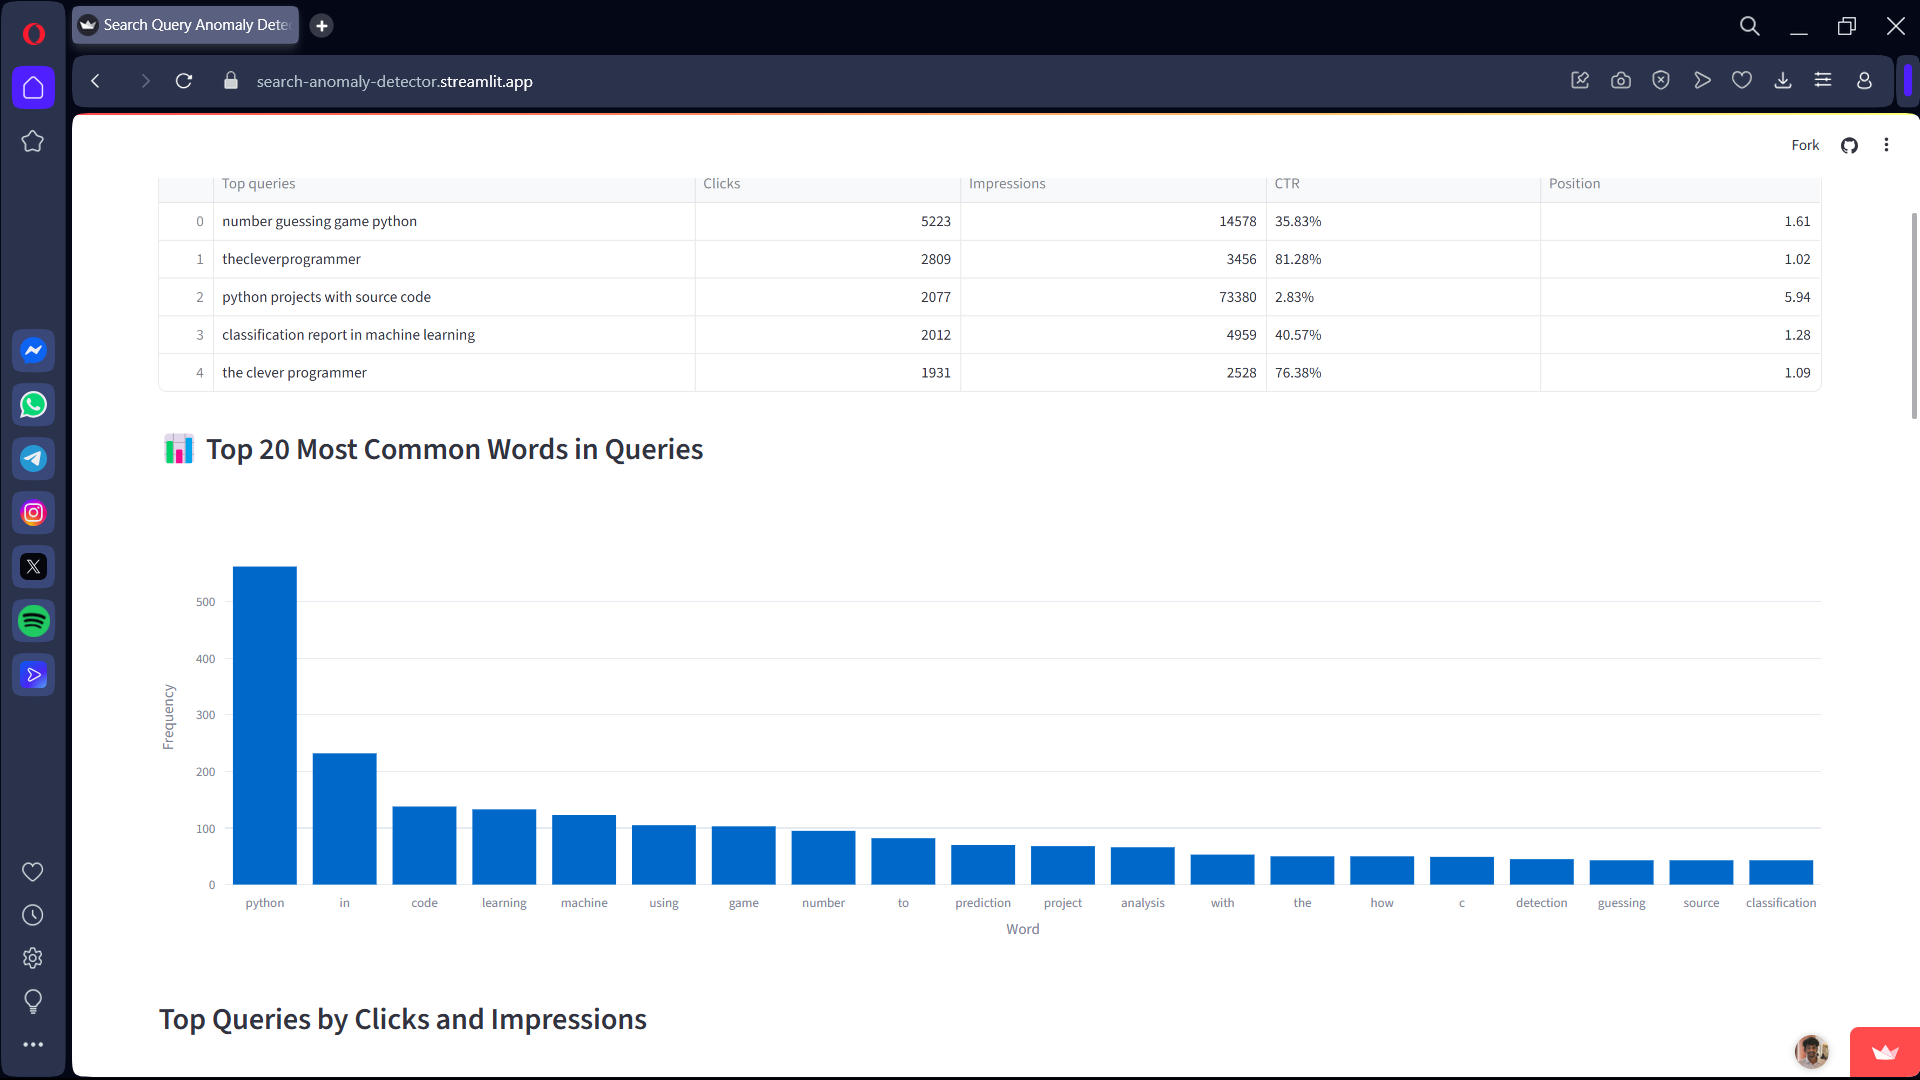
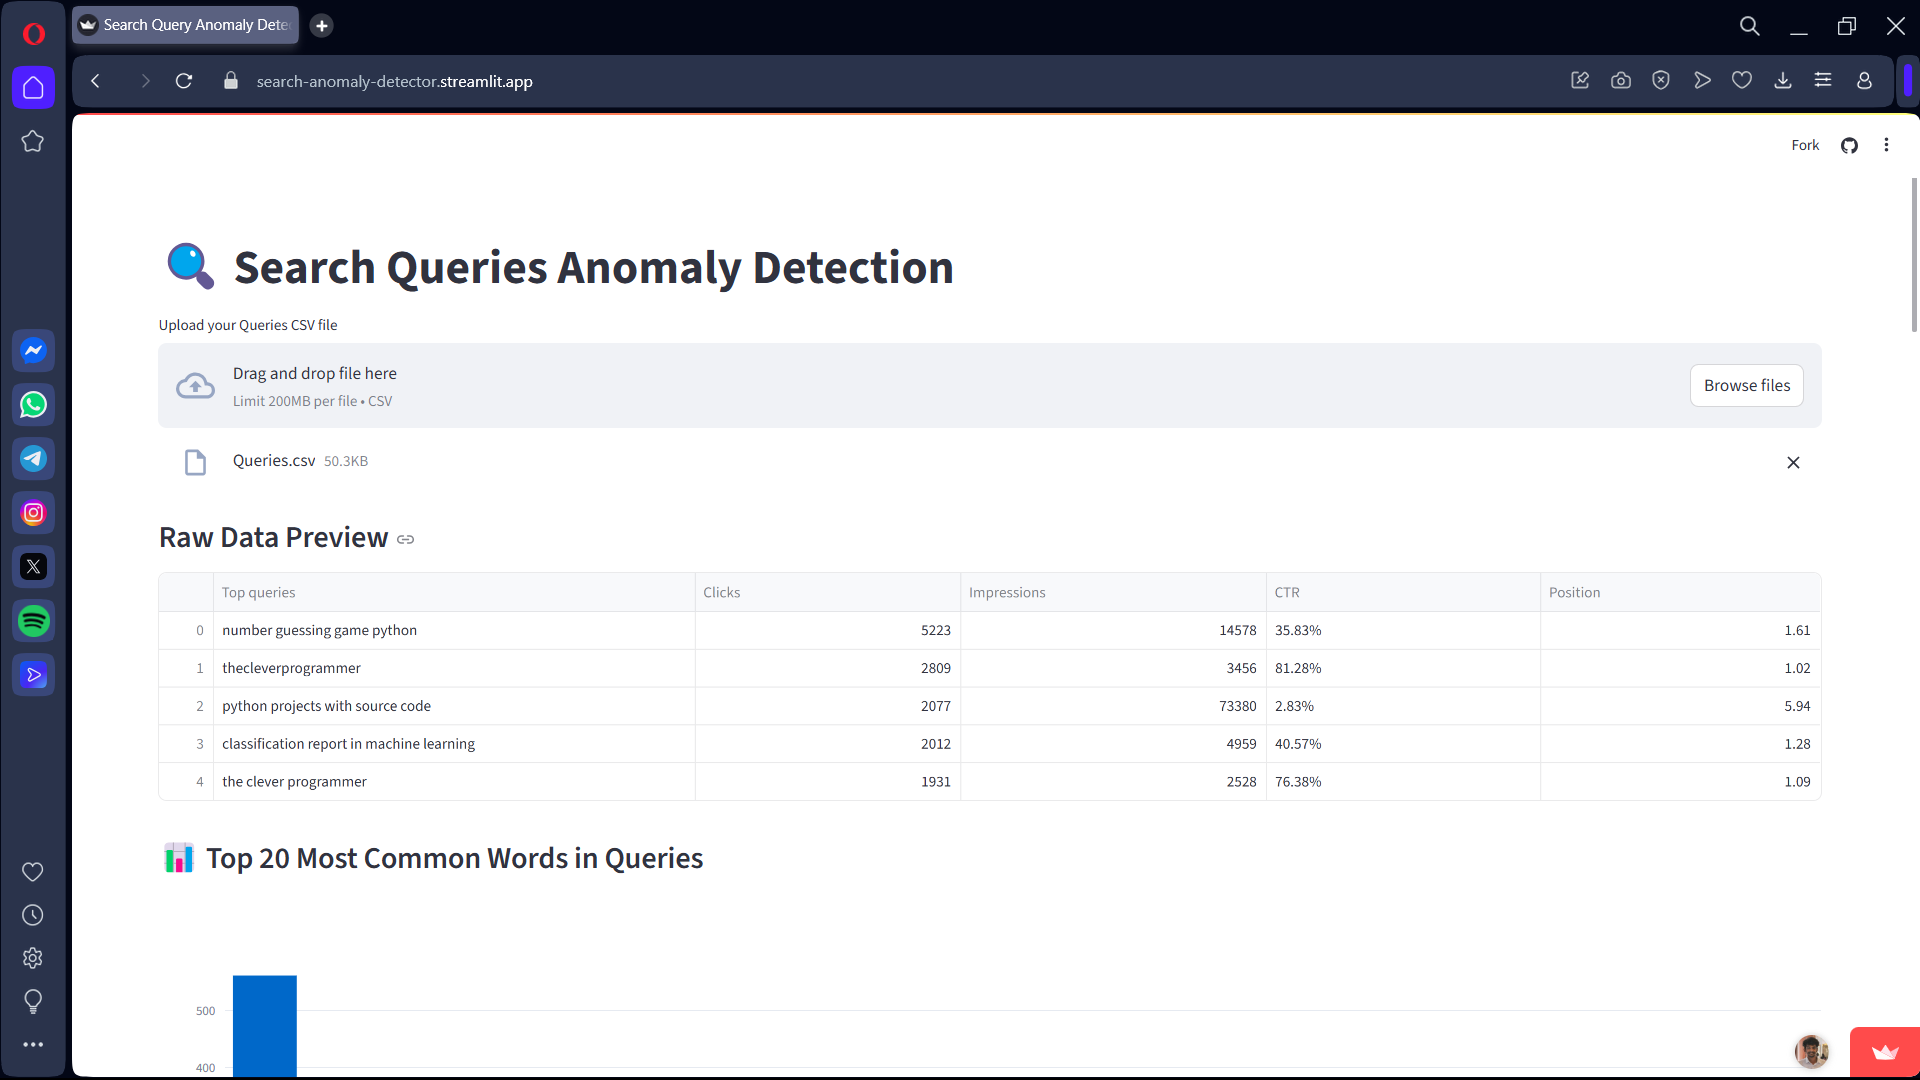
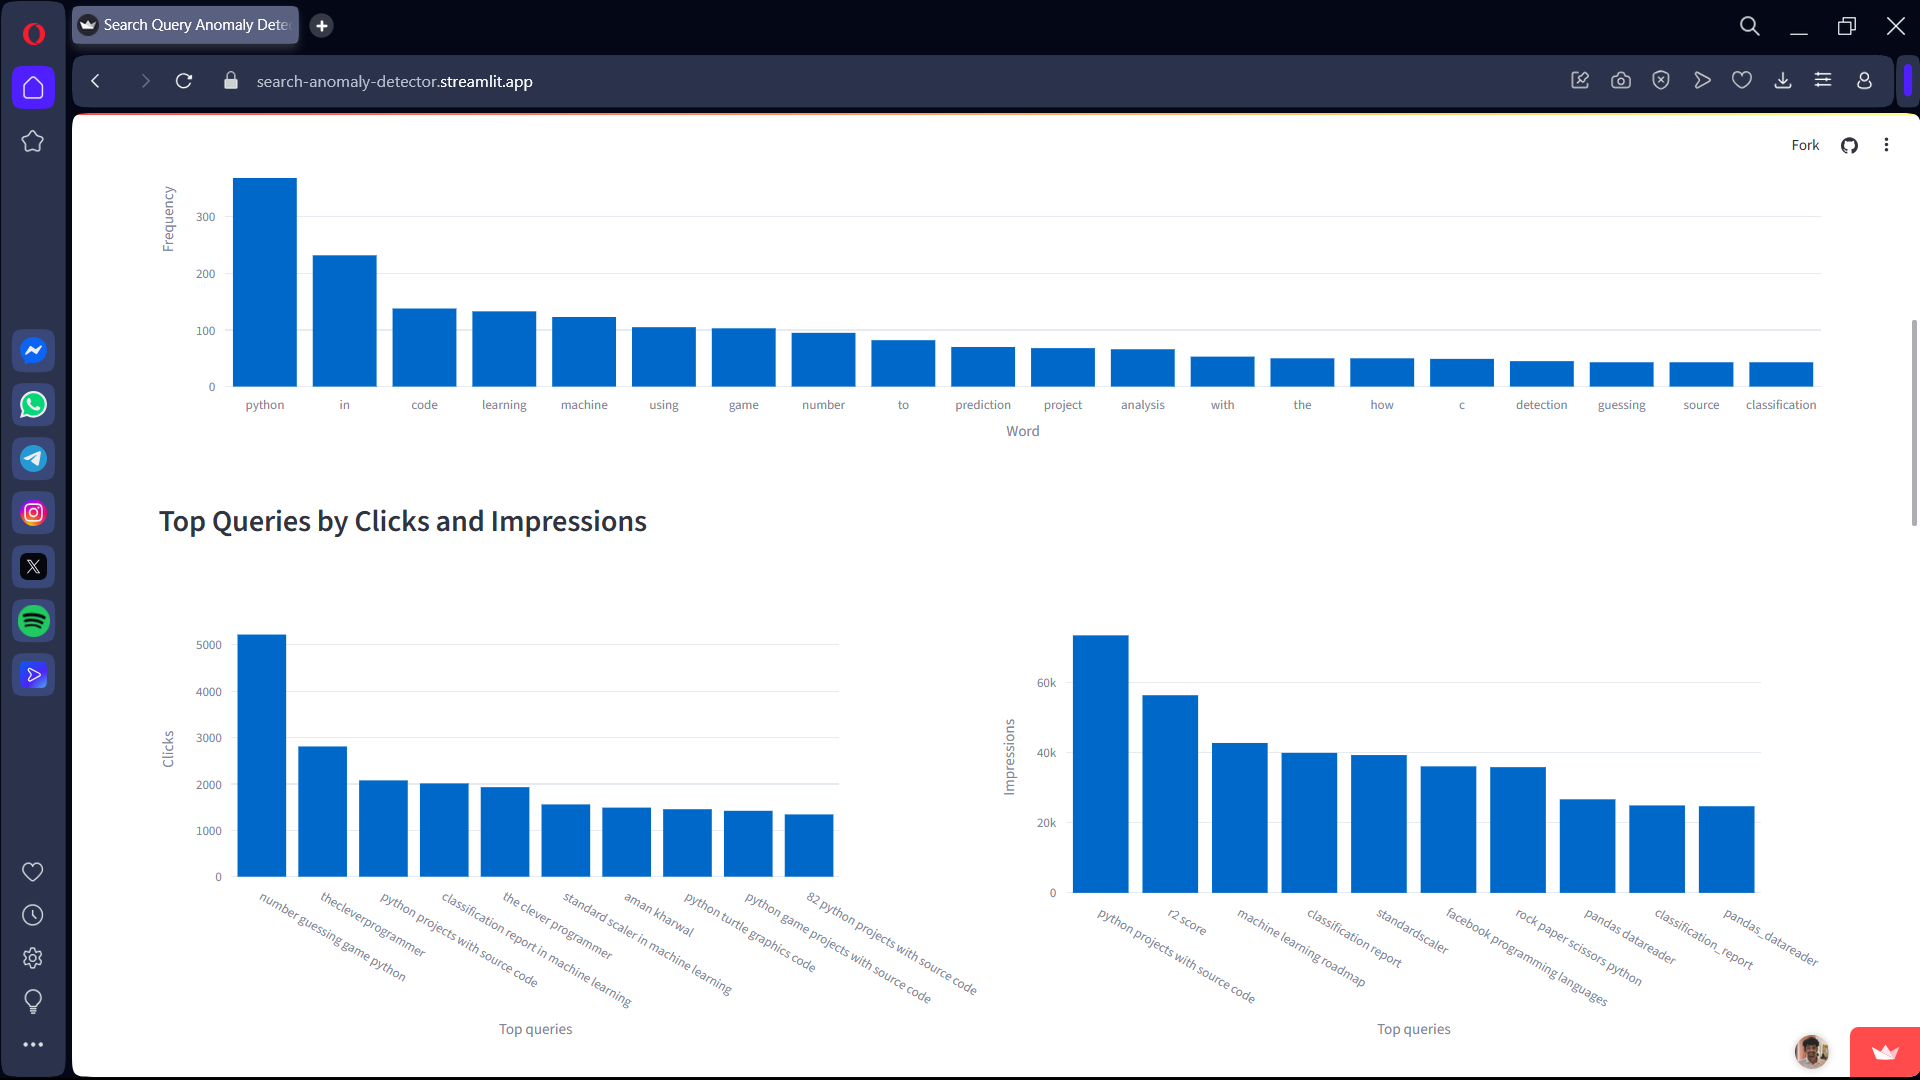
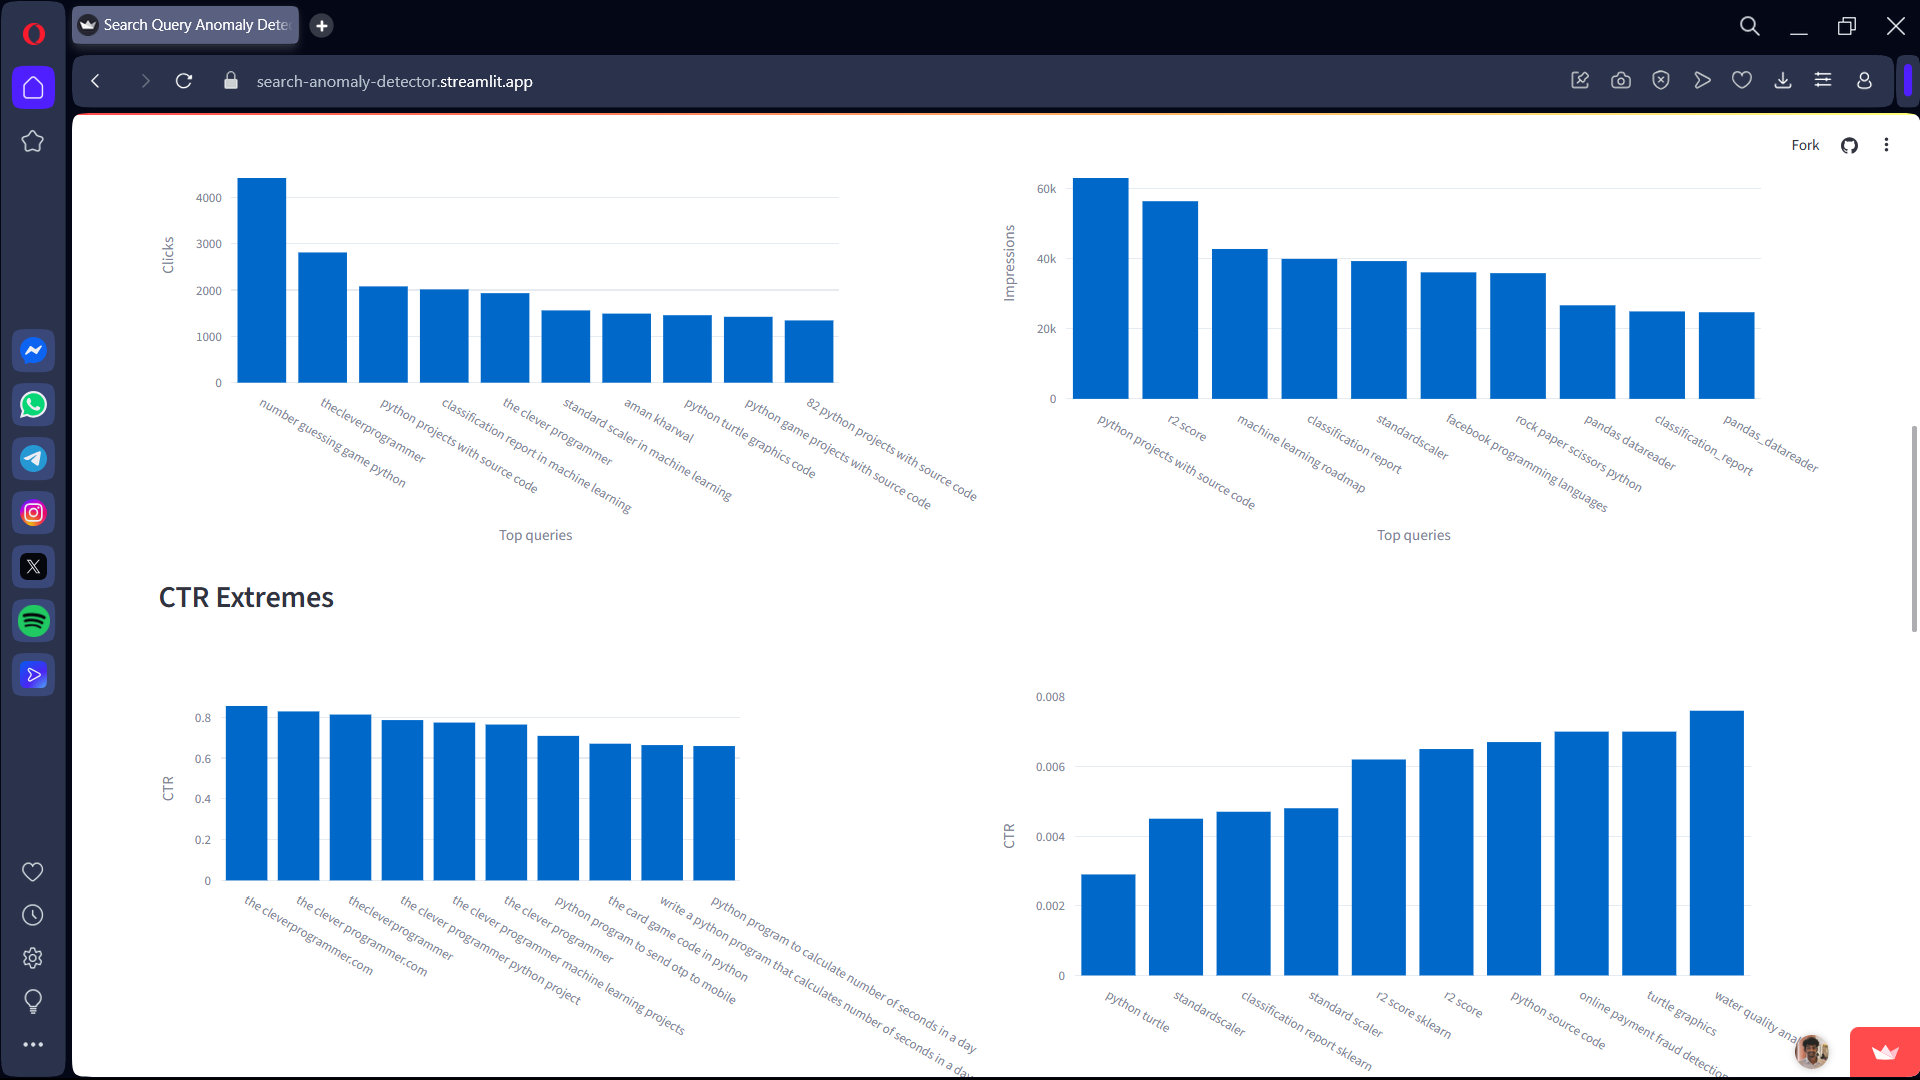
Data Ingestion: Loads Queries.csv with columns: Top queries, Clicks, Impressions, CTR, and Position. Data Preprocessing: Converts CTR from percentage strings (e.g., "35.83%") to floats (e.g., 0.3583). Exploratory Data Analysis (EDA): Shows a preview of the raw dataset. Visualizes the top 20 most frequent words in queries (e.g., "python," "machine"). Displays top queries by Clicks (e.g., "number guessing game python" with 5,223 clicks) and Impressions (e.g., "python projects with source code" with 73,380 impressions). Highlights highest/lowest CTR queries (e.g., "thecleverprogrammer.com" at 85.48%, "python turtle" at 0.29%). Presents a correlation matrix for numerical features.
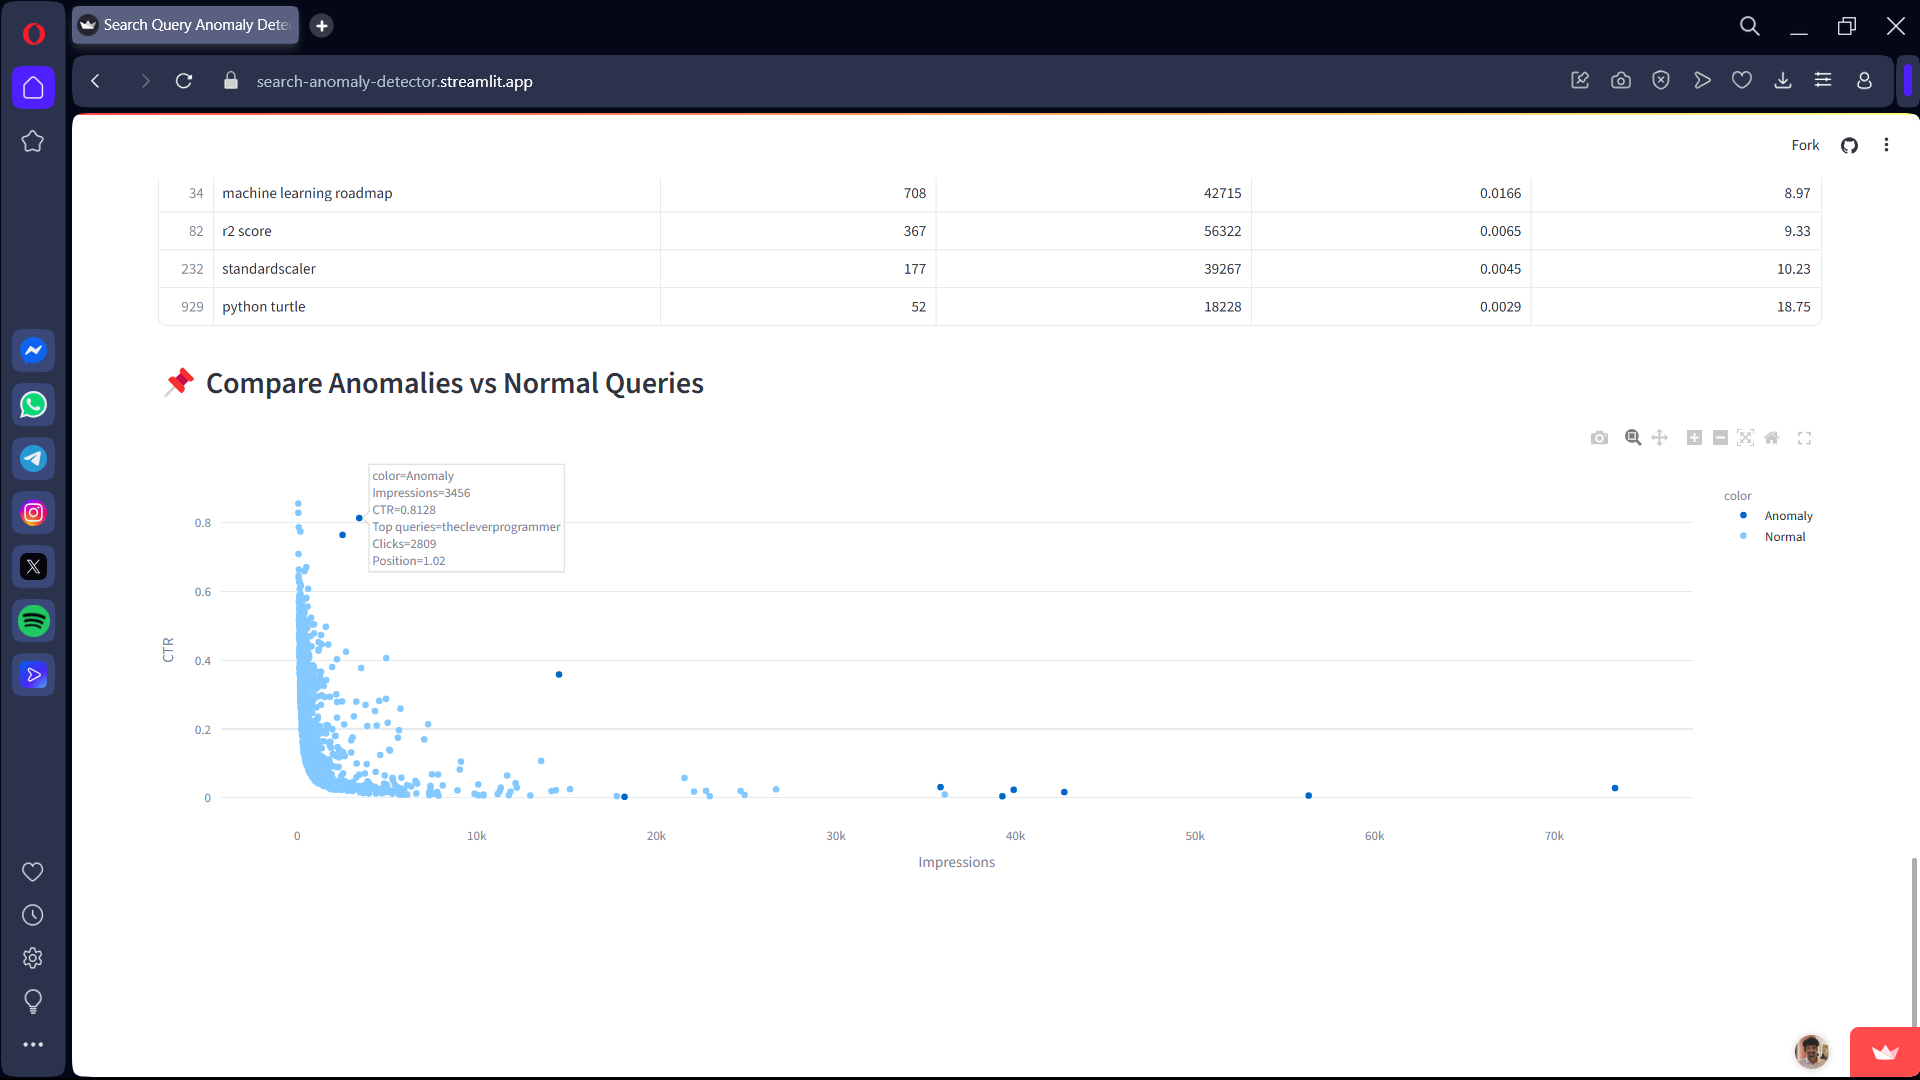
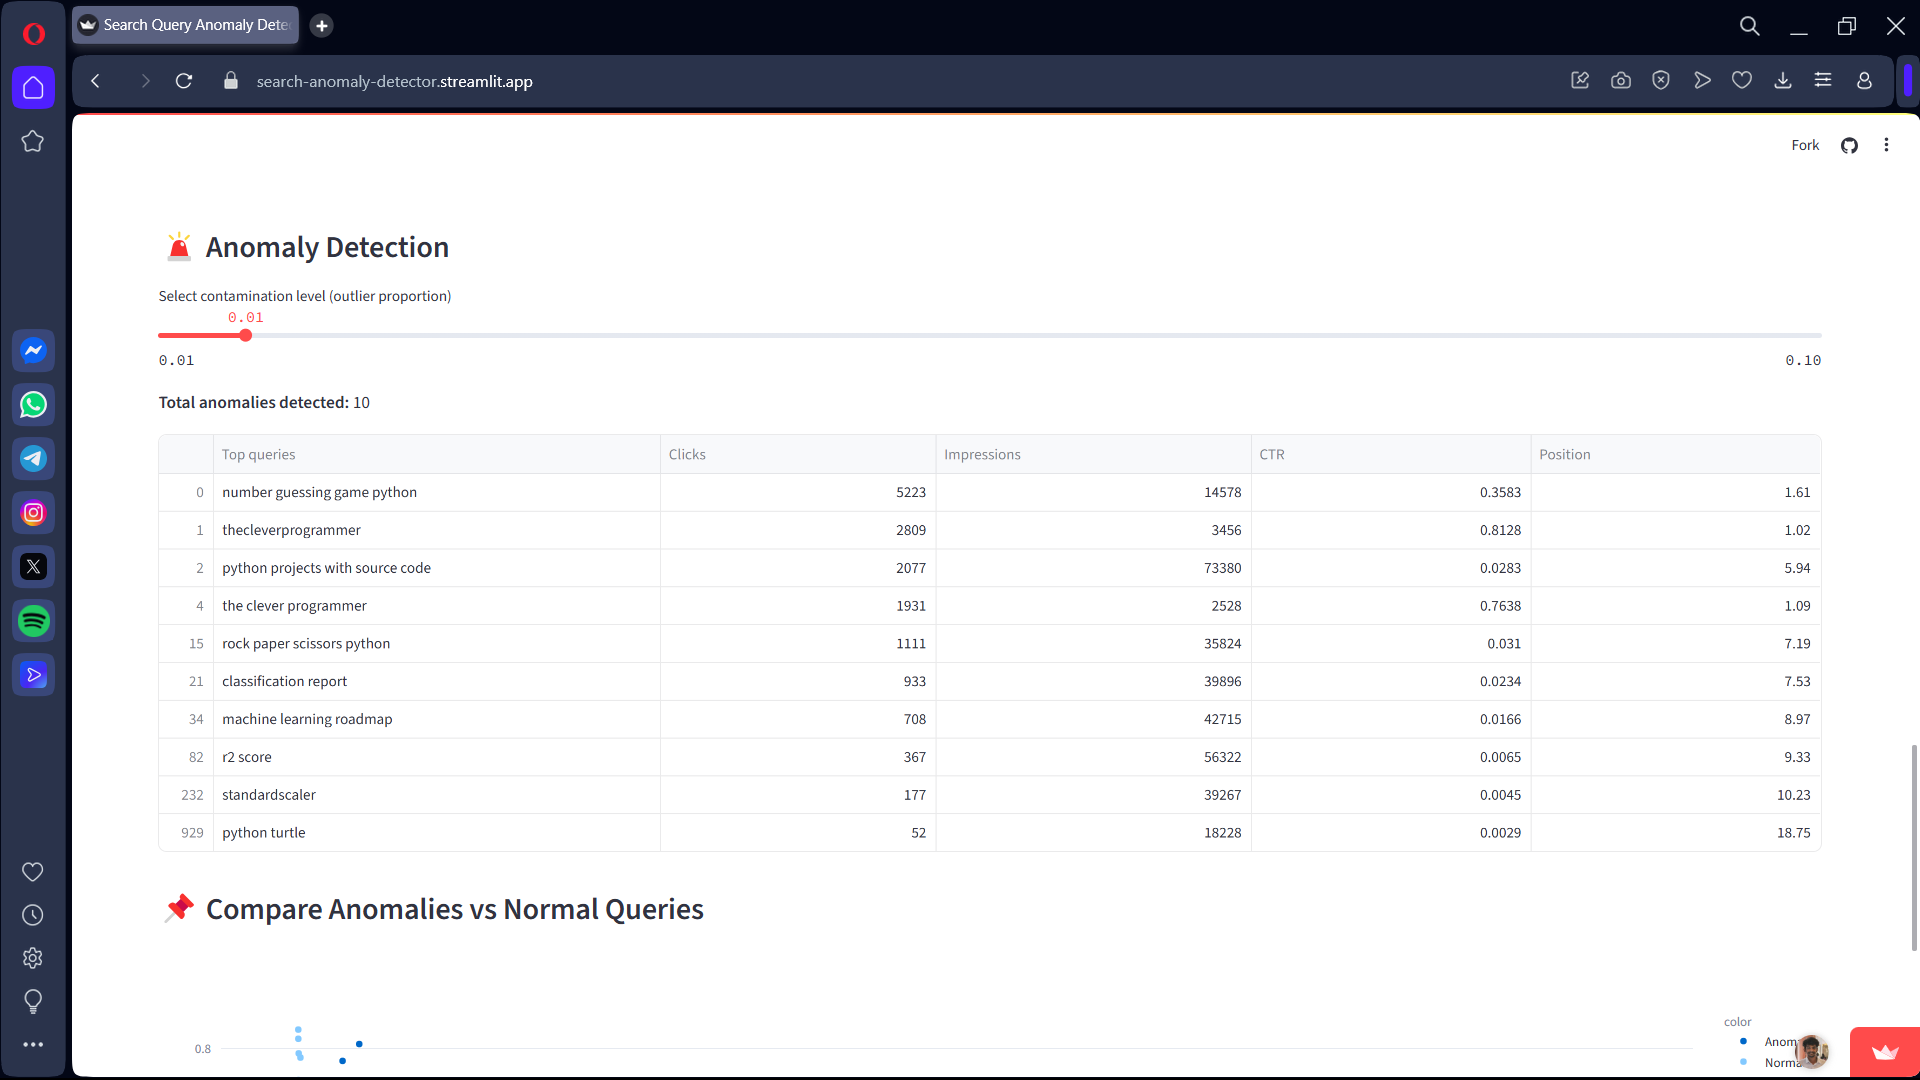
Anomaly Detection: Uses an Isolation Forest to identify outliers based on Clicks, Impressions, CTR, and Position. Interactive Visualizations: Provides a scatter plot comparing anomalies vs. normal queries, with hoverable details. User Customization: Offers a slider to adjust the contamination level (0.005–0.1) for anomaly sensitivity.
This enables users to pinpoint high-potential or problematic queries for data-driven SEO decisions.
Problem Addressed and Approach
Problem The Queries.csv dataset contains 614 search queries related to programming and machine learning, with metrics ranging from 48–5,223 Clicks, 62–73,380 Impressions, 0.29%–85.48% CTR, and 1.0–28.52 Position. Manually identifying outliers, like "thecleverprogrammer.com" with an 85.48% CTR, is time-consuming and error-prone. These anomalies may indicate irrelevant keywords, data errors, or optimization opportunities. Approach The app combines:
EDA: Bar charts, scatter plots, and correlation matrices reveal trends (e.g., high CTR for branded queries). Machine Learning: The Isolation Forest algorithm detects outliers in an unsupervised manner, ideal for Queries.csv. Interactivity: Streamlit’s interface allows users to upload Queries.csv, explore visualizations, and adjust contamination. Scalability: Efficiently processes 614 rows, delivering actionable outputs like anomaly tables and scatter plots.
This approach ensures rapid identification of anomalous queries, enhancing SEO strategy effectiveness. Machine Learning Model Development and Training Model Choice: Isolation Forest The Isolation Forest was chosen for:
Efficiency: Scales well for the 614-row dataset via random partitioning. Unsupervised Learning: Requires no labeled data, perfect for Queries.csv. Robustness: Handles varying feature scales (e.g., Impressions up to 73,380).
Feature Selection
The model uses:
Clicks: E.g., 5,223 for "number guessing game python". Impressions: E.g., 73,380 for "python projects with source code". CTR: E.g., 0.8548 for "thecleverprogrammer.com". Position: E.g., 1.0 for "the card game code in python".
These capture key performance metrics for anomaly detection.
Data Preprocessing
CTR Cleaning: Converts CTR strings (e.g., "35.83%") to floats (e.g., 0.3583). Standardization: Uses StandardScaler to normalize features. Dataset Size: 614 rows, ideal for real-time processing.
Training Process
Dataset: Queries.csv with 614 programming queries. Hyperparameters: n_estimators=100: Balances accuracy and speed. contamination: Adjustable (0.005–0.1, default 0.01). random_state=42: Ensures reproducibility.
Training: Fits on standardized features, labeling queries as normal (1) or anomalous (-1). Training Time: Near-instantaneous for 614 rows.
Dataset Source
Source: Queries.csv, likely from Google Search Console, with 614 programming and machine learning queries. Format: CSV with columns: Top queries, Clicks, Impressions, CTR, Position. Example:Top queries,Clicks,Impressions,CTR,Position number guessing game python,5223,14578,35.83%,1.61 thecleverprogrammer,2809,3456,81.28%,1.02 python projects with source code,2077,73380,2.83%,5.94
Characteristics: Focuses on Python and machine learning queries, with CTR ranging from 0.29% ("python turtle") to 85.48% ("thecleverprogrammer.com").
Integration into the App The Isolation Forest model is integrated as follows:
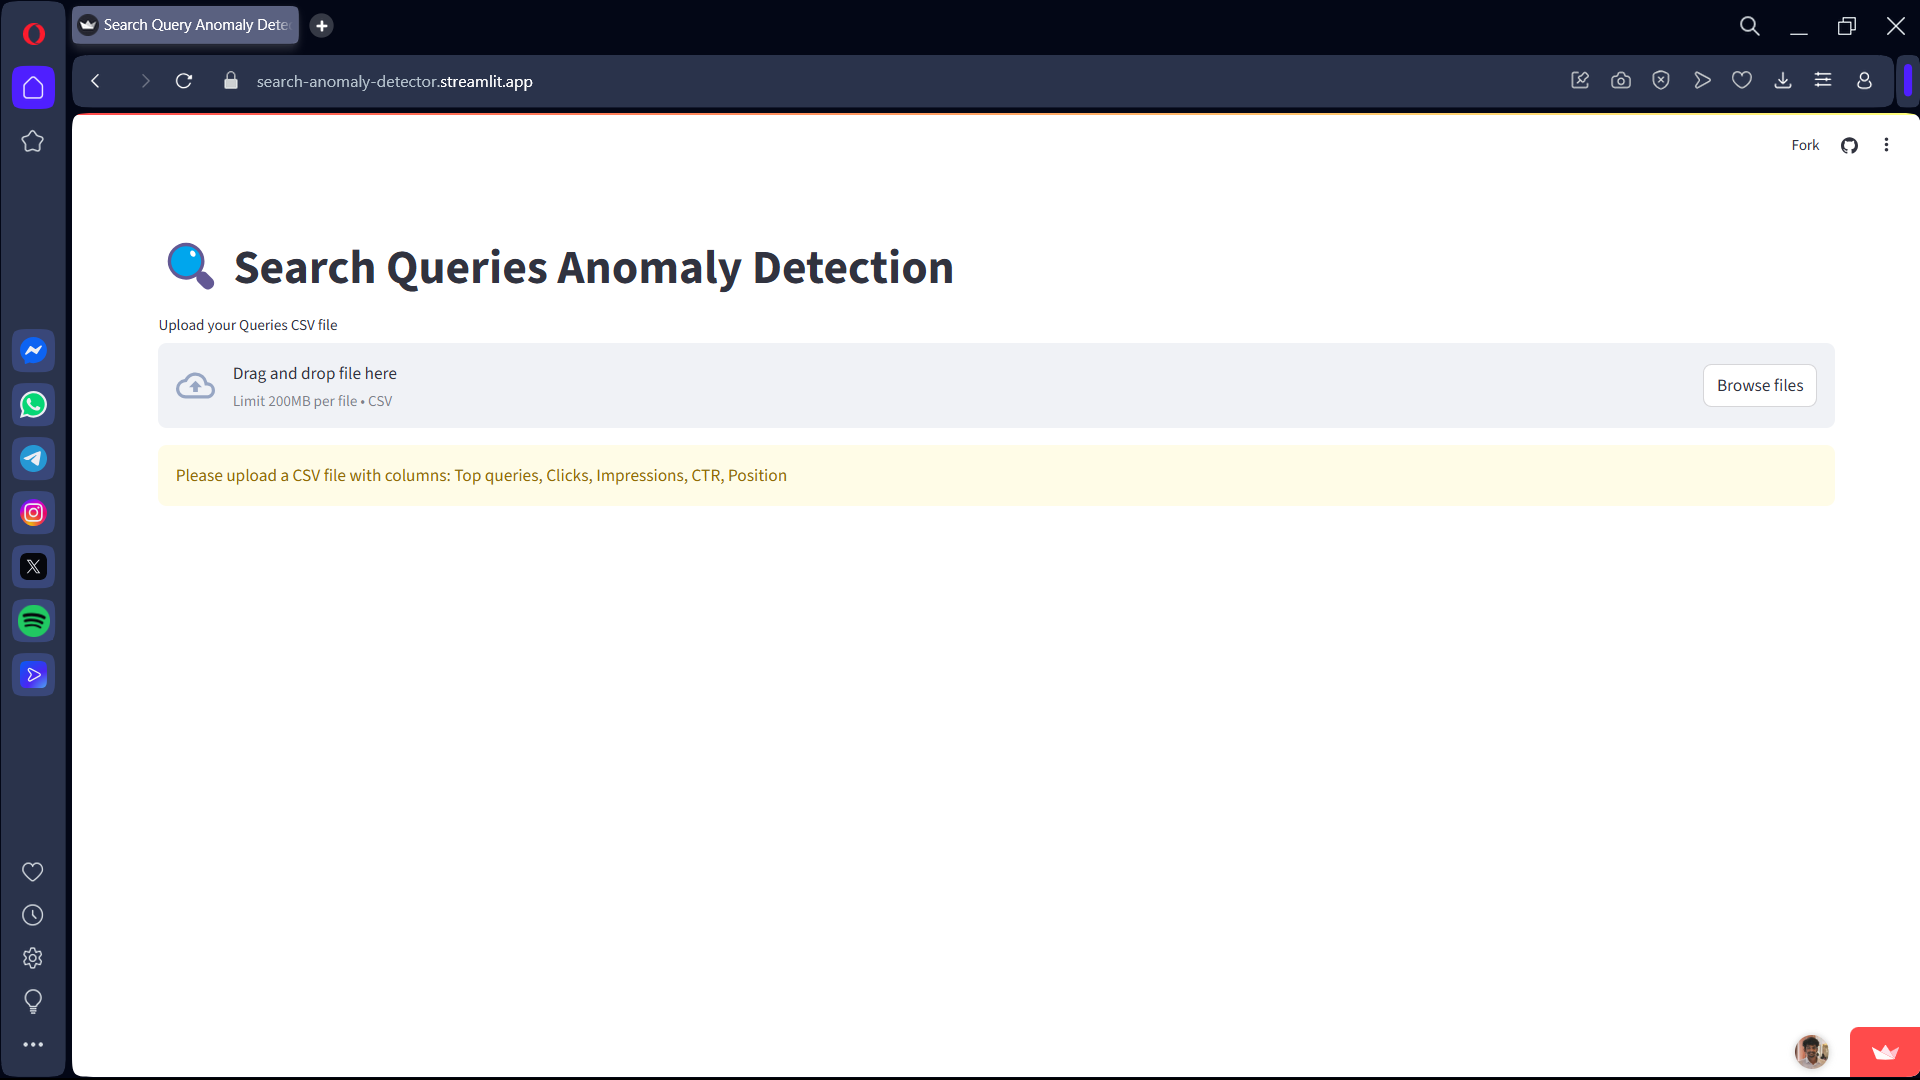
Data Input: Upload Queries.csv via Streamlit’s file uploader. Preprocessing: Converts CTR to floats and standardizes features. Model Execution: Trains on upload or slider adjustment. Output: Table: Lists anomalies (e.g., "thecleverprogrammer.com" with 85.48% CTR). Scatter Plot: Visualizes anomalies vs. normal queries (Impressions vs. CTR).
Interactivity: Adjust contamination slider to update results in real-time.
Documentation
Code Comments The streamlit_app.py code is documented, explaining:
Imports: Libraries like streamlit and scikit-learn.import streamlit as st st.set_page_config(page_title="Search Query Anomaly Detector")
Data Cleaning: E.g., queries_df['CTR'] = queries_df['CTR'].str.rstrip('%').astype('float') / 100. Visualizations: Word frequency, top queries, CTR extremes, correlation matrix. Anomaly Detection: Model training and result display.
Model Design Choices
Isolation Forest: Efficient for 614 rows and unsupervised tasks. StandardScaler: Normalizes diverse scales (Impressions, CTR). Contamination Slider: Adjusts sensitivity for datasets like Queries.csv.
Training Details
Algorithm: Isolation Forest with 100 trees. Features: Clicks, Impressions, CTR, Position. Hyperparameters: n_estimators=100, contamination=0.01 (adjustable), random_state=42. Training Time: Near-instantaneous.
Setup Instructions
Install Dependencies:pip install streamlit pandas plotly scikit-learn
Save Code: Save streamlit_app.py. Prepare Dataset: Ensure Queries.csv has required columns. Run App:streamlit run streamlit_app.py
Access: https://search-anomaly-detector.streamlit.app/ Analyze: Upload Queries.csv, adjust contamination, explore visualizations.
System Requirements
Python: 3.8+ Libraries: streamlit>=1.20.0, pandas>=1.5.0, plotly>=5.10.0, scikit-learn>=1.2.0 OS: Windows, macOS, Linux Browser: Chrome, Firefox, Safari
Conclusion
The Search Query Anomaly Detector leverages Isolation Forest and Streamlit to analyze Queries.csv, identifying anomalies in 614 programming queries. With interactive visualizations and customizable detection, it empowers SEO professionals to optimize strategies, uncovering insights like high-CTR branded queries. Its robust design and documentation make it a scalable solution for SEO challenges.
Built With
- pandas
- plotly
- python
- scikit-learn
- streamlit
- unsupervised

Log in or sign up for Devpost to join the conversation.