Inspiración
La línea telefónica de un banco es la puerta de entrada para millones de personas en América Latina — y para muchas de ellas, es la única puerta. No usan la app. Llaman.
La voz solía ser prueba de identidad. Ya no lo es: bastan unos segundos de audio público para clonar a alguien de forma convincente. Así que nos hicimos una pregunta que terminó definiendo todo el proyecto:
Todos intentan detectar voces sintéticas escuchando la voz. ¿Y si escucháramos la conversación?
Dos cosas nos empujaron hacia ahí. Primero, el reto te entrega los dos lados de la llamada y dice que es "por una razón" — si solo importara la voz de quien llama, el canal del agente sobraría. Segundo, el audio es telefonía de 8 kHz, y casi toda la investigación de anti-spoofing está entrenada con audio limpio de 16 kHz, donde los artefactos del vocoder viven arriba de los 4 kHz. La línea telefónica borra justamente la evidencia que todos los demás buscan.
Qué hace
VoiceGuard recibe una llamada telefónica grabada y decide si quien llama es una persona real o una voz sintética.
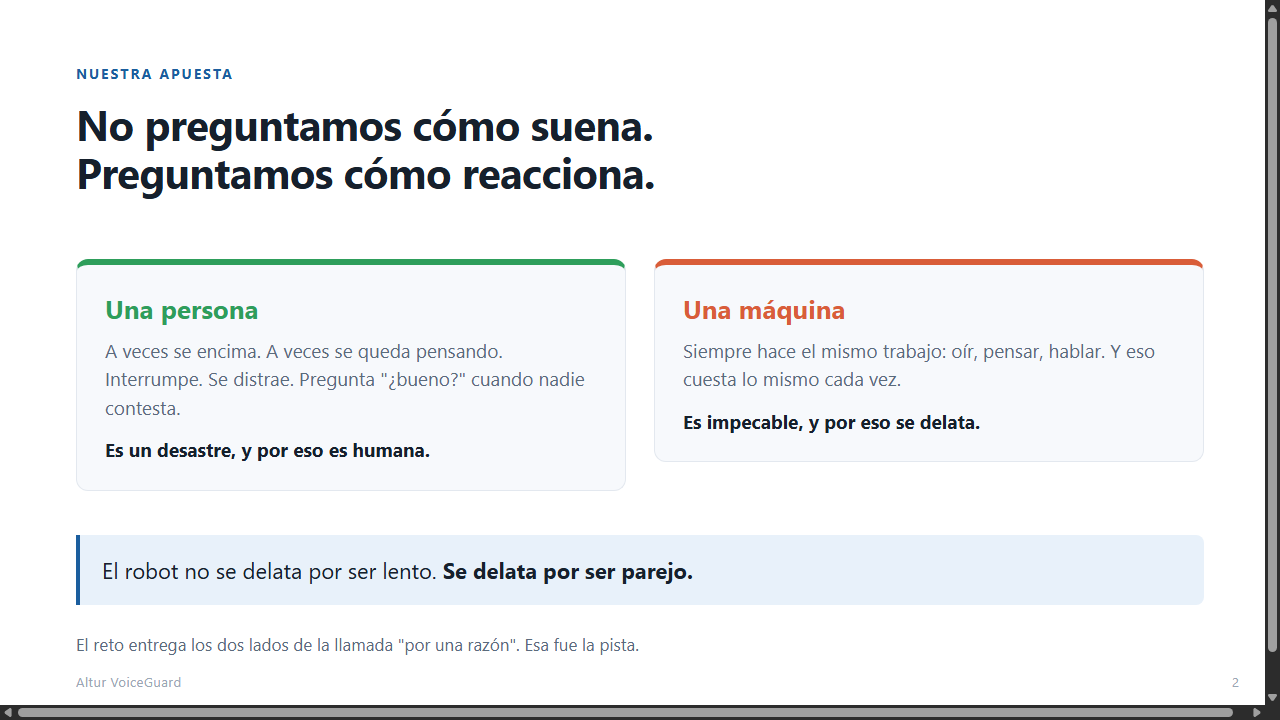
La idea de fondo: un bot no se delata por ser lento. Se delata por ser consistente.
Una persona responde de forma caótica — a veces se encima a los 150 ms, a veces se queda callada dos segundos, interrumpe, se distrae, pregunta "¿bueno?" cuando nadie contesta. Una voz sintética siempre paga el mismo costo: reconocer el audio, correr un modelo de lenguaje, sintetizar el habla. Y eso tarda lo mismo en cada turno.
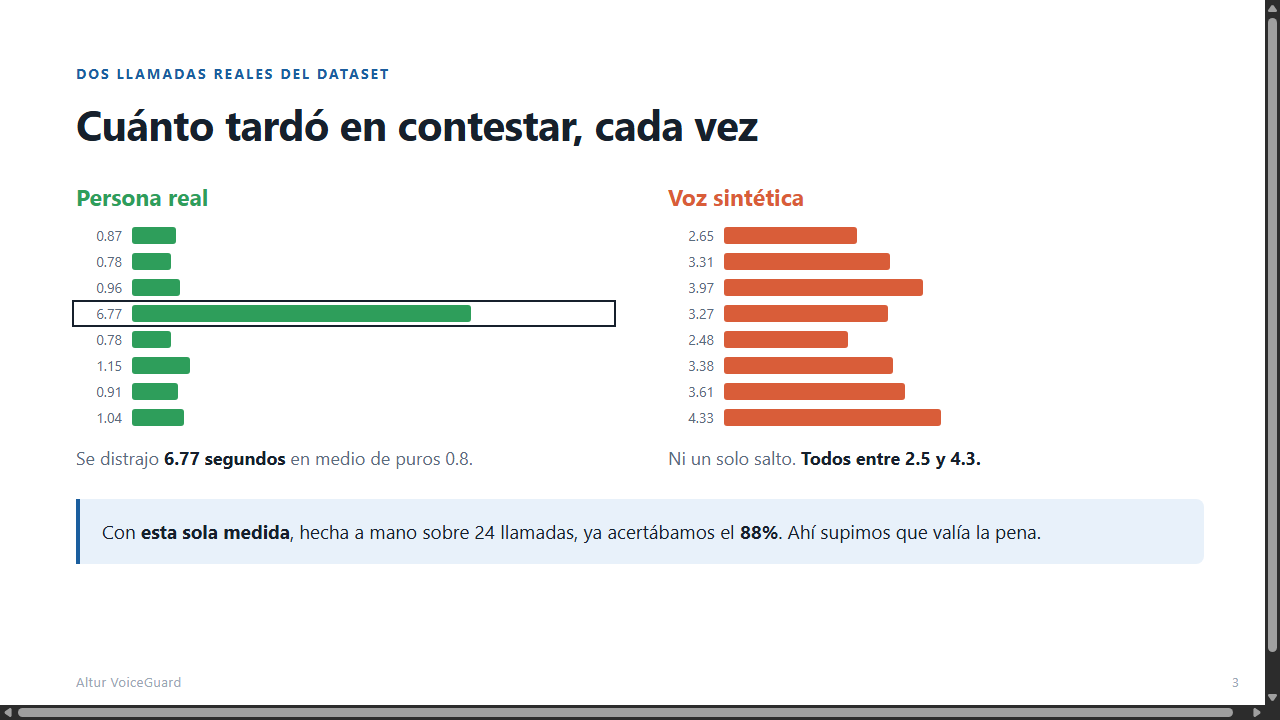
Estas son dos llamadas reales del dataset — tiempos de respuesta, uno tras otro:
Persona real     0.87  0.78  0.96  6.77  0.78  1.15  0.91  1.04
                                   (se distrajo)

Voz sintética    2.65  3.31  3.97  3.27  2.48  3.38  3.61  4.33  ni un solo salto
El sistema expone POST /detect, recibe un WAV estéreo de 8 kHz en base64, y devuelve {"is_synthetic": bool, "confidence": float}.
Cómo lo construimos
Hicimos una lluvia de ideas antes de escribir una sola línea de código, y después usamos IA para convertir esas ideas en una arquitectura. El criterio fue nuestro: qué señal perseguir, qué medir, y cuándo desconfiar de un resultado que salía demasiado bien.
Validamos la hipótesis antes de construir nada. Tomamos 24 llamadas y calculamos un solo número a mano — qué tan consistentes son los tiempos de respuesta. Dio 88% de acierto. Esa hora nos dijo que la idea valía el fin de semana. Si hubiera salido 55%, habríamos cambiado de estrategia esa misma tarde en lugar de descubrirlo al final.
El proceso, por cada llamada:
- Separar el estéreo en quien llama y el agente
- Encontrar los turnos de voz en ambos canales — detección por energía con umbral adaptativo, calculado para cada llamada (el nivel de voz varía 19 dB entre llamadas del dataset; un umbral fijo se pierde por completo a quienes hablan bajito)
- Medir 42 atributos — 23 sobre cómo conversa, 19 sobre cómo suena la voz
- Fusionarlos con una regresión logística en una probabilidad calibrada
No hay una sola red neuronal en este proyecto. Es procesamiento de señal más un modelo estadístico de 42 coeficientes. El modelo entrenado pesa 4 KB.
Lo que el modelo realmente aprendió
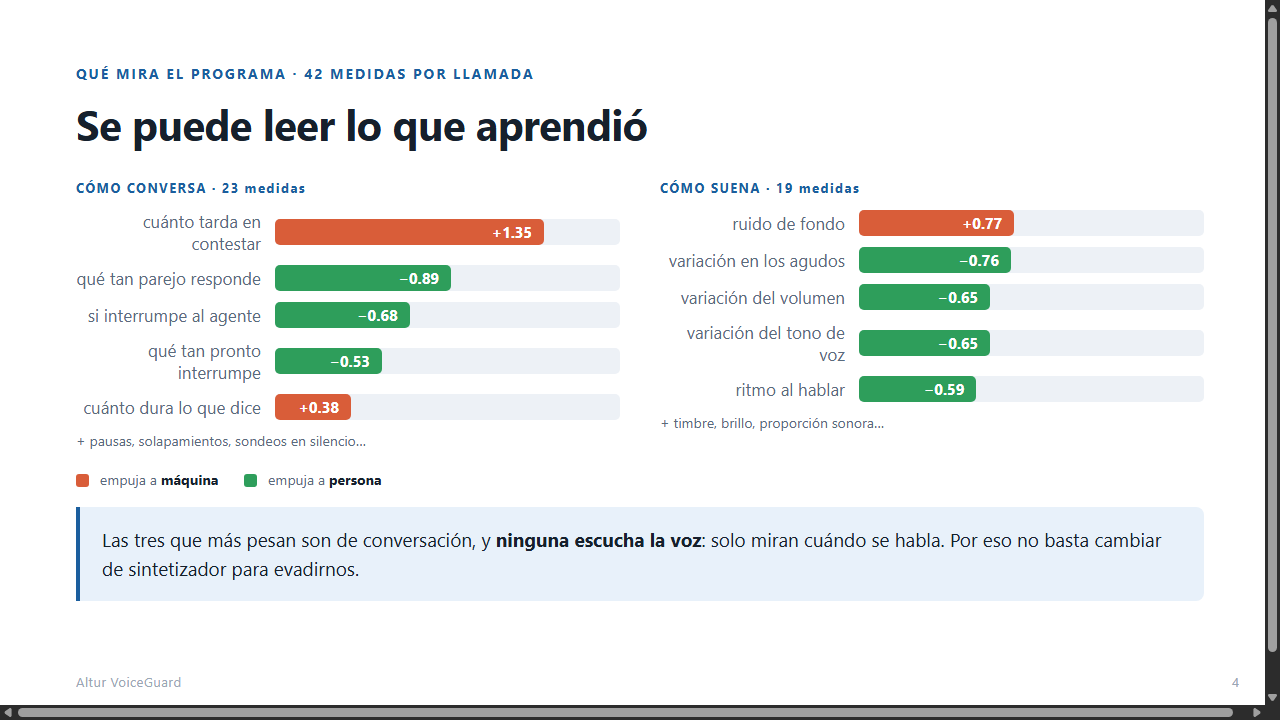
Podemos leer cada coeficiente. Los más importantes:
| Peso | Empuja hacia | Atributo |
|---|---|---|
| +1.35 | máquina | cuánto tarda en contestar |
| −0.89 | persona | qué tan consistentes son esos tiempos |
| −0.68 | persona | si interrumpe al agente |
| +0.77 | máquina | nivel del ruido de fondo |
| −0.65 | persona | variación del tono de voz |
Los tres atributos conversacionales que más pesan nunca escuchan la voz — solo miran cuándo ocurre el habla. Evadirlos no requeriría un mejor modelo de síntesis; requeriría rediseñar la arquitectura de latencia del atacante.
Retos que enfrentamos
Ninguno de nosotros había construido una API antes. Ninguno había trabajado con audio tampoco. Es el primer hackathon de los cuatro, y venimos de Multimedia y Animación, IA y Ciencia de Datos, y Tecnologías Computacionales. Descubrir por dónde siquiera empezar fue el primer obstáculo real.
El problema de los 8 kHz. El ancho de banda telefónico destruye los artefactos de alta frecuencia en los que se apoyan los detectores de spoofing que ya existen. Por eso no podíamos simplemente afinar algo preentrenado.
Medir con honestidad fue más difícil que construir. Estuvimos a punto de reportar un número inflado: primero evaluamos el endpoint con un modelo que ya había visto el conjunto de validación. Número real, resultado sin sentido. Lo repetimos entrenando solo con el grupo de entrenamiento.
Elegir dónde desplegarlo. Medimos antes de suponer: los envíos de los jueces pesan 6.3 MB en promedio (WAV en base64, hasta 11.7 MB), y Vercel limita las peticiones a 4.5 MB — 332 de 353 llamadas, el 94%, habrían sido rechazadas. Nos movimos a Render.
Un arranque en frío de 1.2 segundos. La primera petición de cada proceso pagaba la carga diferida de las librerías. Si esa hubiera sido la primera llamada de los jueces, nos habrían medido seis veces más lentos de lo que somos. Ahora el servicio se precalienta al arrancar.
Logros de los que estamos orgullosos
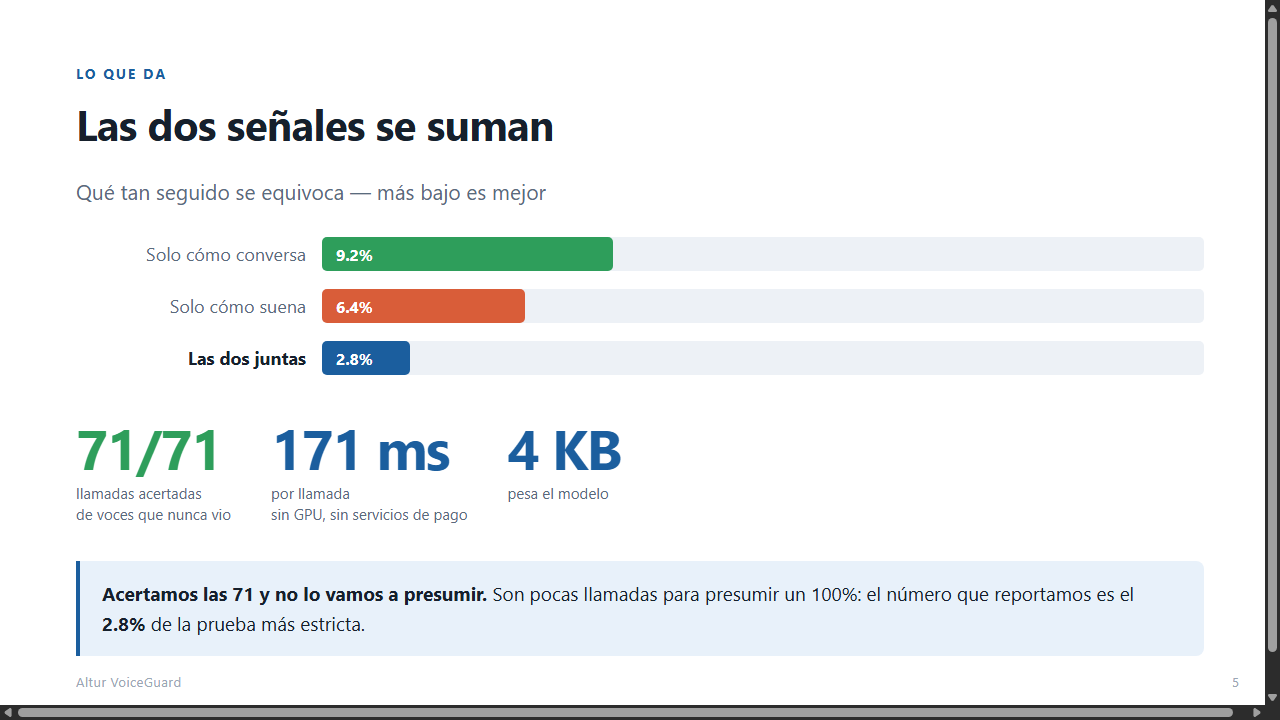
2.8% de tasa de error (EER) en validación cruzada de 5 particiones sobre 282 llamadas.
71 de 71 correctas en el conjunto de validación — hablantes que nunca aparecen en el entrenamiento.
171 ms por llamada en CPU. Sin GPU, sin servicios de pago, sin mandar el audio del cliente a terceros. Un banco podría desplegarlo de verdad.
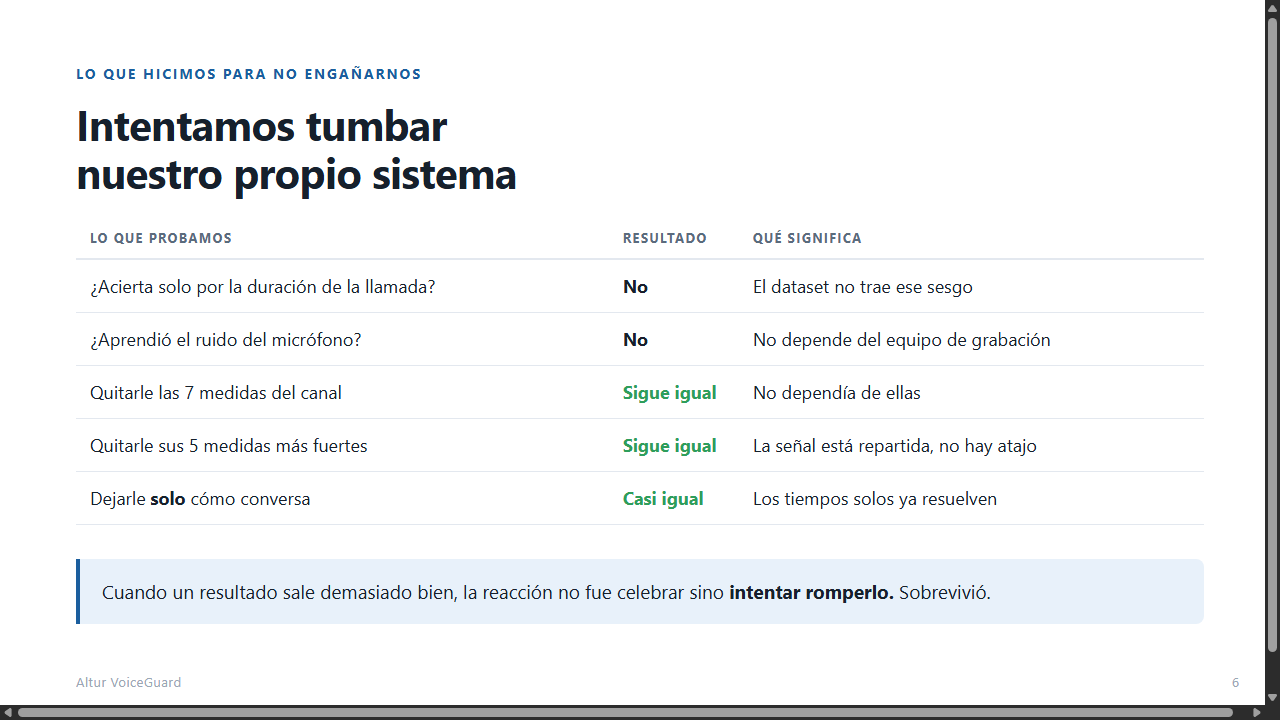
Pero de lo que más orgullosos estamos es de lo que hicimos después de obtener un buen número. Intentamos romper nuestro propio sistema:
| Prueba | Resultado | Qué significa |
|---|---|---|
| ¿La duración de la llamada por sí sola separa las clases? | No (AUC 0.53) | No hay sesgo en la construcción del dataset |
| ¿Aprendimos el ruido del micrófono? | No (AUC 0.57) | No depende del equipo de grabación |
| Quitar los 7 atributos de canal | Sin cambio | No dependíamos de ellos |
| Quitar los 5 atributos más fuertes | Sin cambio | La señal está distribuida, no hay atajo |
| Solo atributos conversacionales | Casi idéntico | El timing por sí solo casi lo resuelve |
Y no estamos presentando ese 100% como nuestro titular. 71 llamadas es una muestra pequeña: cero errores en 71 intentos no significa que el error real sea cero. El número que reportamos es el 2.8%, porque es el más conservador.
Lo que aprendimos
Pensar antes de teclear. La idea buena no salió de programar — salió de leer el reto con cuidado y preguntarnos por qué nos daban los dos canales.
Lo simple ganó. Sin redes neuronales, sin modelos preentrenados, sin APIs externas. Y gracias a eso, podemos explicar cada decisión que toma el sistema. Si un banco pregunta por qué se marcó una llamada, hay respuesta.
Medir cuesta más que construir. Hacer que funcionara fue una parte. Asegurarnos de que el número era real — separar los grupos por hablante, cazar atajos, desconfiar de un 100% — fue la otra, y es la que no se ve.
Desconfiar de lo que sale bien. Cuando vimos 100% en validación, la reacción no fue celebrar. Fue intentar tumbarlo. Sobrevivió.
Qué sigue para RetoAlturTortuHackers26
La señal semántica. El agente pregunta a quien llama por cosas que no existen. Una persona dice "no tengo eso". Un modelo de lenguaje tiende a inventar una respuesta. Esa señal es ortogonal a las dos que ya tenemos y sería la más difícil de evadir de las tres.
Detección en tiempo real. Los atributos conversacionales se pueden calcular de forma incremental — cada turno del agente produce un dato nuevo. Tres o cuatro intercambios son unos 30 segundos de llamada, que es antes de que el cliente entregue cualquier dato sensible.
El atacante adaptativo. La respuesta obvia contra nosotros es aleatorizar los tiempos de respuesta. Simularíamos a ese atacante y mediríamos exactamente cuánto nos degradamos — y cuánto aguanta la rama acústica (6.4% de error por sí sola).
Built With
- anti-spoofing
- audio-processing
- fastapi
- github
- joblib
- logistic-regression
- machine-learning
- numpy
- python
- render
- rest-api
- scikit-learn
- signal-processing
- soundfile
- uvicorn
- voice-activity-detection

Log in or sign up for Devpost to join the conversation.