Inspiration
La plupart des gens qui investissent remplissent un questionnaire de risque une seule fois, reçoivent un portefeuille, puis se retrouvent seuls. Quand ils entendent parler de Tesla ou du Bitcoin, personne ne vérifie si cela correspond à ce qu'ils ont dit pouvoir supporter. Et s'ils posent la question à un robot conversationnel, celui-ci répond avec assurance, parfois avec des chiffres inventés.
Le cas AlphaForge AI nous a présenté trois investisseurs : Robert, 59 ans et prudent; Mateo, 41 ans, qui accorde de l'importance à l'ESG; et Amira, 26 ans, qui accepte un risque élevé, mais pour qui « risque élevé » ne veut pas dire « tout est permis ». Nous voulions un outil capable de dire à chacun, avec de vrais chiffres, si une modification convient à son profil et pourquoi, puis de le laisser décider.
Ce que fait le projet
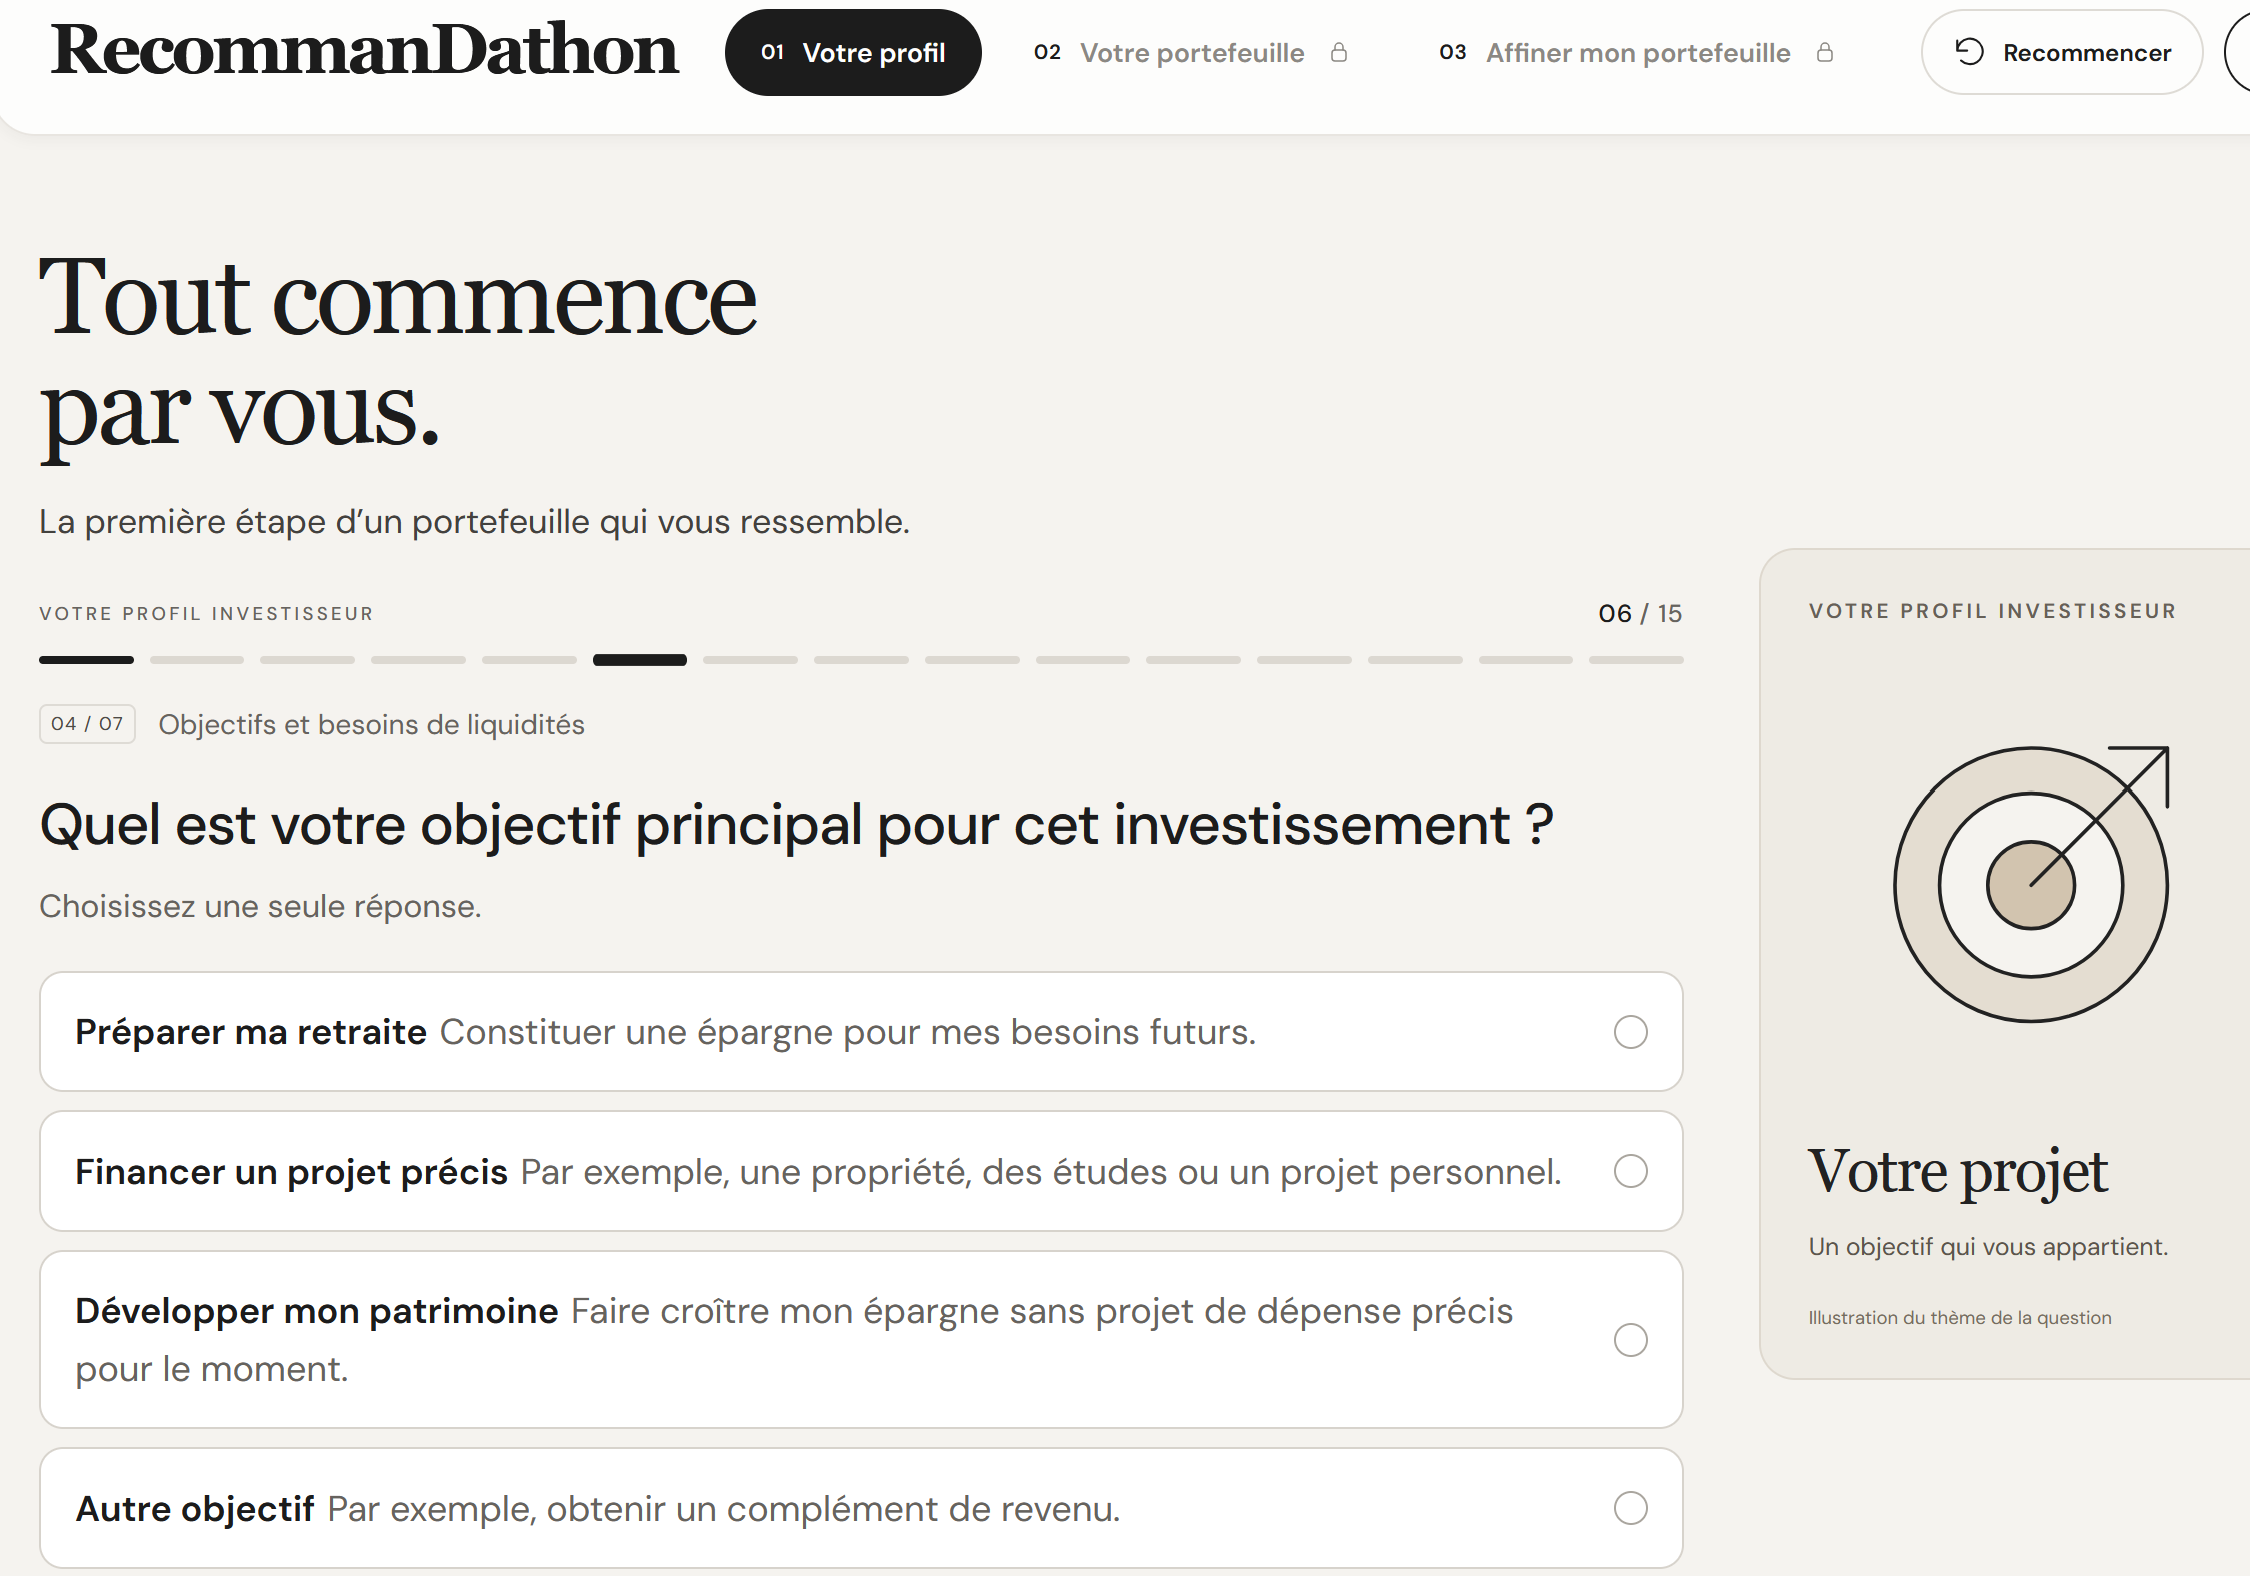
- Un court questionnaire en français place l'investisseur dans l'un de 15 portefeuilles de référence (3 bandes de risque × 5 styles).
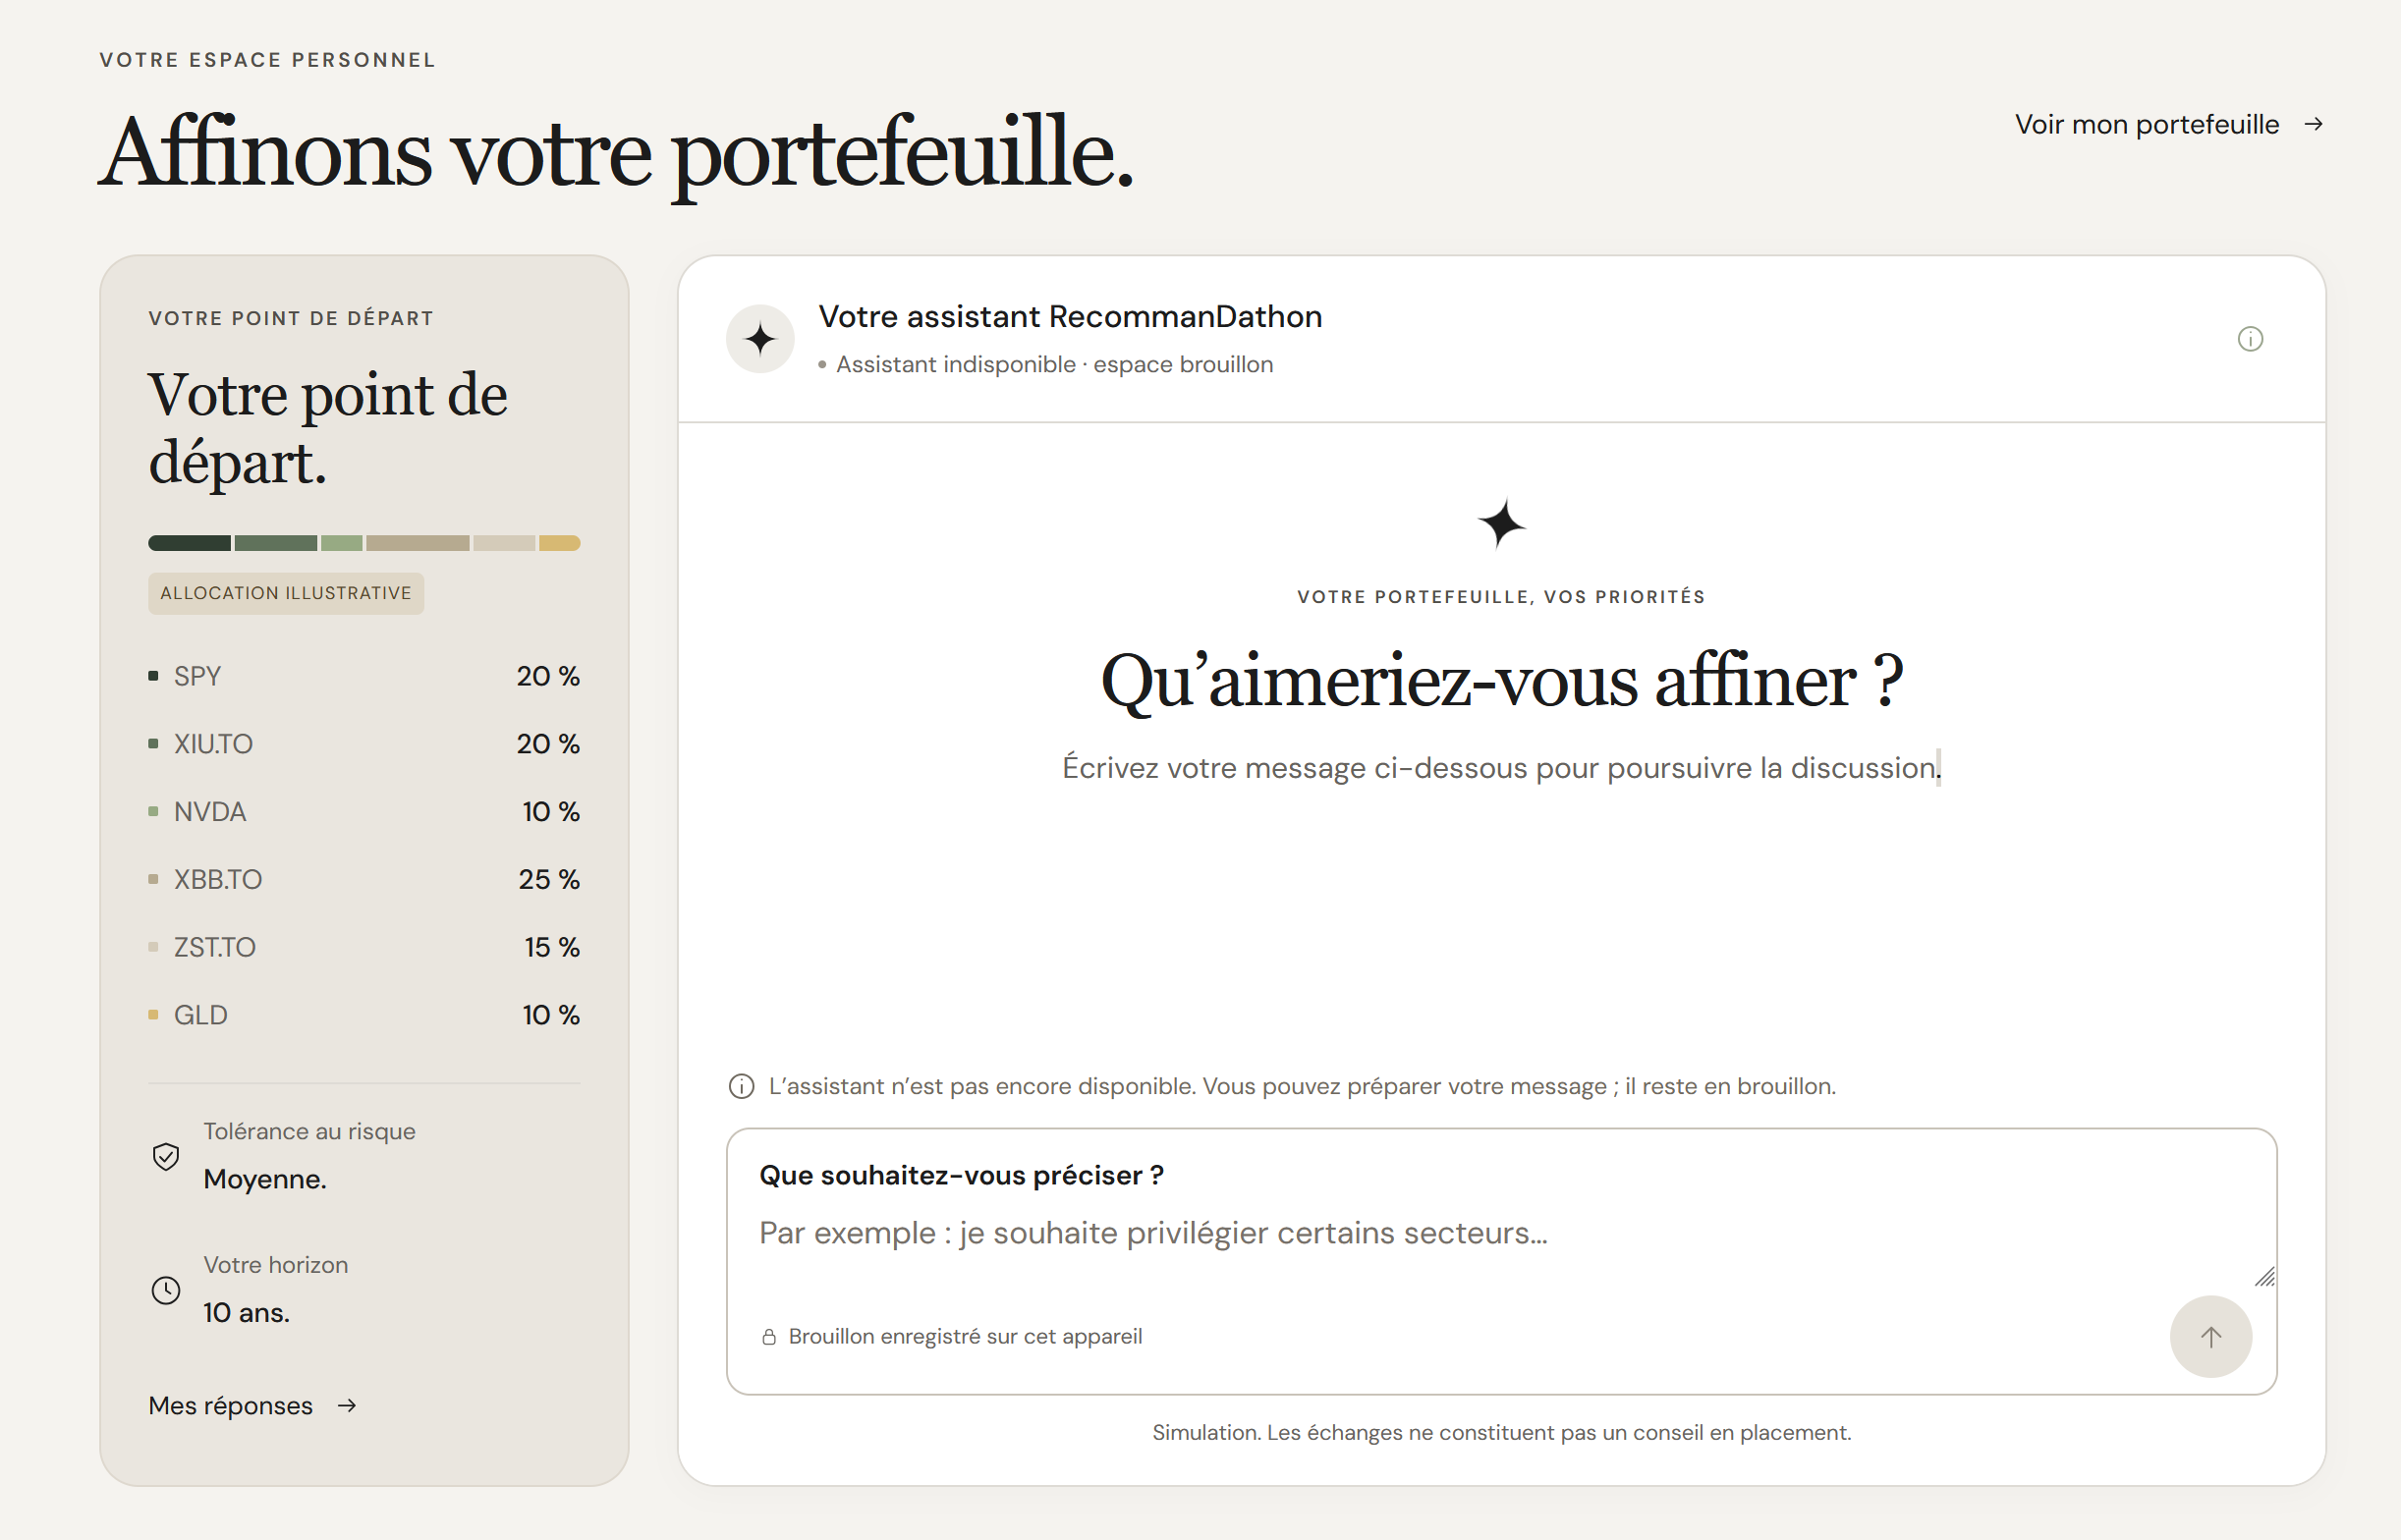
- L'investisseur demande n'importe quelle modification en français ou en anglais courant, par exemple « Ajoutez 20 % de TSLA. »
- Avant que rien ne change, Recommand simule la demande sur cinq ans de données hebdomadaires en dollars canadiens, vérifie chaque limite du profil et trouve la plus grande version de la demande qui reste conforme.
- Il explique le verdict avec des chiffres que l'investisseur peut vérifier, et la modification n'est conservée que s'il la confirme.
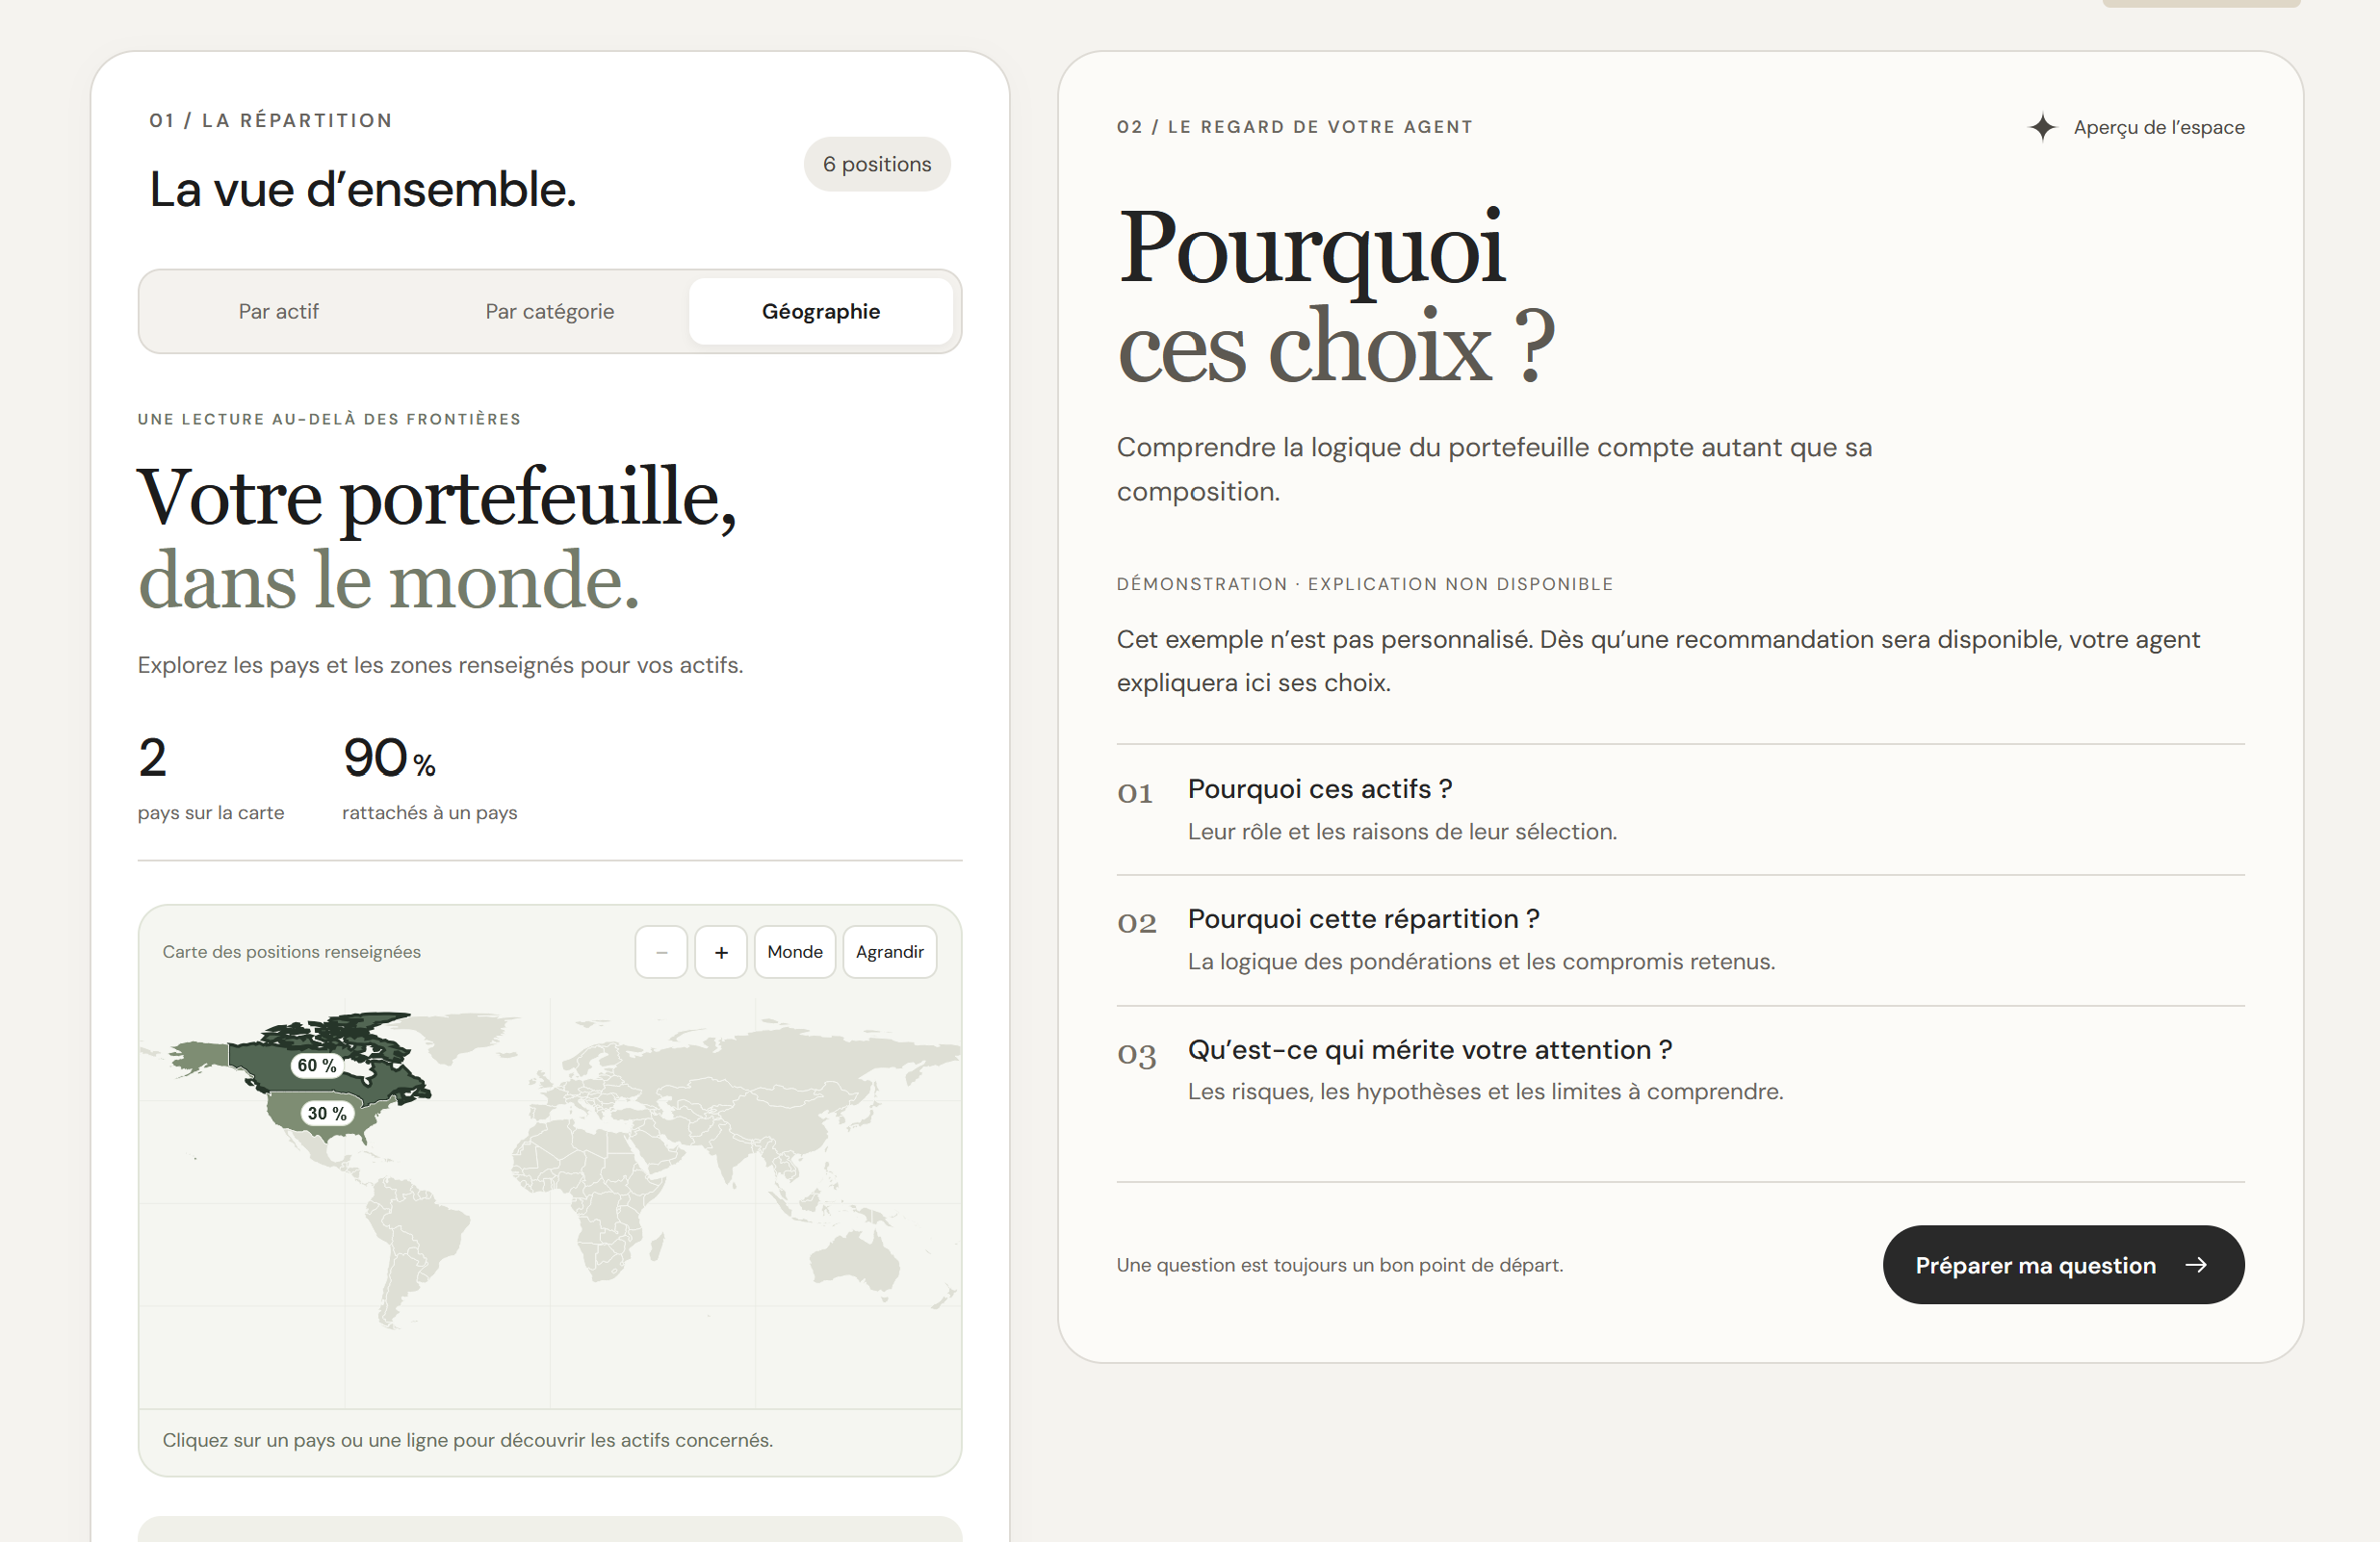
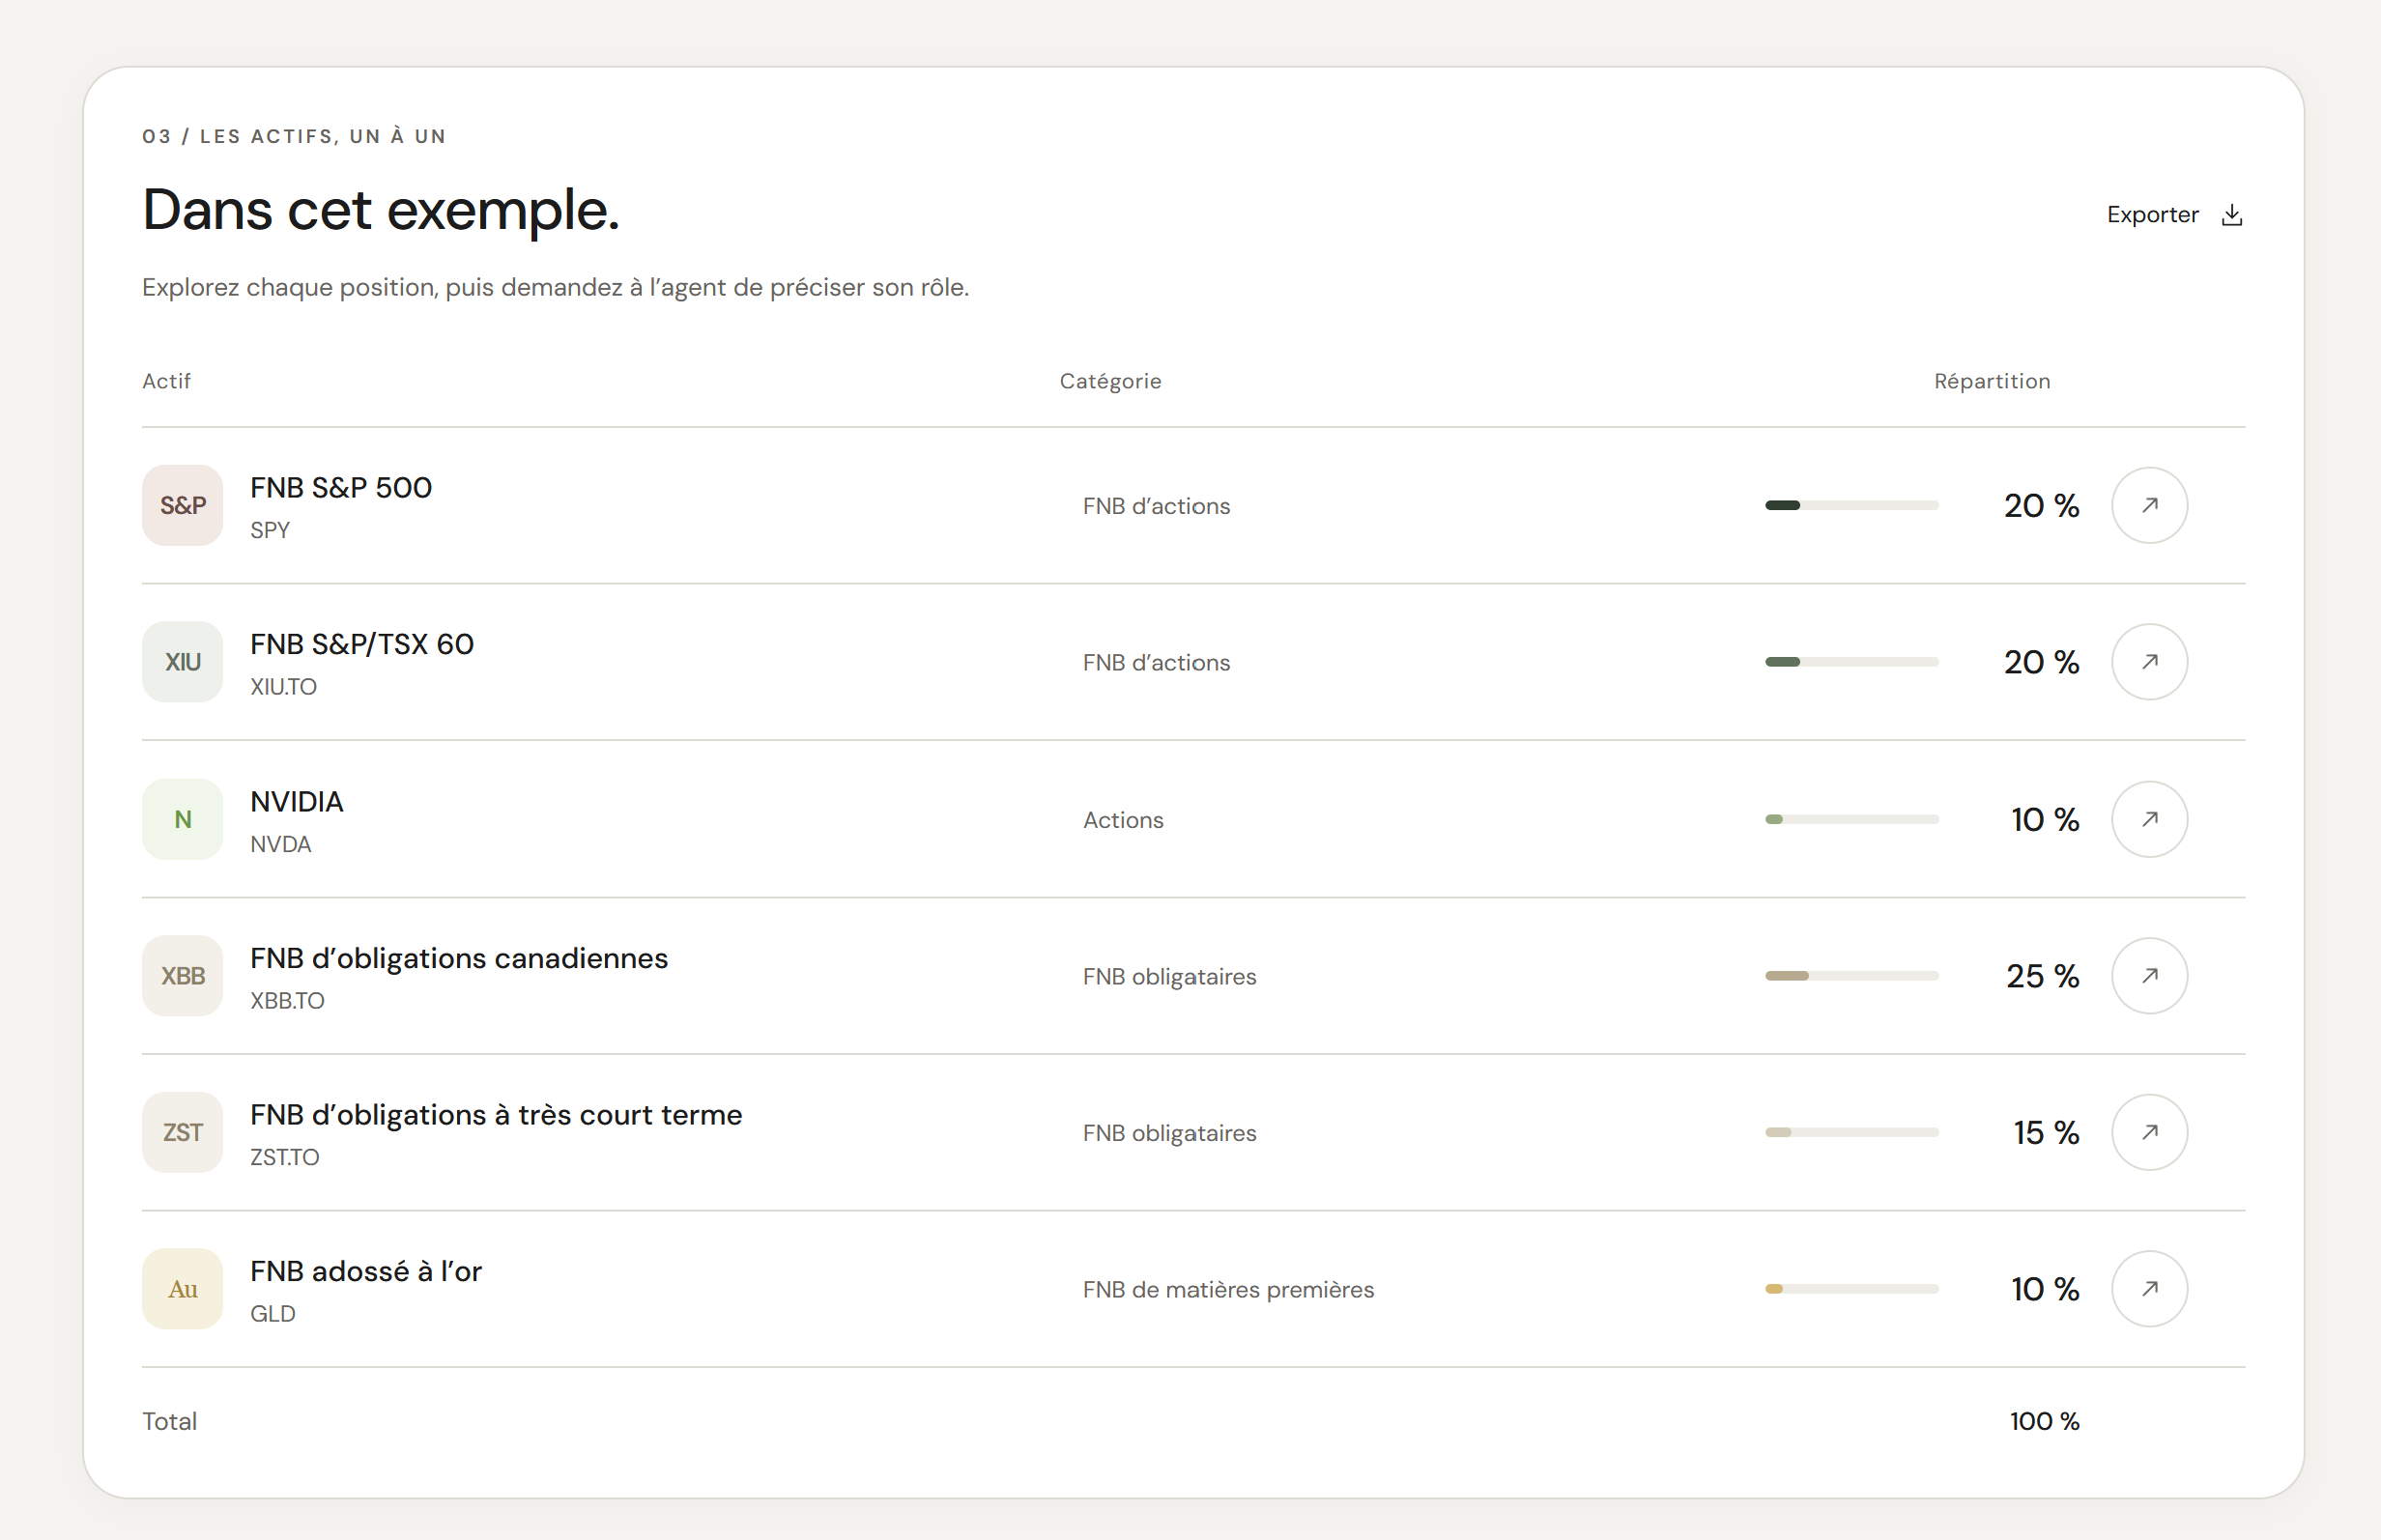
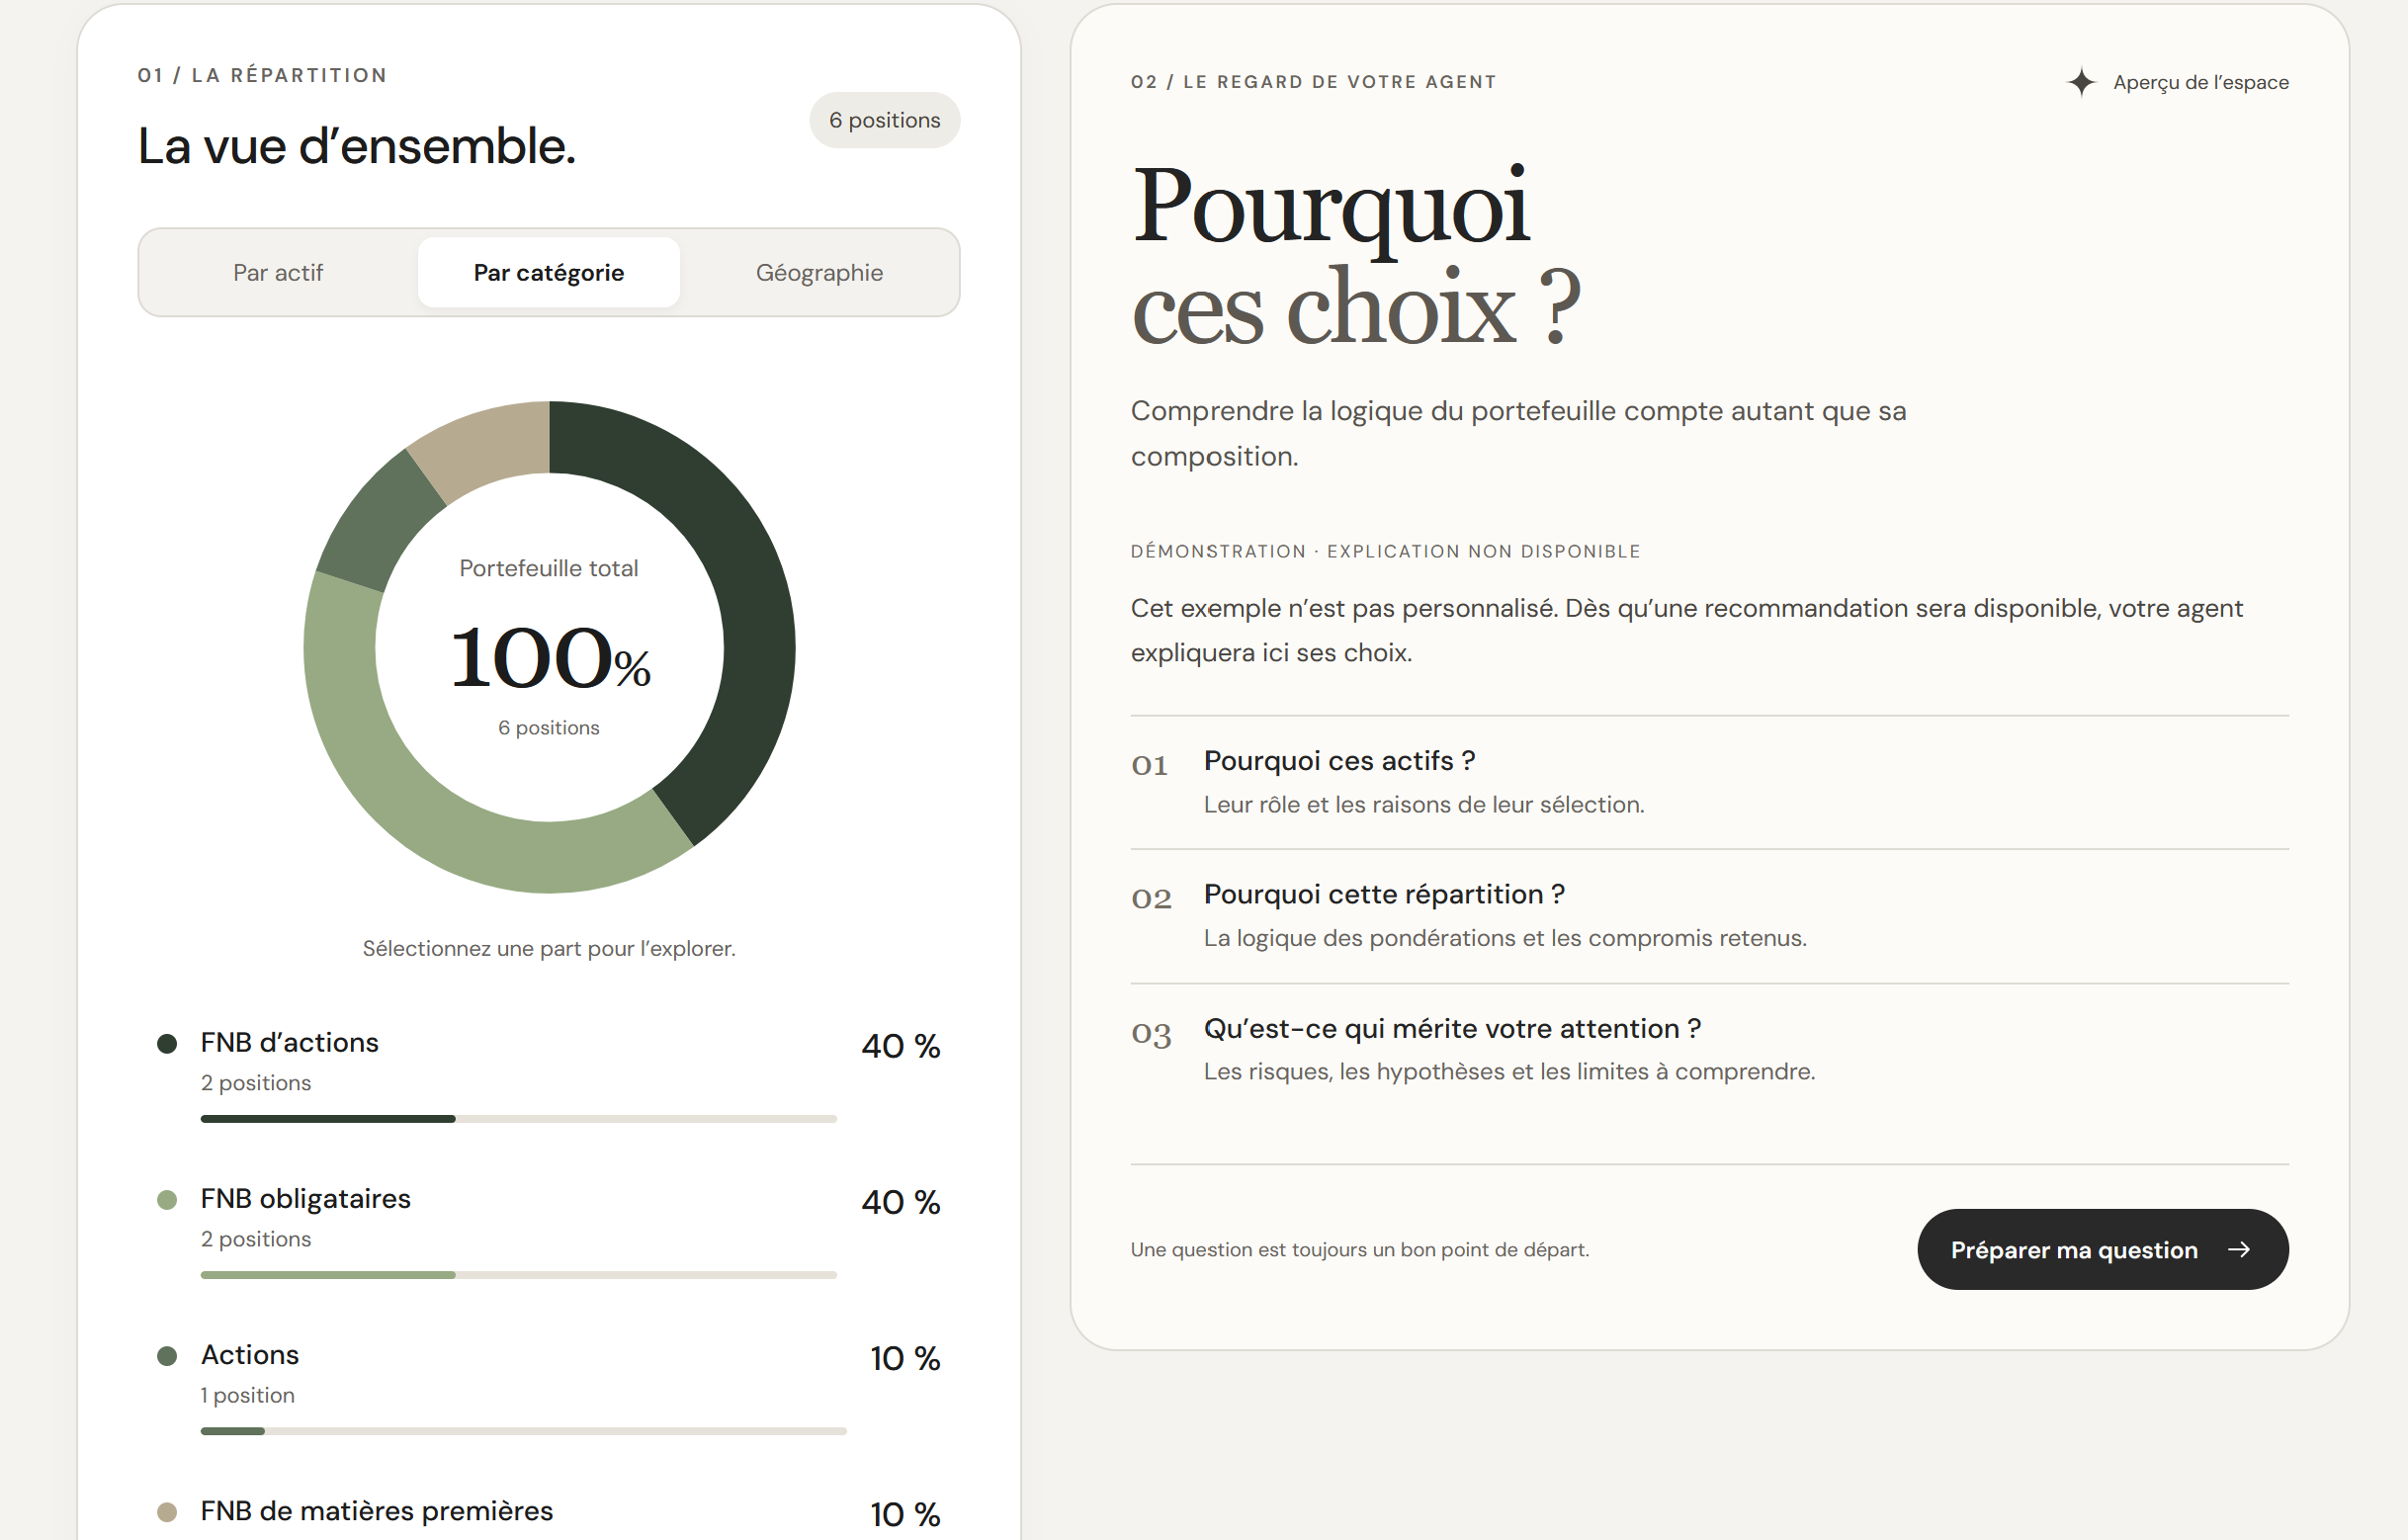
Quand Robert demande 20 % de Tesla, sa volatilité passerait de 4,9 % à 12,2 % (sa limite est de 7 %), sa pire baisse de −8,9 % à −19,6 % (limite −15 %), et un seul titre représenterait 20 % de son portefeuille (limite 5 %). Recommand lui montre que 5 % est conforme, et que les 263 $ de plus que la demande complète aurait rapportés s'accompagnaient d'une baisse qu'il a dit ne pas accepter. Amira peut prendre beaucoup plus de risque, mais une demande de +15 % de Bitcoin dépasse quand même son plafond crypto de 10 %. Mateo voit où va son argent par région, par secteur et par catégorie d'actifs.
Comment nous l'avons construit
Sur AWS. Une seule AWS Lambda exécute un pipeline de dix agents, chacun avec une seule tâche, une entrée et une sortie typées : évaluateur, interprète, données, filtrage, portefeuille, simulation, revue, preuves, explication et contrôle de conformité. Amazon S3 contient un instantané haché de chaque entrée et une piste d'audit de sept fichiers par exécution, écrite avant la diffusion du résultat. Amazon Bedrock n'est appelé que par deux agents : l'un transforme un message ambigu en modification typée, l'autre ordonne des faits déjà vérifiés. Le modèle n'écrit jamais de chiffre : Python rédige chaque phrase à partir d'affirmations vérifiées, et un contrôle de conformité reconstruit chaque fait avant tout affichage.
Profil de risque. Comme une banque, nous séparons la volonté de la capacité de prendre des risques, nous notons chacune de 1 à 6 et retenons la plus basse :
$$ \text{tolérance} = \min(\text{risque},\ \text{réaction à une baisse},\ \text{connaissances}) \qquad \text{capacité} = \min(\text{horizon},\ \text{revenu}) $$
$$ \text{niveau} = \min(\text{tolérance},\ \text{capacité}) $$
Les niveaux 1 et 2 correspondent à la bande faible, 3 et 4 à la bande moyenne, 5 et 6 à la bande élevée. Une seule réponse prudente suffit à plafonner la bande.
Données et indicateurs. Nous avons utilisé les cours de clôture ajustés du vendredi, chaque semaine, pour 127 actifs (Yahoo Finance), et les taux USD/CAD de la Banque du Canada. Les prix américains sont convertis en CAD avant le calcul des rendements, de sorte que les résultats incluent l'effet de change que subit réellement un investisseur canadien. Chaque portefeuille commence à 10 000 $ et est rééquilibré chaque mois. Avec les rendements hebdomadaires r et la valeur du portefeuille V :
$$ \sigma_{\text{annuelle}} = \sigma(r)\sqrt{52} \qquad \text{Baisse maximale} = \min_t \left( \frac{V_t}{\max_{s \le t} V_s} - 1 \right) $$
L'application web est construite en Node.js, avec un questionnaire en français, une page de portefeuille et un clavardage.
Pile technologique
- AWS : Lambda (conteneur Python 3.13, gabarit SAM), S3 (instantané des données et piste d'audit), Bedrock (Claude Sonnet pour les explications, Nova 2 Lite pour les tests), IAM à moindre privilège, CloudWatch Logs
- Moteur : Python, pandas, pytest
- Interface : Node.js 24, questionnaire en français, page de portefeuille et clavardage
- Données : Yahoo Finance (via yfinance), API Valet de la Banque du Canada, FRED, fiches de fonds (State Street, iShares)
Capacités agentiques clés
- Dix agents spécialisés — chacun a une seule tâche, une entrée et une sortie typées, du questionnaire jusqu'au contrôle final.
- Compréhension du langage courant — une demande en français ou en anglais devient une modification précise; si elle est ambiguë, l'agent pose une question au lieu de deviner.
- Recherche de la meilleure version conforme — quand une demande dépasse les limites, le moteur trouve la plus grande version qui les respecte (5 % au lieu de 20 % de TSLA pour Robert).
- Autovérification — un contrôle de conformité reconstruit chaque fait, chaque pondération et chaque limite avant la diffusion; toute différence bloque le résultat.
- Reprises limitées et repli sûr — après une tentative et deux réparations du modèle, un gabarit déterministe prend le relais et doit passer le même contrôle.
- Traçabilité complète — sept fichiers d'audit par exécution dans S3 : chaque phrase remonte jusqu'aux données qui l'ont produite.
- L'humain décide — aucune modification n'est conservée sans la confirmation de l'investisseur.
Les défis rencontrés
- Garder l'IA honnête. Laisser le modèle rédiger les explications voulait dire qu'il pouvait arrondir, adoucir ou inventer des chiffres. Nous l'avons limité à renvoyer l'ordre d'identifiants d'affirmations vérifiées, et nous avons ajouté un contrôle qui rejette tout ce qui ne correspond pas aux preuves.
- Placer chacun dans le bon profil. Notre premier appariement comparait le risque déclaré et les actifs en commun. Il plaçait les trois personas dans le mauvais profil; l'évaluation à deux volets a corrigé les trois.
- Liberté ou limites. Nous avons débattu de la possibilité pour l'utilisateur de tout modifier. Notre choix : toute modification est permise, mais elle est d'abord évaluée, expliquée, puis conservée seulement après confirmation, et les modifications hors profil sont clairement signalées.
- Limites des données. La série de taux de change commence en novembre 2021, ce qui a fixé notre fenêtre de cinq ans. Nous avons utilisé les prix ajustés pour tenir compte des fractionnements d'actions, copié le prix de clôture dans la colonne ajustée pour la crypto, et accepté que les données hebdomadaires masquent les baisses en milieu de semaine. Quand la composition d'un fonds manquait, nous affichons « inconnu » au lieu de deviner.
- Le travail d'équipe sous pression. Des branches ont écrasé des fichiers de données partagés, deux versions de la logique de profil ont dû être fusionnées, et nos identifiants AWS temporaires expiraient en pleine séance de travail.
Ce que nous avons appris
- Finance : la différence entre tolérance au risque et capacité à prendre des risques, l'importance des prix ajustés, pourquoi la conversion de devises se fait avant le calcul des rendements, et comment le biais d'anticipation peut discrètement embellir une simulation historique.
- IA : la tâche la plus utile du modèle de langage était aussi la plus modeste : expliquer des faits que le code avait déjà vérifiés. L'explicabilité est un choix d'architecture, pas une question de prompt.
- Travail d'équipe : récupérer les changements avant de créer une branche, ne valider que ses propres fichiers, et consigner les décisions pour que tout le monde construise la même chose.
Impact
Recommand aide :
- les investisseurs, qui voient l'effet réel d'une modification sur leur risque avant de la faire, au lieu de décider à l'aveugle;
- les conseillers, qui peuvent expliquer chiffres à l'appui pourquoi une demande ne convient pas au profil, et proposer une version qui convient;
- les équipes de conformité, qui disposent d'une trace complète de chaque réponse : données utilisées, calculs, appels au modèle et vérifications;
- les institutions financières, qui peuvent offrir un assistant conversationnel sans risquer qu'il invente des chiffres ou donne des conseils non encadrés.
La suite
Afficher le risque propre à chaque actif demandé à côté de celui du portefeuille, ajouter de vraies données ESG et des questions sur le pays d'origine, utiliser la composition complète des fonds, passer à des prix quotidiens avec un historique plus long et des scénarios de crise (2008, 2020), et proposer la version plafonnée même quand une demande est trop grande pour être financée.
Recommand est une simulation éducative avec des profils fictifs. Il n'exécute aucune transaction et ne donne aucun conseil en placement.
Built With
- amazon-web-services
- api
- aws-bedrock
- aws-lambda
- aws-sam
- bank-of-canada-valet-api
- chatgpt
- claude
- docker
- github
- html5
- javascript
- kiro
- node.js
- pandas
- pytest
- python
- yfinance
