-
-
Logo del proyecto
-
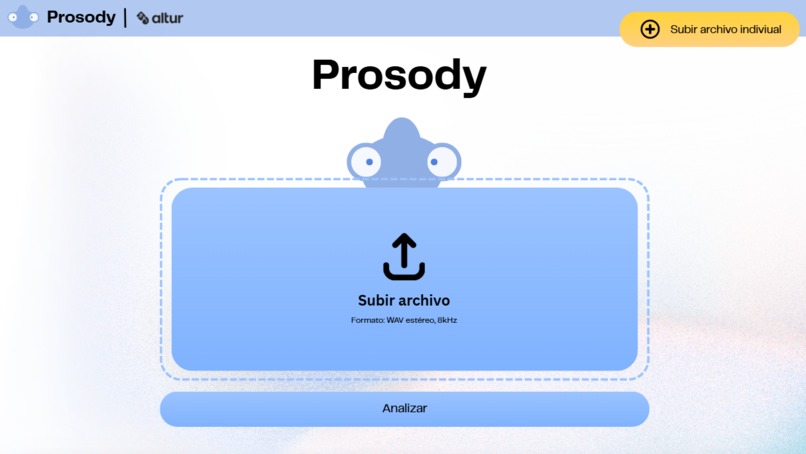
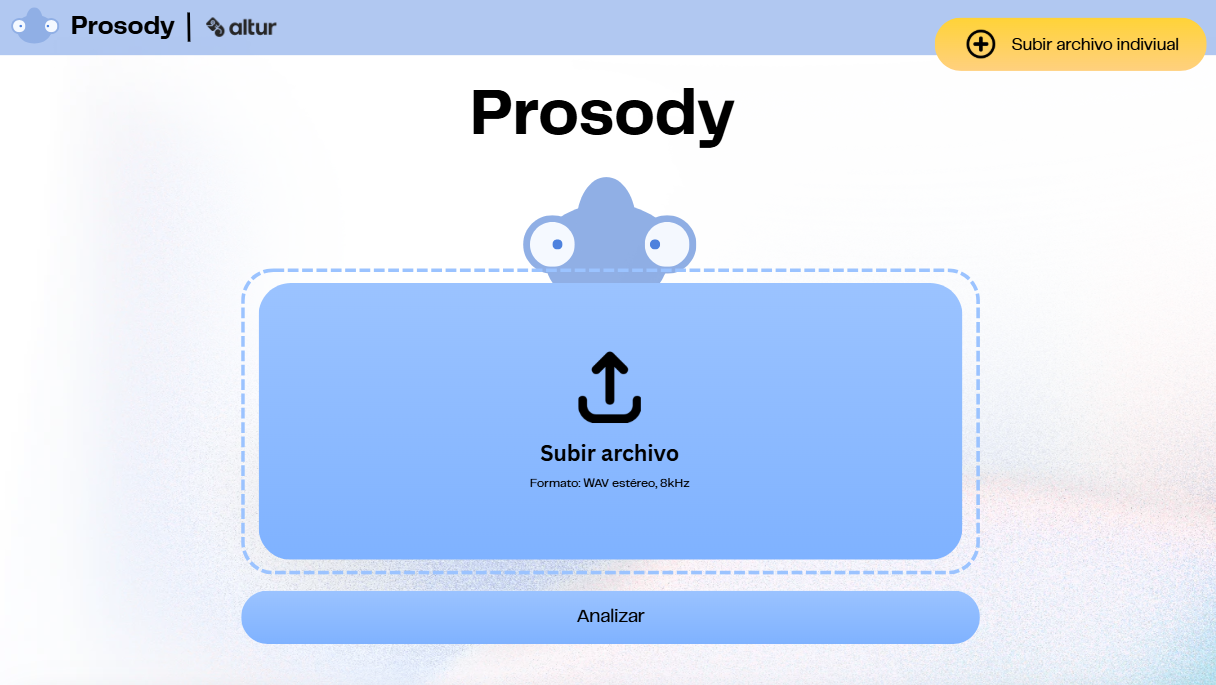
Prototipo de página en donde puedes subir tus audios para analizarlos
-
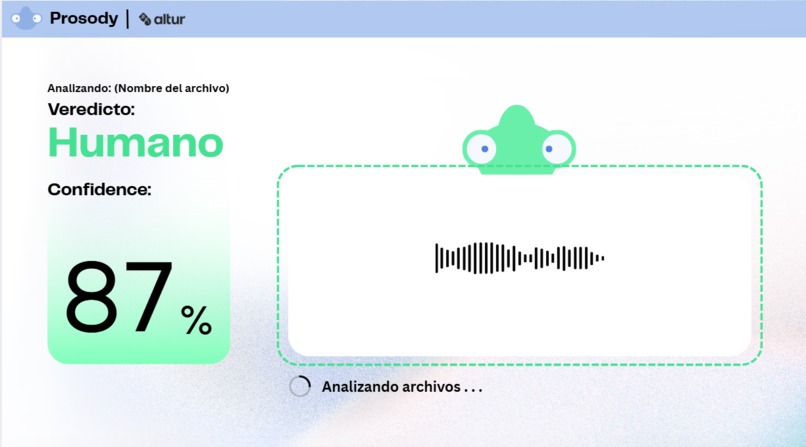
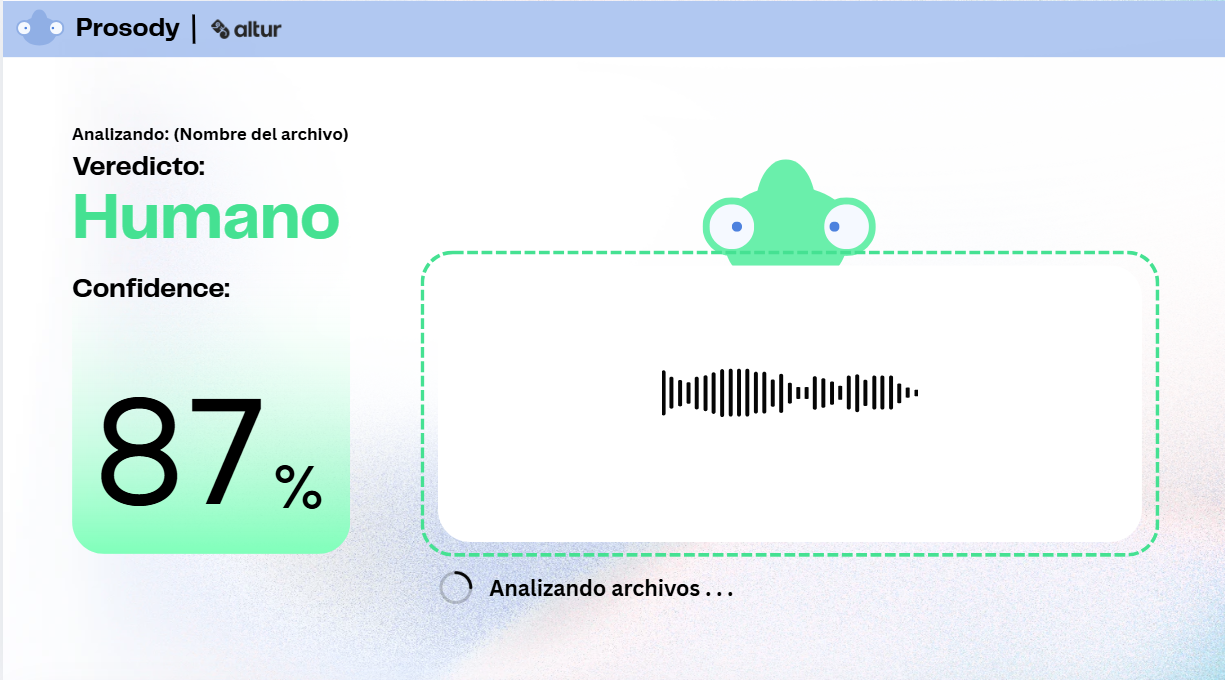
Página cuando detecta la voz de un humano
-
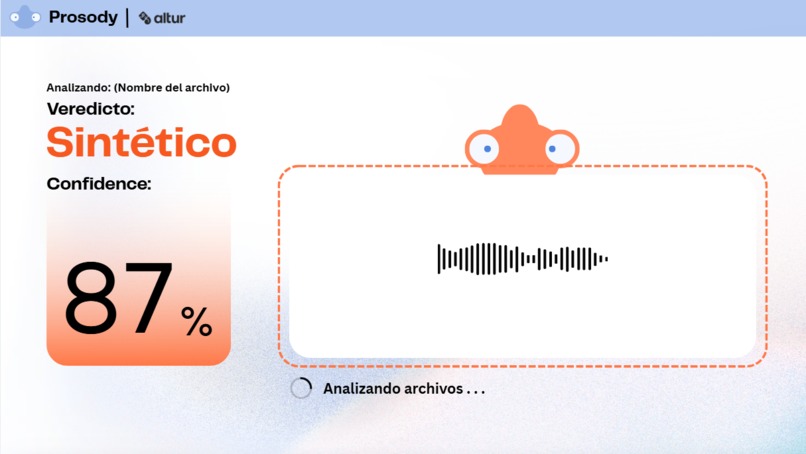
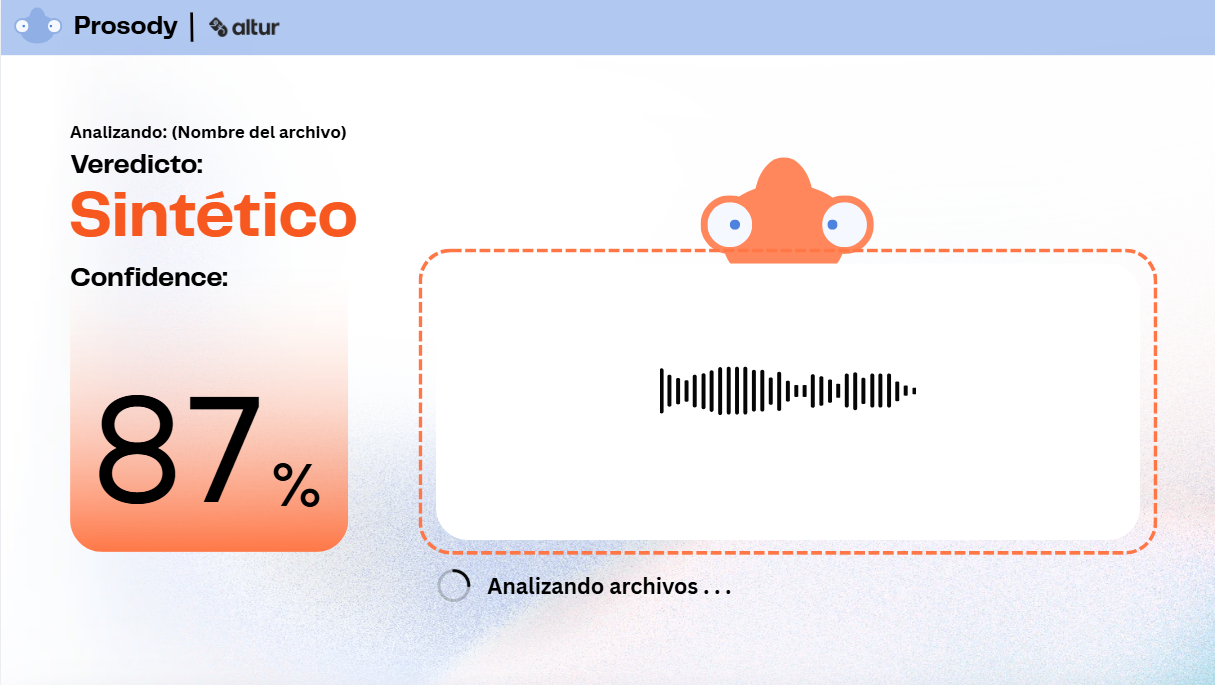
Página cuando detecta la voz de una IA
-
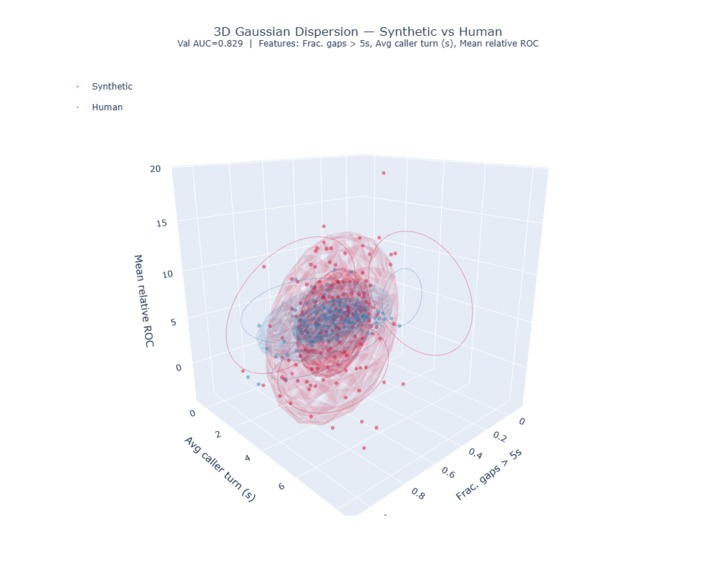
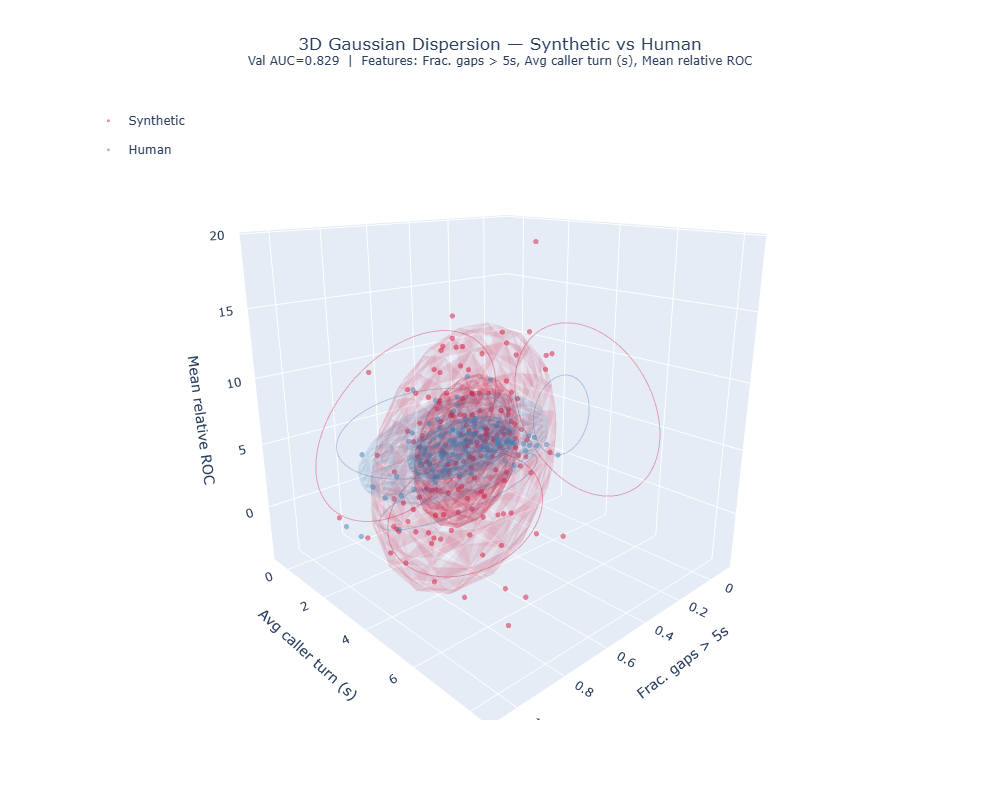
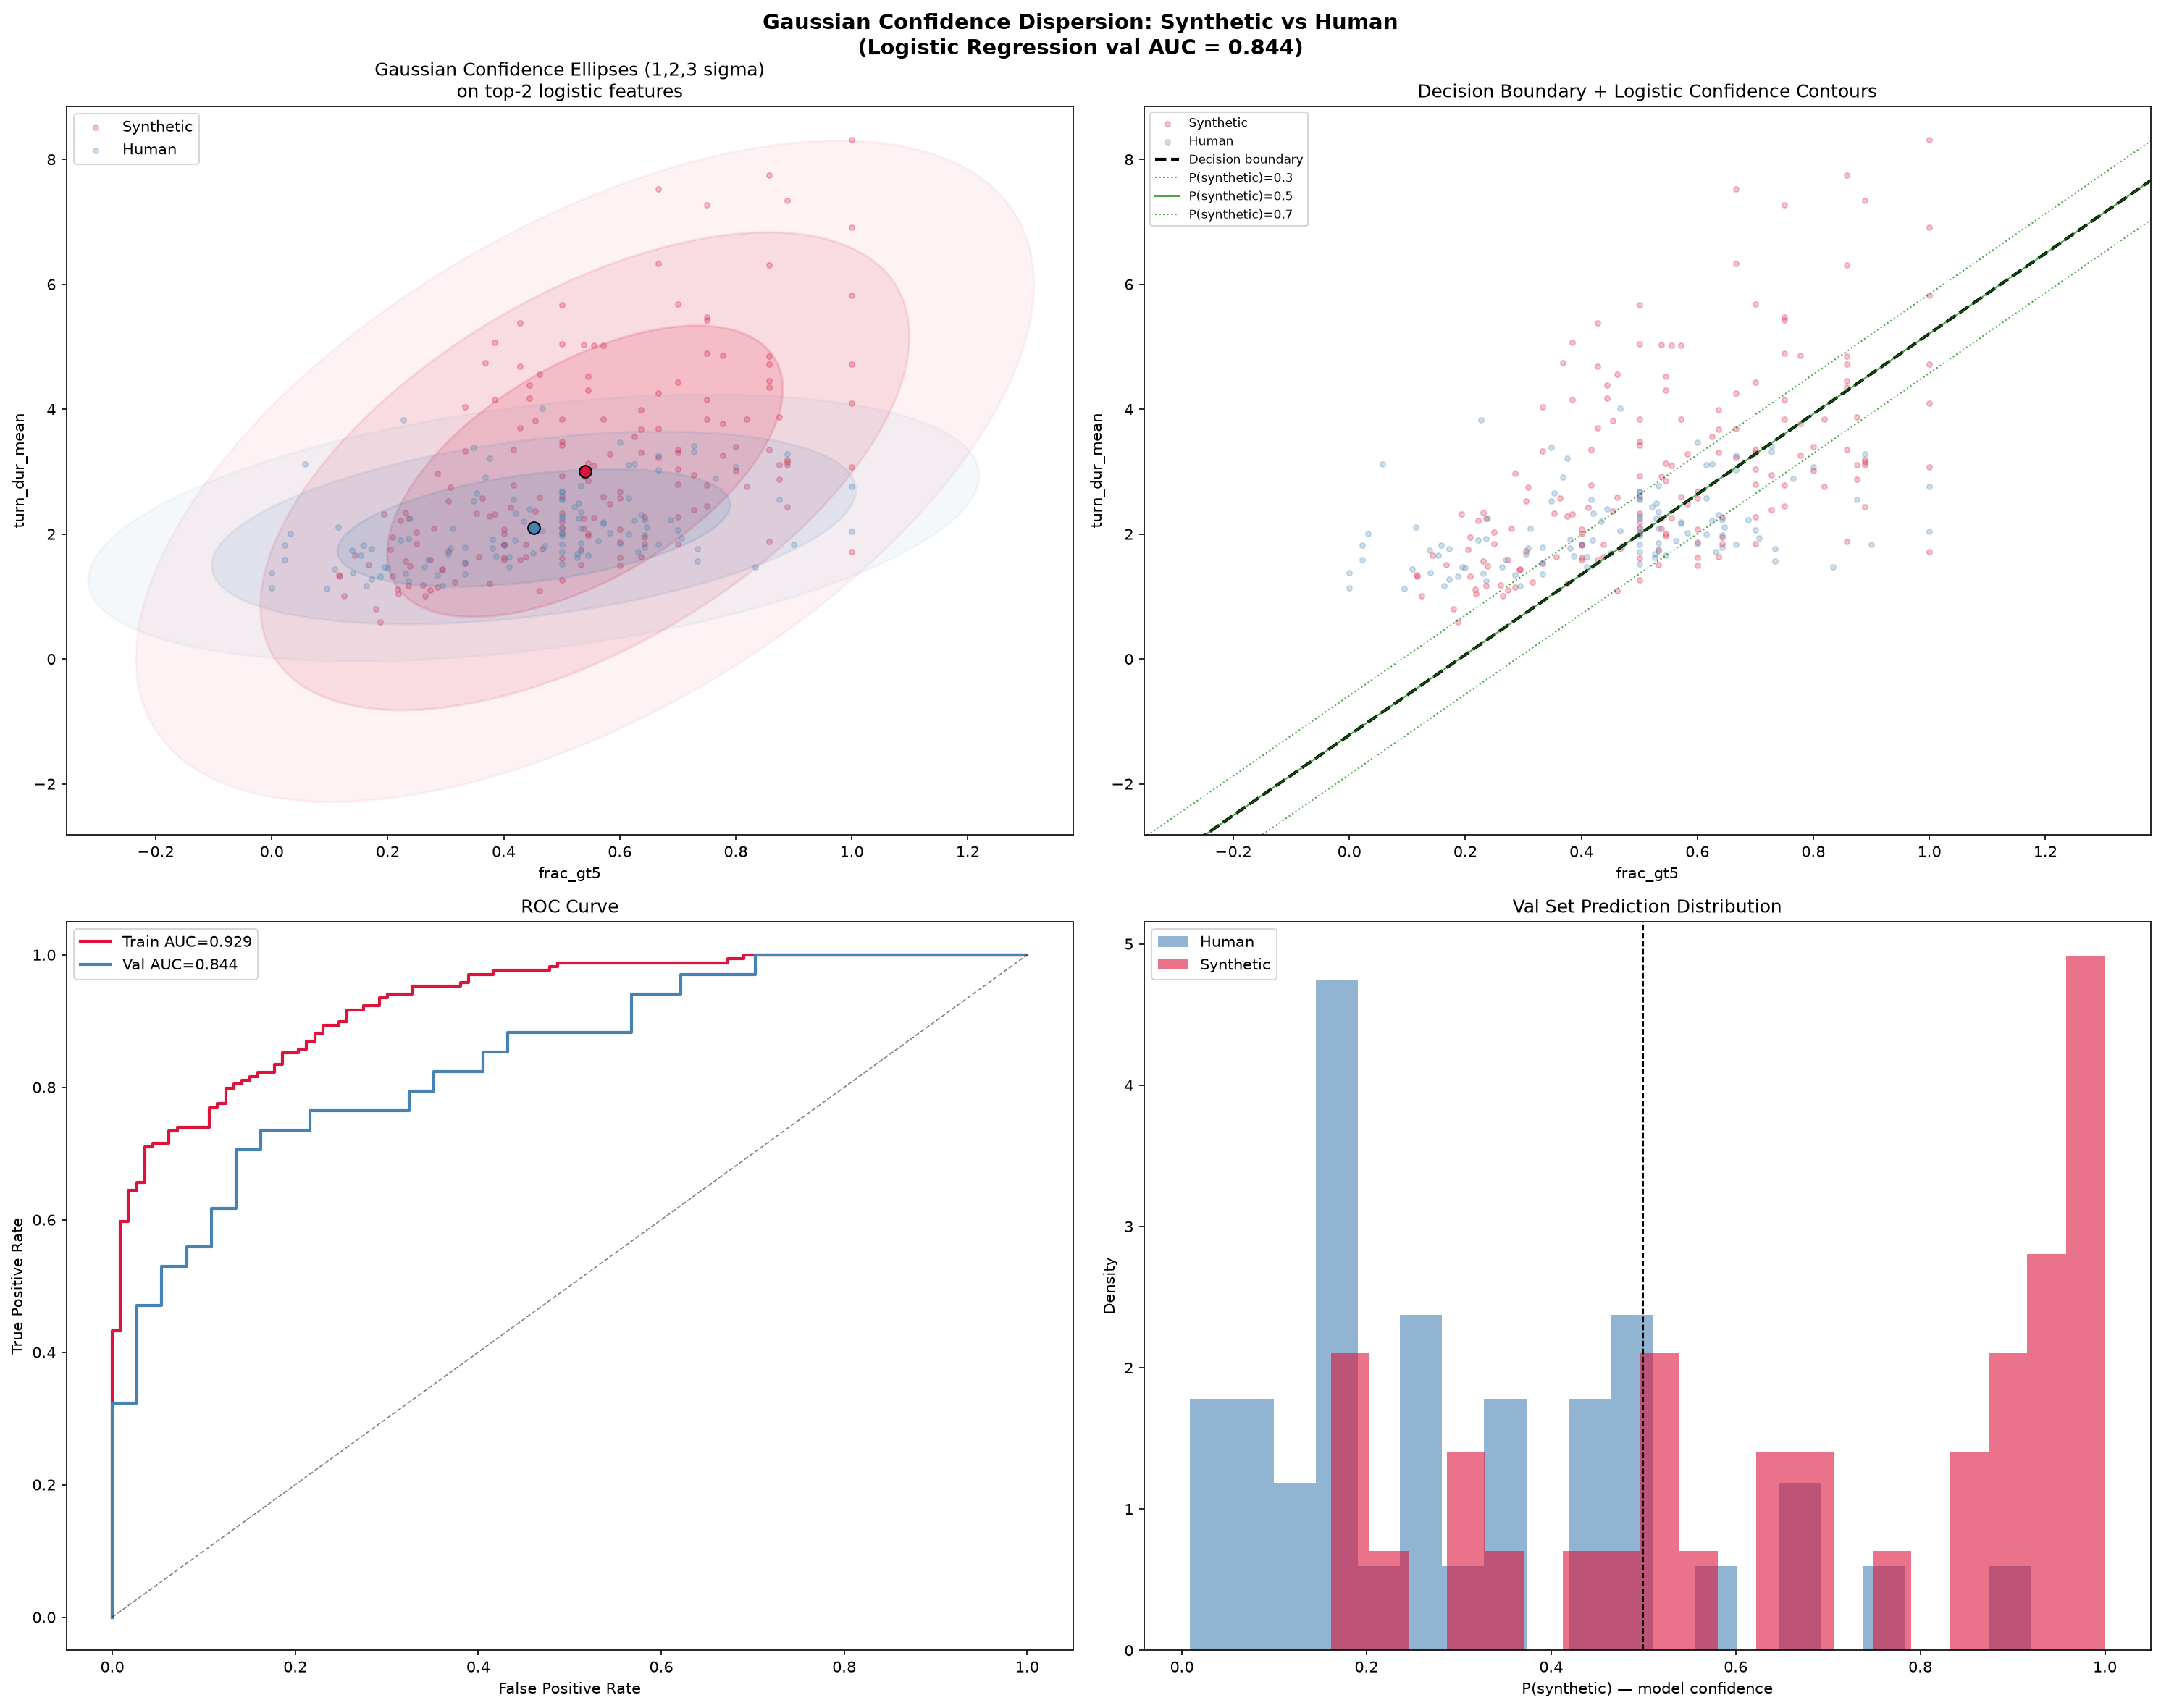
Modelo de dispersión gaussiana
-
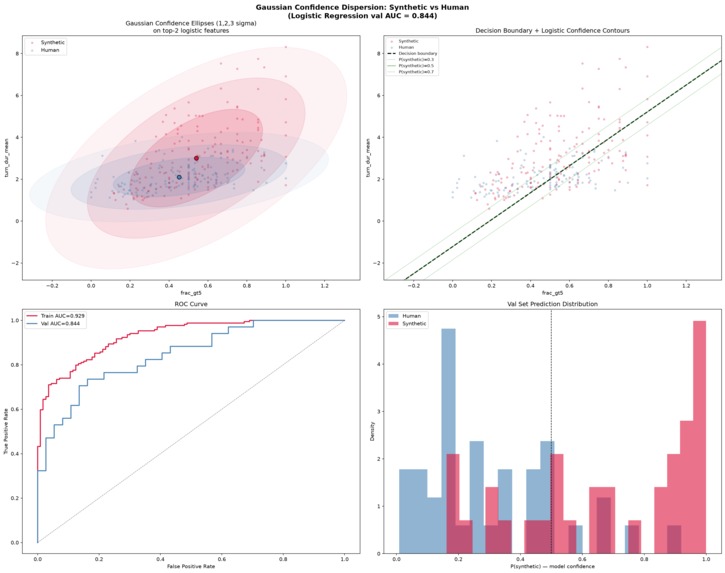
Modelo de dispersión de confianza
-
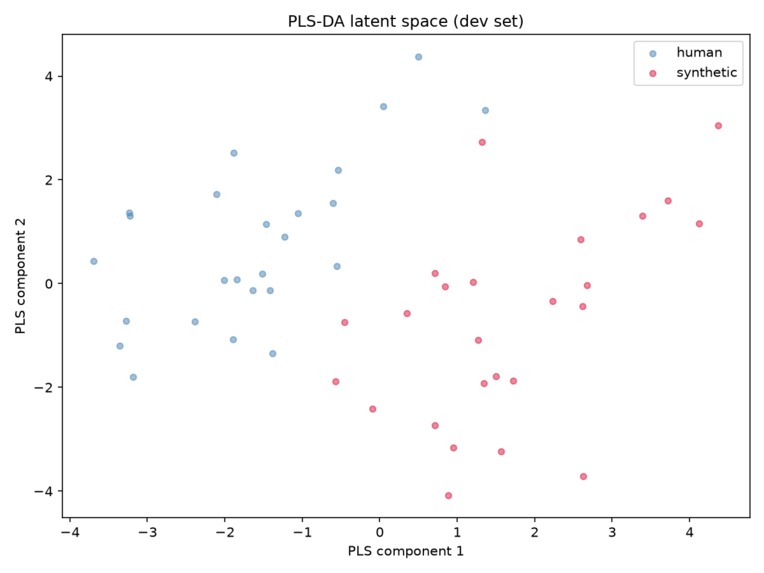
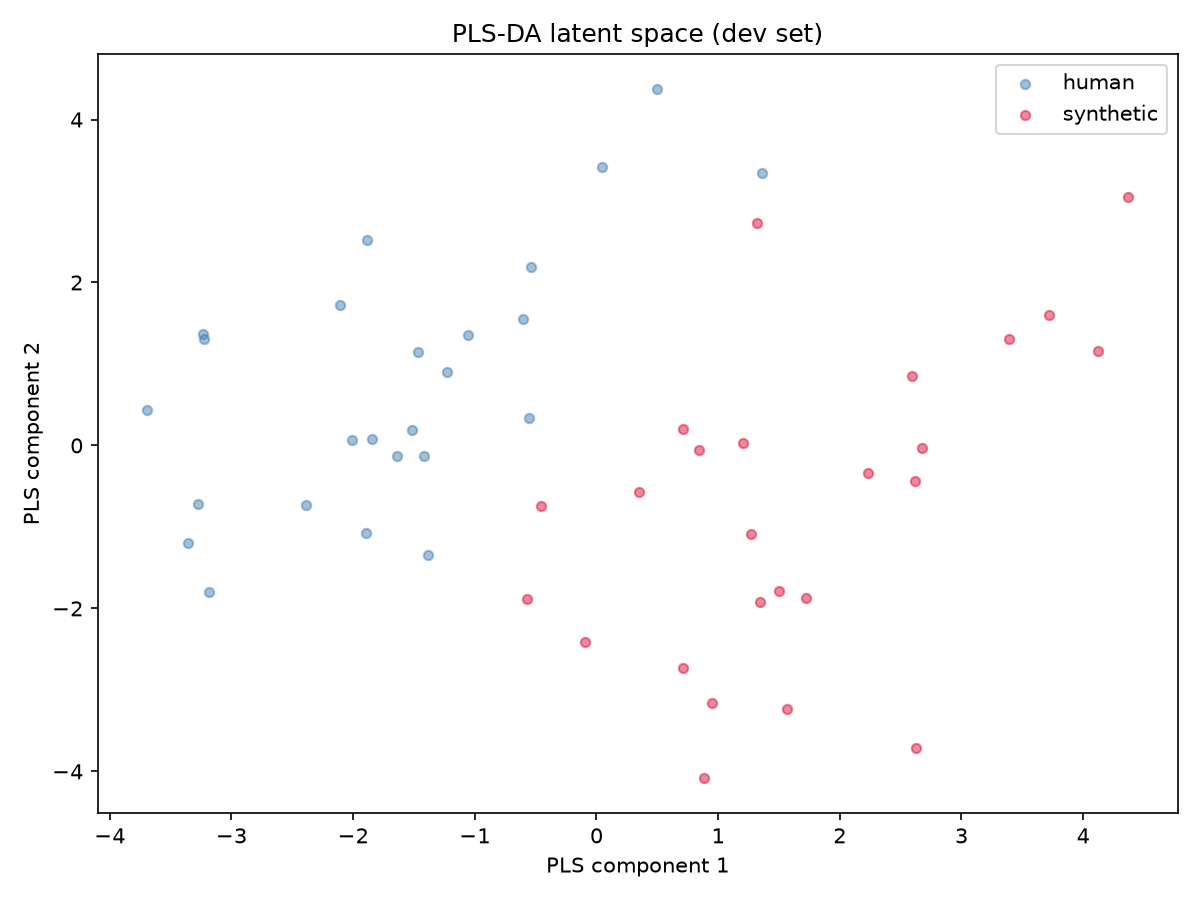
Espacio Latente (Análisis Léxico)
-
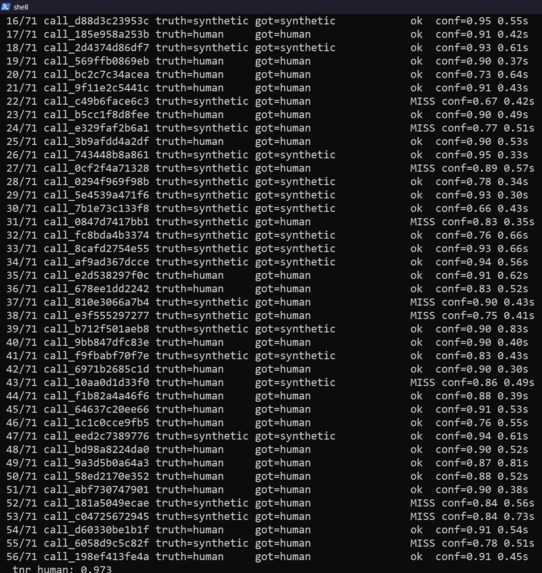
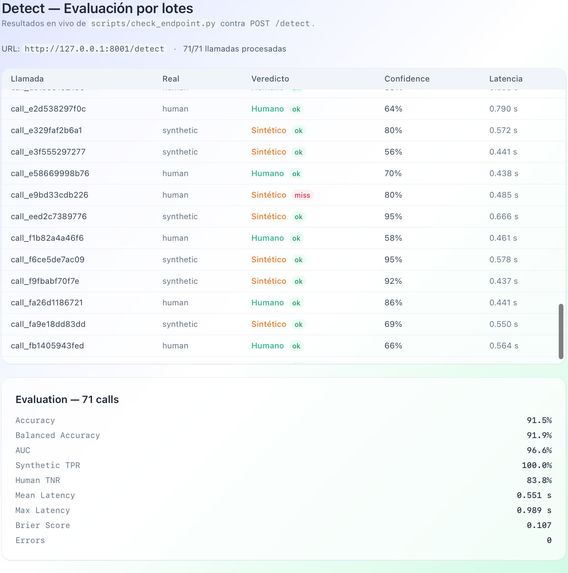
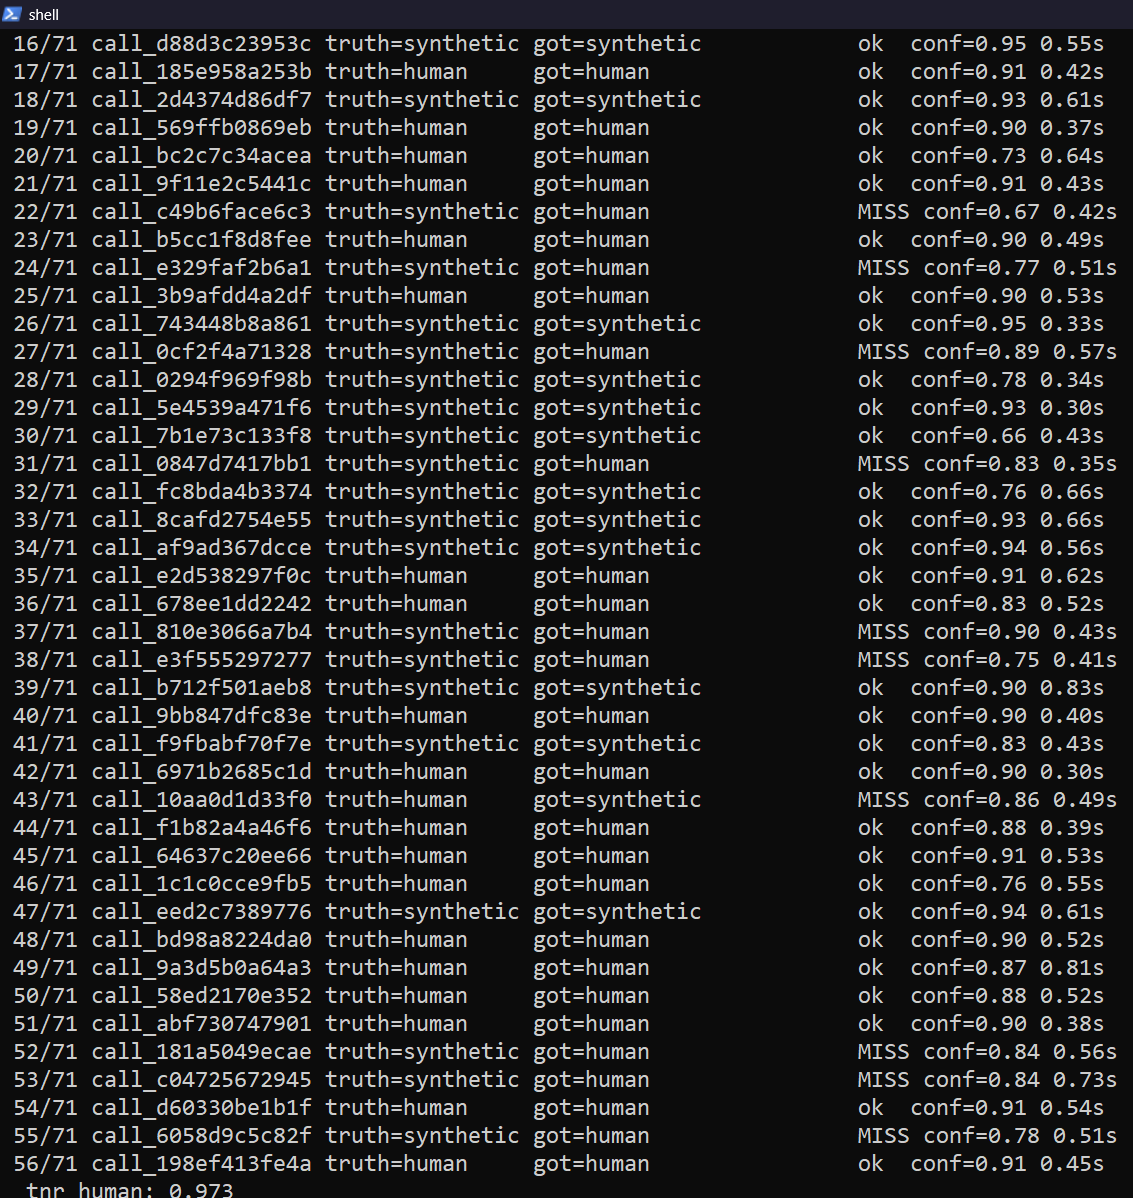
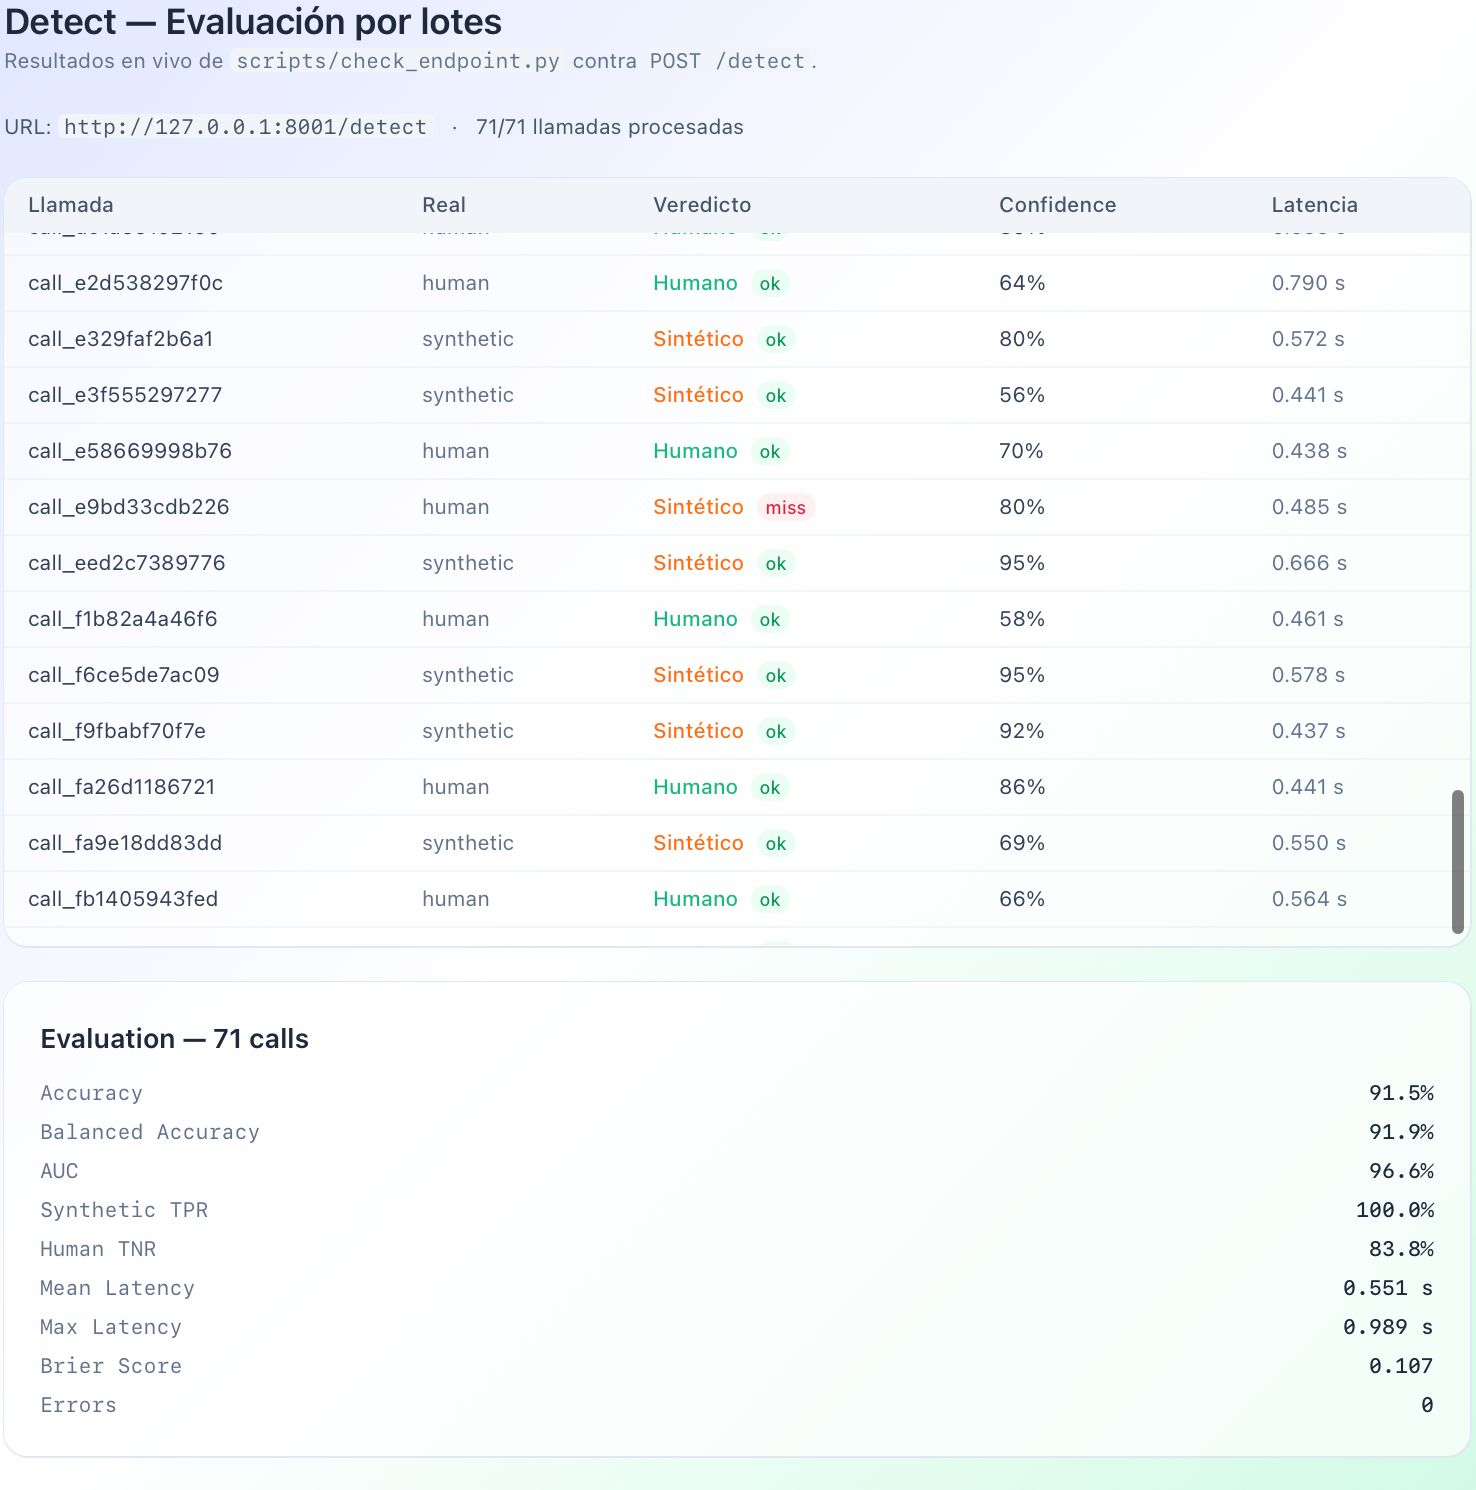
Modelo esamble en acción.
-
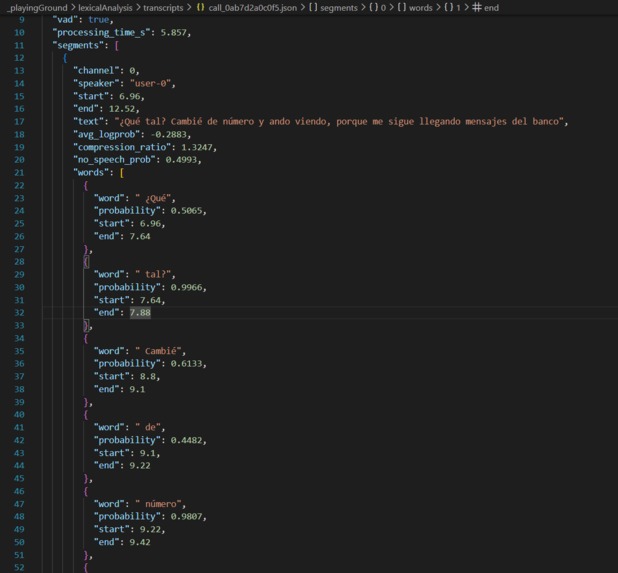
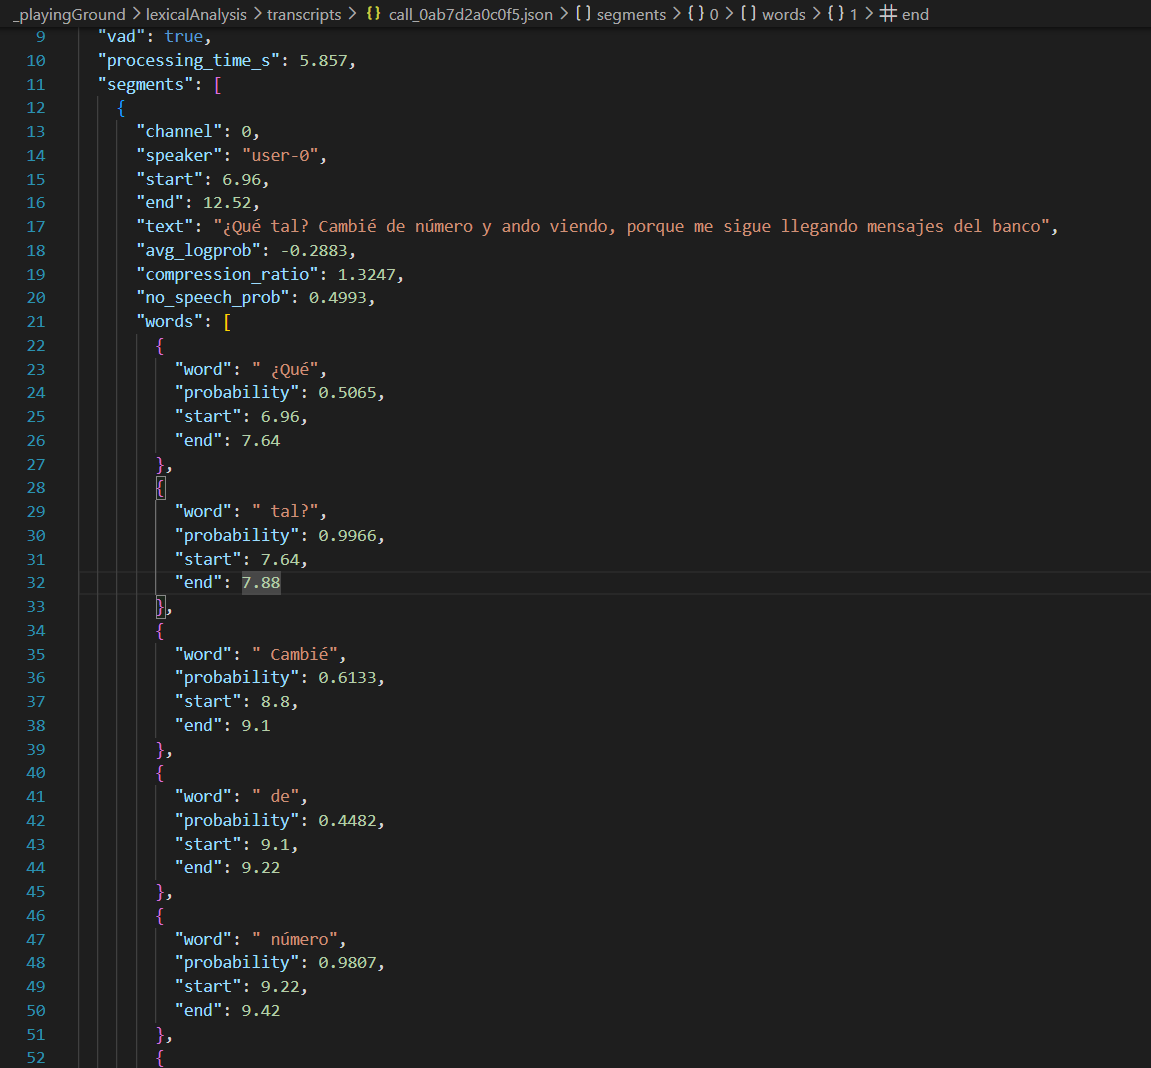
Modelo de STT con FasterWhisper
-
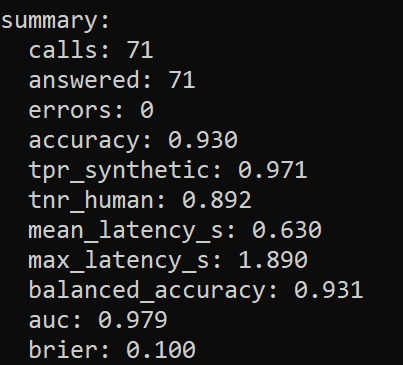
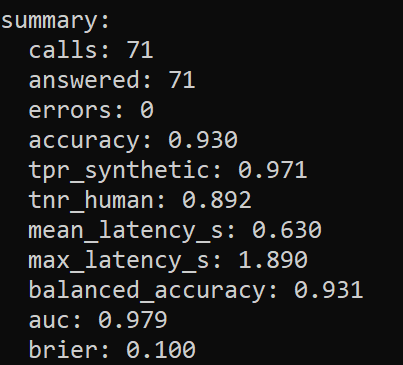
Summary de Ensemble
-
Inspiración
El propósito de este proyecto fue principalmente poner a pruebas nuestras habilidades de modelaje matemático y estadistico.
¿Qué hace?
Como la descripción del proyecto lo menciona, es un modelo estadistico el cuál permite identificar llamadas sinteticas haciendo uso combiando de las siguientes tres herramientas: Tiempos de Diferenciación & Distribución, Resonancia y Finalización Natural del Habla.
¿Cuál es el objetivo?
Saber diferenciar cuando nosotros estamos hablando con una voz sintetica frente a una humana.
¿Cómo lo hicimos?
El objetivo inicial era hacer la mayor cantidad de criterios posibles. Planeamos en crear cuatro criterios basados en el ritmo de las conversaciones (por ende el nombre Prosody). Utilizando un último criterio, nos permitia acercanos de manera orgánica a un modelo muy acertado.
Para los Tiempos de Diferenciación & Distribución
¿Qué mide?
Mide la diferencia de \( t’’_i \) de user-0 y la compara con una regresión gaussiana.
¿Por qué se hace?
Se encontró un patrón en donde el usuario sintético se tarda ligeramente más en contestar, pero sobre todo, el intervalo de esas tardanzas es muy constante. Es decir, \( \sum t’’_i \approx 0 \). Utilizando esta lógica, se desarrolló un modelo de dispersión gaussiana para separar los datos de la mejor manera posible. De esta manera, logramos conseguir un VAL AUC de 0.829 en nuestras simulaciones (usando hackmty26/turns/) y haciendo esto, a la hora de probarlo con los audios, tuvimos un accuracy del 0.775.
Para la Resonancia:
¿Qué se mide?
Mide 7 propiedades físicas de la voz (formantes, tono, cómo cambian en el tiempo) y con eso predice si es humano o sintético.
Mide los formantes (picos) que amplifican las frecuencias
¿Cómo se mide?
Mide los formantes F1, F2 y el tono (F0) del canal del caller con Praat cuadro a cuadro y se calculan 7 números que describen cómo se mueven esas frecuencias a lo largo de la llamada
Tiene 7 métricas:
- F1_jitter: 0.83 (valor alto = sospechoso)
- F0_F1_corr (correlación tono-formante): 0.75 (valor bajo = sospechoso)
- F1_cv: 0.66 (valor alto = sospechoso)
- vocoder_periodicity: 0.63 (valor alto = sospechoso)
- F1_drift_abs: 0.62 (valor bajo = sospechoso)
- F2_cv: 0.61 (valor bajo = sospechoso)
- F2_jitter: 0.60 (valor alto = sospechoso)
Se hace una regresión logística que aprende automáticamente cuánto pesar cada una
Estadísticas
Resultado combinado: AUC 0.94 en llamadas de personas nunca vistas, teniendo un 0.789 de accuracy.
Estructura fuera del endpoint
detector.py --> punto de entrada real, esto se conecta al backend
resonance_core.py --> cálculo de las 7 métricas
vad.py --> encuentra segmentos de habla sin turns.json
model.joblib --> modelo ya entrenado, no hay que reentrenar
training/train_model.py --> reentrena si aparecen más datos
training/resonance_features.py --> genera el CSV de entrenamiento
Natural Speech Termination:
¿Qué se mide?
Se refiere a las señales vocales subconscientes que un usuario utiliza para indicar que terminaron de hablar.
Se miden los siguiente sub-parámetros:
- Brusquedad en la caída del volumen: la IA corta el sonido de forma mucho más abrupta
- Duración del tiempo hasta el silencio: la IA llega al silencio casi al instante
- Nivel de ruido de fondo: las grabaciones de llamadas d eIA presentan un nivel de ruido de fondo más alto y mucho más errático
- Claridad de la voz al final: la voz de la IA se mantiene artificialmente nítida hasta el último milisegundo, mientras que las voces humanas se vuelven entrecortadas o ásperas (se conoce como “vocal fry” [voz crepitante])
- Retardo del eco: existen ligeras diferencias en la sincronización del eco entre las llamas humanas y las de la IA
¿Cómo se mide?
Se analiza el canal del caller cuadro a cuadro alrededor del final de cada turno de habla (detectado con VAD): se mide la envolvente de energía (RMS en ventanas de 10ms) para ver qué tan abrupto es el corte y cuánto tarda en llegar al silencio de fondo, se usa autocorrelación tono/aclaridad para saber si el final sigue sonando "vocalizado", y un análisis de autocorrelación en banda de 8-60ms para detectar eco/reverberación. Con eso se calculan 6 números por llamada que describen cómo termina el habla, no qué se dice.
Tiene 6 métricas (valor = coeficiente estandarizado del modelo final; el signo indica la dirección real de sospecha, no una suposición univariada):
floor_db: +2.68 (alto = sospechoso, línea más ruidosa/menos silenciosa entre turnos --> más sospechoso de ser sintético. Nota: esta es la métrica con mayor riesgo de generalización, su correlación con la salida del modelo (0.44) es más fuerte que su correlación real con la etiqueta verdadera (0.21), documentado pero no resuelto)
abruptness_db_mean: +2.59 (alto = sospechoso, caída de energía más brusca justo al final del turno)
voiced_frac_near_end_range: -0.85 (bajo = sospechoso, poca variación de "cuán vocalizado" es el final entre los distintos turnos de la llamada; los humanos varían mucho más turno a turno)
tail_ms_mean: −1.00 (bajo = sospechoso, llega al silencio casi instantáneamente tras terminar de hablar)
echo_delay_ms_mean: +0.80 (alto = sospechoso, retardo de eco/reverberación mayor)
voiced_frac_near_end_mean: −0.79 (bajo = sospechoso según el modelo conjunto. Ojo: aisladamente esta métrica es más alta en sintéticos [0.75 vs 0.66 humano], pero en el modelo final, combinada con las otras 5, su coeficiente cambia de signo por correlación con range. Es la única de las 6 con esta inconsistencia univariado-vs-modelo, vale la pena mencionarlo si comparan tarjetas entre equipos)
Gracias a esta parametrización, nosotros llegamos a encontrar un accuracy del 0.831 en el dataset.
Esamble
Haciendo uso de la siguiente desigualdad cuando los modelos no se ponen de acuerdo, podemos nosotros hacer la decisión a qué lado nos vamos:
$$ \frac{\alpha\cdot\text{conf}{\alpha}\cdot\text{acc}{\alpha}}{\alpha+\beta+\gamma} > \frac{(\beta \cdot \text{conf}{\beta}\cdot\text{acc}{\beta})+(\gamma \cdot \text{conf}{\gamma} \cdot \text{acc}{\gamma})}{\alpha+\beta+\gamma} $$
Donde \( \alpha \) vendría siendo el lado en desacuerdo y \( \beta \) & \( \gamma \) vendrían siendo los valores de acuerdo. Sí la desigualdad se cumple y \( \alpha \) tira que la voz es sintetica, entonces la voz se tratará como sintetica.
Haciendo esto, nosotros podemos potenciar enormemente la capacidad de elección de nuestros modelos. Llegando a la siguiente tabla de resultados.
| timeDiff | 0.775 | | resonance | 0.789 | | NST | 0.831 |
| Ensemble | 0.930 |
[!NOTE] Basado en ejecutar el endpoint con
--n 71y--audio-dir ~\HackMTY-2026\audio\en el scriptcheck_endpoint.py.
¿A qué retos nos enfrentamos?
Te estarás preguntando, ¿Dónde está el cuarto modelo? Son tres mas su combinación, el cuarto modelo que nosotros teníamos planeado en realizar era un Análisis Léxico; haciendo uso de SilentWhisper y Huggingface-small para STT. La implementación la logramos concluir, sin embargo, terminó siend un cuello de botella terrible para el resto de la implementación. Los demas modelos tardaban un segundo e incluso menos, esté tardaba entre 10 a 25 segundos por audio. ¿La razón? Hacía una partición de palabras de cada uno de los transcripts. Este blocker nos hacia imposible en realizar una calibración de parámetros mas precisa; ademas, que fácilmente entrariamos al bucle del overfitting. Debido a esto, tuvimos que hacer la dificil decisión de deshacernos de este módulo.
Logros que nos enorgullecieron
Principalmente que pudimos haber realizado dichos modelos con poco mas que algunas herramientas estadisticas; sobre todo cuando nos tocó pensar como la maquina para ver que variables ocupabamos. Mas que nada, el simple hecho de que nos funcionó los modelos y que (desde nuestro conocimiento y analísis) no tuvimos problemas de overfitting, lo es todo para nosotros.
¿Qué aprendimos?
Principalmente a que si uno quiere realizar algún proyecto, que no porque se vea complejo significa que no se le va dar de todo. El chiste no es ver lo que pudo haber sido, sino lo que fue.
¿Prosody en el futuro?
Aúnque sea un framework medianamente sencillo de utilizar; constanto de GET para health y POST para los demas criterios, la verdad es que las oportunidades son infinitas. En el mundo en donde la inteligencia artificial domina el planeta, el estar de brazos cruzados, sobre todo como para la empresa que Altur es, simplemente sería inaceptable.

Log in or sign up for Devpost to join the conversation.