-
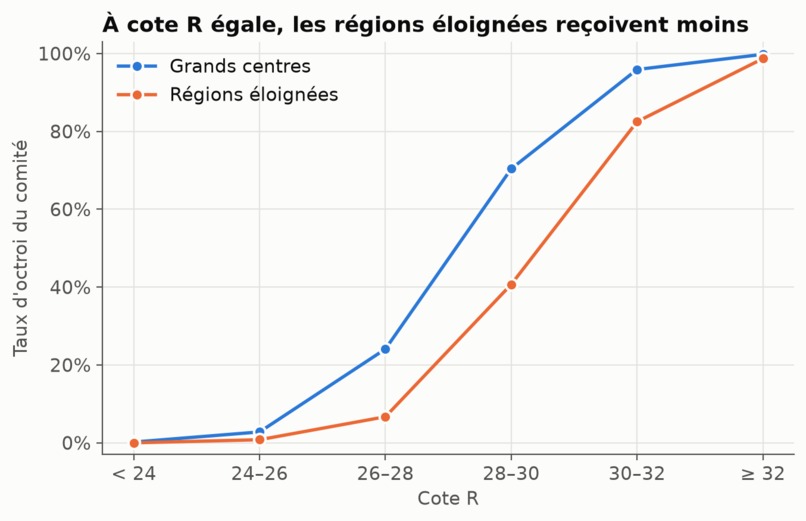
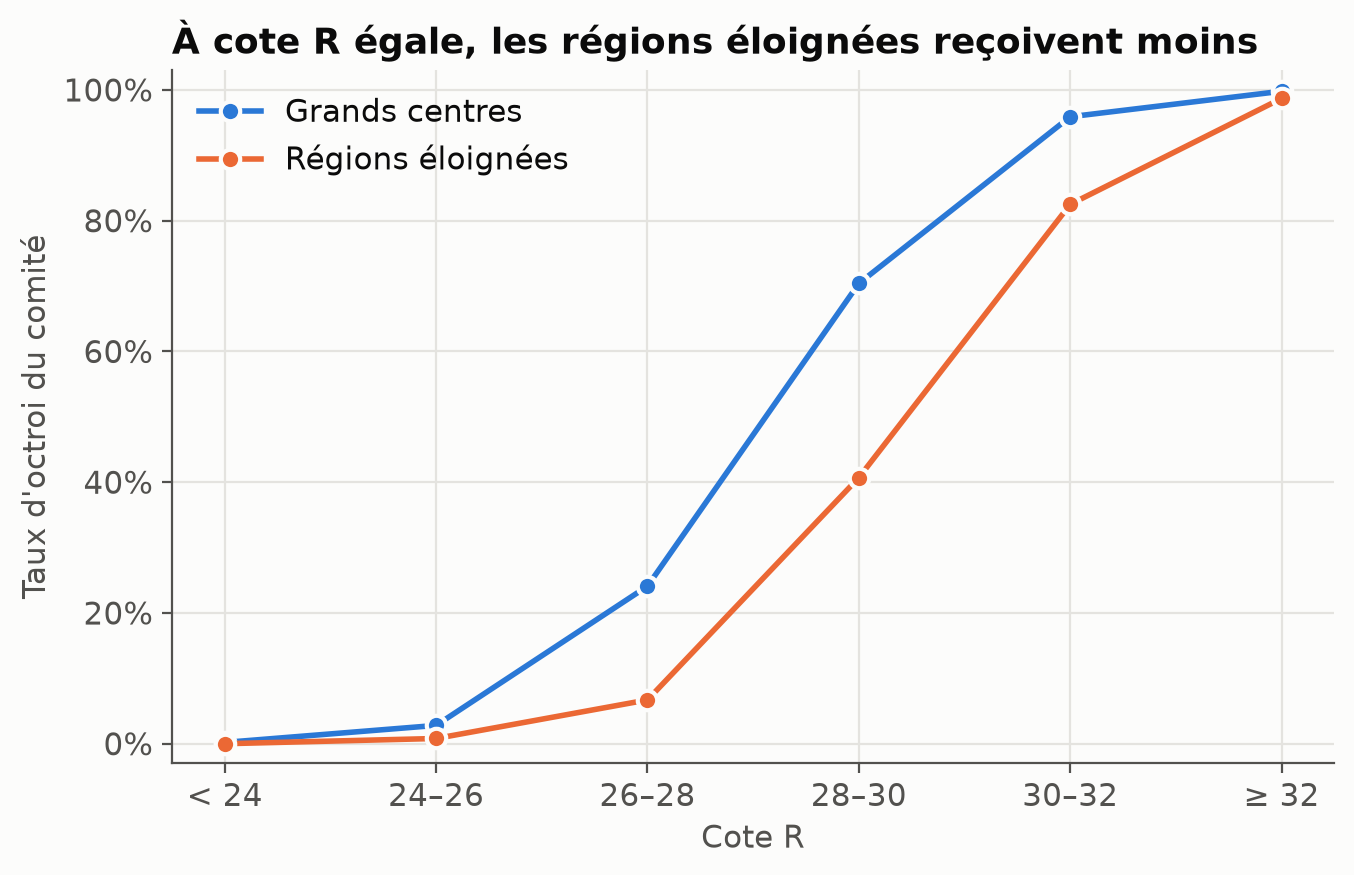
À cote R égale, les régions éloignées reçoivent moins.
-
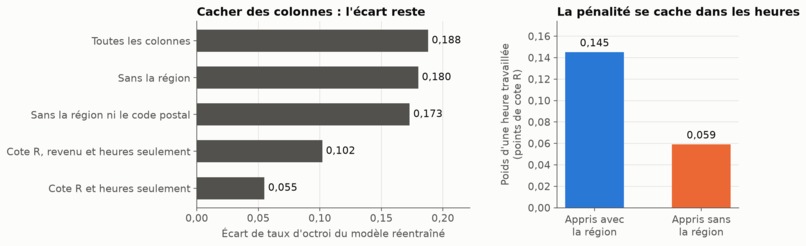
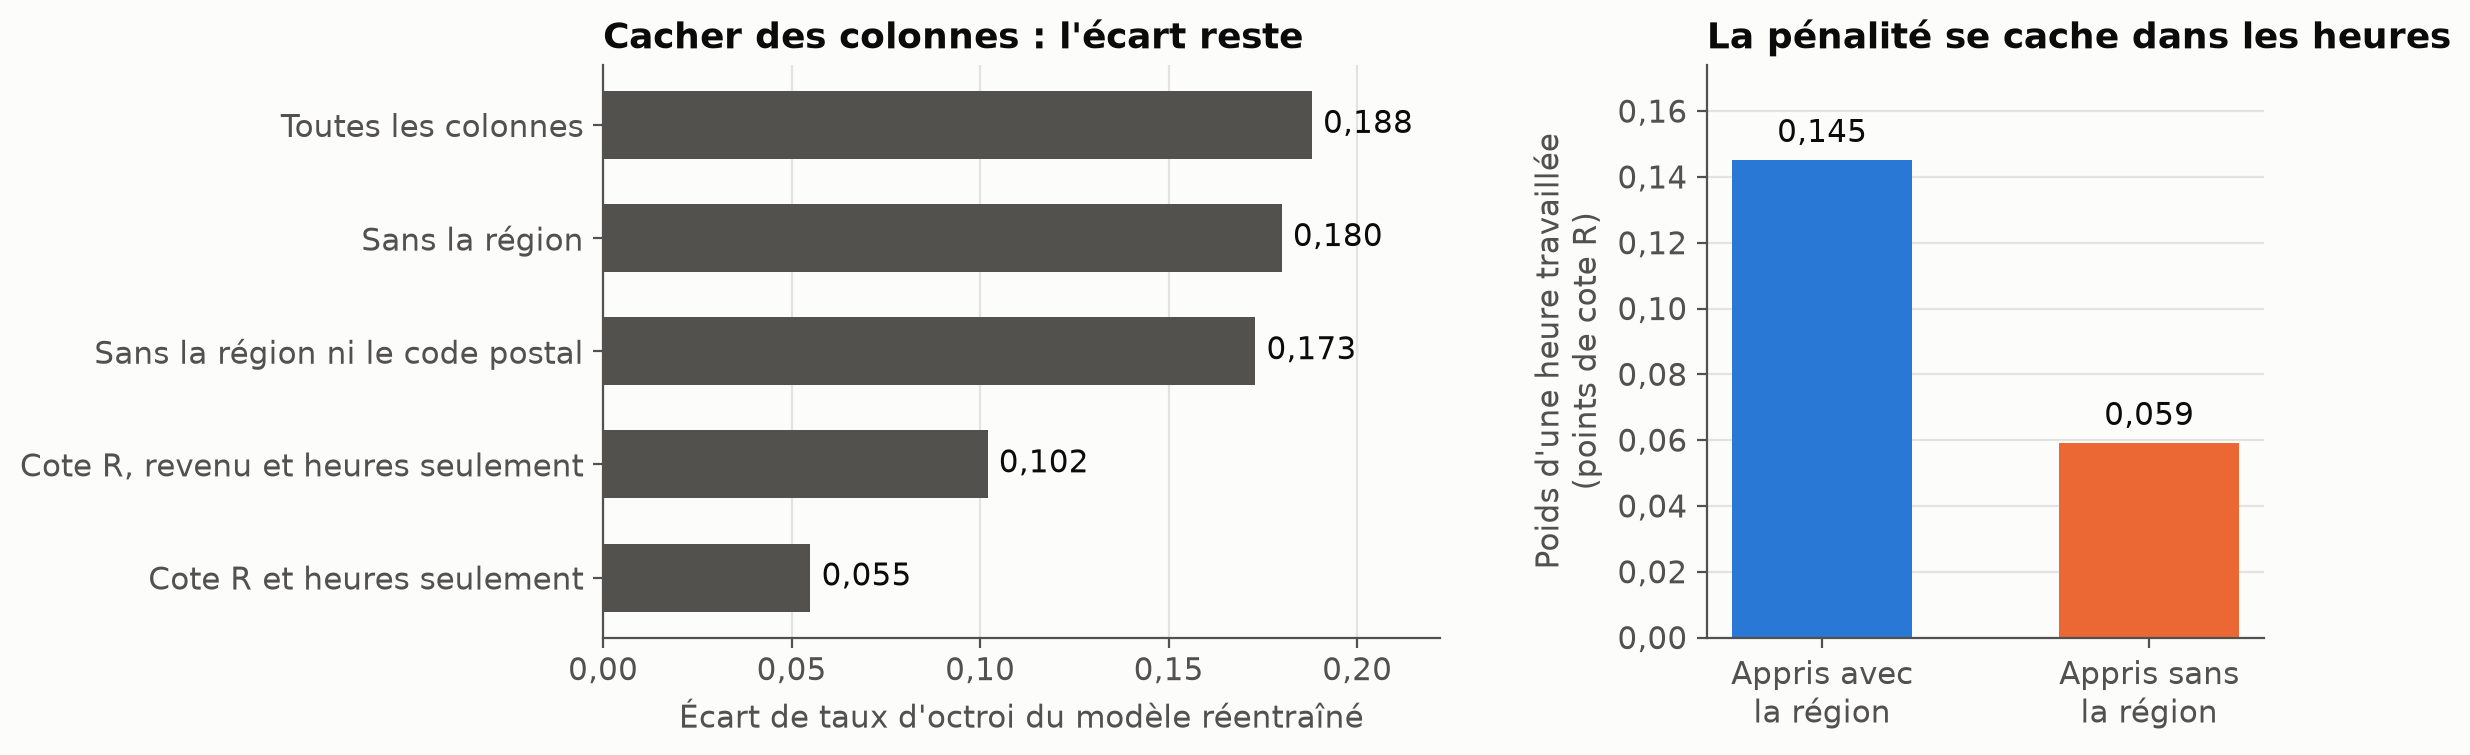
Retirer la région ne suffit pas : le biais change de colonne.
-
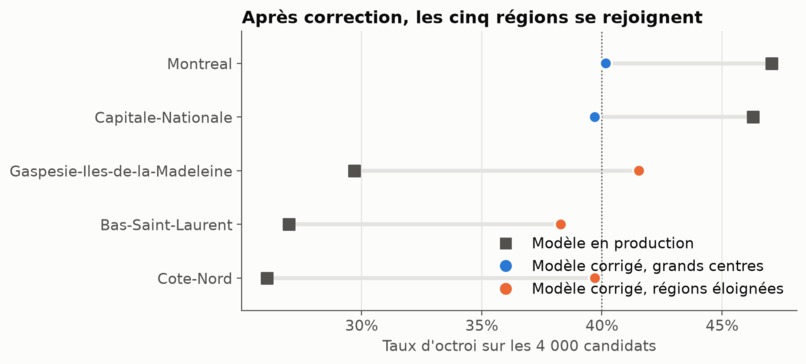
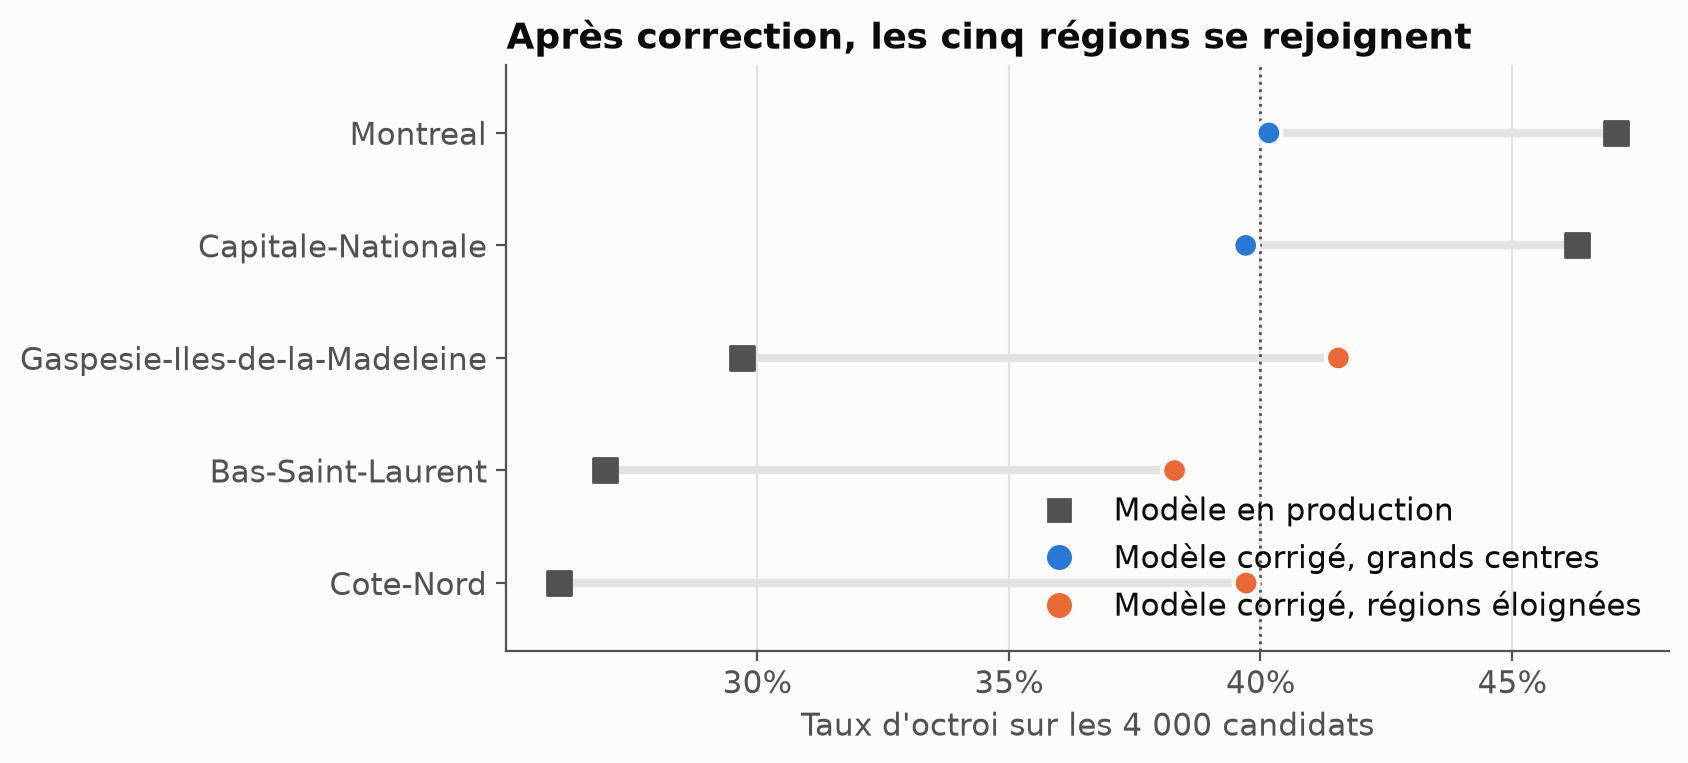
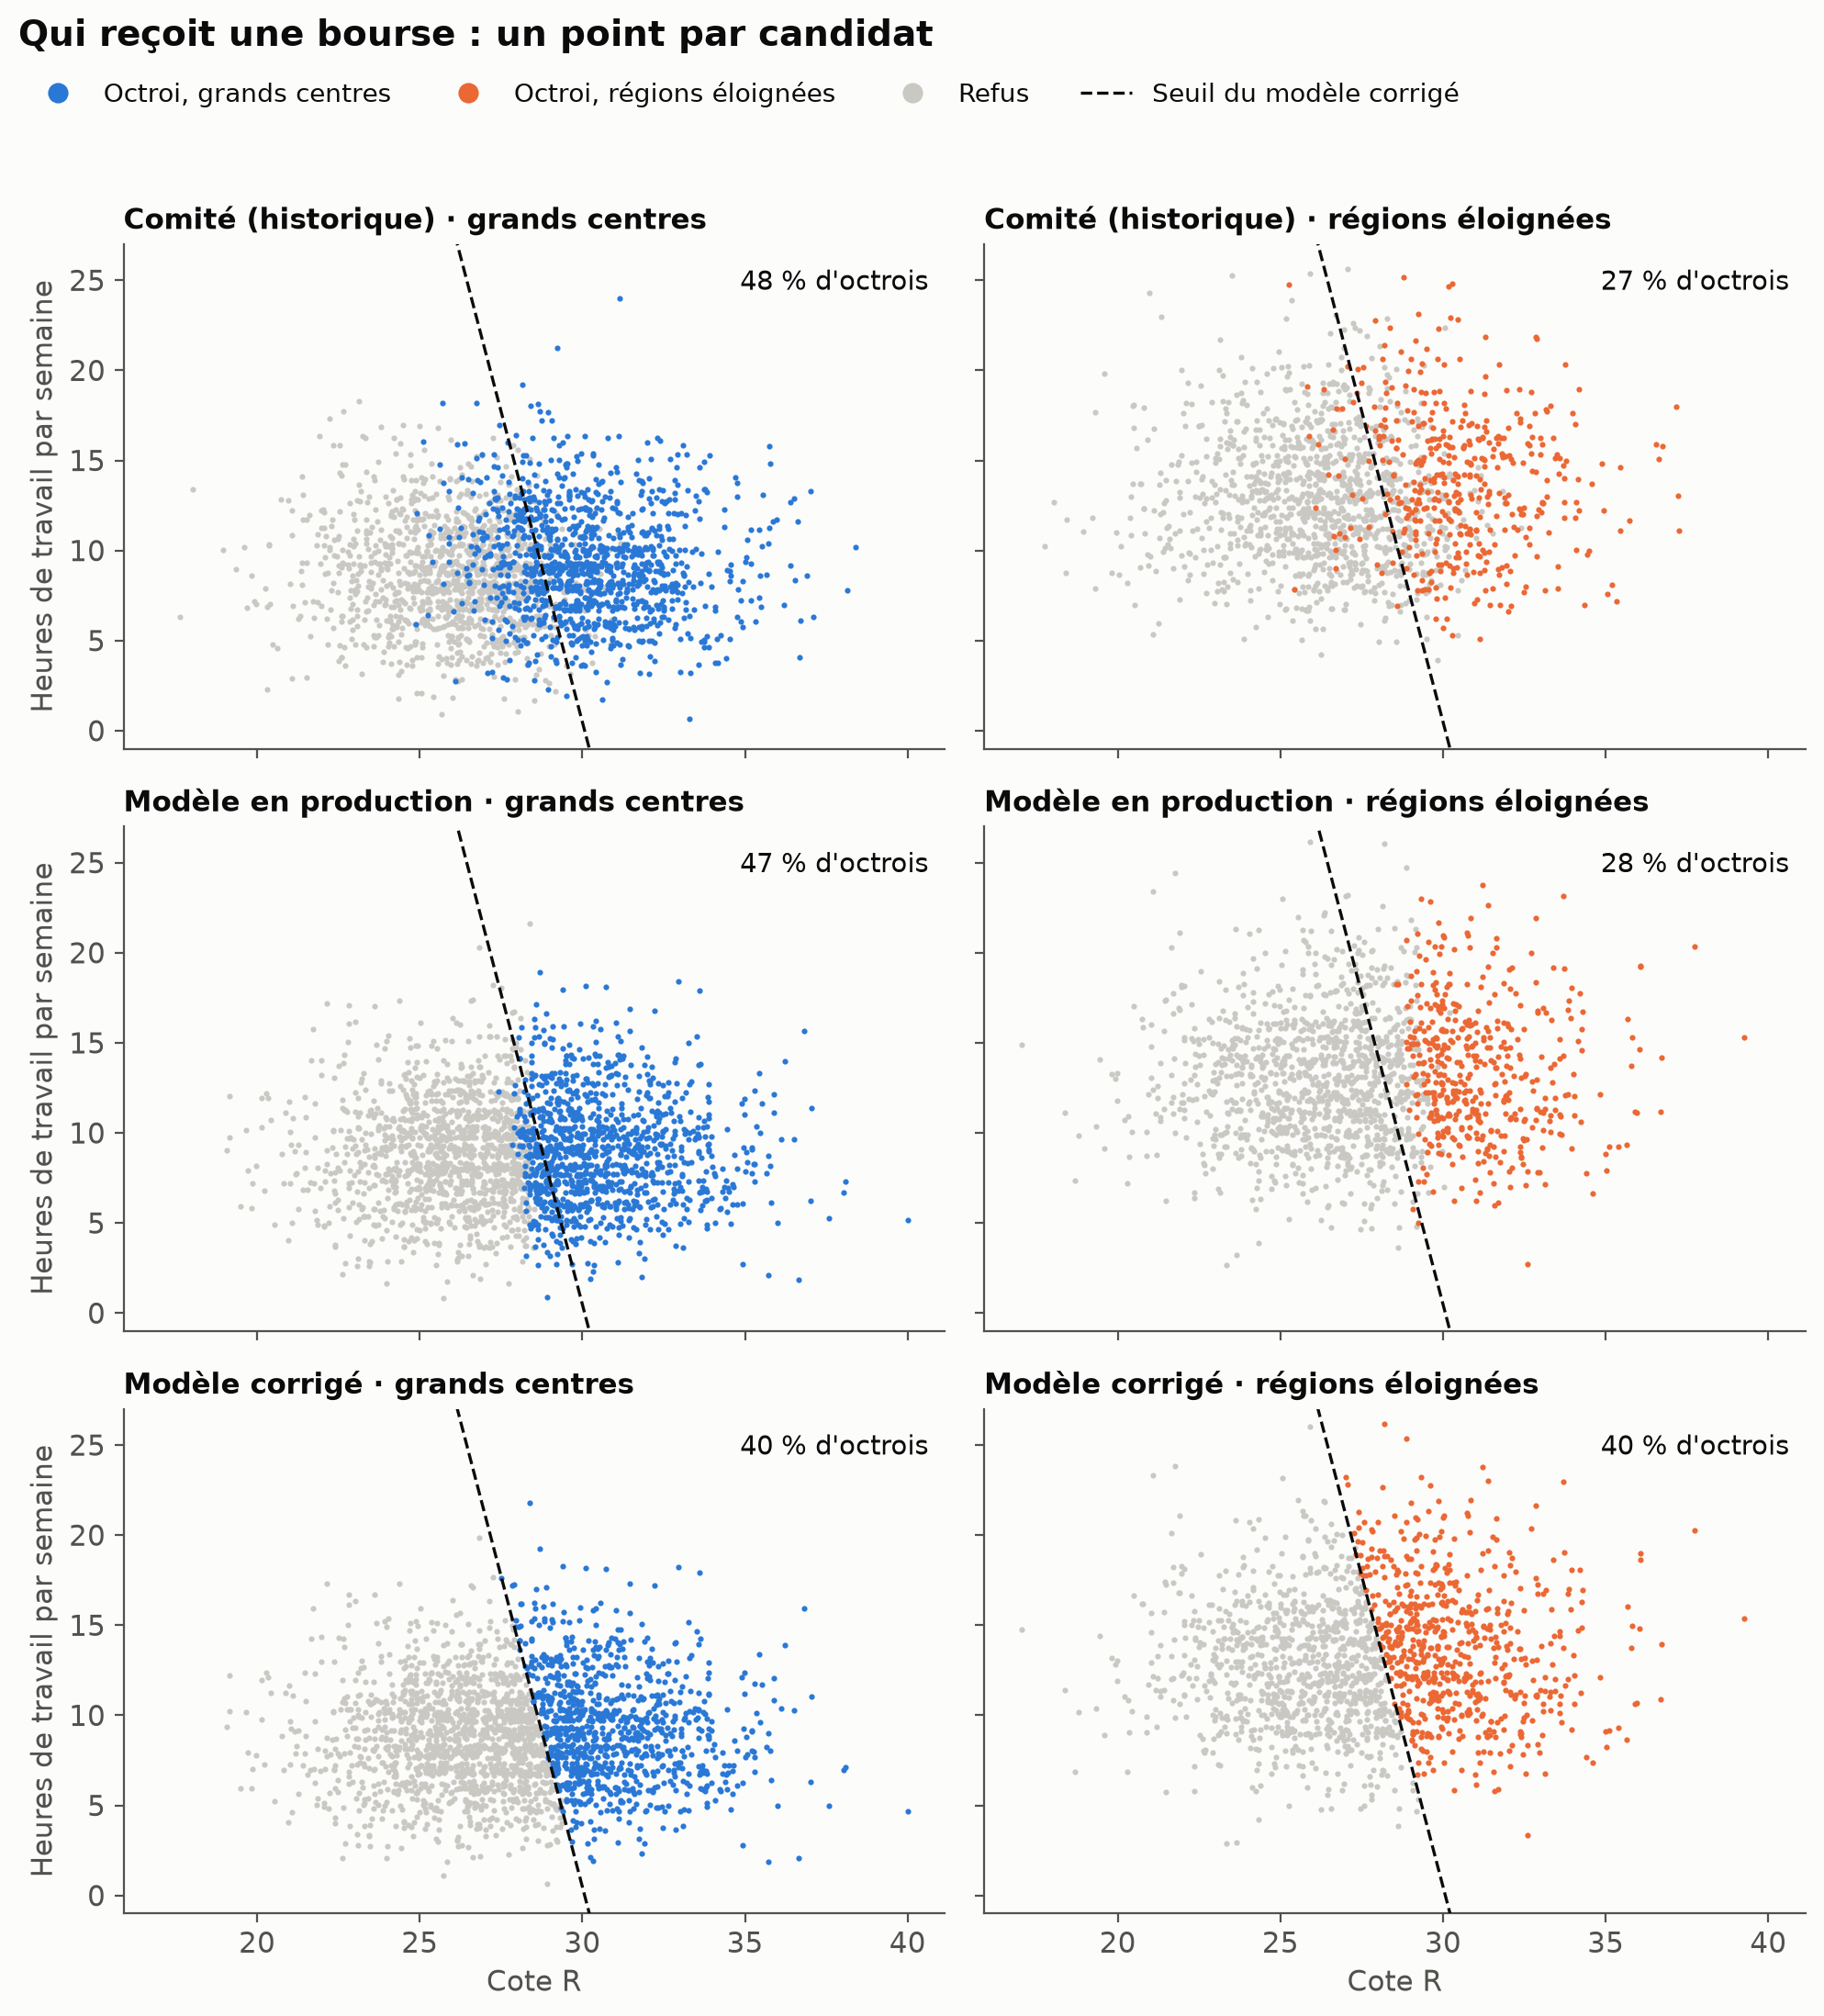
Après correction, les cinq régions se rejoignent autour de 40 %.
-
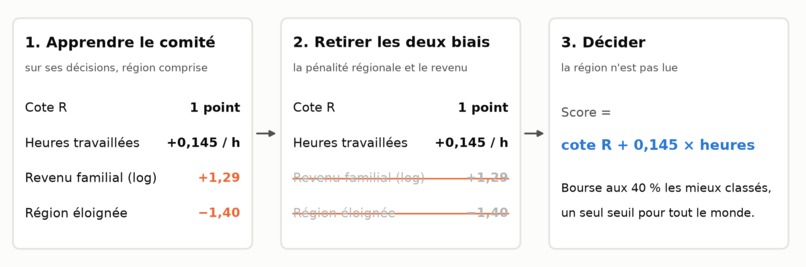
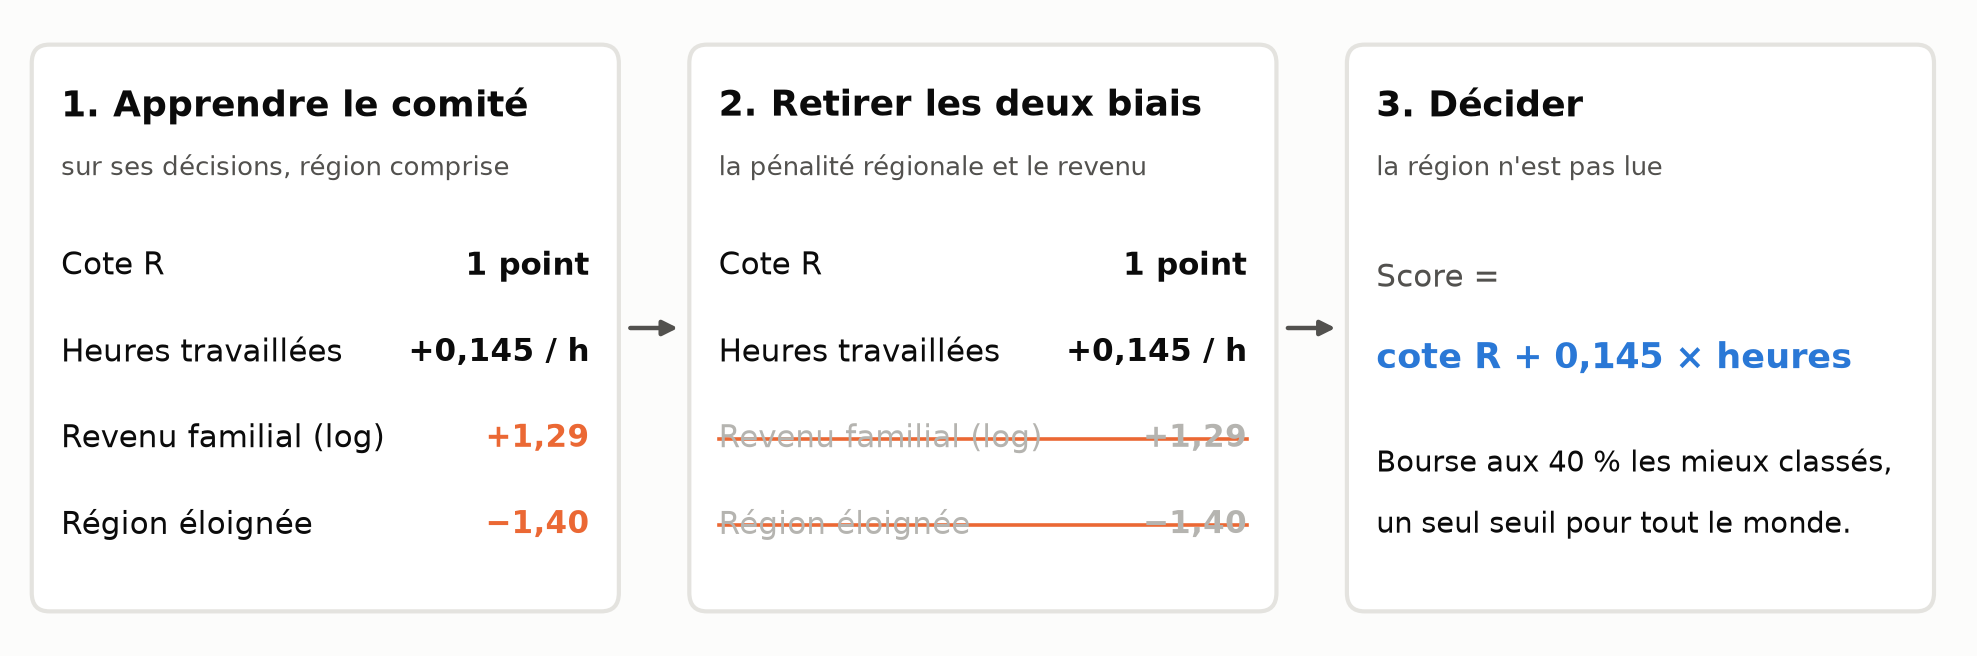
Notre méthode : apprendre le biais pour le retirer.
-
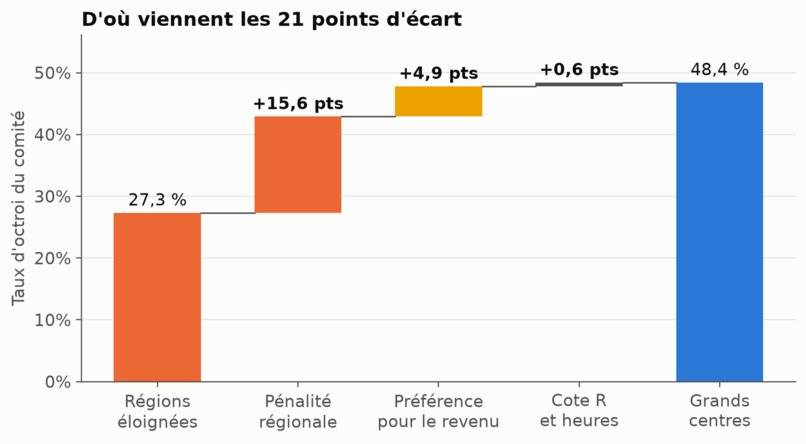
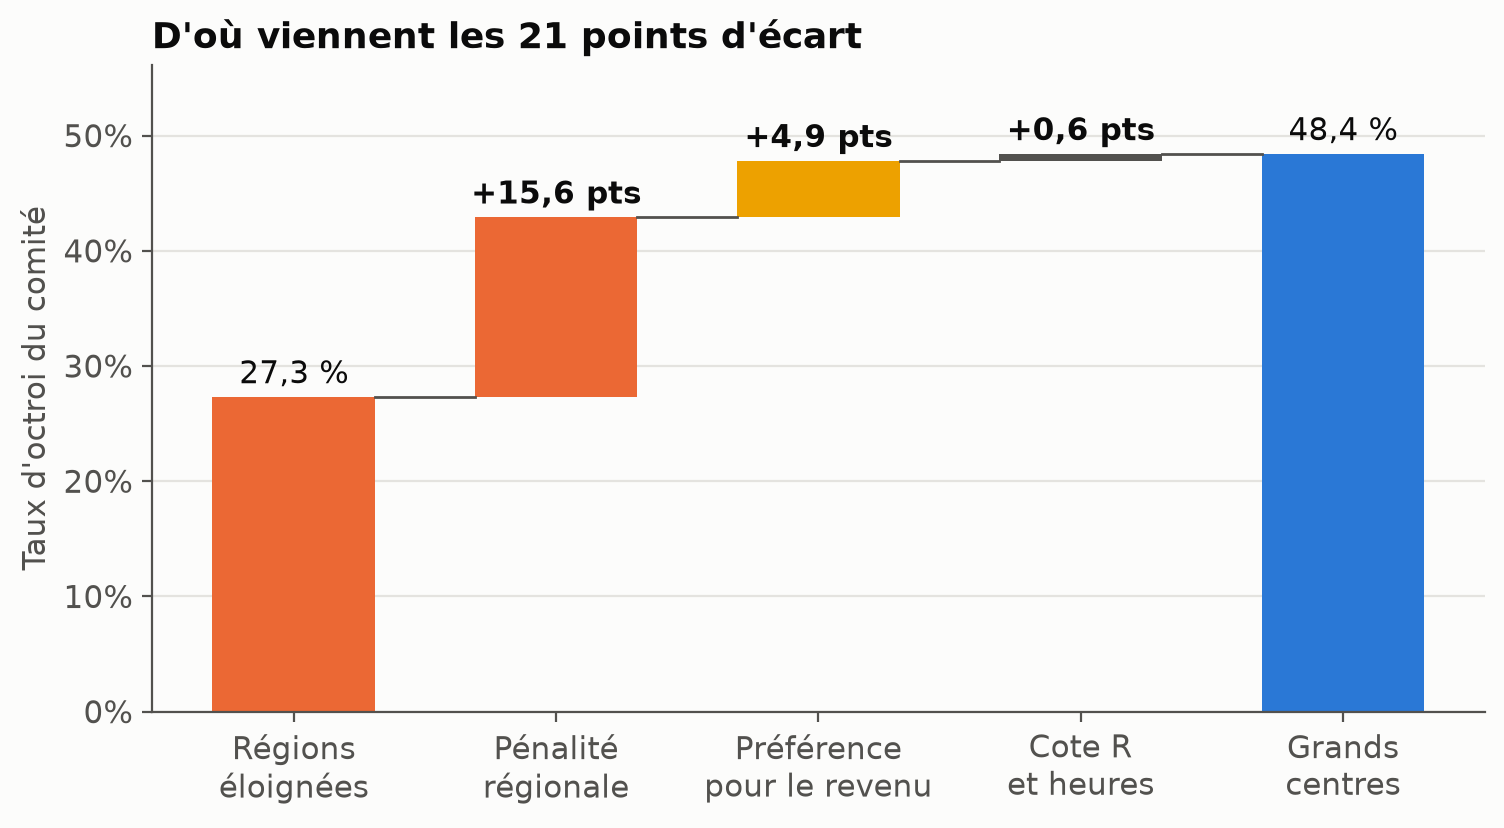
Un écart, deux biais : la pénalité régionale et la préférence pour le revenu.
-
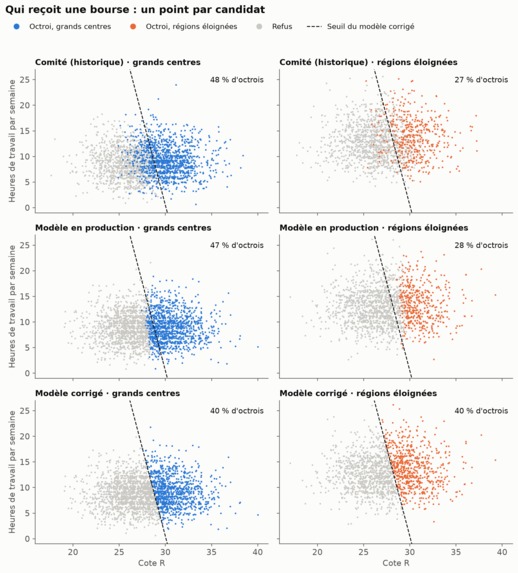
Qui reçoit une bourse : le comité, le modèle en production, le modèle corrigé.
-
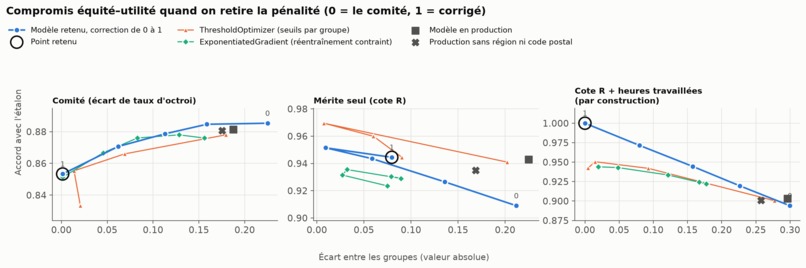
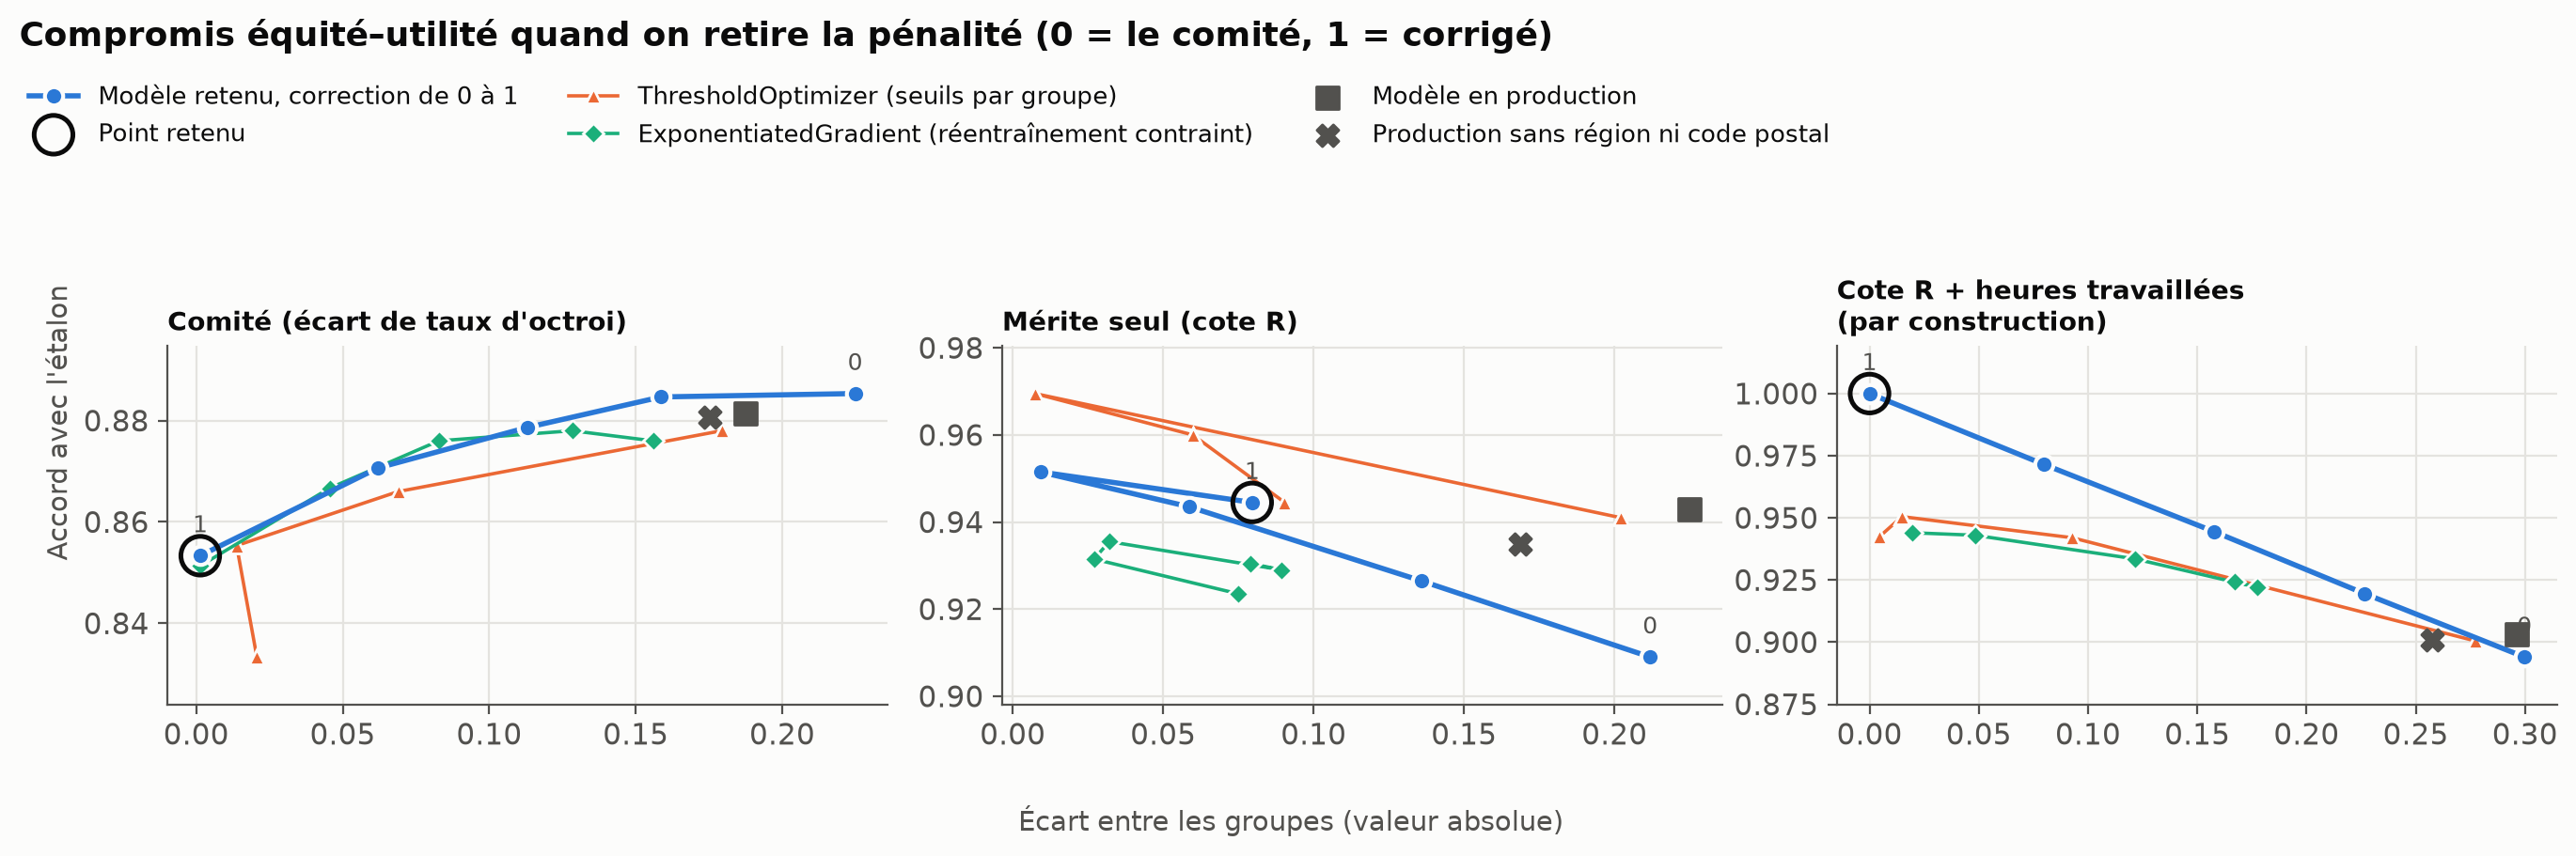
Le compromis équité et utilité.
-
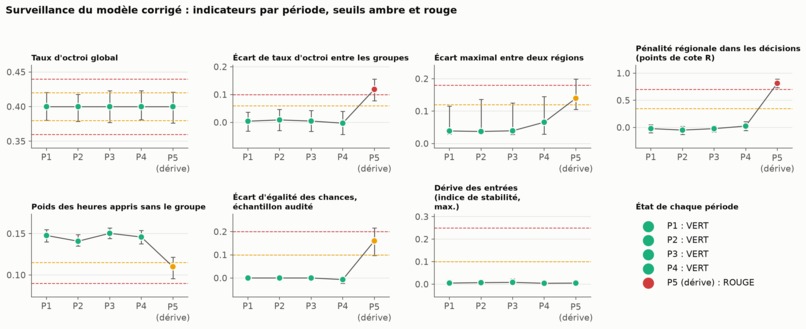
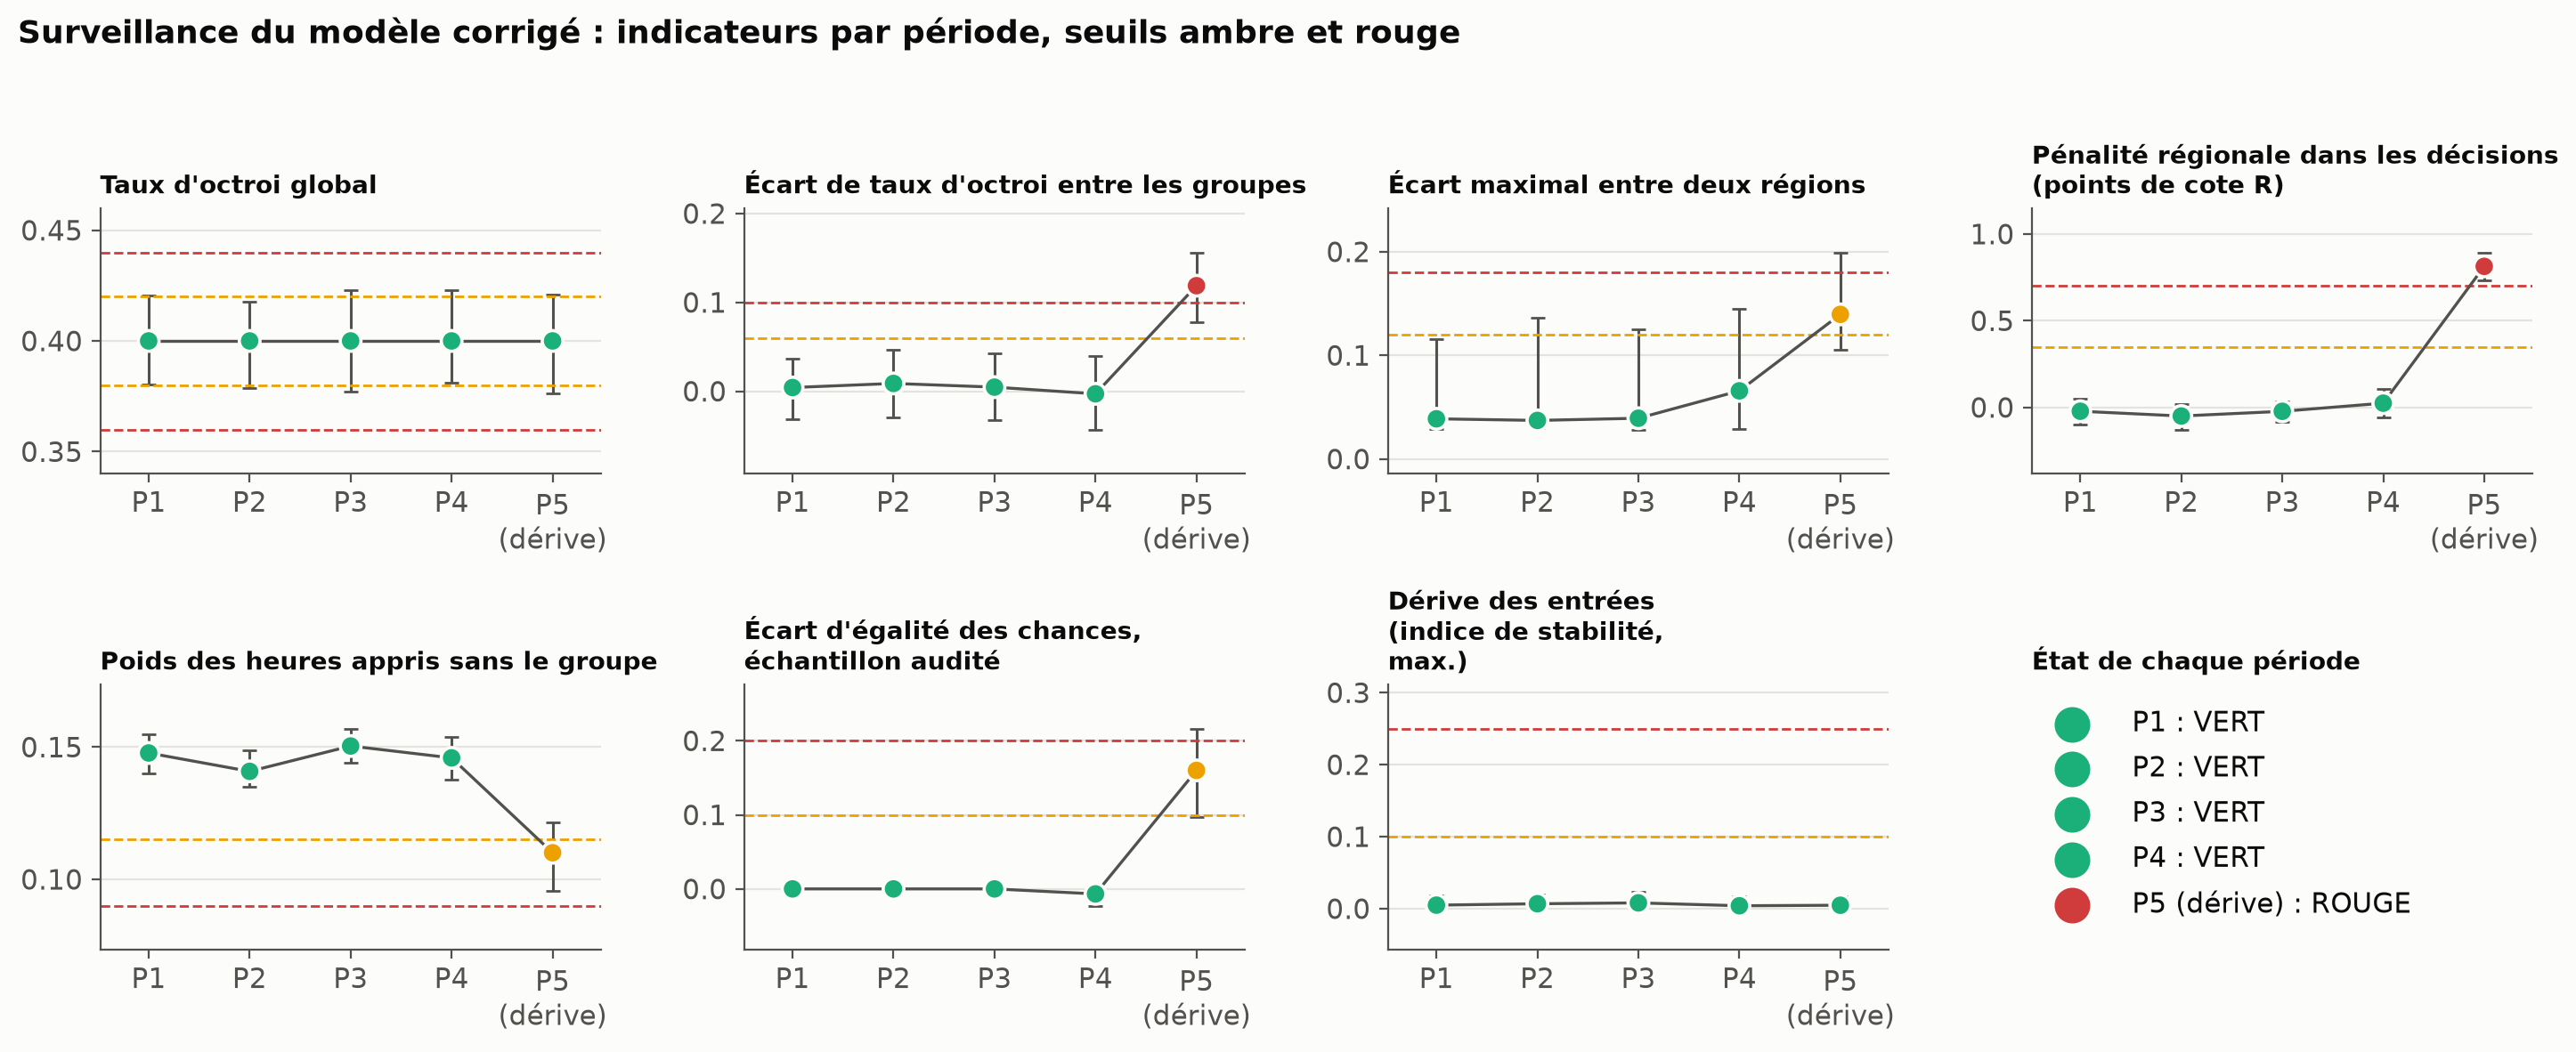
Le prototype de surveillance passe au rouge sur une version mal corrigée.
-
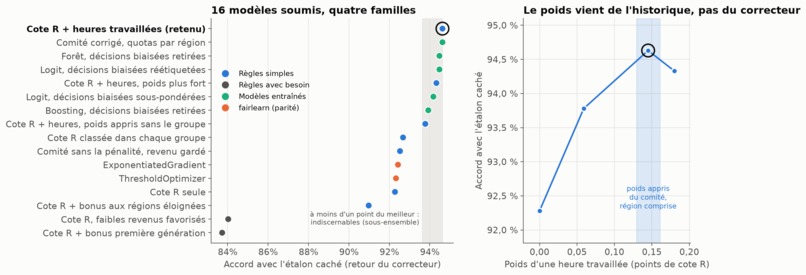
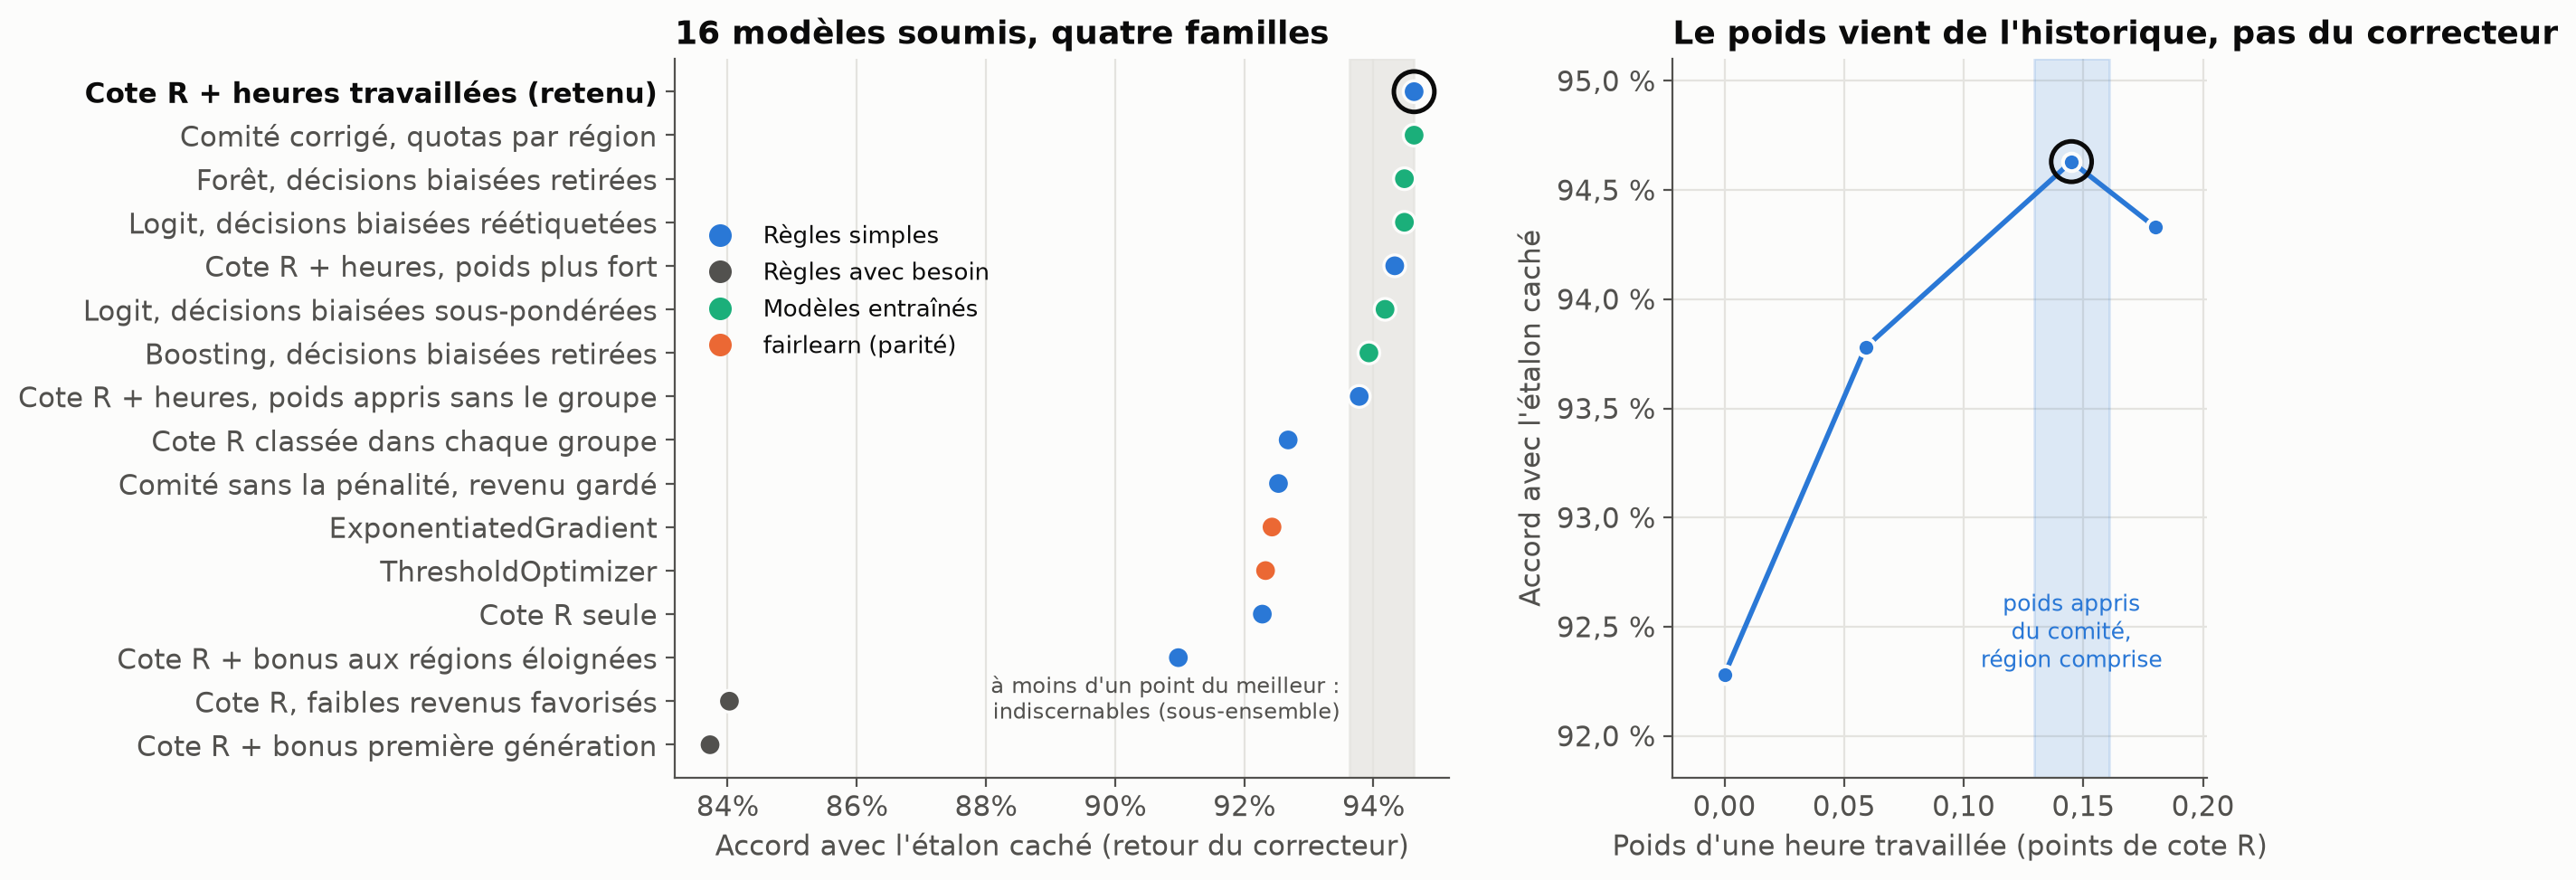
Seize modèles soumis, quatre familles : la règle simple arrive en tête.
Inspiration
Deux étudiants ont la même cote R. L'un habite Montréal, l'autre la Côte-Nord. Le premier reçoit sa bourse, le deuxième non. C'est ce que les données du défi montraient, et on voulait comprendre pourquoi avant de corriger quoi que ce soit.
Ce que fait le projet
ÉquiAlgo fait trois choses.
Un diagnostic. Le comité accordait une bourse à 48 % des candidats des grands centres et à 27 % de ceux des régions éloignées. Ce n'est pas une question de dossier : à cote R égale, l'écart reste. On a montré que le comité se résume à quatre poids, et que deux sont des biais. Le premier est une pénalité fixe pour les régions éloignées, qui vaut 1,4 point de cote R et explique environ les trois quarts de l'écart. Le deuxième est une préférence pour les revenus élevés, qui touche les régions par ricochet.
Une correction. Notre modèle décide avec une seule règle : cote R + 0,145 × heures travaillées, et une bourse aux 40 % les mieux classés. La région n'est jamais lue au moment de décider. Le taux d'octroi passe à environ 40 % dans les cinq régions, et le budget est respecté.
Une surveillance. Un prototype suit sept indicateurs à chaque cycle. Il passe au rouge quand on lui donne une version à moitié corrigée.
Comment on l'a construit
En Python, avec pandas, scikit-learn, fairlearn et SHAP.
On a commencé par modéliser le comité lui-même, pas les candidats. Une fois qu'on sait ce que le comité pesait, on peut enlever ce qui n'a pas sa place.
Le piège, c'est que cacher la région ne règle rien. Le code postal et la distance la redonnent presque à coup sûr. Pire, quand le modèle ne voit plus la région, il cache la pénalité ailleurs : il apprend que les heures travaillées comptent moins, parce que les étudiants des régions travaillent plus.
Notre méthode va donc dans l'autre sens :
- On apprend le comité avec la région, pour que la pénalité soit mise au bon endroit.
- On retire la pénalité régionale et la préférence pour le revenu.
- On décide avec ce qui reste : la cote R et les heures.
Ensuite on a comparé cette règle à tout le reste : forêts, boosting, ensembles, quotas par région, contraintes de parité de fairlearn. Chaque essai est une petite spécification qu'on peut rejouer, et une seule commande reconstruit tous les livrables.
Les défis
L'étalon est caché. Les décisions du comité ne sont pas la vérité, elles sont biaisées. Le modèle en production est « exact à 88 % », mais ça veut seulement dire qu'il imite bien le comité. On a donc écrit plusieurs hypothèses sur ce que le mérite veut dire, et on a jugé chaque modèle contre toutes.
Ne pas tricher avec le correcteur. On avait des retours sur un sous-ensemble. On s'est donné une règle : chaque fichier soumis est un vrai modèle qu'on serait prêts à garder, et aucun paramètre n'est réglé sur ces retours. Le poids des heures vient de l'historique.
Résister à la complexité. On a essayé beaucoup de modèles plus sophistiqués. Aucun n'a battu la règle d'une ligne.
Ce dont on est fiers
- Avoir trouvé où le biais se cache quand on retire la région. C'est notre résultat le plus important.
- Une règle qu'on peut expliquer exactement à un candidat refusé.
- Sur seize fichiers soumis, c'est la règle la plus simple qui a le meilleur accord avec l'étalon caché (environ 94,6 % sur le sous-ensemble), devant la parité imposée par fairlearn.
- Un outil de surveillance qui mesure le biais directement, pas seulement ses symptômes.
Ce qu'on a appris
Être exact ne veut pas dire être juste. Quand les données d'entraînement sont biaisées, un modèle très exact est un modèle très fidèle au biais.
On a aussi appris qu'il faut comprendre un biais avant de le corriger. Cacher une colonne donne bonne conscience, mais ça ne change presque rien.
Et un modèle simple qu'on comprend vaut mieux qu'un modèle compliqué qui fait pareil.
La suite
Certaines décisions ne sont pas techniques, et elles reviennent à l'institution :
- Les heures travaillées sont-elles du mérite ou une contrainte ?
- Faut-il tenir compte du besoin financier ? Notre modèle ne le fait pas de lui-même.
- Le budget est fixe, donc des candidats des grands centres perdent. Qui en décide ?
Côté technique : tester sur de vraies données, parce qu'un vrai comité est moins régulier, et envoyer les dossiers proches du seuil à un réviseur humain.
Built With
- fairlearn
- jupyter
- marp
- matplotlib
- pandas
- python
- scikit-learn
- shap

Log in or sign up for Devpost to join the conversation.