Inspiration
Reprendre un projet en cours exige de traiter des sources éparpillées et contradictoires (courriels, comptes rendus, tickets, tableurs, factures, Teams). Le défi Projet 360 place le projet fictif NOVA dans cette configuration, figée au 30 septembre 2026 à 9 h.
L'objectif : établir l'état réel du projet à cette date et en fournir la preuve vérifiable. La date de modification d'un fichier ne garantit pas l'exactitude d'une donnée. Une livraison ne constitue pas une validation, et une proposition ne vaut pas décision.
Ce que fait NOVA
NOVA transforme un corpus désorganisé de 63 fichiers en une mémoire opérationnelle structurée et sourcée :
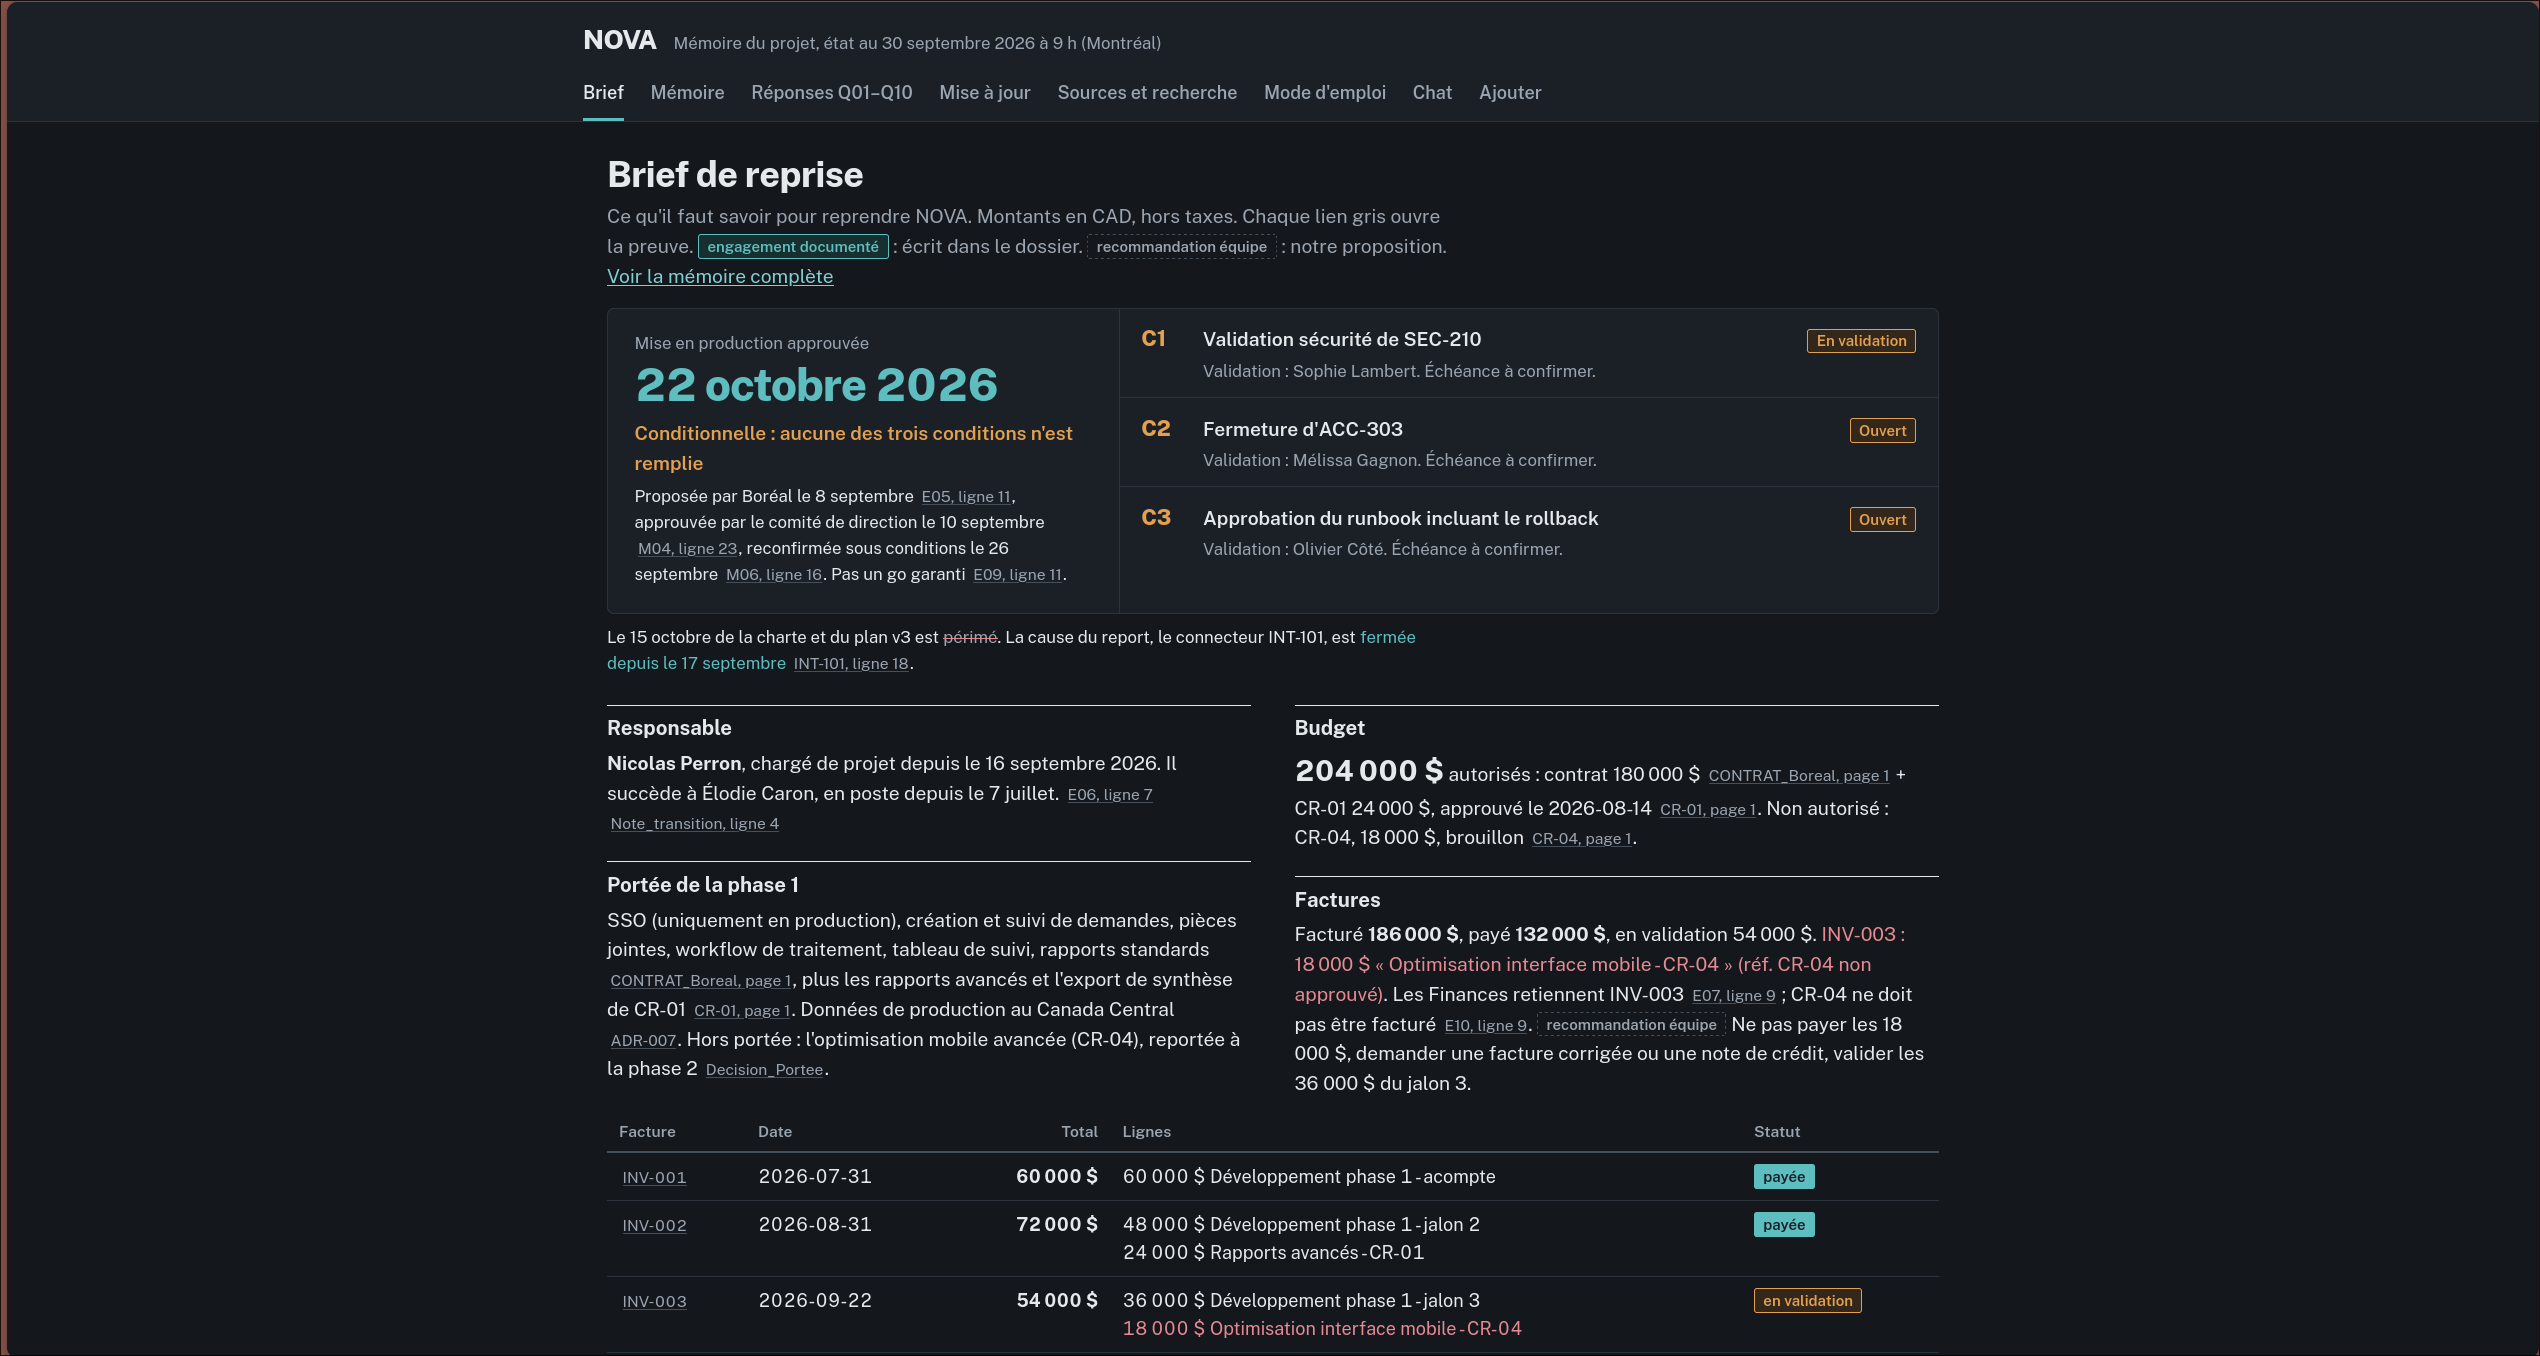
- Brief d'une page : Affiche la date de mise en production approuvée (22 octobre 2026), ses trois conditions préalables, le responsable, la portée, le budget et le suivi des factures.
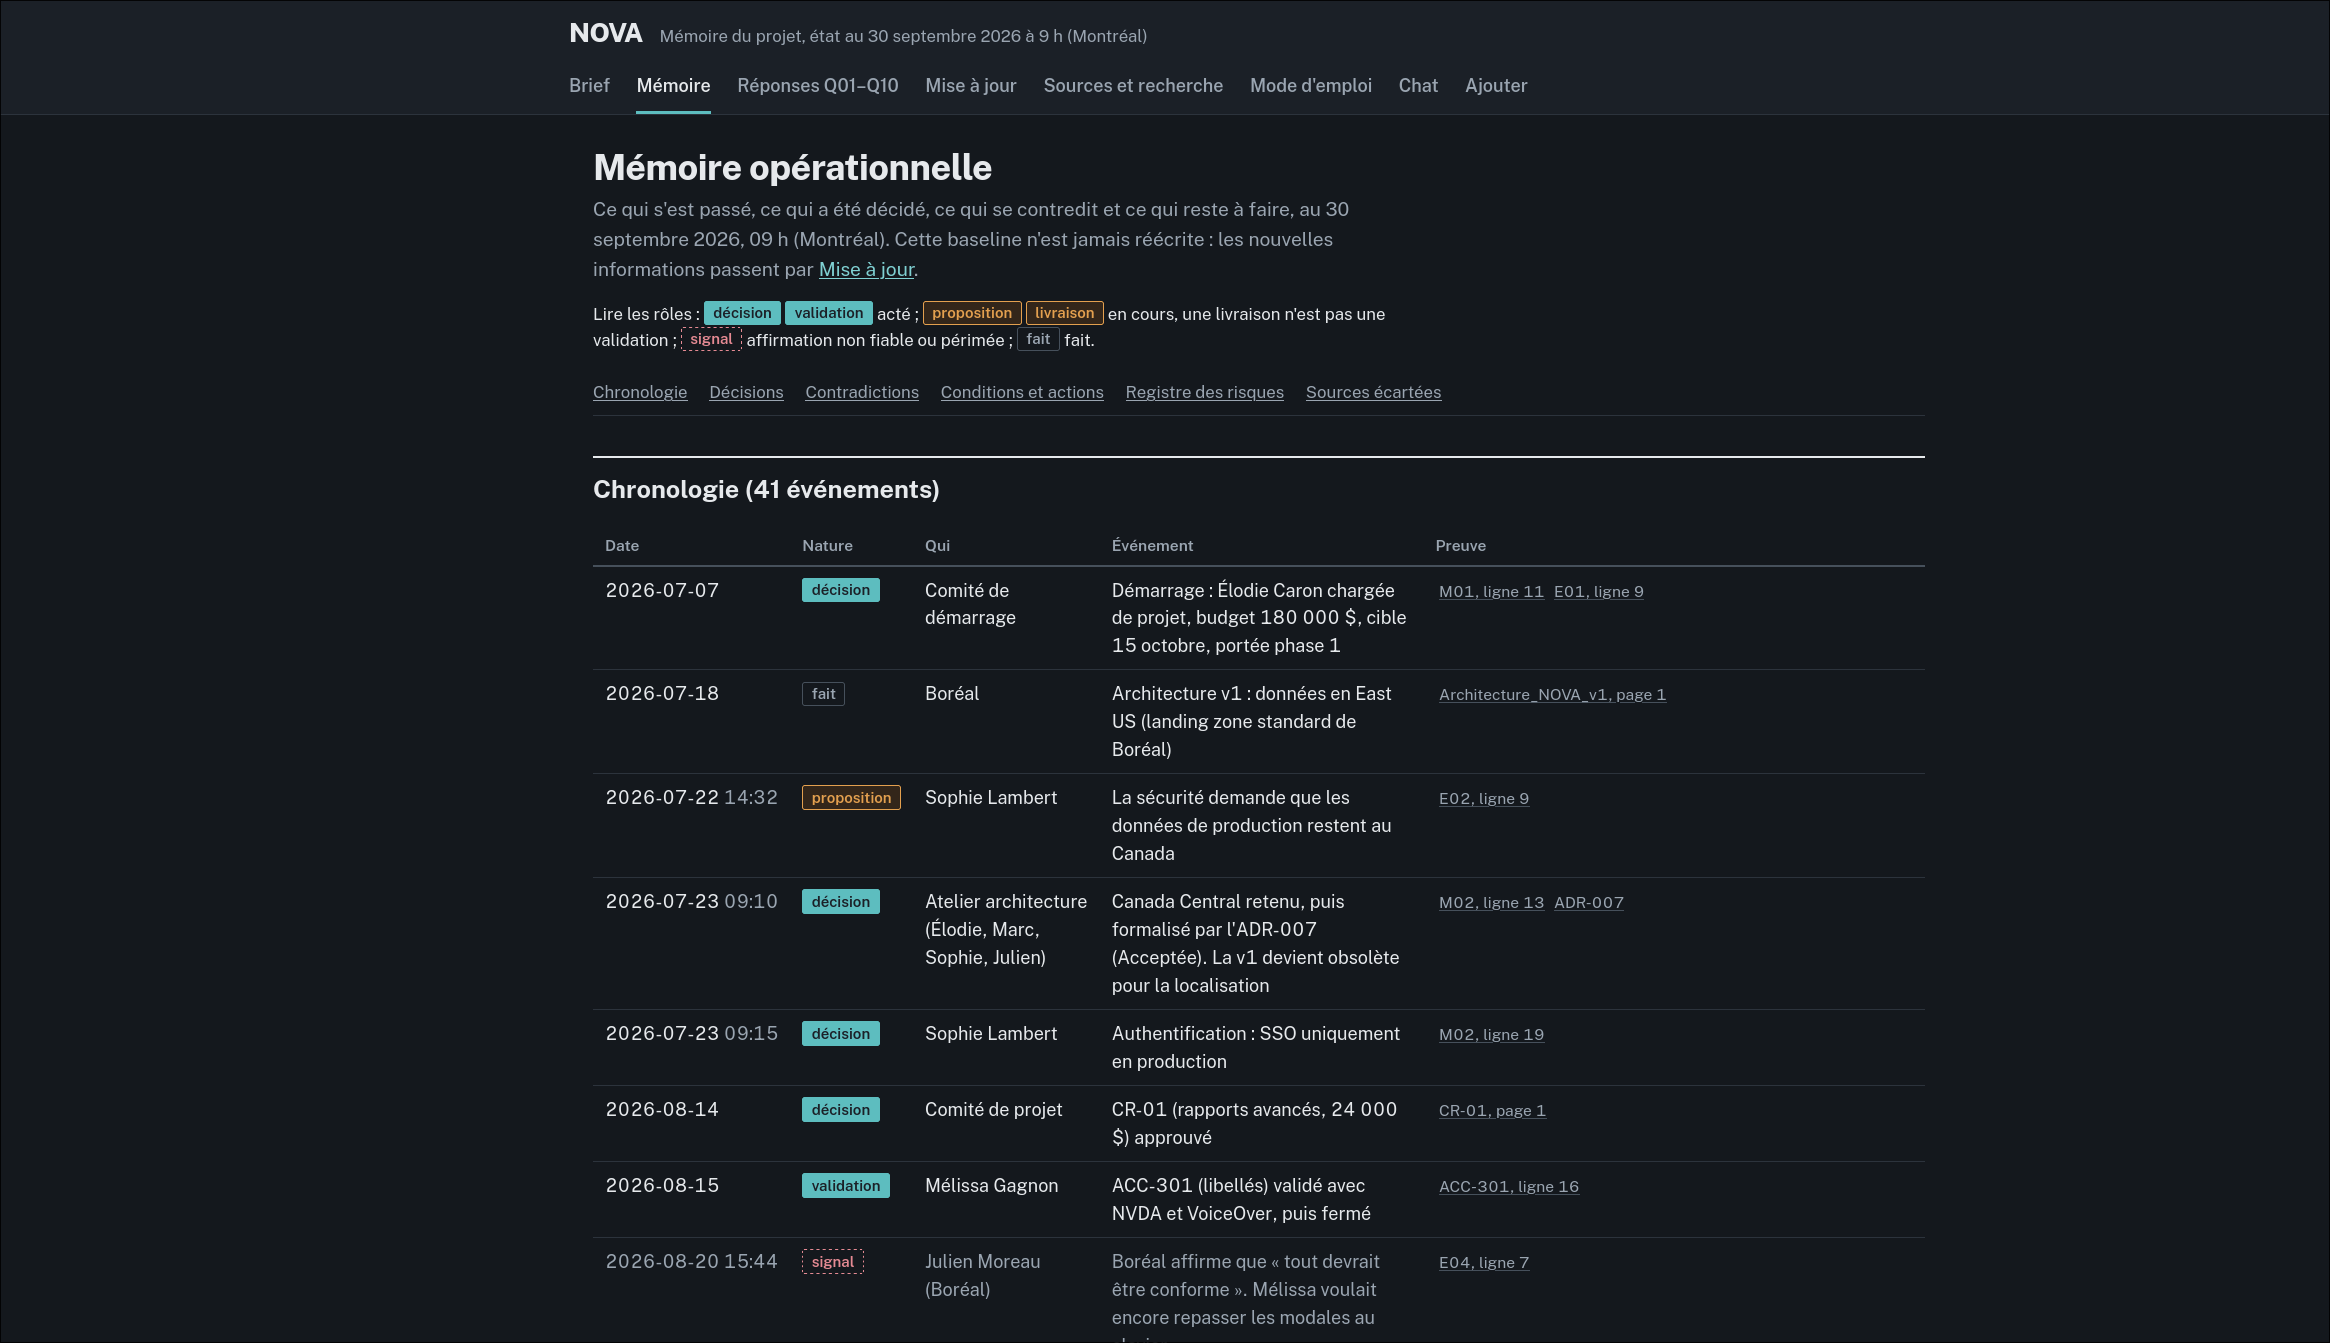
- Mémoire complète : Contient une chronologie de 41 événements qualifiés (proposition, décision, validation, livraison, signal), 7 trajectoires de décisions, 9 contradictions résolues et 10 actions attribuées avec échéance.
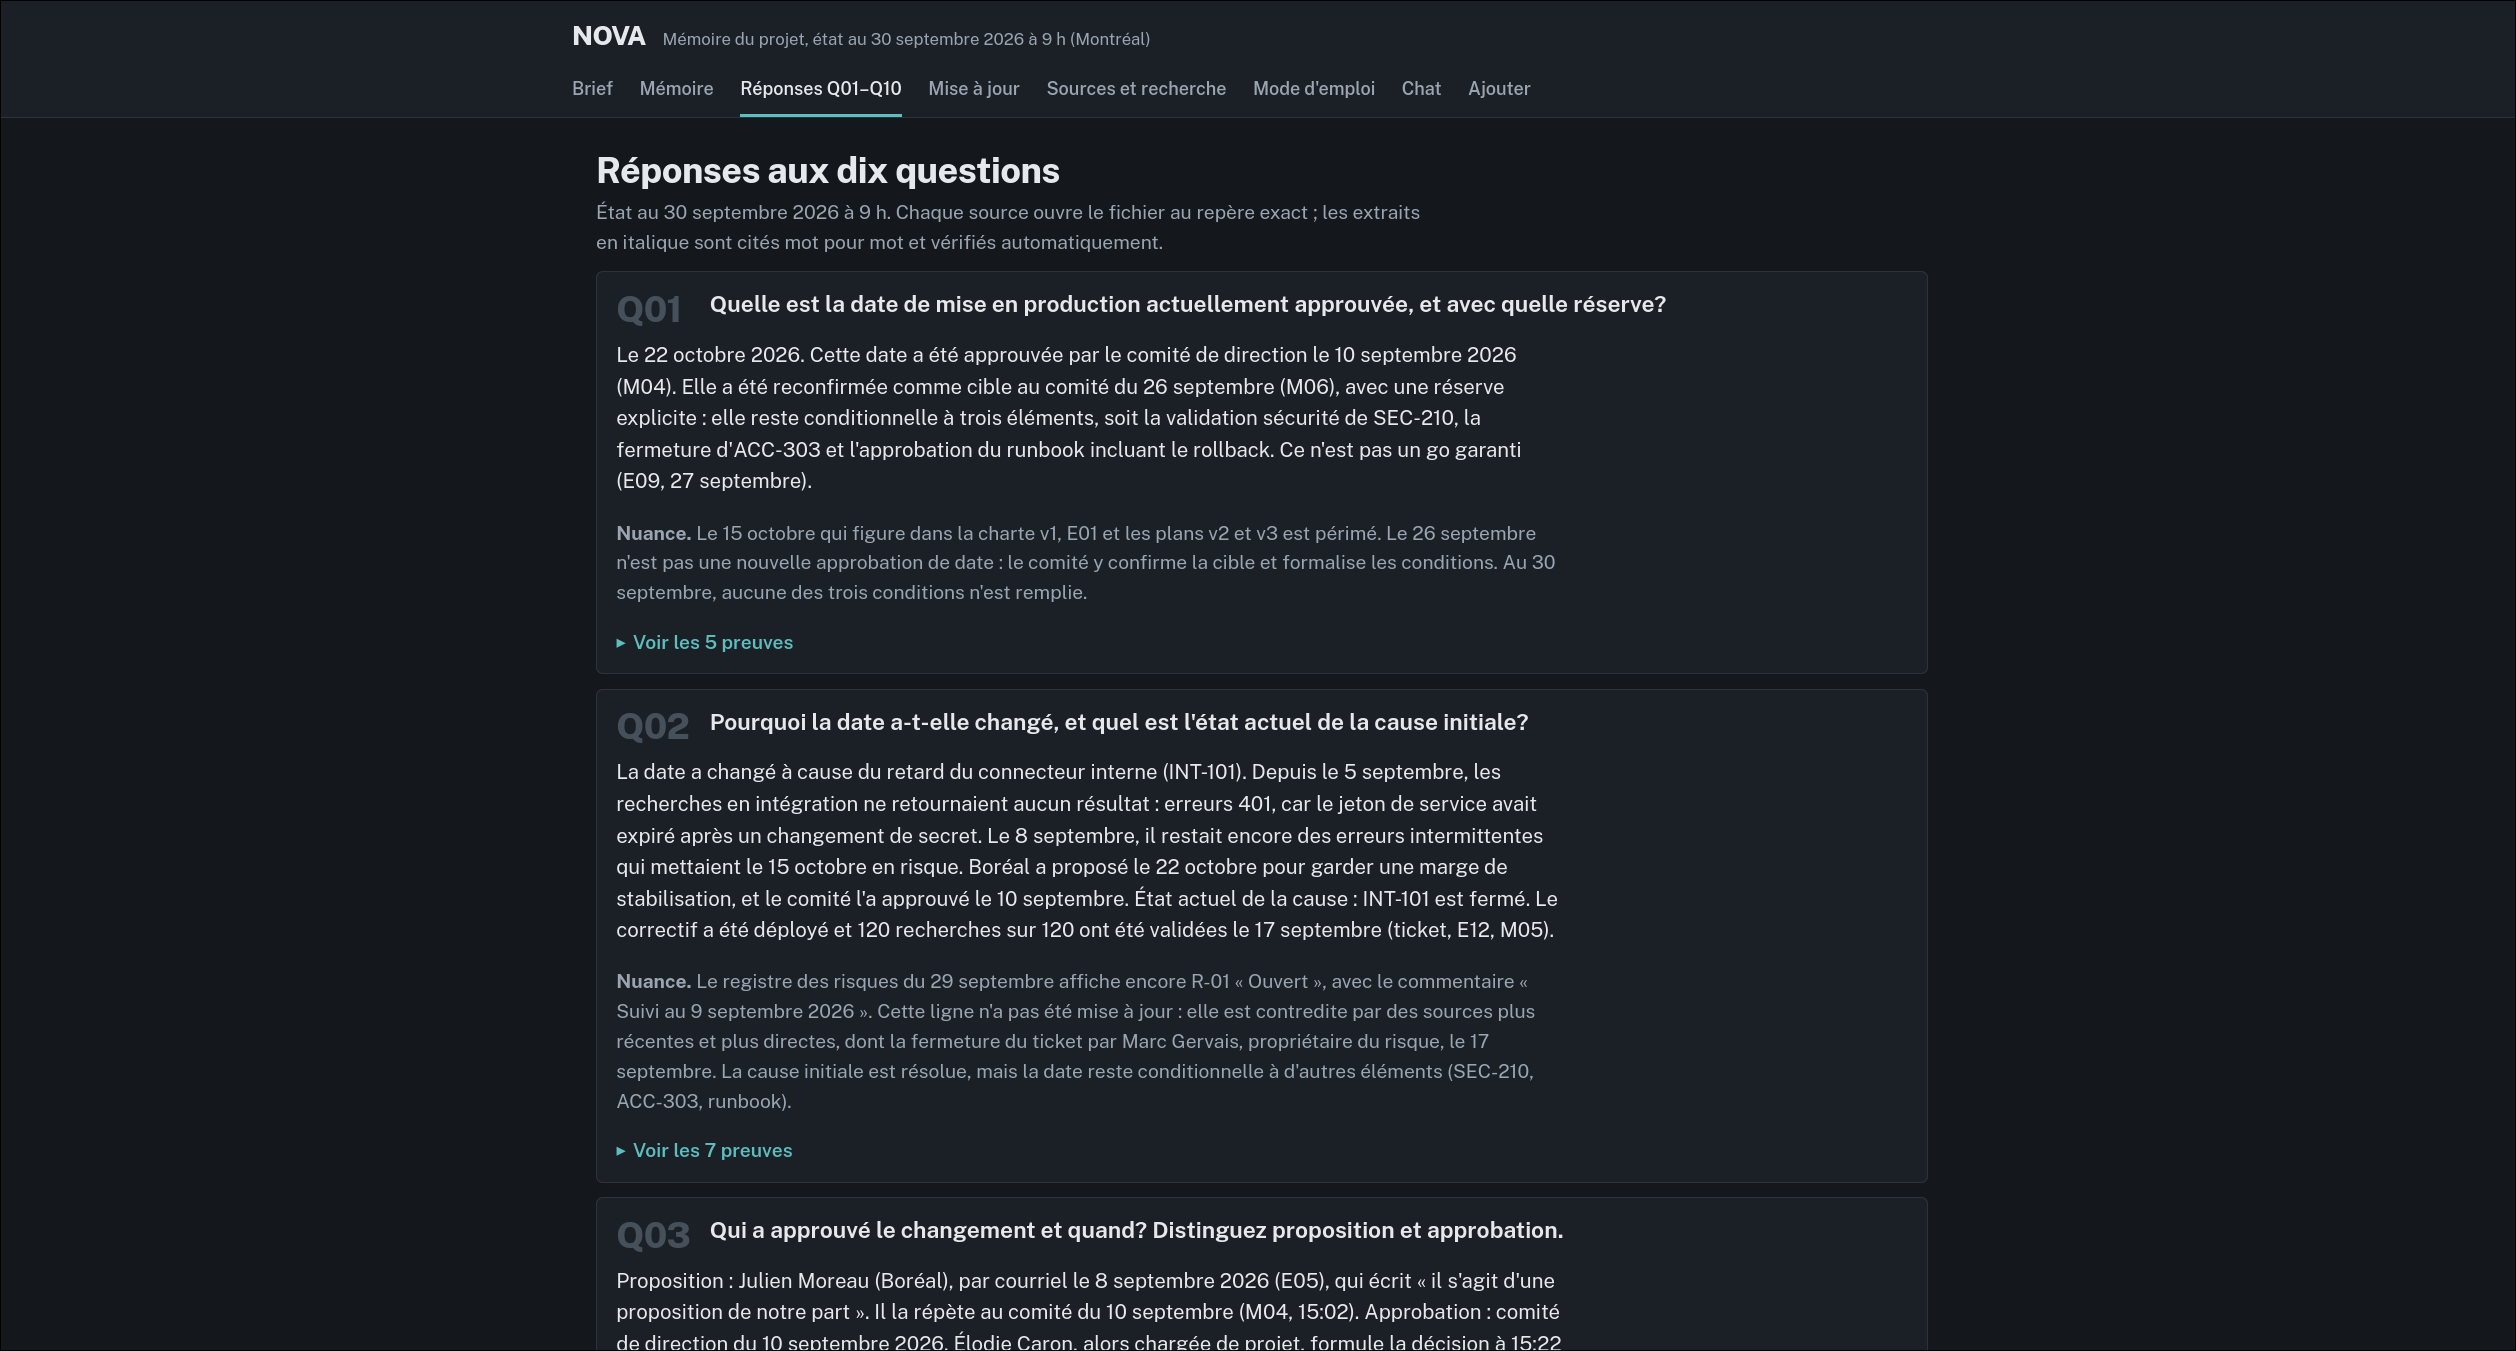
- Réponses vérifiables : Répond aux 10 questions du défi à l'aide de citations exactes renvoyant au fichier, à la ligne, à la page ou à la cellule source.
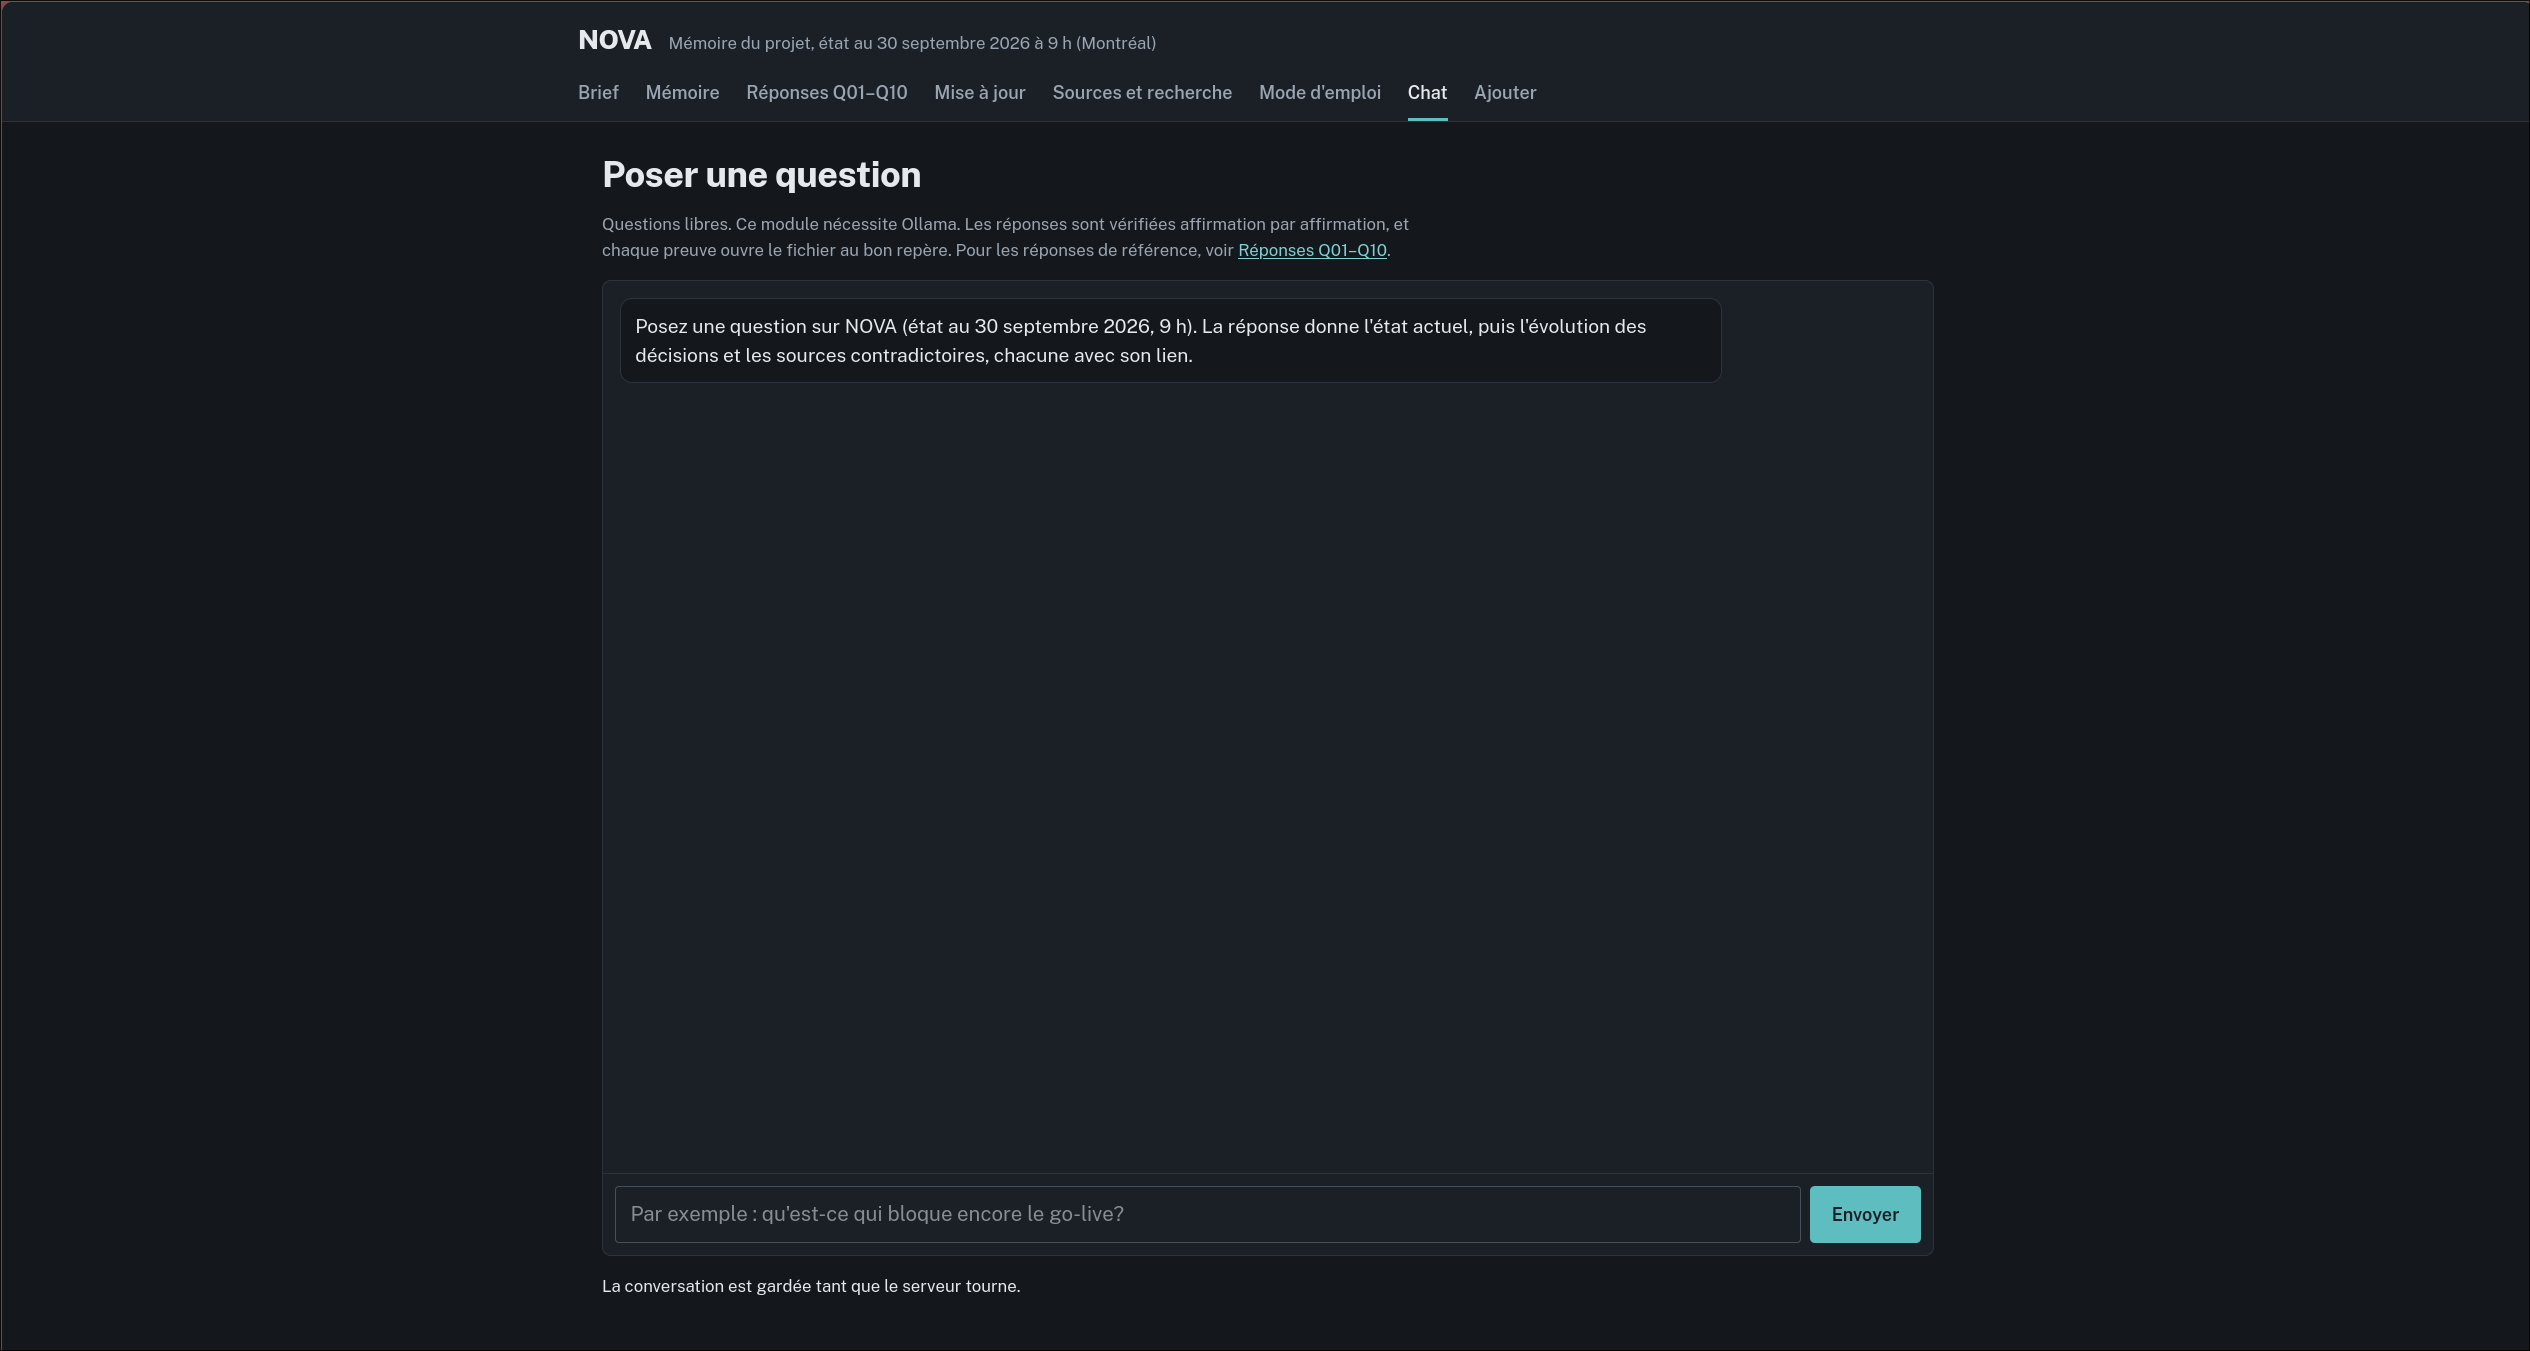
- Chat justificatif : Fournit l'état actuel d'un sujet, expose l'historique des arbitrages et détaille la raison du rejet des sources obsolètes.
- Analyse d'impact : Évalue tout nouveau document déposé en identifiant les modifications, les éléments affectés et les actions requises, sans altérer la baseline.
- Export HTML autonome : Génère un livrable consultable hors ligne, sans dépendance Python ni exécution de LLM.
Architecture et réalisation
- Ingestion du corpus : Scripts Python dédiés pour les courriels, PDF (
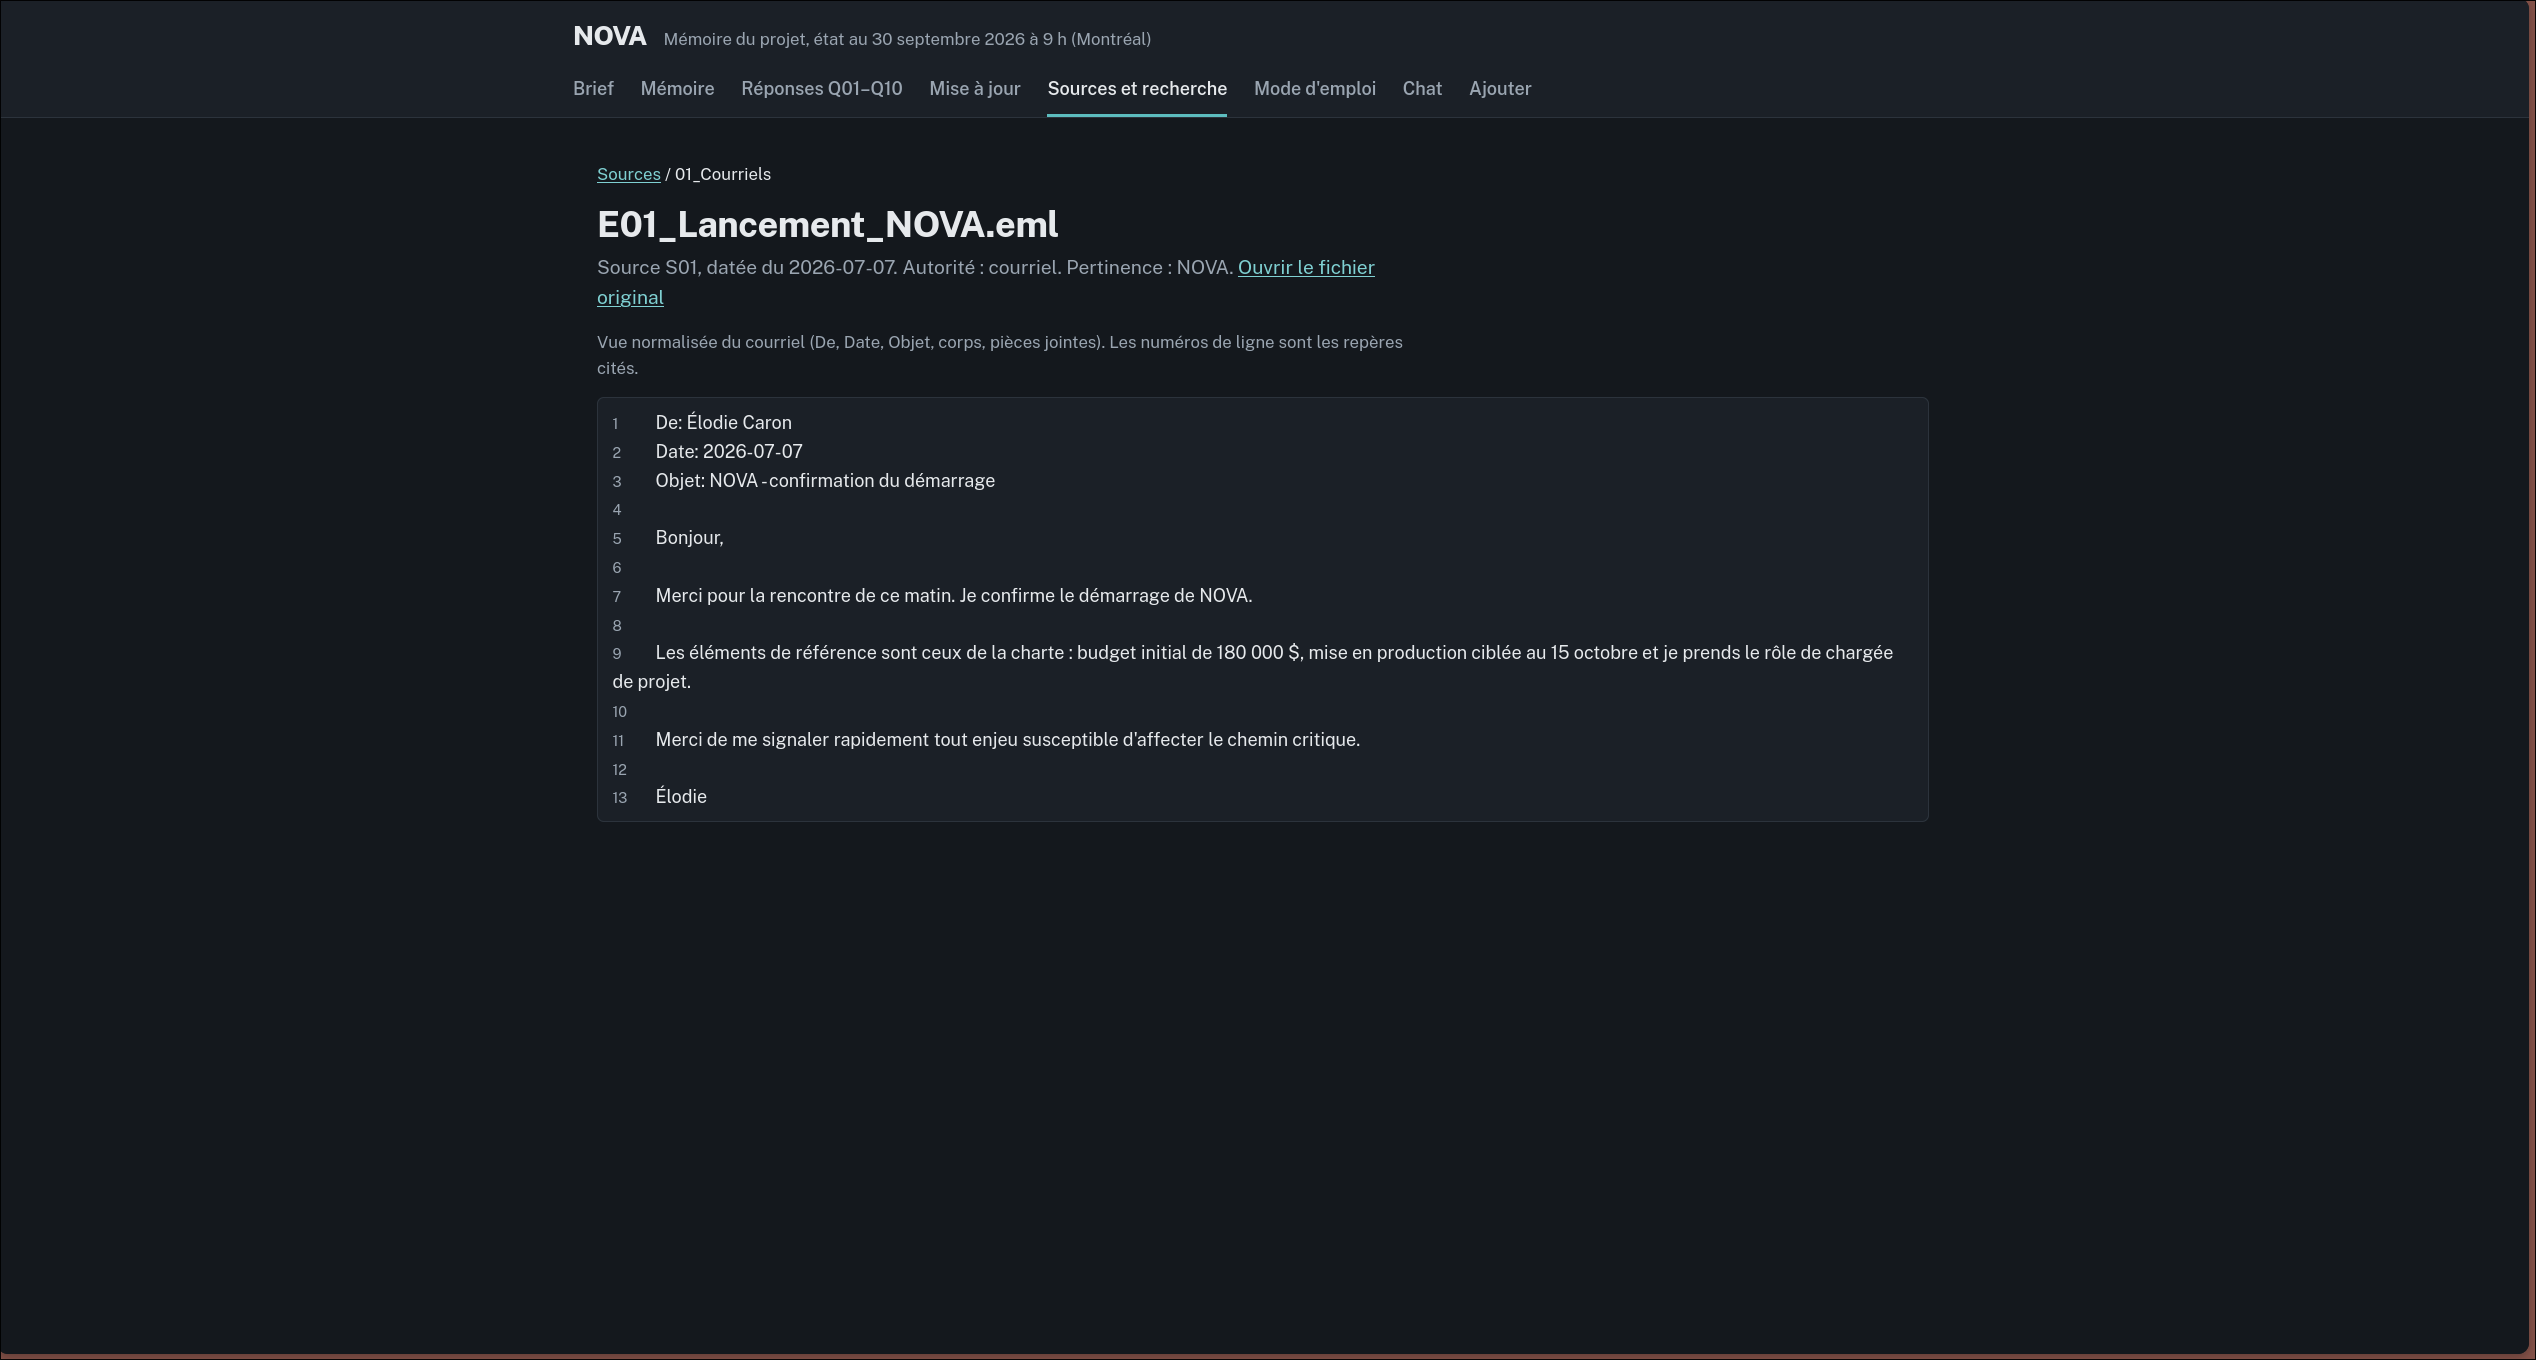
pypdf), fichiers Excel avec commentaires (openpyxl), CSV et texte. Le dossier est découpé en 412 extraits repérés (claims). Transcription et vérification manuelle des 8 captures d'écran. - Mémoire vérifiable : Chaque assertion intègre une citation verbatim. Un module de localisation valide automatiquement la présence exacte de l'extrait dans le document source.
- Résolution des faits : Le code détermine l'état valide selon la date du fait et l'autorité de la source, indépendamment de la date du fichier.
- Orchestration LLM : LangGraph avec l'API Gemini comme moteur principal et Ollama (Llama 3.1 local) en basculement (fallback). Le LLM gère la formulation textuelle, tandis que le code valide la logique, les entités et les statuts. Un agent vérificateur contrôle la conformité des sorties.
- Interface : Application FastAPI utilisant un code couleur fonctionnel (sarcelle pour l'acté, ambre pour l'ouvert, rouge sombre pour le contredit).
Défis rencontrés
- Contrôle des hallucinations : Correction des erreurs initiales d'attribution de dates et de statuts via l'ajout d'assertions automatiques strictes.
- Gestion de la péremption : Traitement des cas où un fichier récent contient des données obsolètes (ex. un plan v3 postérieur à une décision officielle du comité). Le code applique des règles de priorité basées sur l'autorité de la source.
- Fiabilité de l'exécution : Transfert de la logique de validation au code Python pour pallier les erreurs de formatage JSON et les divergences du vérificateur LLM.
- Détection des changements : Implémentation d'une analyse comparative syntaxique et logique en code pour distinguer les propositions récentes des faits passés lors de l'ajout de documents.
- Sécurité : Ajout d'un filtre pour bloquer l'injection d'instructions contenues dans les documents ingérés.
Résultats
- Vérification automatique : 100 % des citations de la mémoire et des réponses sont validées dynamiquement contre le corpus.
- Gestion des pièges du corpus : Distinction stricte entre livraison et validation, proposition et décision, et élimination des doublons de confirmation.
- Transparence du raisonnement : Le chat affiche l'état actuel, l'historique des modifications et les sources écartées.
- Performance : Temps d'analyse d'un document réduit à 36 secondes avec détection exacte des modifications.
- Validation déterministe : 4 suites de tests automatisés s'exécutent sans faire appel au LLM.
Enseignements
- Séparation des rôles : Le code doit trancher l'exactitude des faits ; le LLM doit se limiter à la structuration et à la rédaction.
- Approche chronologique : La reconstruction de la séquence temporelle des événements est indispensable pour déterminer l'état présent.
- Couverture par les tests : Chaque incohérence identifiée a été convertie en test automatisé.
Prochaines étapes
- Optimisation du traitement des requêtes synthétiques larges.
- Intégration d'un modèle de vision pour l'extraction automatique du texte des captures d'écran.
- Extension du moteur de règles à d'autres corpus de projets.
- Génération automatique de notes de synthèse exécutives après validation d'un nouveau document.

Log in or sign up for Devpost to join the conversation.