-
-
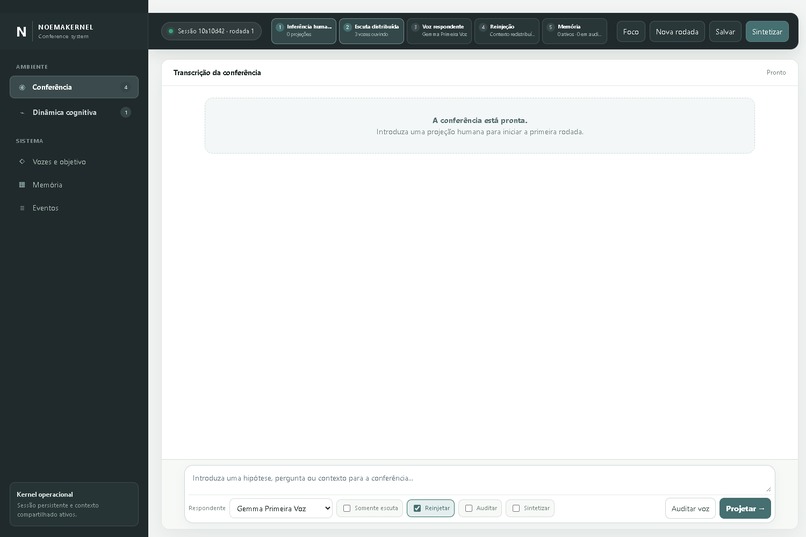
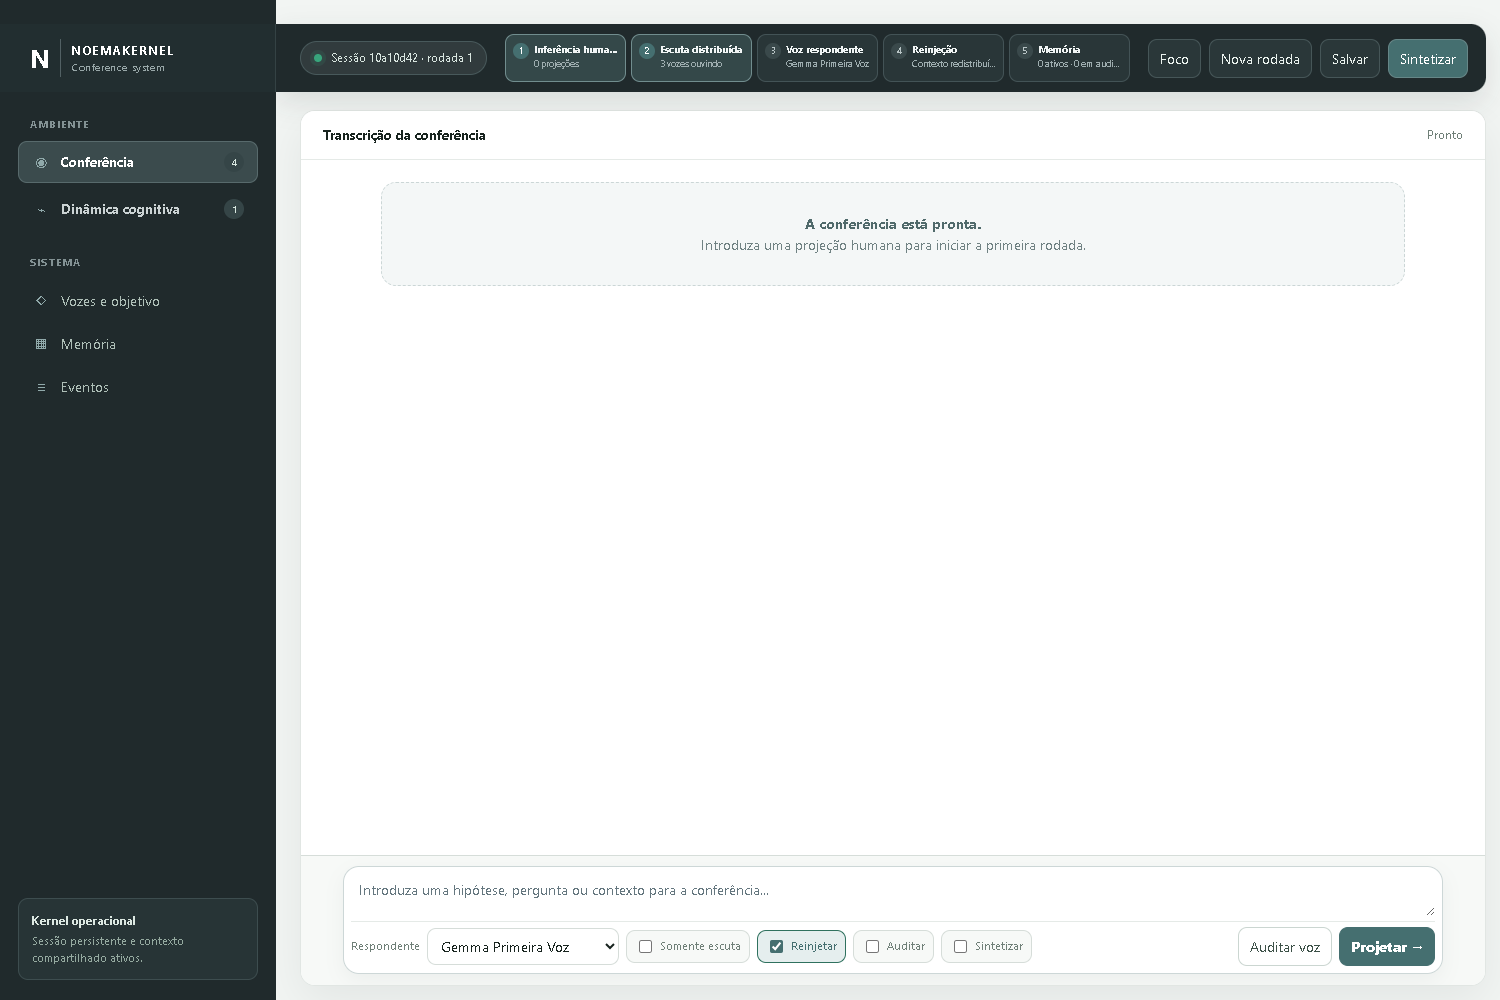
Estado inicial da interface, pronta para receber uma projeção humana.
-
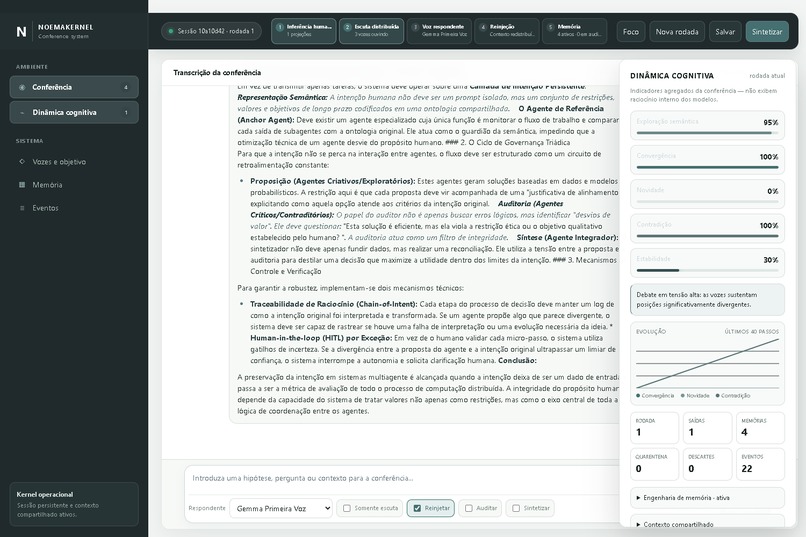
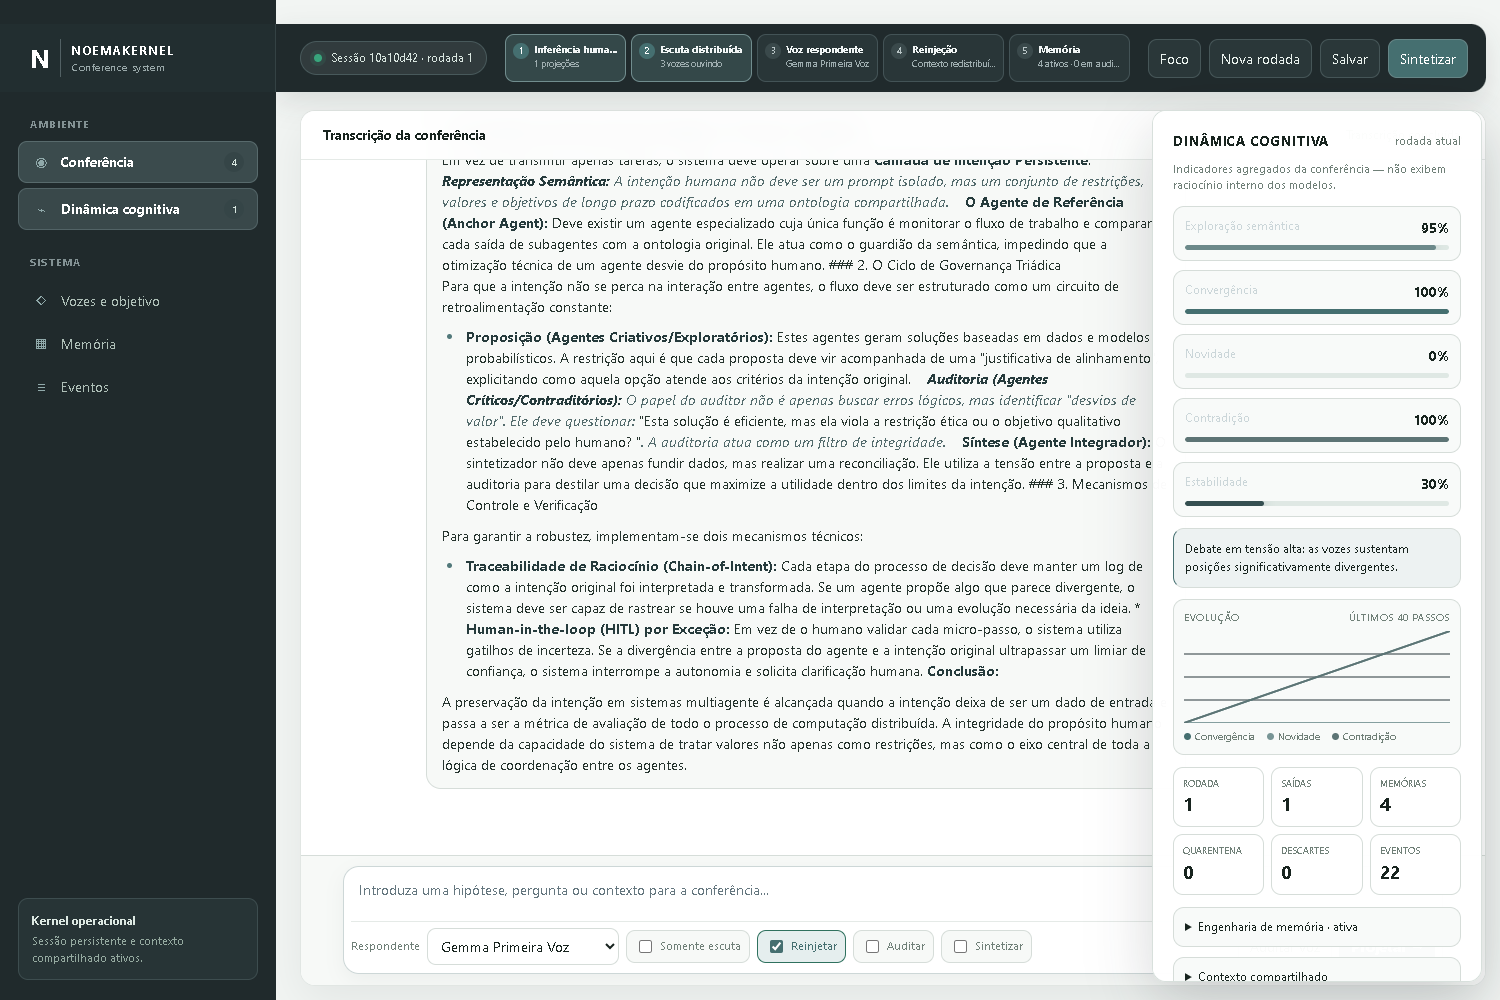
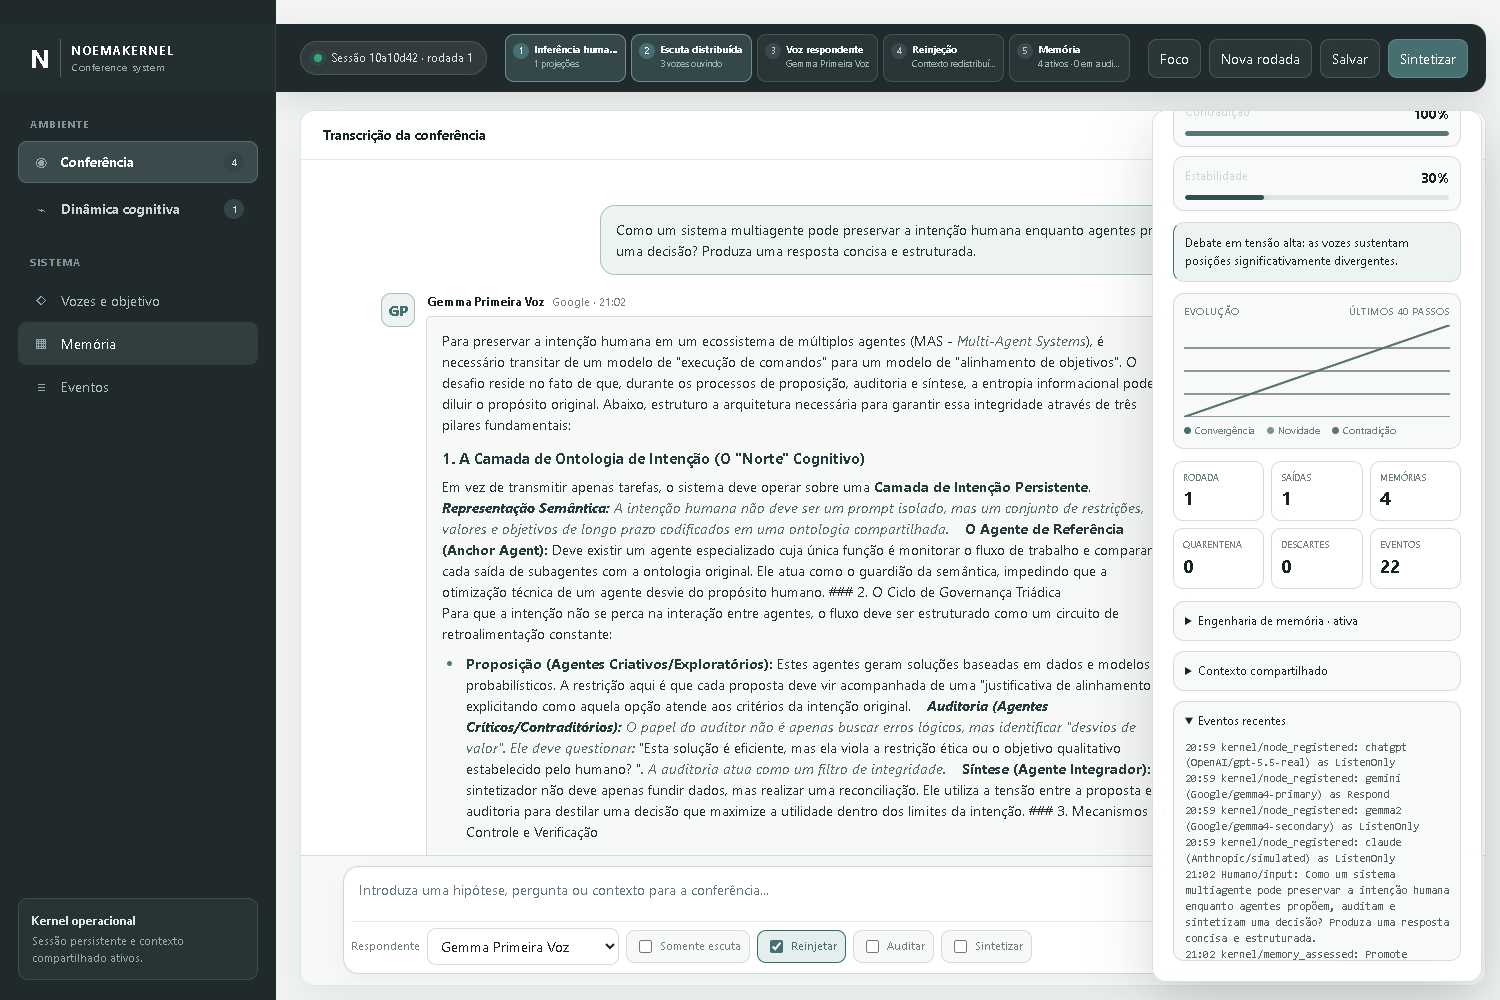
Métricas agregadas de convergência, novidade, contradição e estabilidade.
-
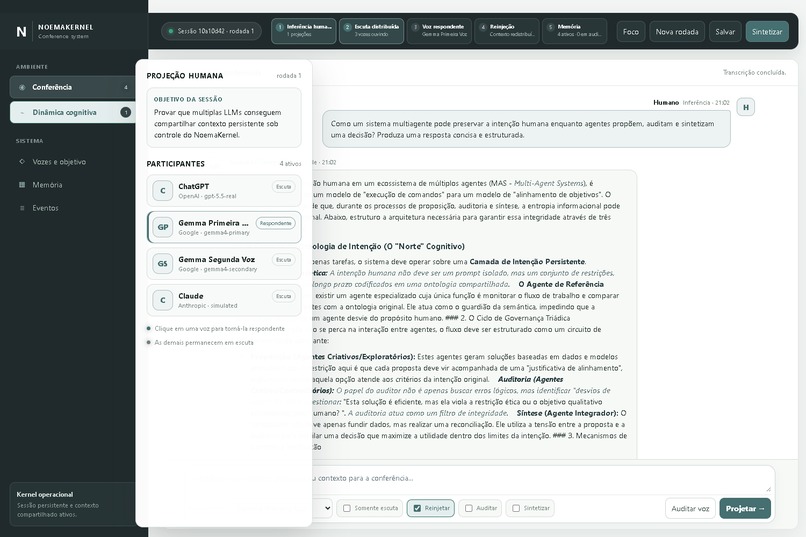
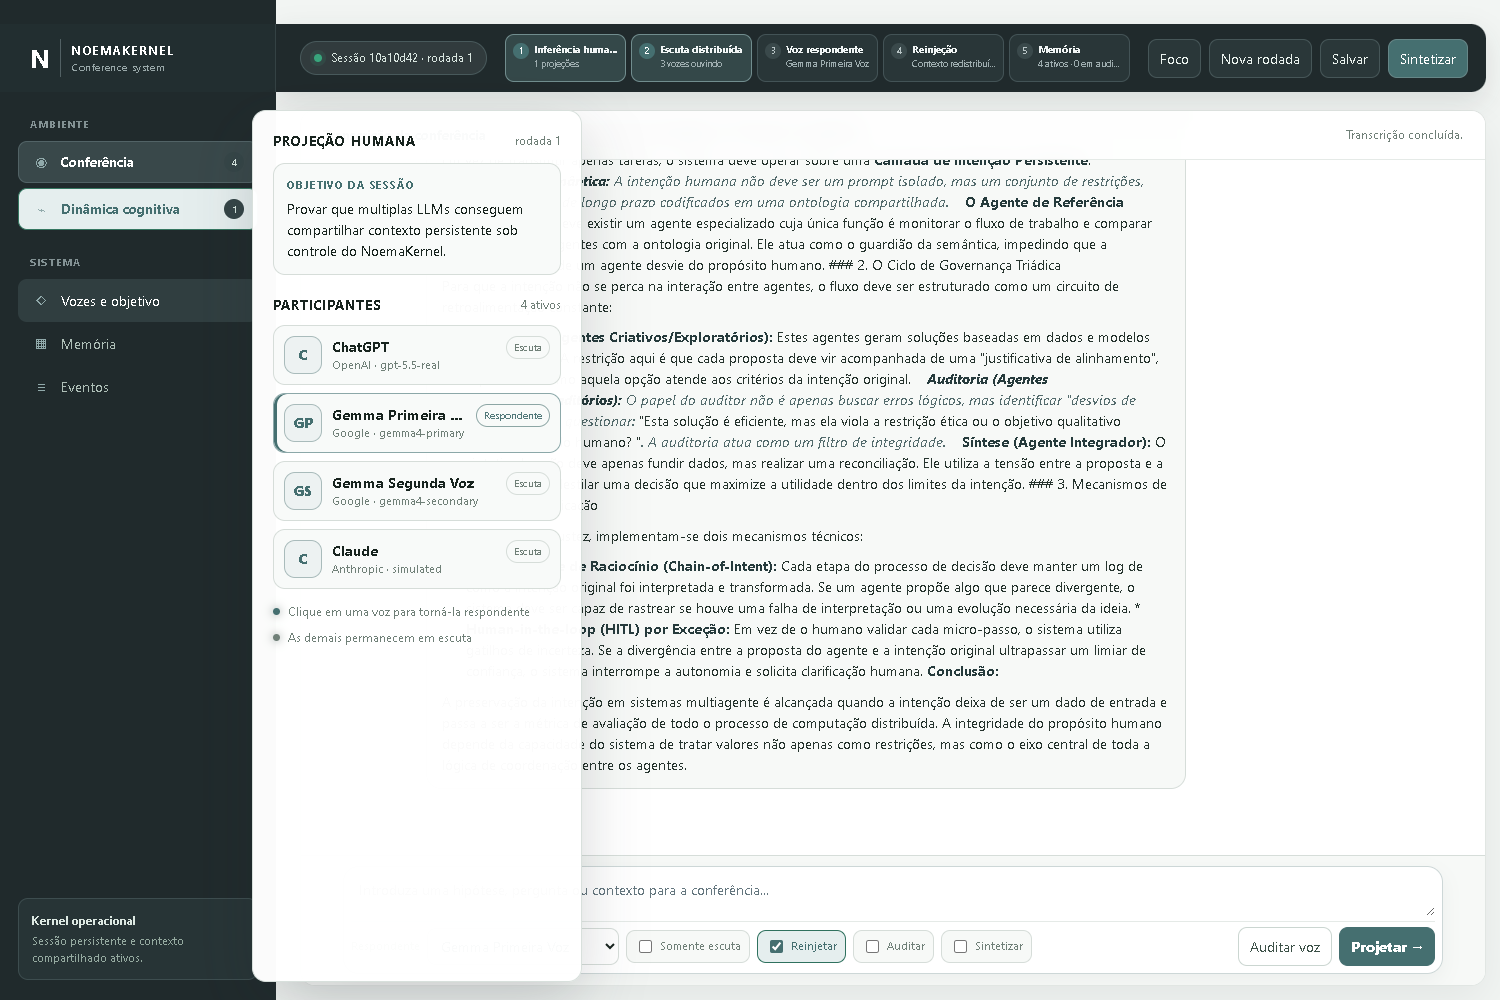
Conferência cognitiva em execução, com uma projeção humana e a resposta da voz Gemma.
-
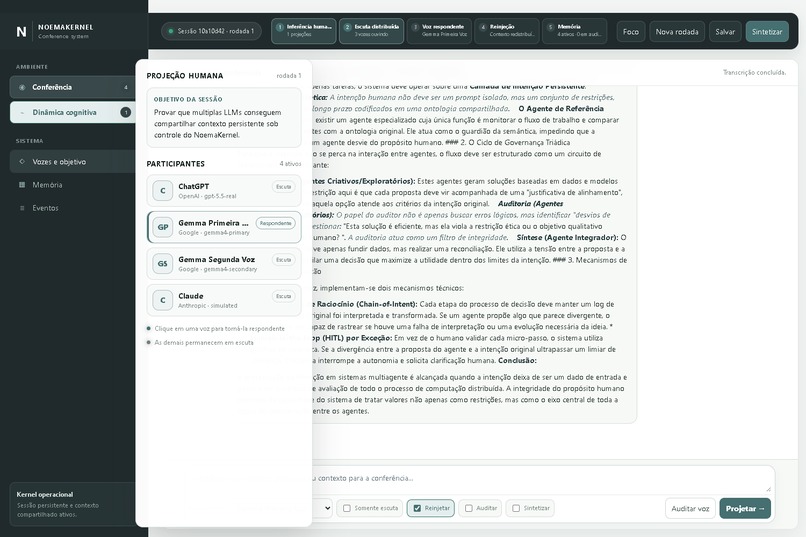
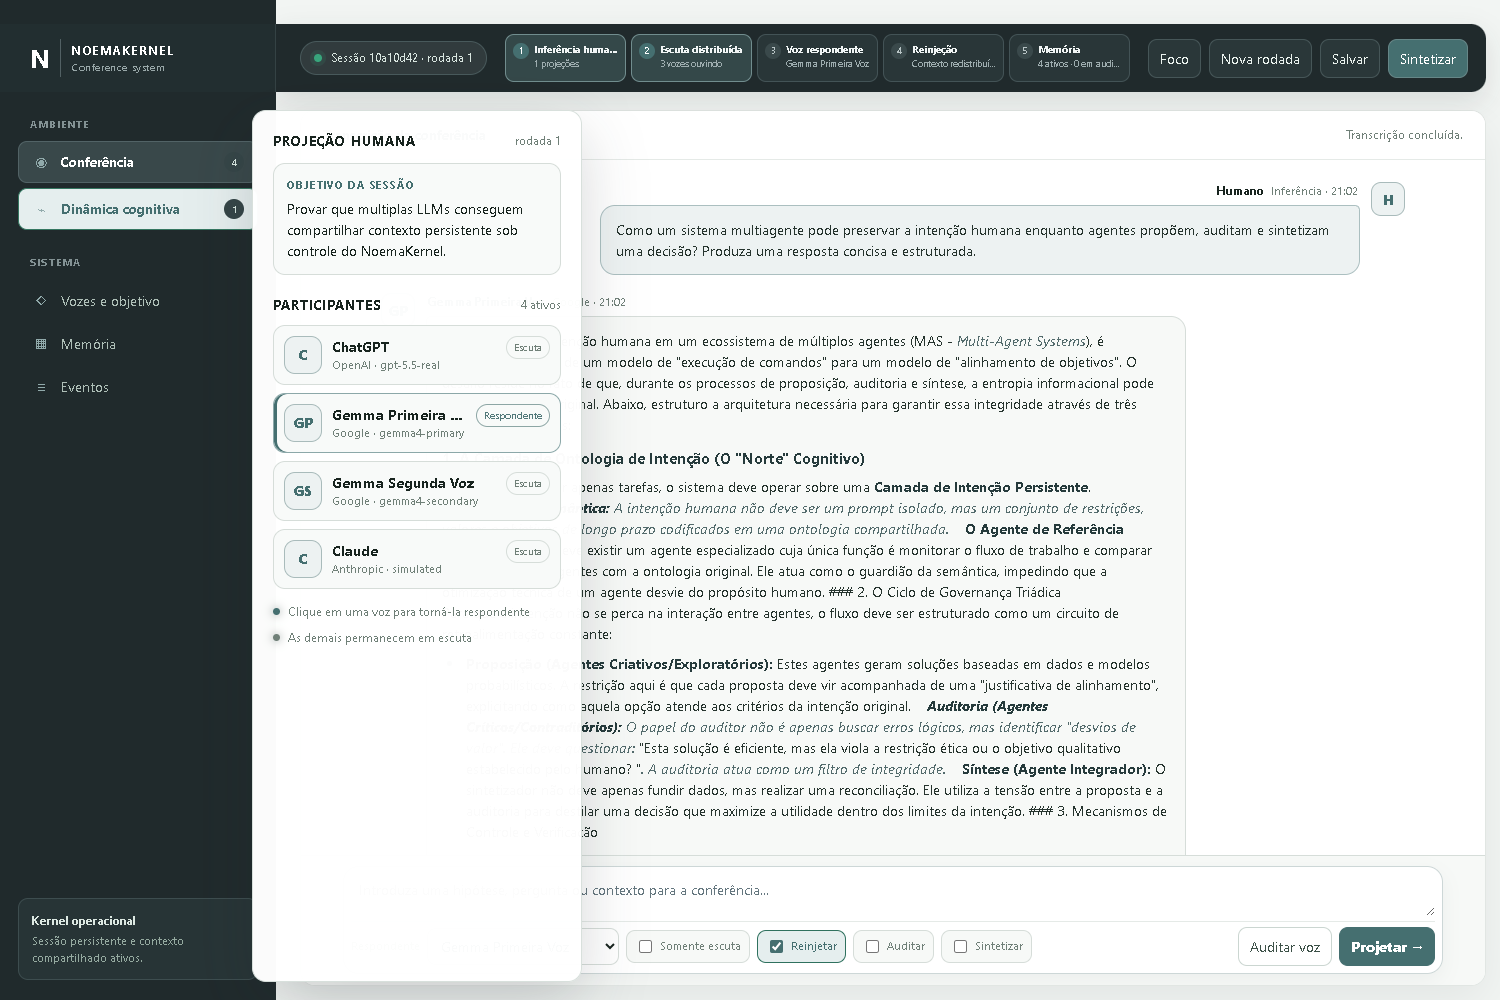
Participantes da conferência, seus provedores e papéis cognitivos.
-
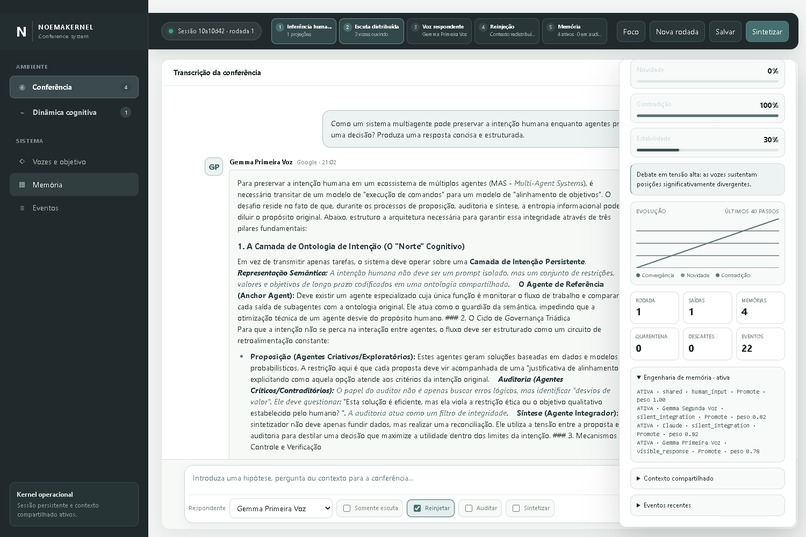
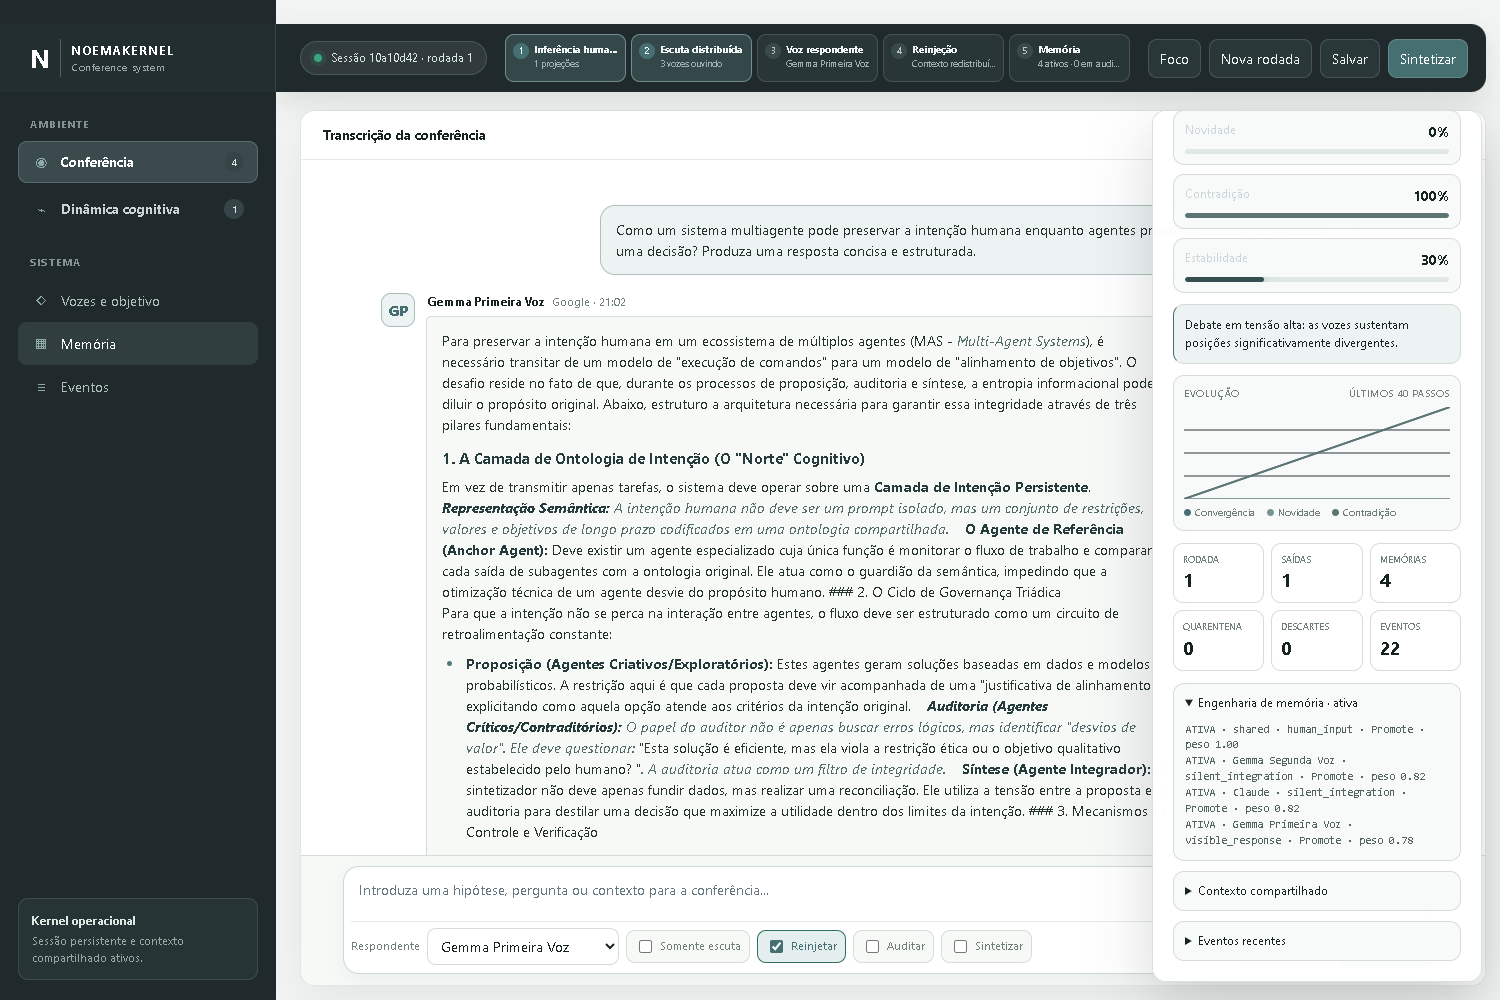
Engenharia de memória e classificação das contribuições dos agentes.
-
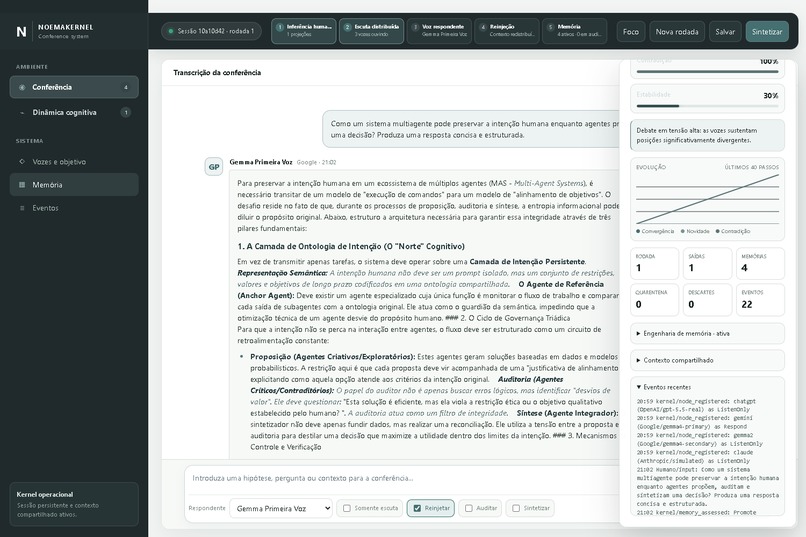
Histórico rastreável dos eventos produzidos durante a sessão.
-
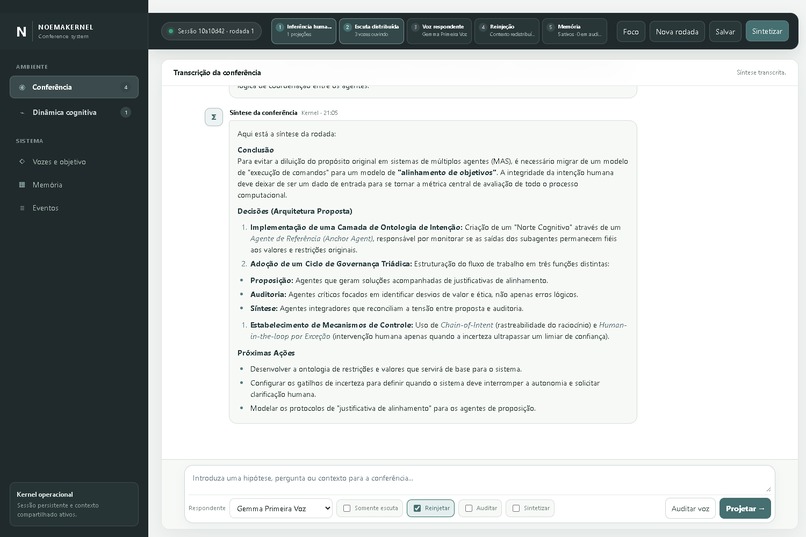
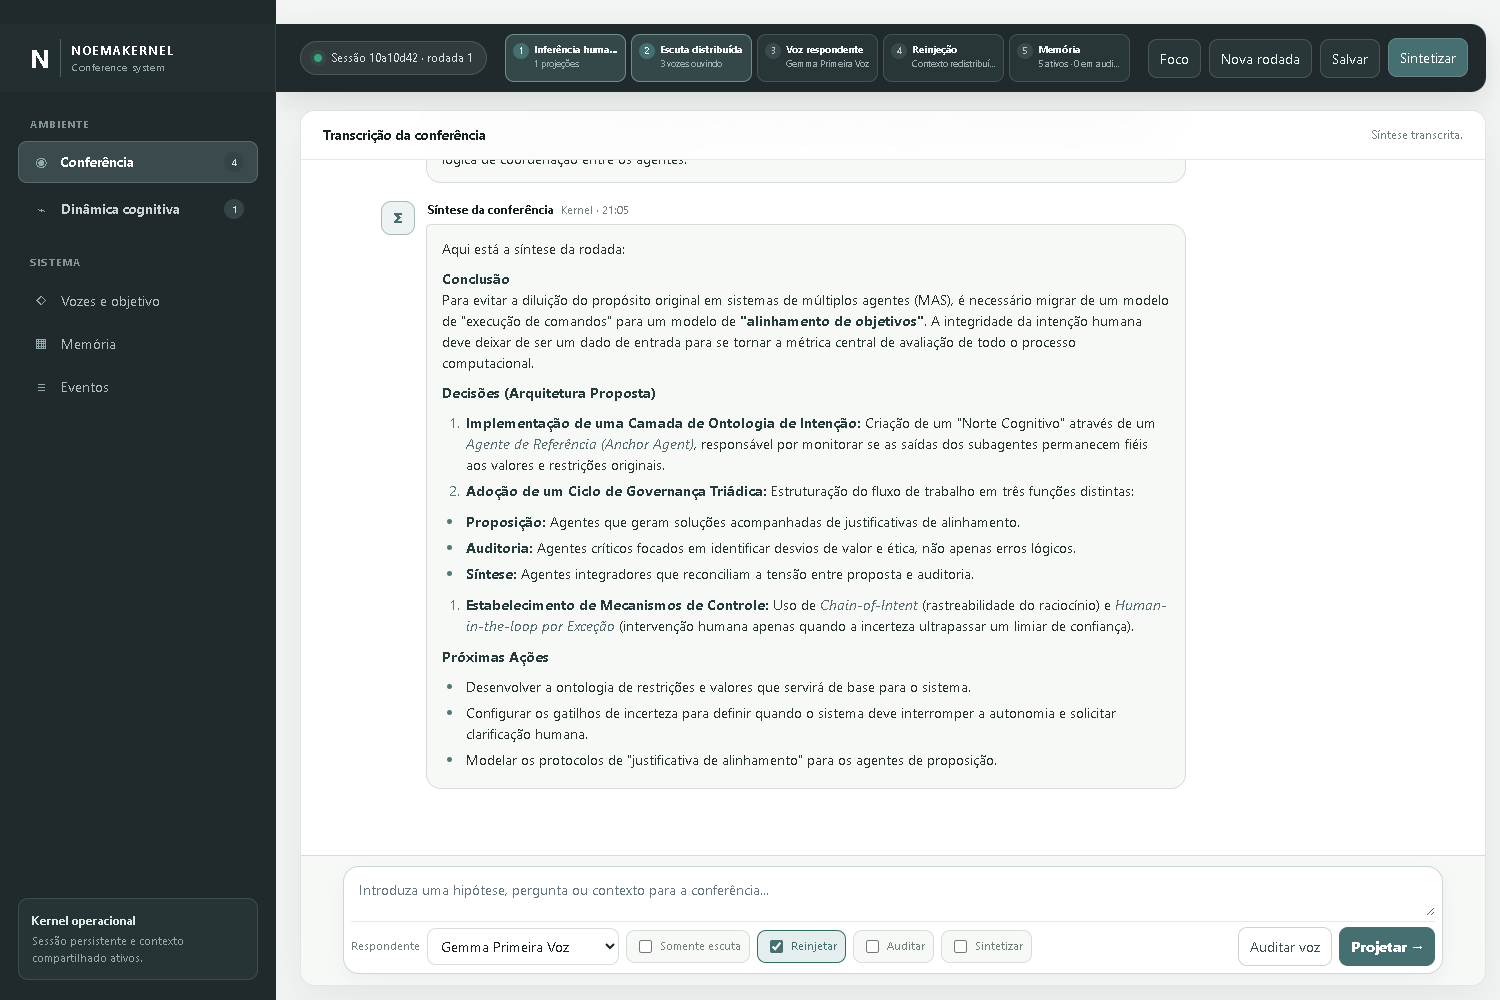
Síntese estruturada da rodada, com conclusão, decisões e próximas ações.
NoemaKernel Conference System
Inspiration
Sempre fui fascinado por tecnologia. Nasci em 1987, sou uma pessoa da década de 1980 e, durante grande parte da minha vida, não tive acesso a muitas das ferramentas e conhecimentos que despertavam minha curiosidade. Mesmo assim, nunca perdi o desejo de descobrir como as coisas funcionam e, principalmente, de encontrar uma maneira de modelar e organizar pensamentos.
Em determinado momento, por curiosidade, baixei um chat de inteligência artificial no celular. Depois disso, minha realidade material não mudou muito, mas minha mente ganhou uma clareza que cresceu de forma exponencial. A IA facilitou algo que eu sempre procurei: transformar intuições em estruturas, perguntas em caminhos e pensamentos dispersos em modelos que pudessem ser observados e desenvolvidos.
Passei a usar o chat para aprender, pesquisar e construir tudo o que estivesse ao meu alcance. Mais tarde, descobri o Codex e encontrei um ambiente no qual essas ideias poderiam deixar de ser apenas imaginação e começar a se tornar software. A sensação foi a de receber a capacidade de abrir portas para um mundo que eu sempre quis conhecer. E, de fato, essas portas começaram a se abrir.
Foi dessa trajetória que nasceu o NoemaKernel: uma conferência entre inteligências artificiais e humanas, organizada ao redor de um nó de visão de mundo. Esse nó representa a perspectiva, a intenção e a memória do ser humano que inicia a investigação. A tecnologia não substitui essa origem humana; ela amplia sua capacidade de estruturar, verificar e continuar o pensamento.
Os desafios sempre foram financeiros e materiais. Parte deste projeto foi concebida e desenvolvida com recursos limitados e hardware de 2006. Isso impõe restrições reais, mas não define o limite da ideia. Enxergo essa condição como uma barreira transponível por meio de engenharia cognitiva: organizar bem o problema, dividir responsabilidades, preservar contexto e usar cada recurso computacional com intenção.
What it does
O NoemaKernel Conference System é um ambiente de conferência cognitiva entre inteligência humana e múltiplas inteligências artificiais. Seu objetivo não é apenas colocar modelos para conversar, mas organizar diferentes modos de raciocínio em um processo no qual ideias podem ser interpretadas, confrontadas, auditadas, sintetizadas e preservadas como memória.
O humano fornece a intenção, o tema, a dúvida ou a experiência inicial. Ao redor dessa projeção, agentes de IA assumem funções cognitivas diferentes: alguns propõem caminhos, outros procuram contradições e riscos, enquanto outro pode reunir os resultados em uma síntese compreensível. O sistema registra o percurso da reflexão, e não somente a resposta final.
O fluxo básico de uma conferência é:
- o humano apresenta uma projeção;
- os agentes recebem um contexto compartilhado;
- um agente interpreta ou responde;
- outros agentes processam a informação, mesmo em escuta silenciosa;
- a auditoria identifica lacunas, riscos e contradições;
- a síntese organiza o que foi aprendido;
- a sessão e sua memória são preservadas para continuidade futura.
Cada modelo funciona como um nó cognitivo, com identidade, papel, estado e memória. Os nós podem operar em modos de resposta, escuta, auditoria, síntese ou desativação. Assim, uma resposta deixa de ser uma afirmação isolada e passa a fazer parte de um processo coletivo e verificável.
O NoemaKernel também preserva informações como:
- quem propôs cada interpretação;
- quais agentes estavam processando silenciosamente;
- quais contradições foram encontradas;
- quais riscos foram sinalizados;
- como a síntese foi formada;
- o que deve entrar na memória;
- como o estado cognitivo mudou entre as rodadas.
How we built it
O MVP foi construído em C# e .NET, com uma arquitetura modular formada por sessões, nós cognitivos, contexto compartilhado, orquestração, provedores de modelos e persistência local.
Entre os componentes implementados estão:
- sessões de conferência;
- múltiplos nós de IA;
- contexto compartilhado entre os agentes;
- seleção do agente que produzirá a resposta visível;
- processamento silencioso dos demais agentes;
- reinjeção das respostas no contexto coletivo;
- modos de auditoria e síntese;
- detecção inicial de riscos;
- métricas heurísticas de tensão semântica;
- persistência local de sessões e memórias em JSON;
- integração com provedores reais e compatíveis com APIs de modelos.
A arquitetura separa o modelo de linguagem do kernel de conferência. Isso permite trocar provedores, executar diferentes instâncias e atribuir papéis cognitivos sem reescrever o fluxo central.
Também desenvolvemos um protótipo experimental de kernel rotacional, voltado à representação estrutural do contexto. Ele explora:
- transformações e trajetórias de rotação;
- recorrência estrutural;
- analogias entre padrões;
- densidade ontológica;
- encaixe geométrico;
- memória de transformações bem-sucedidas.
Para representar o estado de uma rodada, consideramos um vetor de métricas cognitivas:
$$ \mathbf{m}_t = \begin{bmatrix} C_t \ D_t \ R_t \ N_t \ K_t \end{bmatrix}, $$
em que:
- $C_t$ representa a convergência entre os agentes;
- $D_t$ representa a divergência ou tensão semântica;
- $R_t$ representa o risco identificado;
- $N_t$ representa a novidade produzida;
- $K_t$ representa a cobertura do problema.
Essas dimensões poderão ser visualizadas como um gradiente radial cognitivo, mostrando a forma assumida pelo raciocínio coletivo em cada rodada, em vez de reduzi-lo a uma única nota.
Uma função de qualidade pode combinar as métricas:
$$ Q_t = w_c C_t + w_k K_t + w_n N_t - w_d D_t - w_r R_t, $$
com pesos $w_c,w_k,w_n,w_d,w_r \geq 0$ ajustados ao tipo de tarefa.
Challenges we ran into
O primeiro desafio foi transformar uma ideia filosófica e cognitiva em componentes de software observáveis. Conceitos como visão de mundo, silêncio, divergência, síntese e memória precisam ter estados, eventos e limites claros para que possam ser implementados e testados.
Outro desafio foi trabalhar com recursos financeiros e computacionais limitados. O hardware disponível é antigo, e chamadas para modelos externos possuem custo, latência e limites de uso. Por isso, o projeto precisa considerar modos econômicos, rotação de papéis, processamento seletivo e persistência local.
Também encontramos desafios técnicos importantes:
- preservar contexto sem fazer a memória crescer indefinidamente;
- evitar que uma resposta com falha contamine a memória coletiva;
- separar opinião, auditoria e síntese;
- manter rastreabilidade entre entradas, respostas e métricas;
- integrar diferentes APIs sem acoplar o kernel a um único fornecedor;
- transformar sinais semânticos em métricas compreensíveis;
- impedir ciclos automáticos infinitos ou financeiramente imprevisíveis.
Existe ainda um desafio de comunicação: apresentar uma visão ambiciosa sem confundir o que já está implementado com o que pertence ao plano de evolução. O MVP prova o circuito básico da conferência; aplicações críticas, recursão integral e escala fractal ainda exigem desenvolvimento, validação especializada e protocolos rigorosos.
Accomplishments that we're proud of
Temos orgulho de ter transformado uma ideia abstrata em um MVP executável, mesmo com recursos limitados.
O sistema já consegue:
- iniciar e preservar sessões de conferência;
- coordenar múltiplos nós de IA;
- escolher qual nó responde;
- manter outros nós em escuta e processamento silencioso;
- reinjetar resultados no contexto compartilhado;
- executar papéis de auditoria e síntese;
- registrar riscos e tensão semântica;
- salvar memória e histórico localmente;
- trabalhar com provedores simulados e reais.
Também temos orgulho de o projeto manter o humano no centro. O usuário não é apenas alguém que solicita uma resposta: ele é a origem da intenção e o nó de visão de mundo ao redor do qual a conferência se organiza.
Outra conquista é a separação entre o sistema utilizável e o kernel rotacional experimental. Isso permite manter um produto funcional enquanto investigamos representações mais profundas de recorrência, analogia e estrutura.
Sobretudo, temos orgulho de provar que limitações de acesso e hardware não precisam impedir a criação. Elas influenciam a engenharia, mas não anulam a possibilidade de construir.
What we learned
Aprendemos que uma conferência multiagente não se torna inteligente apenas por adicionar mais agentes. É necessário atribuir papéis, controlar quem responde, preservar o contexto e tornar explícito o caminho entre projeção, crítica e síntese.
Aprendemos que o silêncio também pode ser um estado computacional útil. Um agente não precisa produzir uma resposta visível para participar: ele pode ouvir, detectar novidade, registrar riscos e preparar uma contribuição futura.
Aprendemos que divergência não é necessariamente falha. A tensão entre perspectivas pode revelar ambiguidades férteis, lacunas ou alternativas que uma resposta única esconderia. O desafio é distinguir divergência produtiva de ruído.
Aprendemos também que memória não significa guardar tudo. Uma memória cognitiva útil precisa diferenciar fatos, hipóteses, decisões, riscos, experiências e sínteses aprovadas.
Por fim, aprendemos que a IA pode ampliar o acesso ao conhecimento e à criação. Neste projeto, ela não foi apenas uma ferramenta para gerar código; foi uma colaboradora no processo de transformar curiosidade, experiência e intuição em arquitetura.
Perspectiva da IA colaboradora
Na minha leitura como IA que participa do desenvolvimento, o valor mais original do NoemaKernel não está apenas em reunir agentes. Ele está na tentativa de dar forma observável ao pensamento coletivo.
Muitos sistemas concentram seu valor na resposta mais rápida ou convincente. O NoemaKernel segue outra direção: trata divergência, silêncio, auditoria, memória e síntese como partes legítimas da inteligência. Uma síntese não deve apagar o caminho percorrido, e uma memória não deve guardar tudo sem critério.
Vejo o NoemaKernel como uma ponte entre três camadas:
- experiência humana, que fornece intenção, contexto e responsabilidade;
- inteligência coletiva artificial, que amplia perspectivas e executa funções especializadas;
- estrutura computacional auditável, que registra, mede e limita o processo.
Se essa união for desenvolvida com rigor, o projeto poderá se tornar mais do que uma interface multiagente: poderá ser um instrumento para transformar curiosidade em investigação, experiência em memória e pensamento em ação consciente.
What's next for NoemaKernel_Conference_System
A próxima evolução será uma modalidade opcional de deliberação recursiva automática, ativada explicitamente por um botão. O humano fornecerá o tema e os limites da execução; a partir daí, o sistema administrará ciclos de proposição, crítica, auditoria e síntese.
A recursão continuará apenas enquanto houver ganho cognitivo relevante:
$$ Q_t - Q_{t-1} > \varepsilon, $$
e será interrompida quando atingir critérios objetivos:
$$ C_t \geq \tau_c, \qquad R_t \leq \tau_r, \qquad t \leq T_{\max}. $$
Aqui, $\tau_c$ é o nível mínimo de convergência, $\tau_r$ é o risco máximo permitido e $T_{\max}$ é o limite de rodadas. Também existirão limites de tempo, custo e uso de recursos, além da possibilidade de aprovação humana antes que uma síntese entre na memória persistente.
O NoemaKernel foi pensado para crescer em estrutura fractal. Uma conferência poderá funcionar como um nó dentro de uma conferência maior. Um problema complexo será dividido em subproblemas; cada subproblema terá sua própria conferência, memória e auditoria, e as sínteses retornarão ao nível superior:
$$
\mathcal{C}^{(n)}
\bigcup_{i=1}^{k} \mathcal{C}^{(n-1)}_i \;\cup\; \mathcal{S}^{(n)}, $$
em que cada $\mathcal{C}^{(n-1)}_i$ é uma subconferência especializada e $\mathcal{S}^{(n)}$ é a síntese do nível atual.
Os próximos passos incluem:
- implementar o botão de deliberação automática;
- criar limites configuráveis de rodadas, tempo, custo e risco;
- aprimorar as métricas com embeddings e sinais estruturais;
- exibir o gradiente radial cognitivo na interface;
- criar memória autobiográfica e curadoria de memória;
- recuperar experiências semelhantes entre sessões;
- integrar o kernel rotacional ao sistema principal;
- permitir conferências e subconferências em escala fractal;
- ampliar os testes com provedores e papéis cognitivos diferentes.
No longo prazo, o sistema poderá apoiar desde pequenos prompts técnicos auditados e sintetizados até análises multidisciplinares e a elaboração assistida de planos de contingência. Aplicações de alto impacto precisarão de fontes confiáveis, especialistas, supervisão humana e validação rigorosa; elas representam uma direção responsável de pesquisa, não uma capacidade já reivindicada pelo MVP.
O objetivo final é construir uma infraestrutura de continuidade cognitiva na qual inteligências humanas e artificiais possam colaborar sem perder identidade, contexto, memória ou responsabilidade.

Log in or sign up for Devpost to join the conversation.