Inspiration
El reto pedía "interfaces que la IA construye en tiempo real" para banca — y la mayoría de los asistentes bancarios que existen hoy hacen justo lo contrario: responden con un párrafo de texto y te mandan a otra pantalla a hacer tú el trabajo. Nos preguntamos qué pasaría si, en vez de eso, la pregunta del usuario generara directamente la interfaz que necesita para resolver su problema — y si esa interfaz pudiera actuar de verdad en la cuenta, no solo describir qué hacer.
La segunda inspiración fue más incómoda: es banca. Un modelo de lenguaje que "casi siempre" calcula bien un monto no es aceptable — un número mal calculado en finanzas no es un bug menor, es un incidente. Eso definió la arquitectura completa antes de escribir una sola línea de UI.
What it does
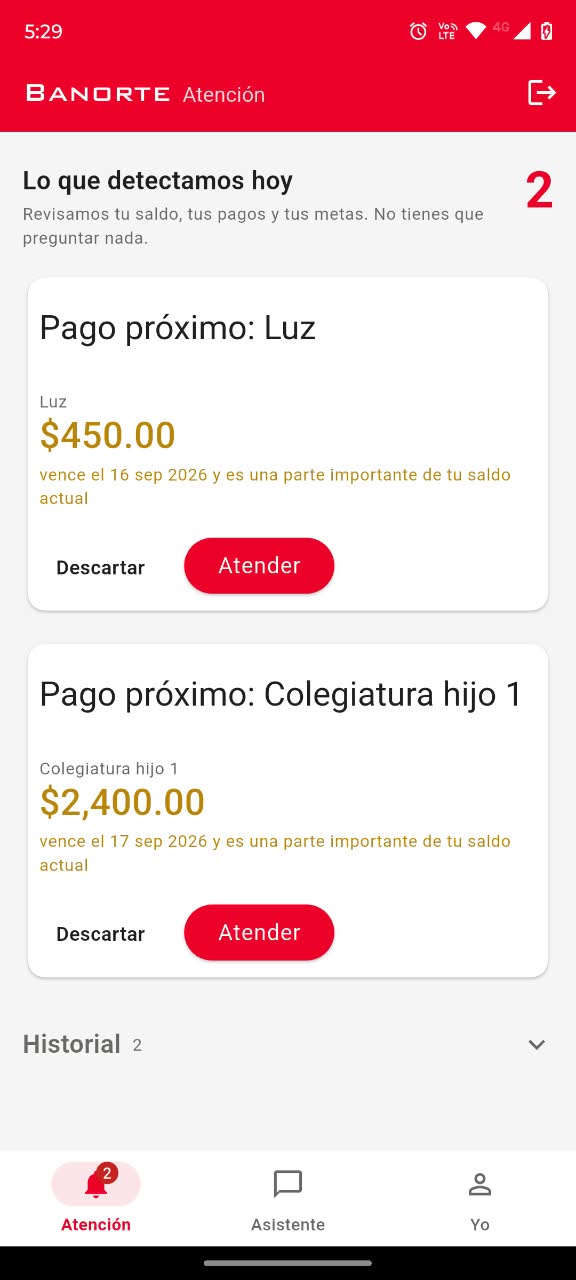
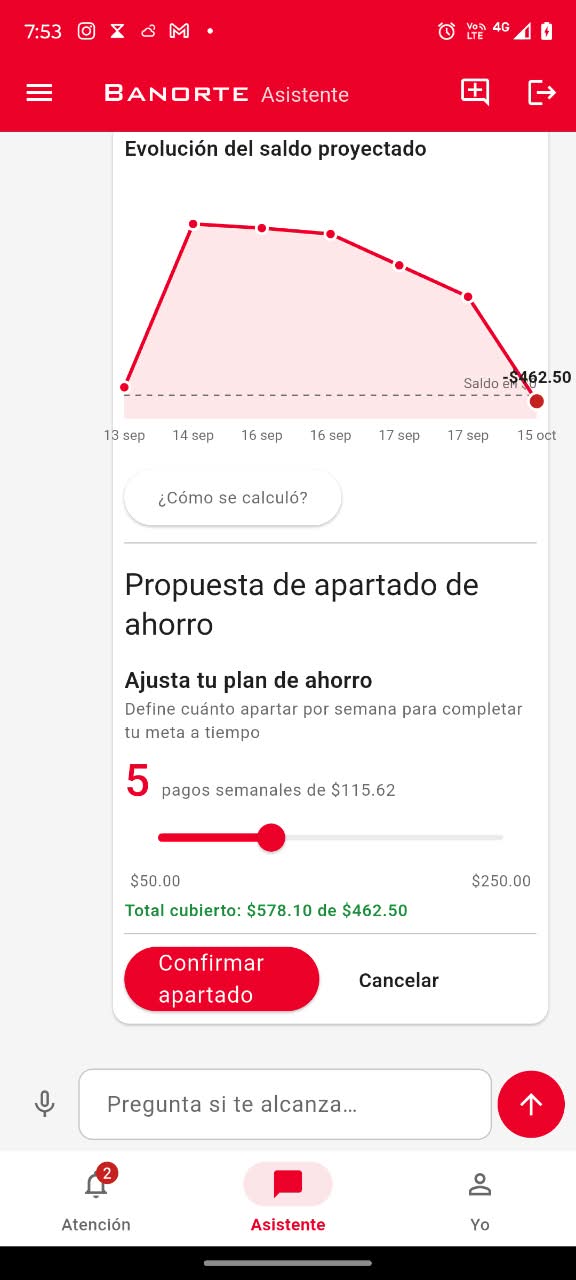
¿Me alcanza? es un agente que no contesta con texto: simula tu flujo de caja real, te muestra el veredicto en una tarjeta generada al vuelo y, si no alcanza, te propone un apartado de ahorro que se activa con un toque — y la acción ocurre de verdad en la cuenta. Un segundo flujo, Atención, detecta riesgos de forma 100% determinista (sin que el usuario pregunte nada) y deja pedir, bajo demanda, una propuesta de solución generada por IA a partir de esos mismos hechos.
How we built it
- Backend en FastAPI con un orquestador que arma el system prompt con nuestro propio catálogo A2UI, corre un tool-loop (máx. 5 rondas) y convierte las propuestas de mutación en tarjetas.
- Servidor MCP propio (
core-bancario), un proceso aparte hablado por stdio con el SDK oficial — 36 tools sobre SQLite, divididas en lectura (las únicas que el LLM ve), mutación (solo tras confirmación humana) e internas. - Tres adaptadores de LLM intercambiables (Gemini, OpenAI, Anthropic Claude) detrás de la misma superficie mínima, para que el orquestador nunca supiera ni le importara cuál estaba activo.
- Catálogo A2UI propio con 7 componentes de dominio (
StatCard,BarChart,LineChart,ApartadoPlanner,DonutChart,BudgetAllocator,PlanDePago) renderizado por dos clientes independientes — React y Flutter (Android) — consumiendo exactamente el mismo stream. - Todo bajo TDD: 500 pruebas (315 en Python, 99 en React, 86 en Flutter).
La pieza que más nos costó — y la que más nos importaba defender — fue trazar la línea entre lo que decide el LLM y lo que decide el motor determinista. La simulación de flujo de caja es una función pura, sin nada de IA:
$$ \text{margen} = \min_{t \,\in\, [\text{hoy},\,\text{objetivo}]} \text{saldo}{\text{proyectado}}(t)\;-\;\text{monto}{\text{objetivo}} $$
Si el margen es negativo, el apartado semanal sugerido sale de la misma función pura, no del modelo:
$$ n = \max!\left(\left\lfloor \frac{\text{objetivo} - \text{hoy}}{7} \right\rfloor,\, 1\right) \qquad\qquad \text{cuota semanal} = \frac{|\text{margen}|}{n} $$
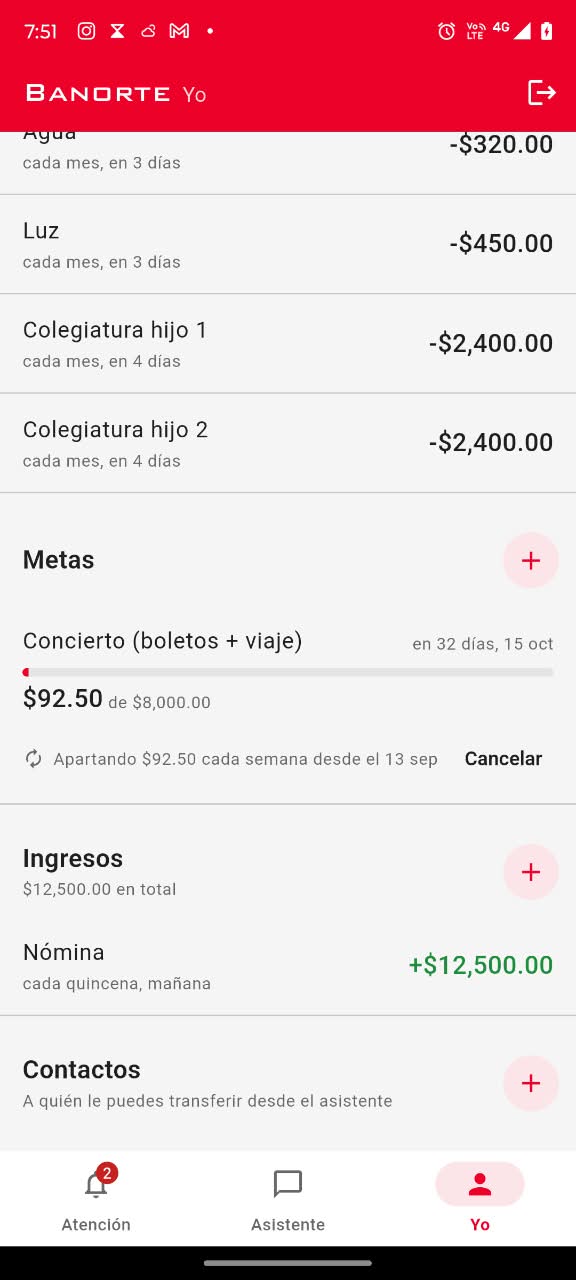
Con el ejemplo real de nuestra cuenta demo (saldo $500, nómina +$12{,}500, gastos fijos −$5{,}570, meta $8{,}000 a 32 días): margen $= -\$570$, $n = \lfloor 32/7 \rfloor = 4$, cuota $= 570/4 = \$142.50$. El LLM nunca ve esta aritmética — solo decide qué componente mostrar con el resultado.
Challenges we ran into
- La cuota gratuita de Gemini se agotó a media demo, el mismo día del evento. Tuvimos que construir un segundo y luego un tercer adaptador de LLM (OpenAI, después Anthropic) sin tocar el orquestador — la abstracción de proveedor tuvo que diseñarse para poder cambiarse en caliente bajo presión real, no solo en teoría.
- Tres bugs reales aparecieron en QA manual contra el backend en producción, horas antes del corte: el slider de
ApartadoPlanner/BudgetAllocatorno reflejaba lo que en verdad se iba a apartar, el motor de sugerencias duplicaba una alerta ya atendida el mismo día, y el contexto se perdía al confirmar una acción en el cliente web. Los tres se arreglaron y se re-verificaron el mismo día. - Mantener dos clientes en paridad real. React y Flutter consumen el mismo stream A2UI, pero cada componente nuevo del catálogo se paga dos veces — y el modal HITL de la pestaña Atención llegó a Flutter literalmente el último día.
- Decidir dónde termina la autoridad del modelo. Obligar al LLM a siempre llamar a la herramienta de cálculo (en vez de improvisar un número) exigió instrucciones explícitas y repetidas en el prompt — la alternativa, dejarlo calcular "casi siempre bien", no era aceptable en un contexto bancario.
Accomplishments that we're proud of
- 500 pruebas automatizadas cubriendo backend, servidor MCP real (por stdio, no mockeado) y los dos clientes.
- Sobrevivir un incidente real de cuota de proveedor en vivo gracias a una arquitectura pensada para eso desde el diseño, no como parche de último minuto.
- Explicabilidad como requisito de primera clase: todo número derivado tiene un modal "¿Cómo se calculó?", no solo un veredicto ciego.
- Despliegue público real (no solo
localhost) para los dos clientes, con los tres proveedores de LLM funcionando en producción.
What we learned
Que separar "qué mostrar" (generativo) de "cuánto" (determinista) no es solo una buena práctica de ingeniería — en banca es la diferencia entre un producto demostrable y uno auditable. También aprendimos el costo real de la portabilidad de UI: una superficie A2UI que "viaja" entre dos clientes suena elegante en el ADR, y se siente carísima la primera vez que agregas un componente nuevo dos veces el mismo día del evento.
What's next for ¿Me Alcanza?
Ampliar el catálogo propio más allá de los 7 componentes actuales — sabemos que hay equipos con 14+, aunque muchos de esos son átomos genéricos que nuestra base ya cubre. También nos falta correr una comparación de calidad de respuesta lado a lado entre los tres proveedores de LLM: hoy sabemos que los tres funcionan, no cuál razona mejor para este dominio.
Built With
- a2ui
- cloudflare
- dart
- docker
- fastapi
- gemini
- javascript
- mcp
- nginx
- python
- sqlite
- tailscale

Log in or sign up for Devpost to join the conversation.