Inspiration
El reto nos lo dijo casi como acertijo: "Given a company's books and only the hint that something is wrong, can an AI agent find the fraud, follow the money, and prove it, without accusing anyone it cannot back up?" En México eso tiene nombre y ley: el Artículo 69-B del Código Fiscal de la Federación, las EFOS (empresas que facturan operaciones simuladas) y el SAT publica una lista pública de más de 11,000 contribuyentes marcados. No queríamos un detector de "algo huele raro" — queríamos un agente que se comportara como un perito real: que investigue, que dude, y que se niegue a firmar un dictamen que no puede sostener con una fila exacta de la base de datos.
What it does
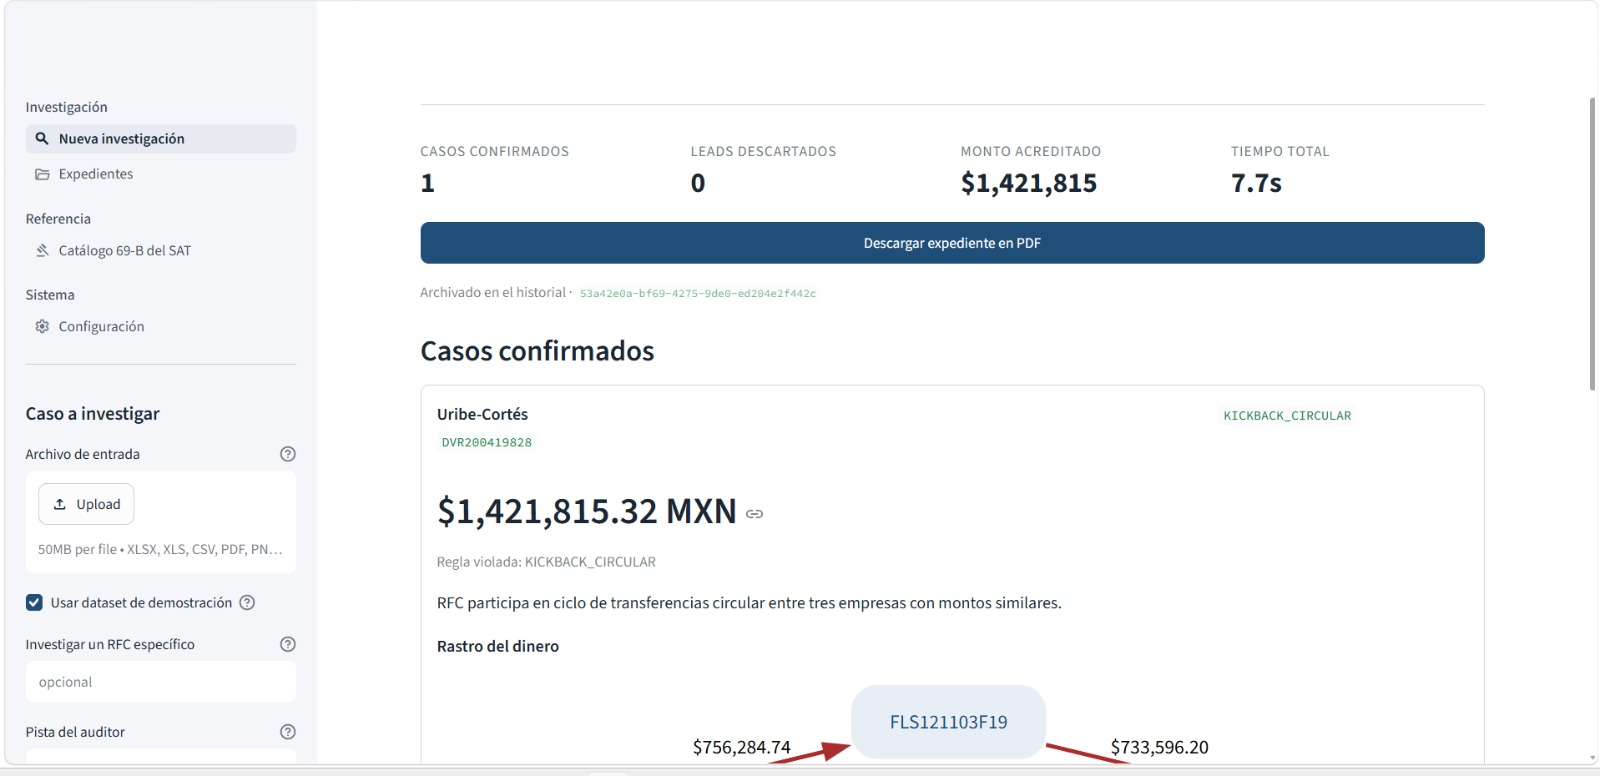
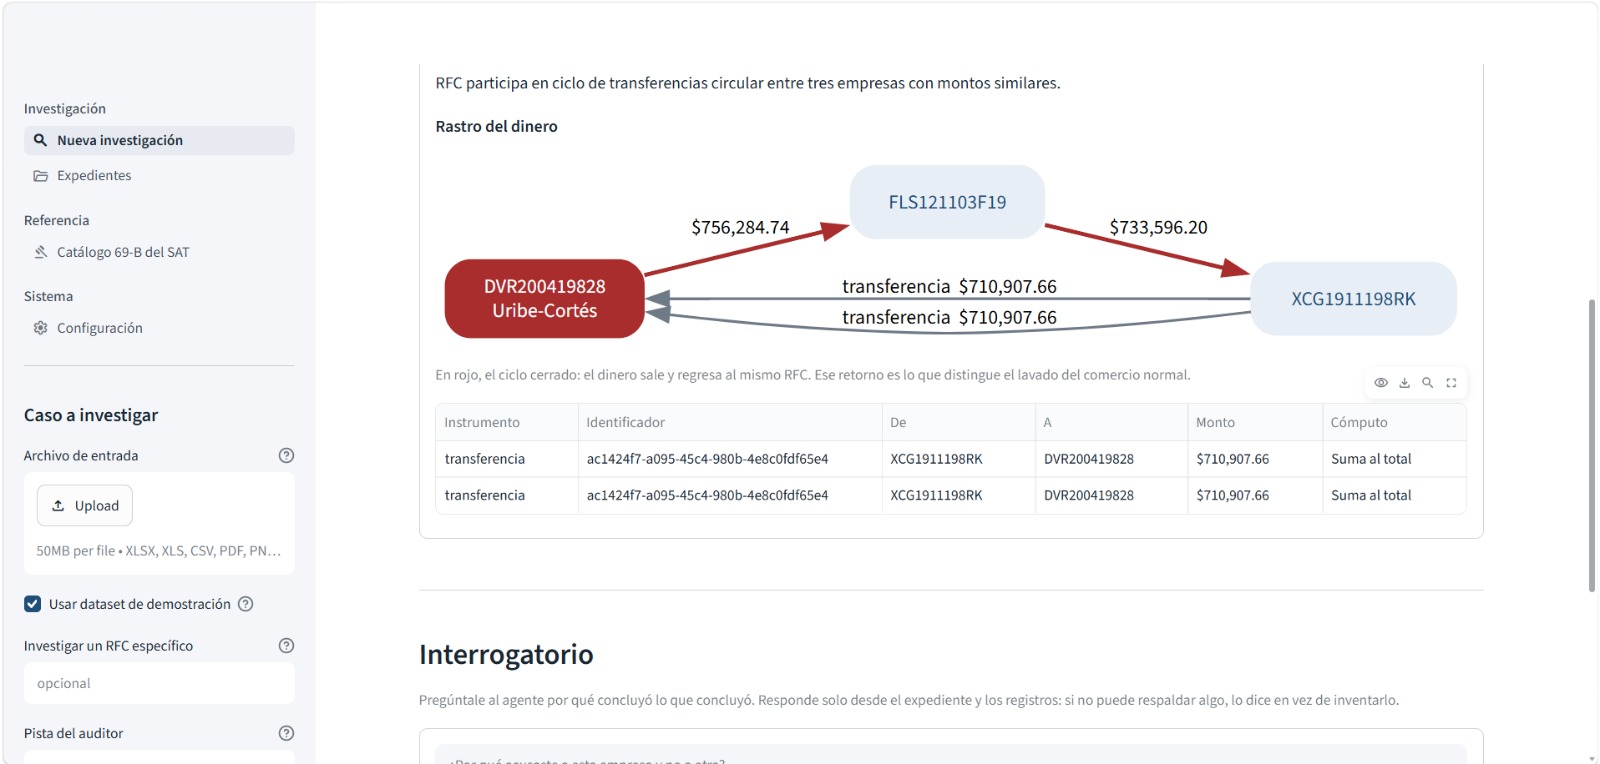
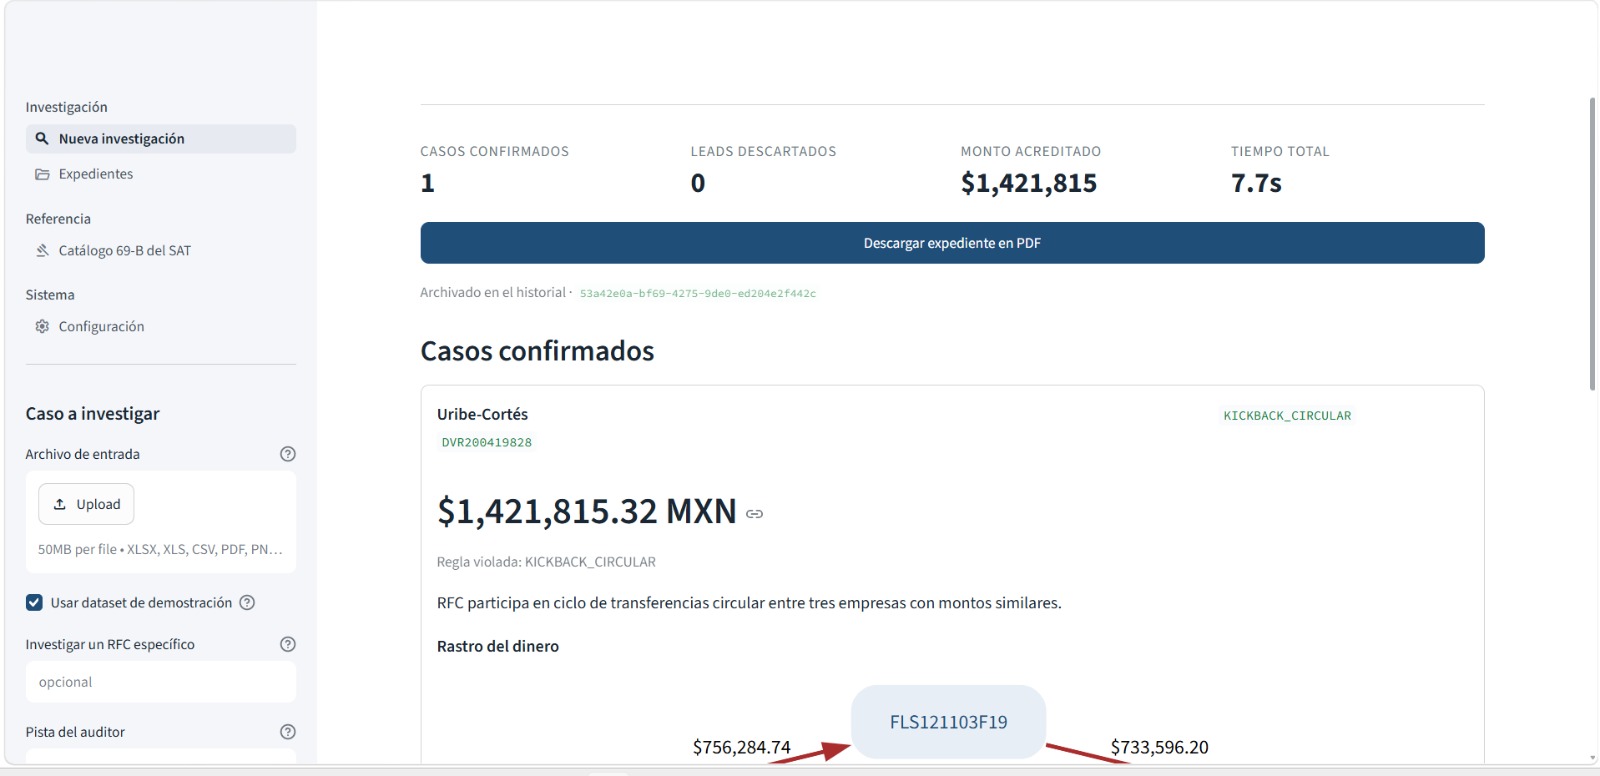
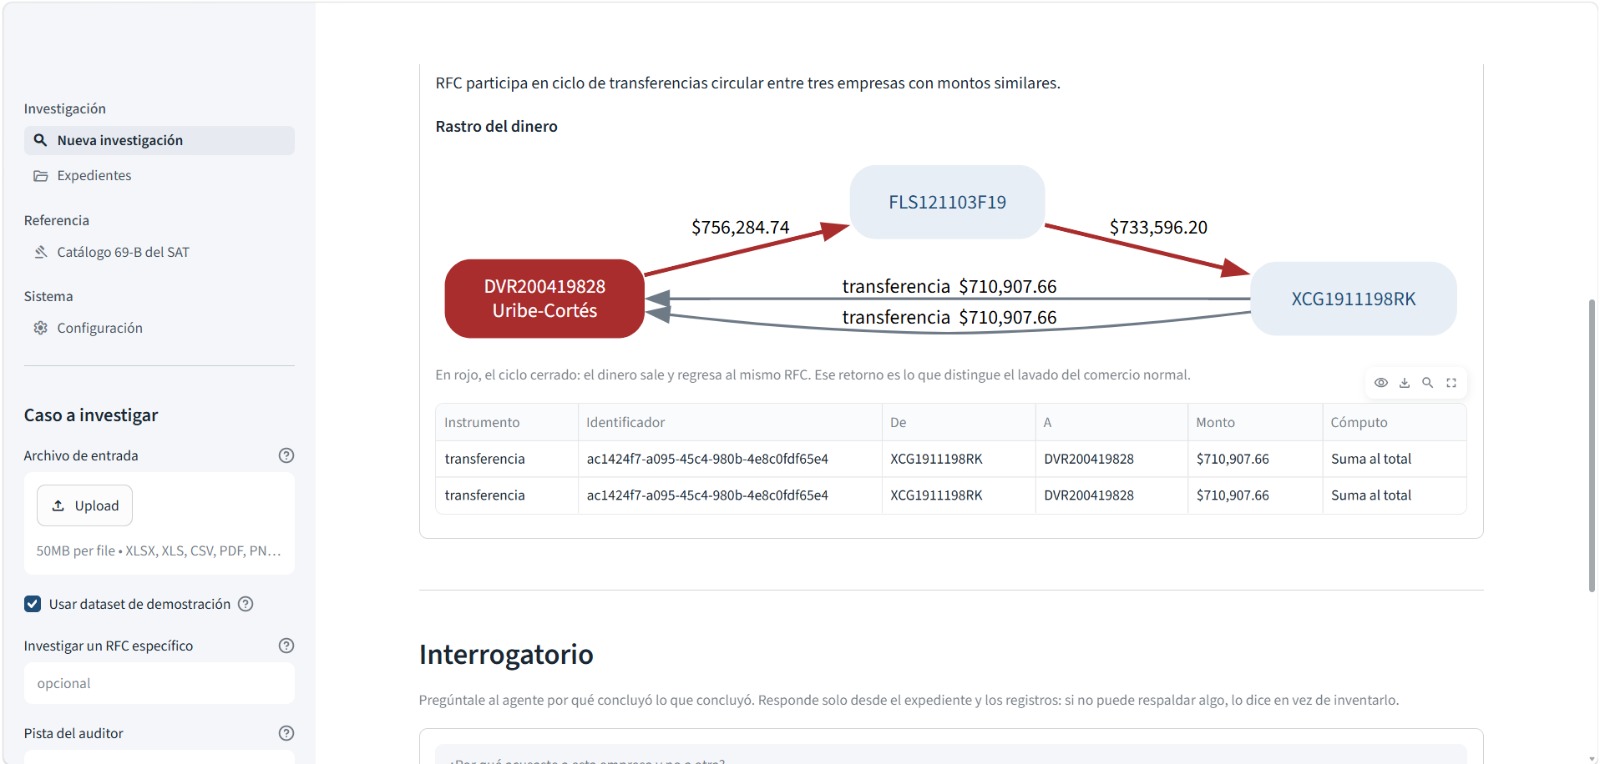
Recibe los libros de una empresa — Excel, CSV, PDF o hasta una foto de un CFDI — y decide por sí mismo a quién vale la pena investigar, escaneando toda la contabilidad con 5 detectores deterministas. Un modelo de lenguaje local (Qwen3.5, corriendo en la propia GPU, sin depender de internet) investiga cada candidato como detective, usando herramientas para consultar la base. Pero el modelo nunca decide si algo es fraude: un verificador de código puro contrasta cada monto y cada identificador contra la base con SQL, y solo confirma cuando hay vínculo probatorio real — un proveedor DEFINITIVO en el listado 69-B del SAT, un ciclo cerrado de transferencias, un depósito sin factura, un concepto que no corresponde al giro de la empresa.
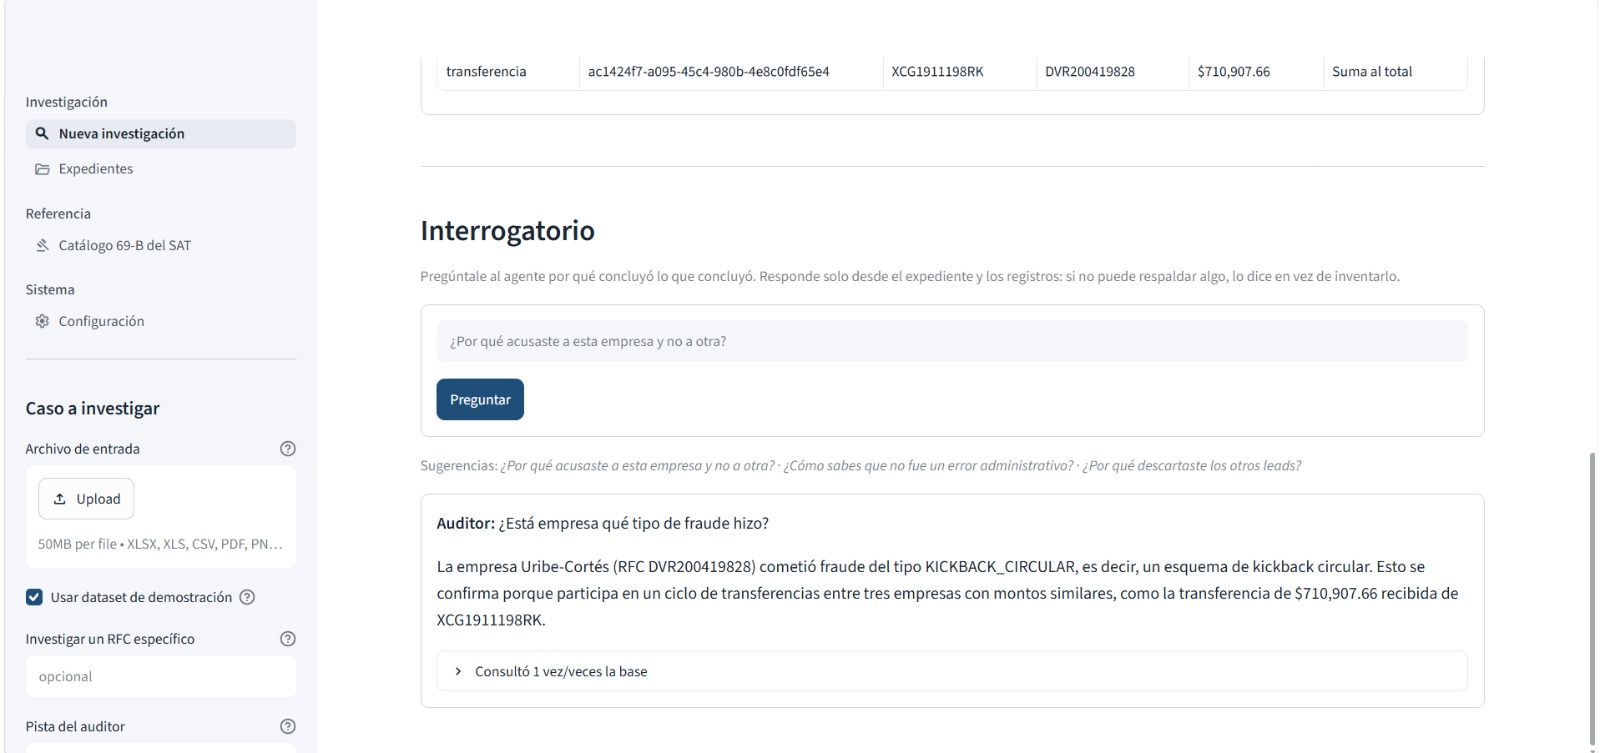
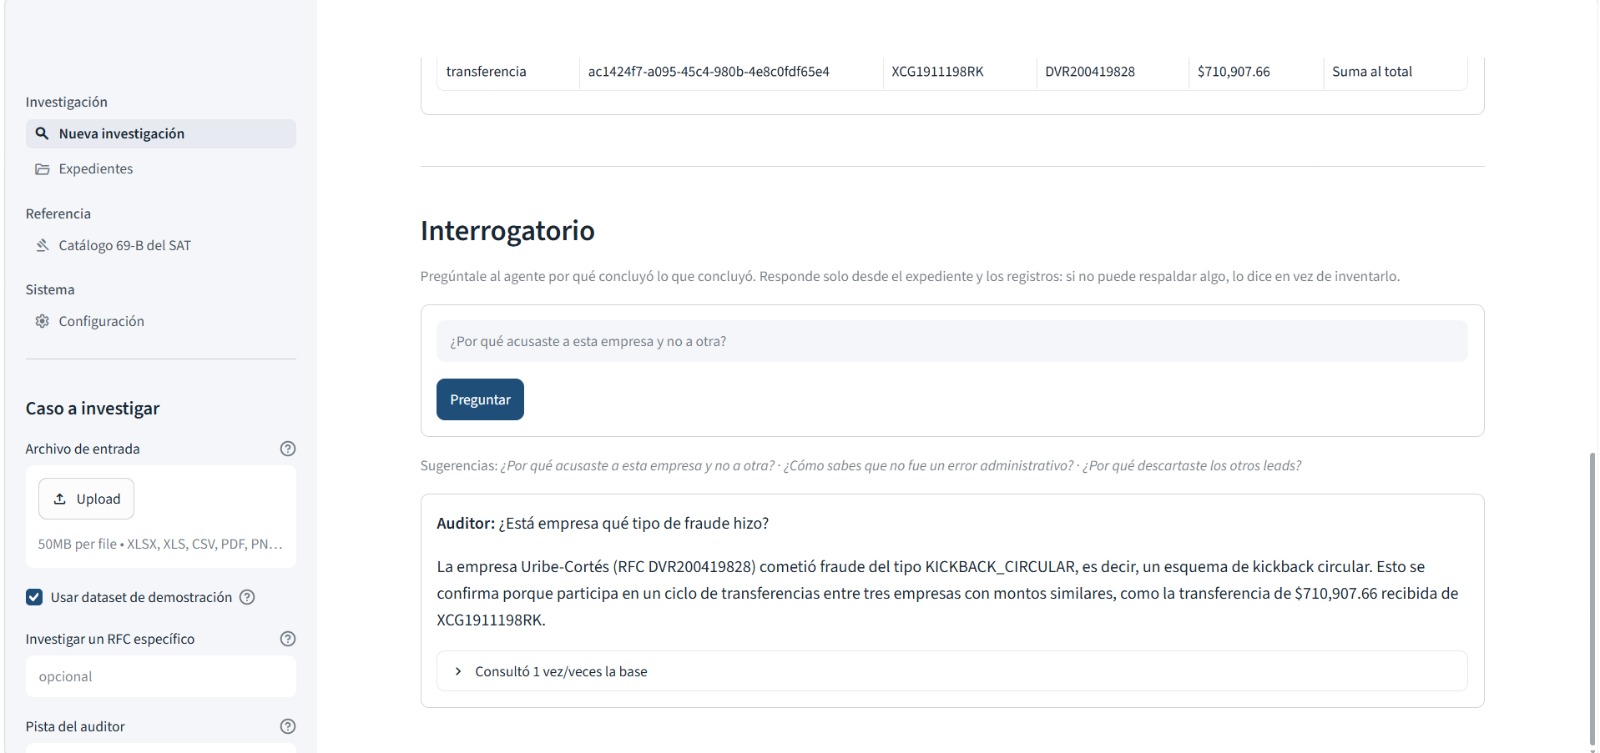
El resultado es un expediente pericial en PDF con folio, el rastro del dinero dibujado, y una lista de leads que se investigaron y se descartaron — con su razón exacta. Un "Defensor" responde preguntas del jurado sobre ese expediente en vivo, citando evidencia real, sin poder cambiar el dictamen ni inventar una exoneración.
How we built it
Cuatro fases, cada una con una responsabilidad y un dueño distinto: Ingesta (pandas, traduce cualquier formato al esquema canónico, sin LLM), Investigador (Qwen3.5:4b local vía Ollama, tool-calling nativo, solo puede señalar identificadores), Verificador (código puro, resuelve montos y razón social por SQL, aplica el estándar de prueba de cada tipología), y Auditor (Gemini, temperatura 0, redacta el expediente a partir de lo ya verificado). El principio que gobierna todo: ninguna cifra, RFC ni folio fiscal del expediente lo genera un modelo de lenguaje — el modelo señala qué fila mirar, el código resuelve su contenido.
Cargamos el listado real y completo del Artículo 69-B descargado del SAT (11,631 RFCs, con su situación y fecha de publicación en el DOF reales) como catálogo de referencia permanente, y sembramos un esquema de fraude EFOS usando un proveedor real de esa lista — no inventado. El frontend es Streamlit puro: nadie del equipo tiene experiencia en desarrollo web, así que todo el frontend vive en Python.
Challenges we ran into
El más caro fue de confianza, no de código: cada vez que dejábamos que el modelo generara un valor — un monto, un concepto, un identificador — tarde o temprano lo corrompía. La solución fue estructural en todo el sistema: el modelo nunca escribe una cifra, solo señala una fila.
Probamos el sistema contra sí mismo, deliberadamente, y encontramos fallas reales: un CFDI leído por visión que rompía el RFC del emisor 4 de 4 veces (resuelto con el dígito verificador del propio RFC, sin depender de que el modelo lea mejor); ciclos de comercio normal entre dos empresas que se marcaban como lavado de dinero (el round-tripping real necesita mínimo 3 nodos, no 2); dos esquemas de fraude que quedaban imposibles de probar en cualquier Excel que no fuera el nuestro, porque el catálogo de giros vivía en un archivo aparte; y — ya con el interrogatorio en vivo — el Defensor mezclando el monto de un caso con el esquema de otro al comparar cifras en prosa, que arreglamos enseñándole a consultar SQL en vez de comparar de memoria.

Log in or sign up for Devpost to join the conversation.