Inspiration
VOXA nació de una pregunta: ¿cómo podemos hacer que una charla sea más accesible, sin que el idioma se convierta en una barrera?
En conferencias y eventos, seguir una presentación, tomar notas y comprender contenido en otro idioma puede ser difícil. Queríamos crear una herramienta que permita concentrarse en las ideas del orador y consultar después los puntos más importantes.
Qué hace VOXA
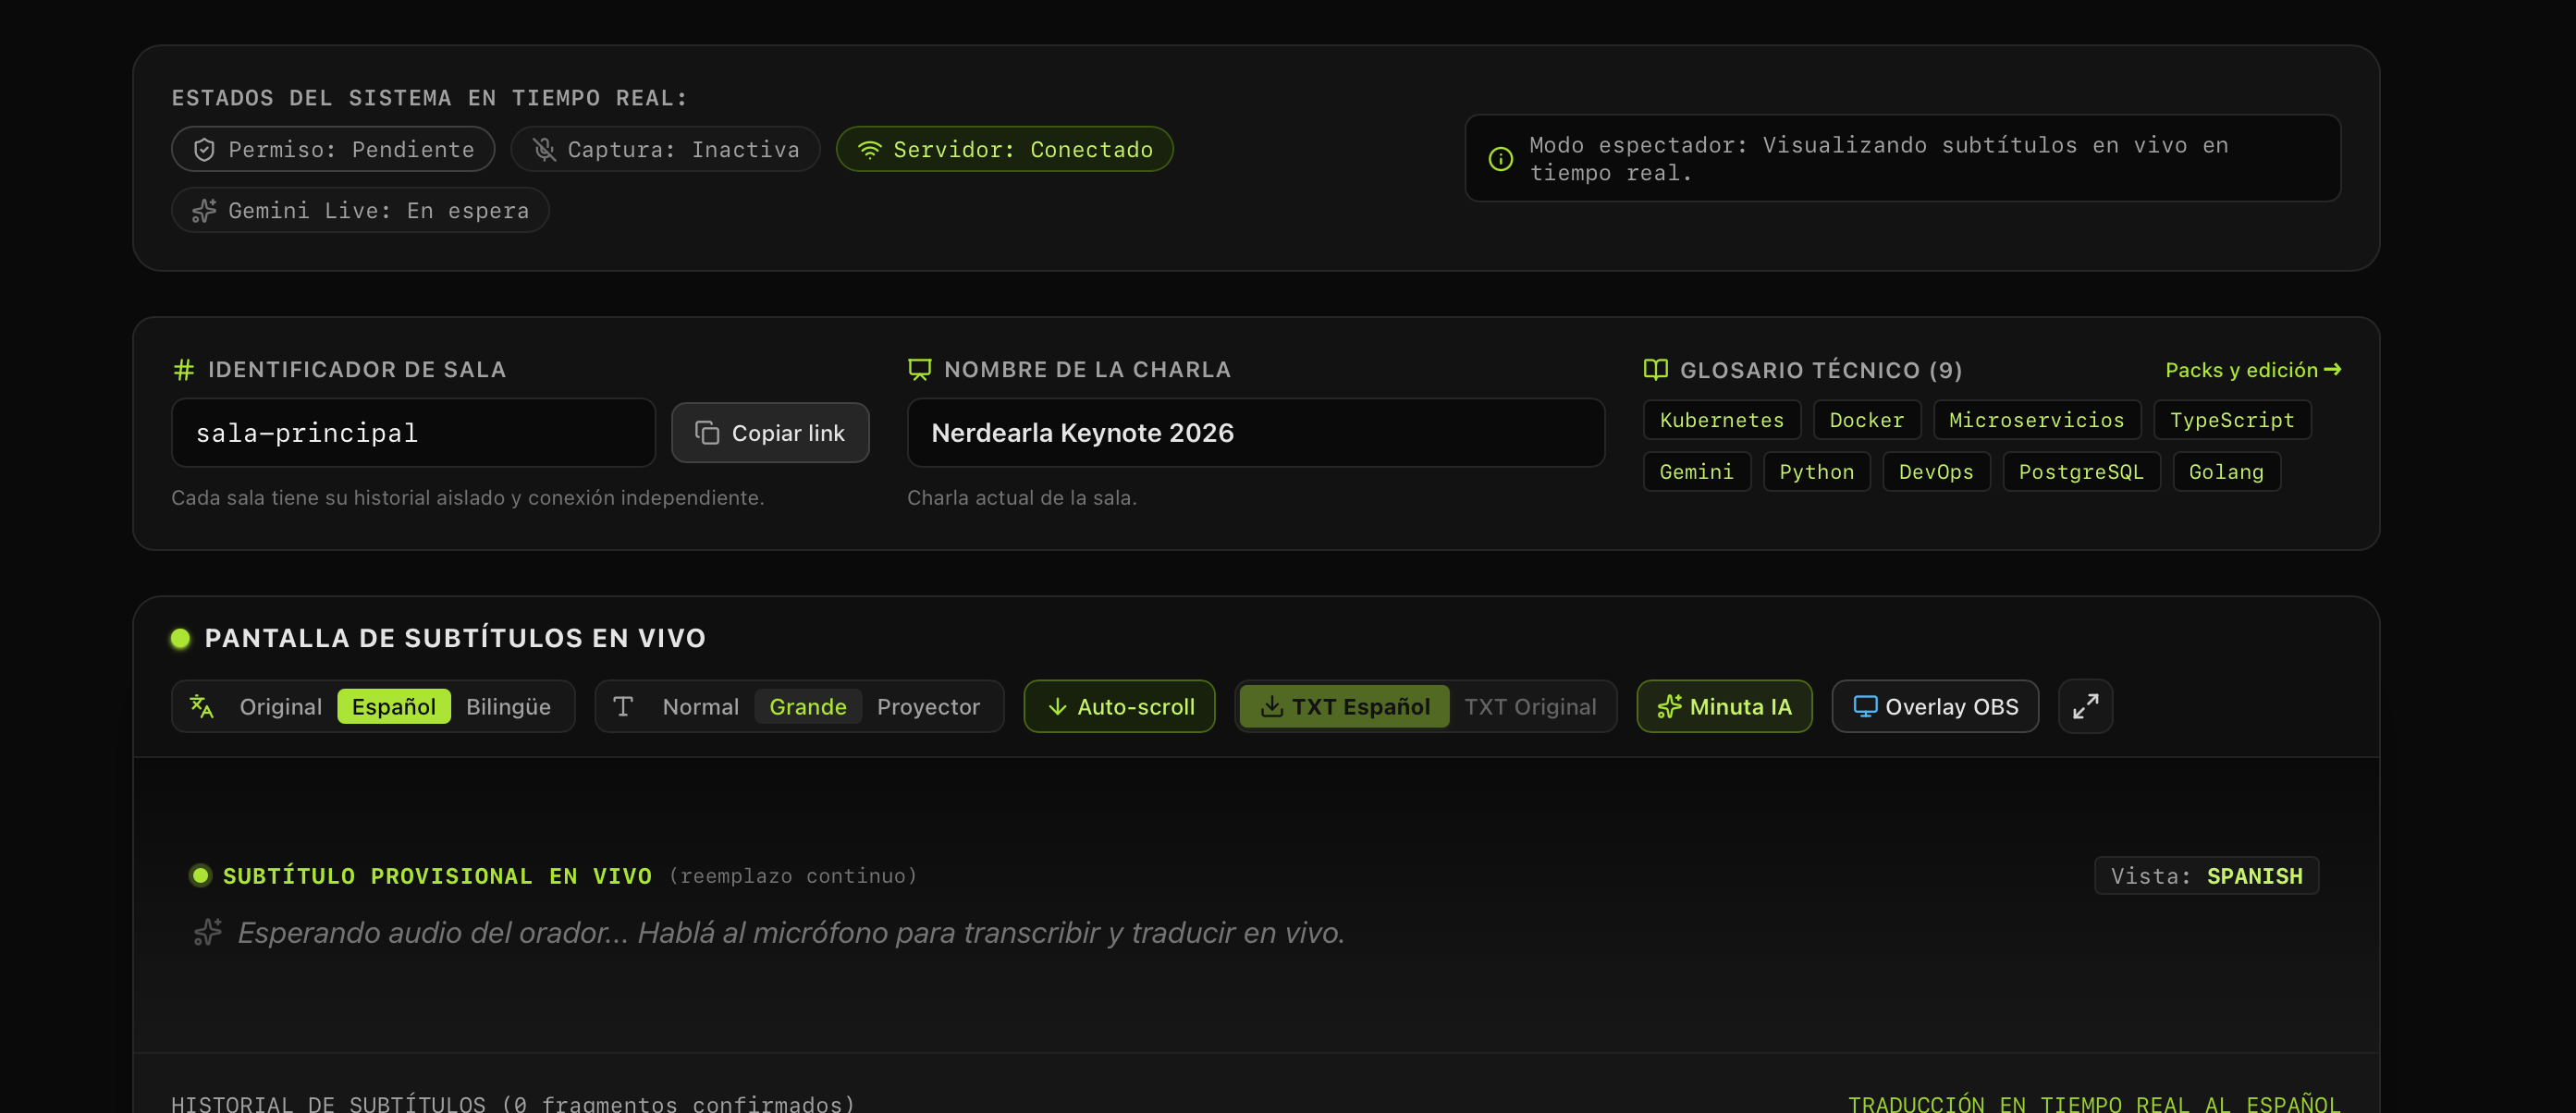
VOXA transforma el audio de una charla en subtítulos en vivo y permite traducirlos al idioma elegido. También genera un resumen ejecutivo de la transcripción y ofrece distintas opciones visuales para mostrar los subtítulos durante una presentación o transmisión.
El objetivo es acompañar a las personas durante la charla y ayudarlas a recuperar su contenido después.
Cómo lo construimos
Construimos la interfaz con React, TypeScript y Tailwind CSS, utilizando Vite y Google AI Studio para desarrollar e iterar sobre el prototipo.
El navegador captura el audio del micrófono mediante Web Audio API y AudioWorklet. Un servidor de Node.js y Express conecta a los participantes mediante WebSockets y envía el audio a Gemini Live API para obtener transcripciones de forma continua.
Utilizamos Gemini para traducir las transcripciones y generar resúmenes ejecutivos. También incorporamos fondos y opciones de presentación para adaptar los subtítulos a diferentes contextos, incluyendo un modo de superposición para transmisiones.
Desafíos que enfrentamos
El mayor desafío fue lograr una transcripción que resultara útil en vivo. Las primeras pruebas procesaban fragmentos de audio por separado, lo que generaba esperas largas, errores temporales del servicio y, en ocasiones, texto que no correspondía a lo que habíamos dicho.
Pasar a una conexión continua con Gemini Live mejoró la experiencia. También tuvimos que ajustar la captura del micrófono y probar el comportamiento en distintos navegadores.
Otro desafío fue manejar los errores de traducción sin interrumpir la charla. Incorporamos un comportamiento de respaldo que conserva la transcripción en el idioma original cuando la traducción falla.
Qué aprendimos
Aprendimos que una aplicación de IA en tiempo real depende de mucho más que elegir un modelo: la captura de audio, el transporte de datos, la latencia y la manera de mostrar los resultados son partes esenciales de la experiencia.
También aprendimos a distinguir entre procesar grabaciones y trabajar con audio continuo, y a diseñar una aplicación que siga siendo útil cuando un servicio externo tarda o falla.
De qué nos sentimos orgullosos
Logramos convertir un prototipo con problemas de demora en una experiencia funcional que combina transcripción, traducción y resúmenes en un mismo lugar.
VOXA representa un primer paso hacia charlas más accesibles y fáciles de seguir, donde cada participante pueda dedicar más atención a las ideas que se comparten.
Próximos pasos
Queremos seguir reduciendo la latencia, ampliar las pruebas con distintos idiomas y acentos, y validar la experiencia en eventos reales. También buscamos mejorar la precisión y la estabilidad para que VOXA pueda acompañar conversaciones cada vez más diversas.
Built With
- api
- audio
- audioworklet
- css
- express.js
- gemini
- gen
- google-ai-studio
- live
- node.js
- react
- sdk
- tailwind
- typescript
- vite
- web
- websockets

Log in or sign up for Devpost to join the conversation.