-
-
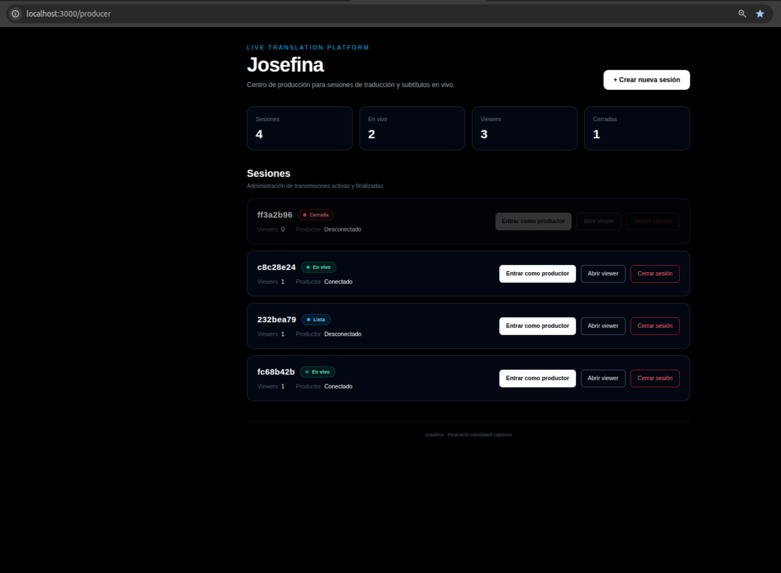
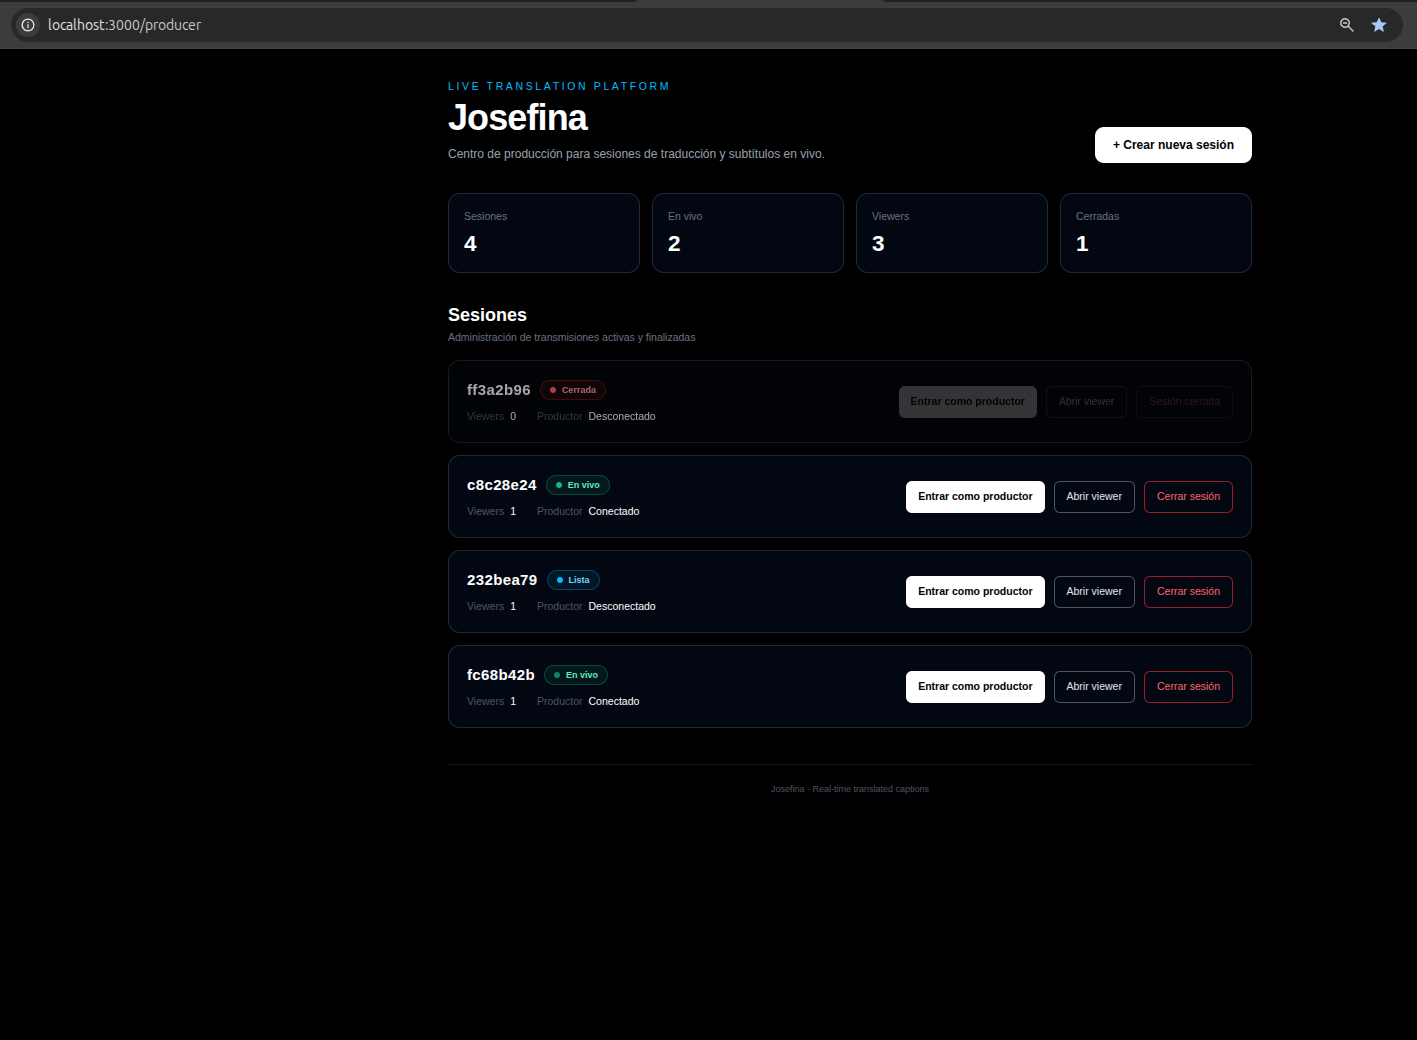
Panel de producción de Josefina con múltiples sesiones, estados en vivo/lista/cerrada, viewers conectados y controles de operación.
-
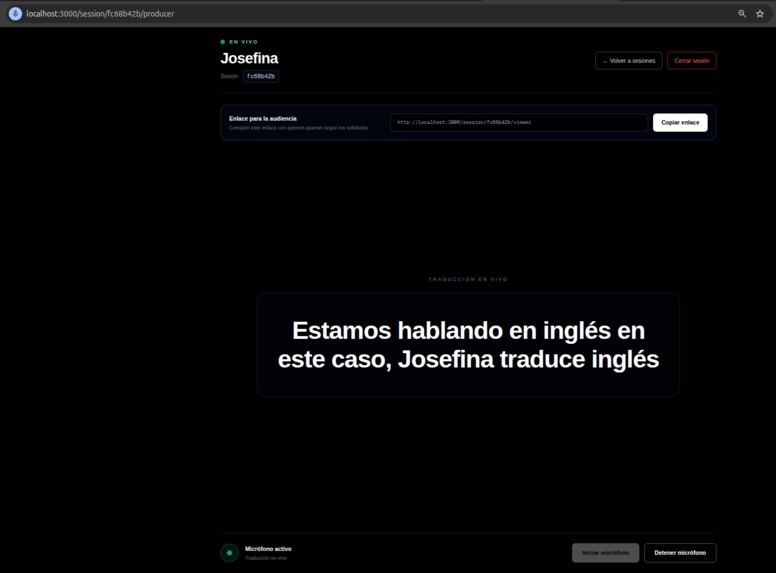
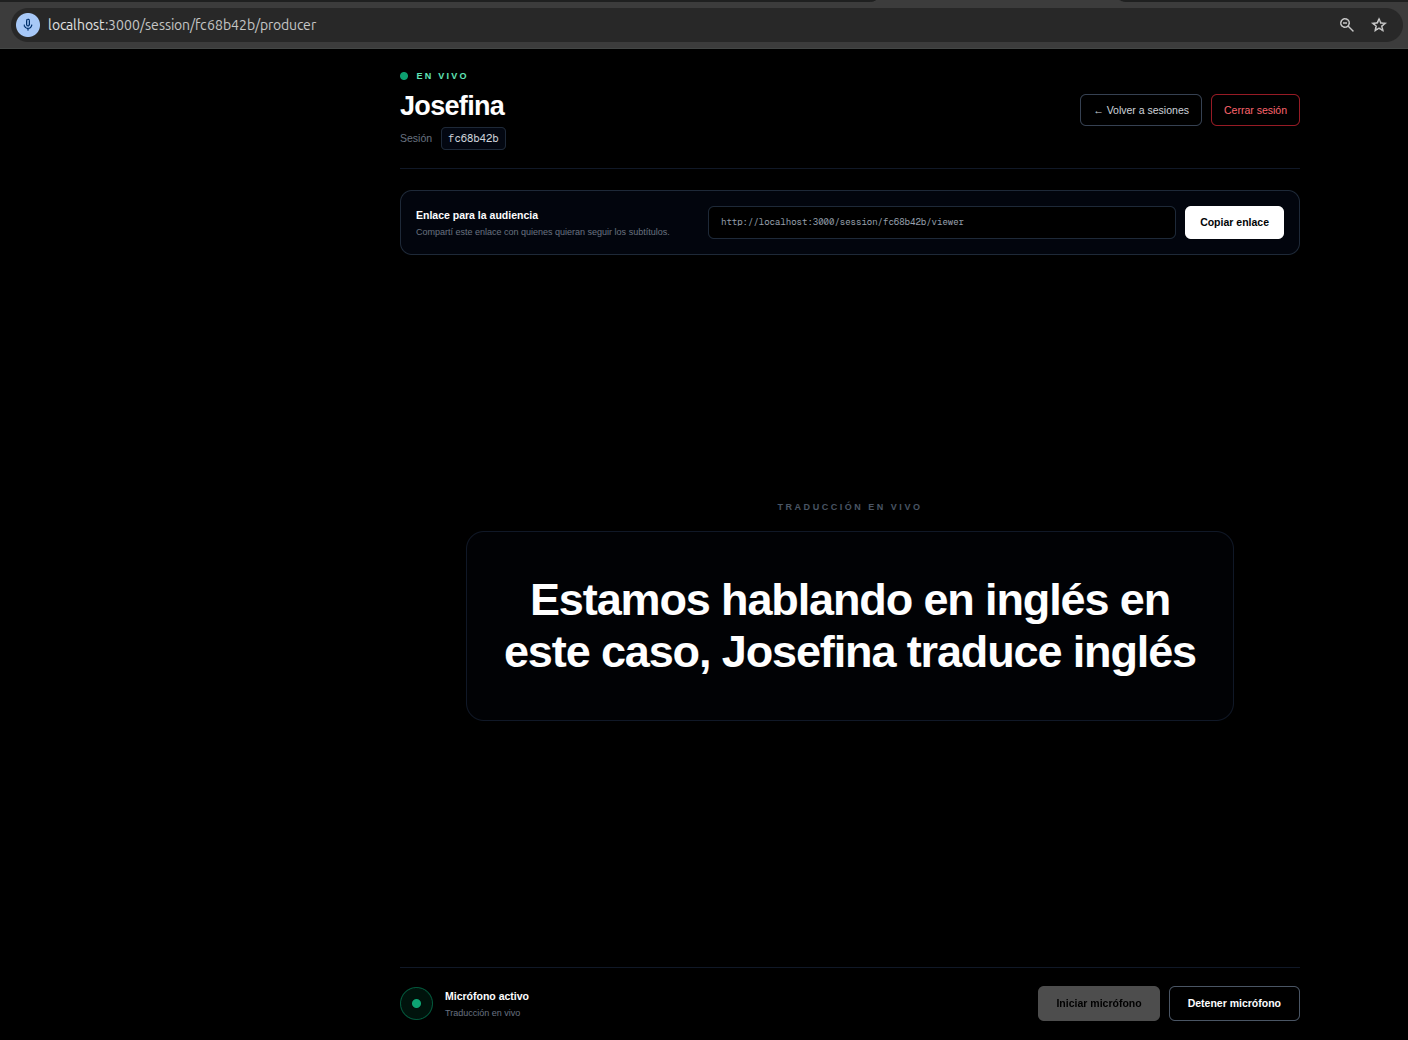
Interfaz del productor durante una sesión en vivo: micrófono activo, enlace para la audiencia y subtítulos traducidos en tiempo real.
-
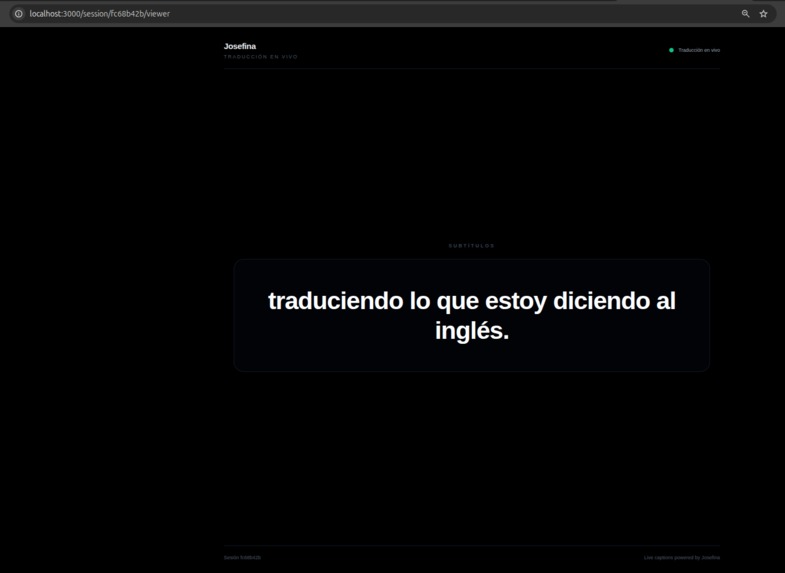
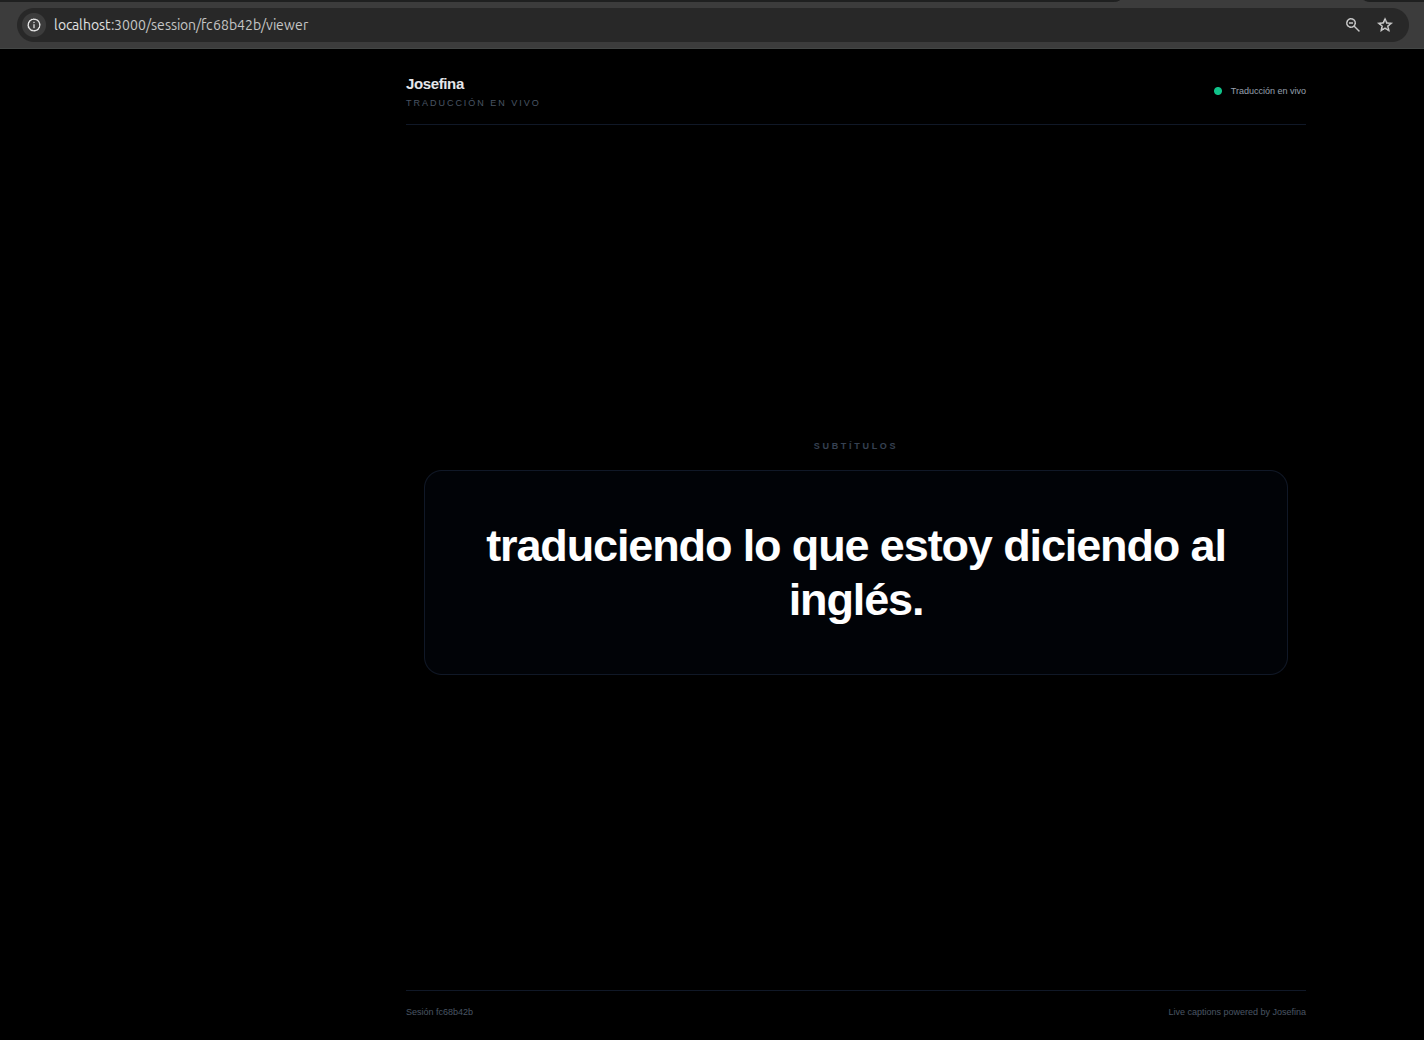
Vista del asistente recibiendo subtítulos traducidos en tiempo real desde una sesión activa de Josefina. para viewers
-
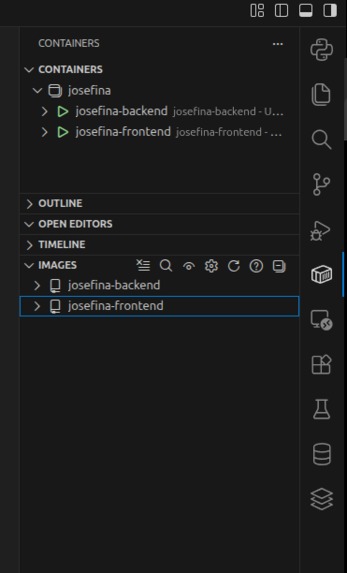
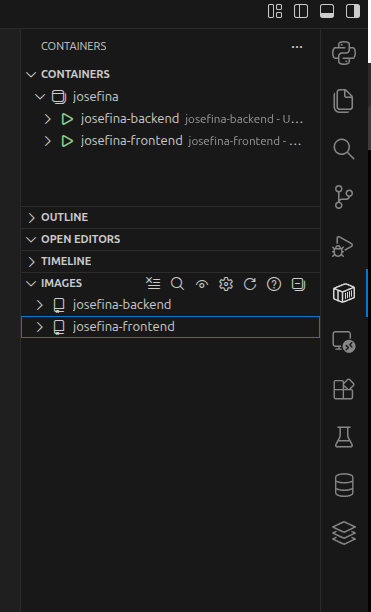
Despliegue containerizado de Josefina con frontend y backend ejecutándose como servicios independientes mediante Docker Compose.
-
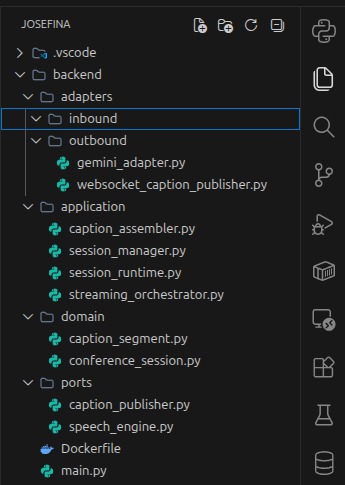
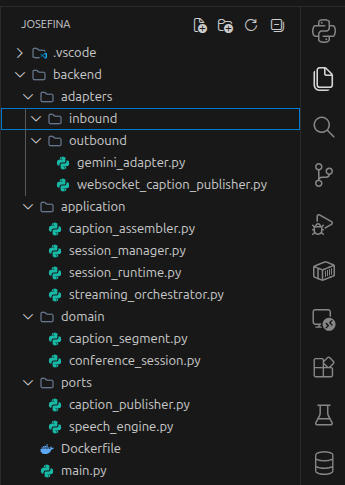
Backend organizado con arquitectura hexagonal (Ports and Adapters), separando dominio, aplicación, puertos y adaptadores de infraestructura.
Inspiration
Josefina nació de una necesidad concreta: reducir la barrera idiomática en conferencias y eventos en vivo sin obligar a la audiencia a instalar aplicaciones ni interrumpir la experiencia de la charla. La idea fue construir una solución simple para el asistente, pero operable desde producción: el organizador crea sesiones independientes, comparte un enlace con la audiencia y controla cada transmisión desde una consola central. El MVP actual trabaja con traducción en vivo de inglés a español, pero la arquitectura fue diseñada para poder incorporar nuevos idiomas y proveedores de procesamiento en el futuro.
What it does
Josefina genera subtítulos traducidos en tiempo real para conferencias en vivo. El productor puede crear y administrar múltiples sesiones desde un panel de producción. Cada sesión tiene su propia interfaz de productor, captura de micrófono, flujo de audio y enlace para viewers. El audio del orador se captura desde el navegador y se transmite continuamente al backend. Josefina procesa el audio y envía los subtítulos traducidos a los viewers mediante WebSockets. La audiencia únicamente necesita abrir el enlace de la sesión en un navegador para seguir los subtítulos. Actualmente el MVP implementa traducción de inglés a español.
How we built it
Construimos Josefina como una aplicación de streaming con frontend y backend separados.
El frontend utiliza Next.js, React y TypeScript. El navegador captura el micrófono mediante MediaRecorder y envía audio WebM/Opus en fragmentos de 500 ms.
El backend está desarrollado con Python y FastAPI. Cada flujo de audio llega mediante WebSocket y un proceso persistente de FFmpeg lo convierte a PCM mono de 16 kHz.
Cada sesión mantiene su propio runtime y una cola de audio asíncrona. Un StreamingOrchestrator consume esa cola y se comunica con Gemini Live a través de un puerto SpeechEngine.
Los resultados se ensamblan en segmentos y se publican a los viewers mediante otro WebSocket.
El backend utiliza una arquitectura hexagonal ligera —Ports and Adapters— para mantener la lógica de aplicación desacoplada de Gemini, WebSockets y otras tecnologías externas.
El frontend y el backend están containerizados y todo el MVP puede iniciarse con Docker Compose:
docker compose up --build
Challenges we ran into
Uno de los principales desafíos fue construir un flujo de audio realmente continuo en lugar de procesar grabaciones completas. El navegador produce audio WebM/Opus, mientras que el motor de speech necesita PCM. Para resolverlo mantuvimos un proceso FFmpeg persistente por transmisión que convierte el flujo mientras llegan nuevos fragmentos. Otro desafío fue coordinar correctamente el ciclo de vida de cada sesión: productor conectado, viewers, colas de audio, WebSockets, tareas asíncronas y cierre de recursos. También tuvimos que separar claramente las responsabilidades entre la consola de producción, la interfaz del productor y la interfaz del viewer, evitando que acciones de navegación interrumpieran accidentalmente una transmisión activa. Finalmente, containerizar frontend, backend y FFmpeg sin modificar el flujo que ya funcionaba fue otro desafío importante. A todo esto se sumó una restricción fundamental de la Vibeathon: el tiempo disponible era extremadamente limitado. Tuvimos que priorizar continuamente entre arquitectura, estabilidad, experiencia de usuario, despliegue y nuevas funcionalidades, intentando no romper un flujo end-to-end que ya funcionaba.
Accomplishments that we're proud of
Logramos construir un flujo completo de extremo a extremo durante la Vibeathon: micrófono → navegador → WebSocket → FFmpeg → PCM → Gemini Live → subtítulos → WebSocket → viewer También conseguimos: múltiples sesiones independientes; una consola central de producción; captura de audio en vivo desde el navegador; traducción inglés-español en tiempo real; enlaces independientes para la audiencia; múltiples viewers por sesión; cierre remoto de sesiones; separación entre las interfaces de producción y audiencia; arquitectura hexagonal con puertos y adaptadores; frontend y backend containerizados; despliegue completo mediante Docker Compose.
Nos interesaba especialmente que Josefina fuera algo más que una demostración aislada de speech-to-text: queríamos modelar un flujo que pudiera utilizarse realmente en la operación de un evento.
What we learned
Aprendimos que en una aplicación de subtítulos en vivo la calidad del modelo es solo una parte del problema. La latencia depende de todo el pipeline: captura del navegador, tamaño de los fragmentos de audio, transporte por WebSocket, conversión de formatos, procesamiento del modelo y distribución de subtítulos. También comprobamos la importancia de modelar explícitamente el ciclo de vida de una sesión y de aislar sus recursos. Cada sesión necesita administrar de forma independiente su productor, cola de audio, conexión de procesamiento y viewers. La arquitectura hexagonal también resultó útil para separar la lógica de streaming de los detalles específicos del proveedor de IA. Esto permite pensar en incorporar otros motores sin rediseñar el núcleo de la aplicación. Finalmente, aprendimos que la facilidad de operación es tan importante como la traducción: crear una sesión, compartir un enlace y cerrarla deben ser acciones simples para quien está produciendo un evento.
What's next for Josefina
El siguiente paso es ampliar Josefina desde el MVP actual de inglés a español hacia una plataforma multilingüe y más resiliente. Queremos incorporar selección de idiomas de origen y destino, múltiples idiomas simultáneos, detección automática de idioma, glosarios técnicos, persistencia de sesiones, historiales y descarga de transcripciones, autenticación, métricas de latencia y calidad, y observabilidad de producción. También queremos evolucionar la arquitectura para mejorar escalabilidad y tolerancia a fallos. Entre los próximos pasos están: Watchdogs por sesión y por worker, capaces de detectar conexiones bloqueadas, tareas detenidas o sesiones sin progreso y recuperarlas automáticamente. Separación en microservicios para desacoplar captura de audio, procesamiento, traducción, distribución de subtítulos y gestión de sesiones. Estado distribuido con Redis, para compartir información de sesiones entre múltiples instancias. Colas de trabajo y workers escalables, permitiendo aumentar capacidad horizontalmente según la cantidad de sesiones activas. Escalado horizontal, distribuyendo sesiones entre distintas instancias o nodos sin cambiar el flujo central. Health checks y recuperación automática, de modo que una falla en un componente no derribe toda la conferencia. TLS, reverse proxy y routing de WebSockets para un despliegue real en producción. La arquitectura hexagonal actual facilita esta evolución porque los casos de uso centrales ya están desacoplados de la infraestructura mediante puertos y adaptadores.
Built With
- asyncio
- captions
- docker
- docker-compose
- fastapi
- ffmpeg
- gemini
- hexagonal-architecture
- live-translation
- mediarecorder
- next.js
- python
- react
- real-time
- speech-to-text
- streaming
- tailwindcss
- typescript
- websockets

Log in or sign up for Devpost to join the conversation.