-
-
Bienvenido!
-
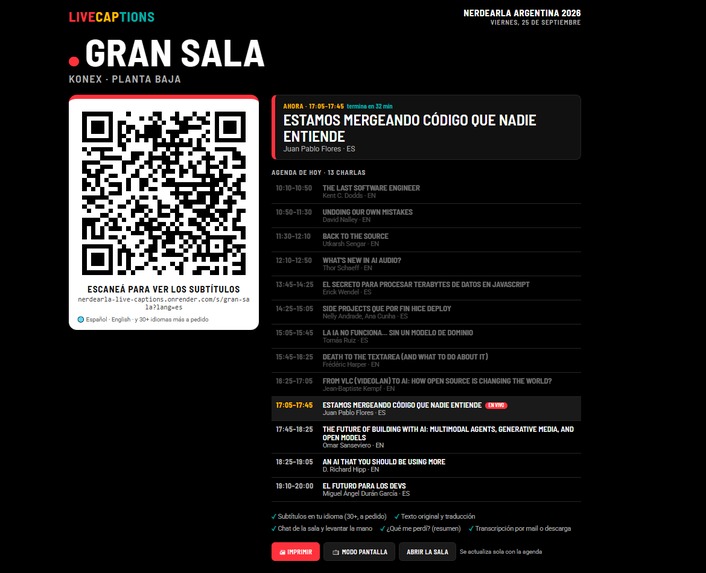
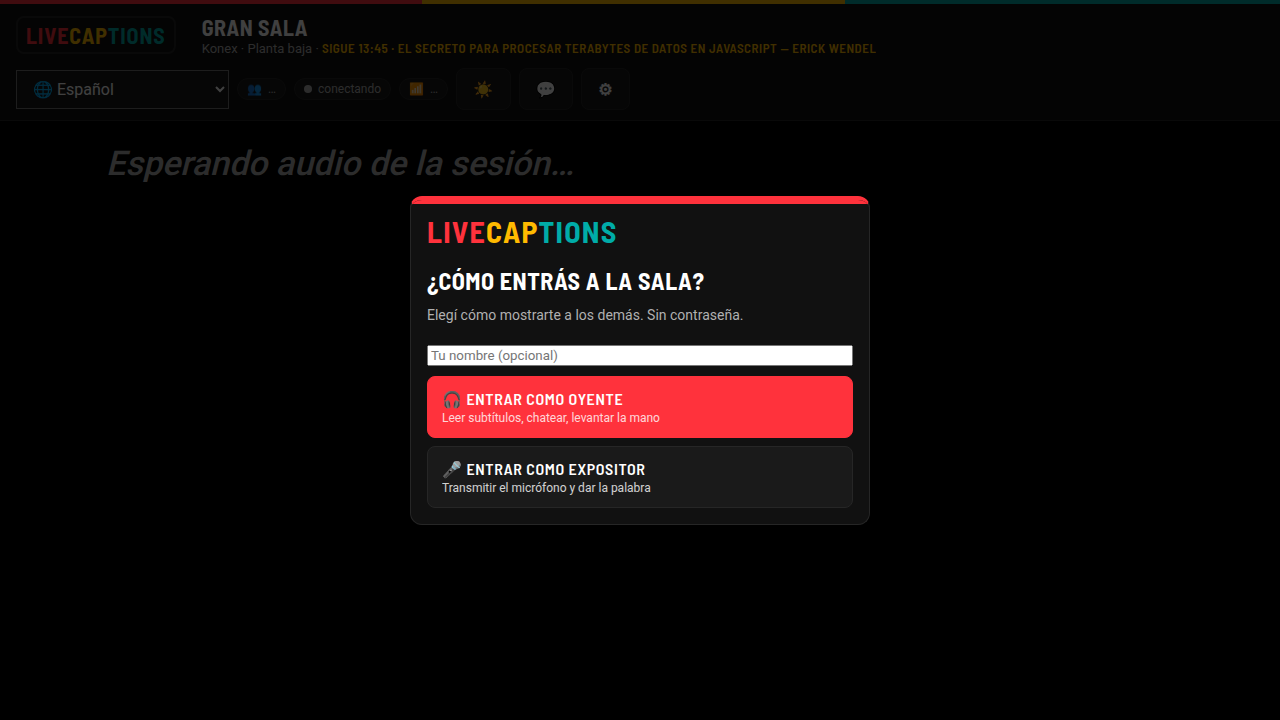
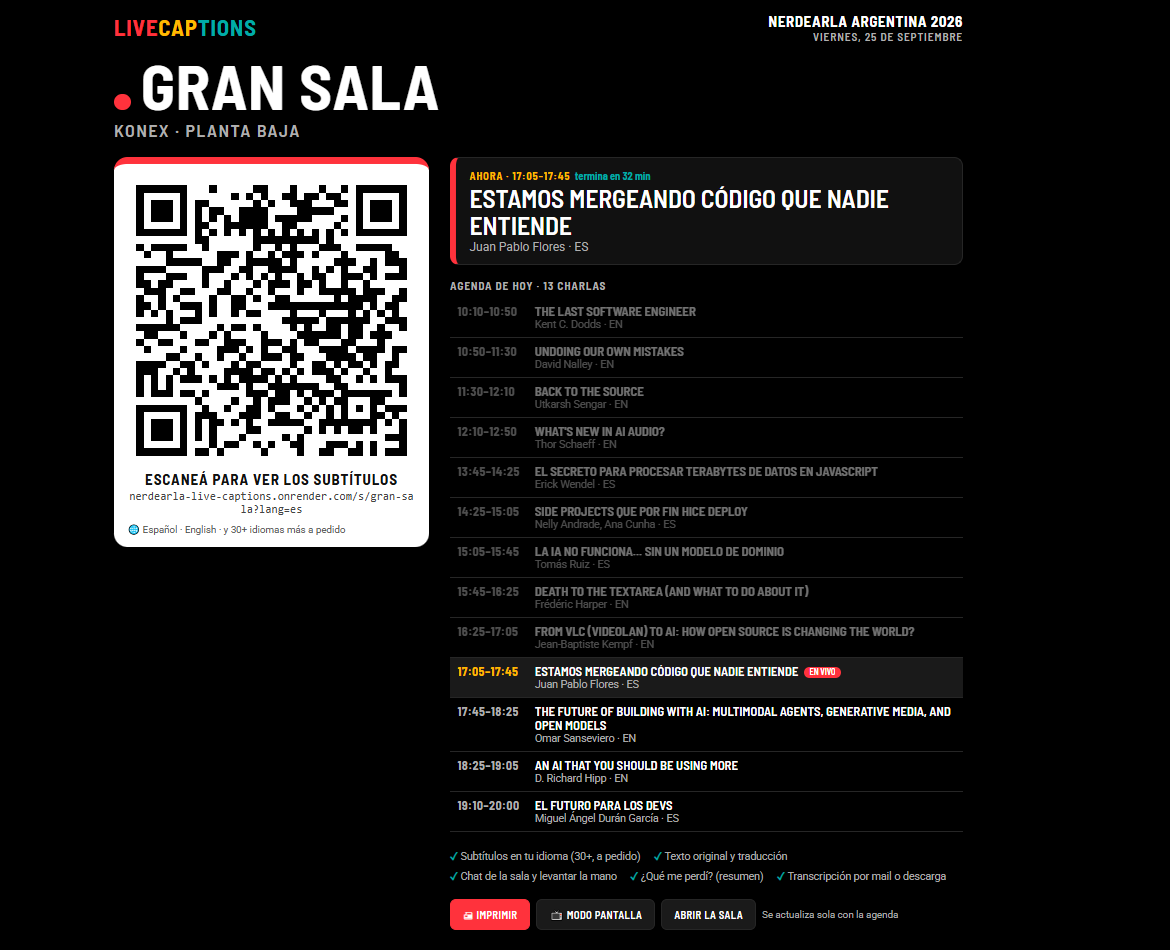
Pantalla de acceso QR de la sala, probada en vivo en Nerdearla 2026
-
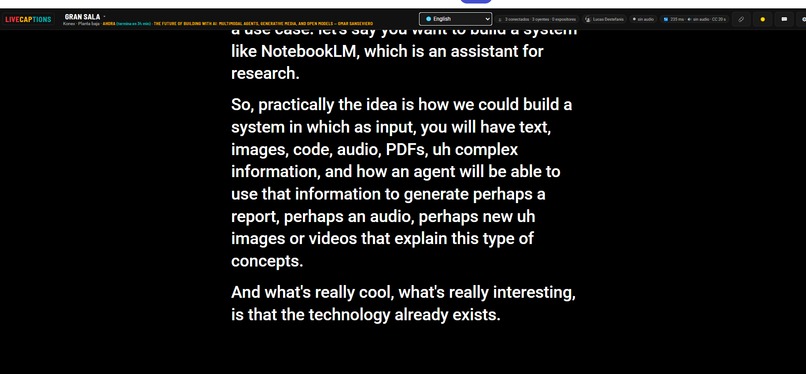
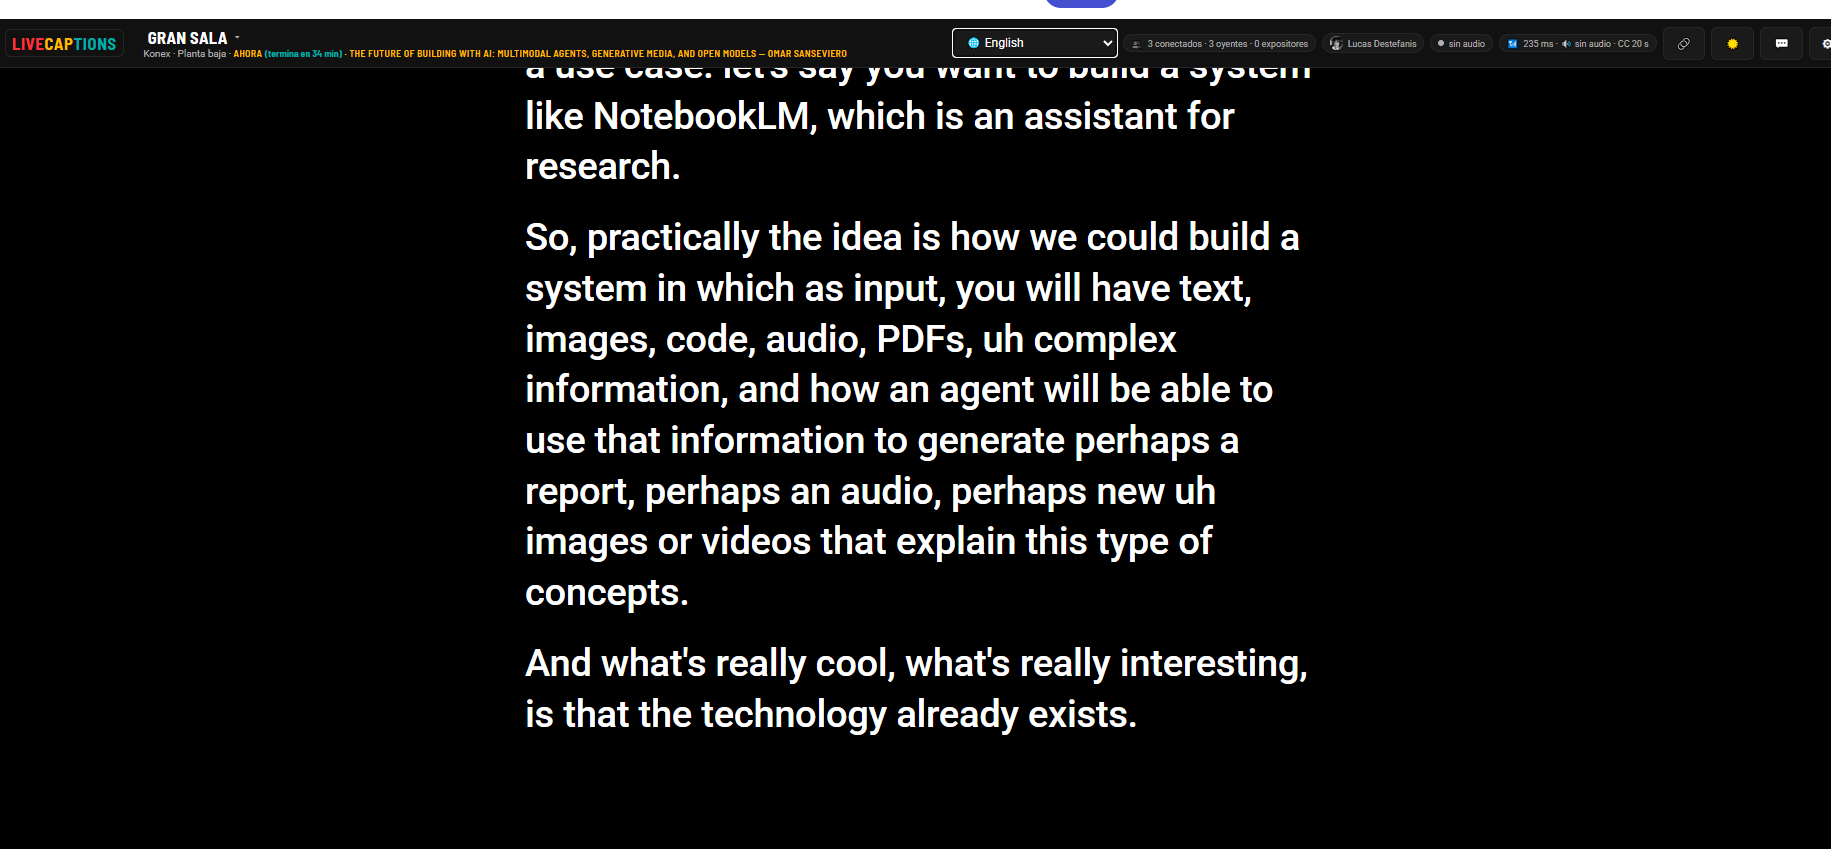
Probado en vivo en Nerdearla 2026: charla real traducida al ingles en tiempo real, sin retraso perceptible
-
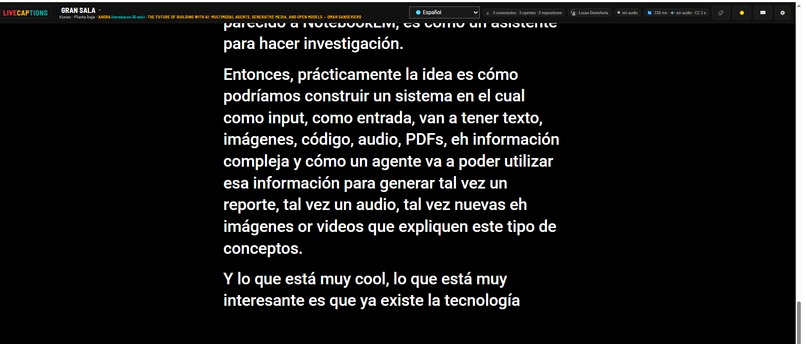
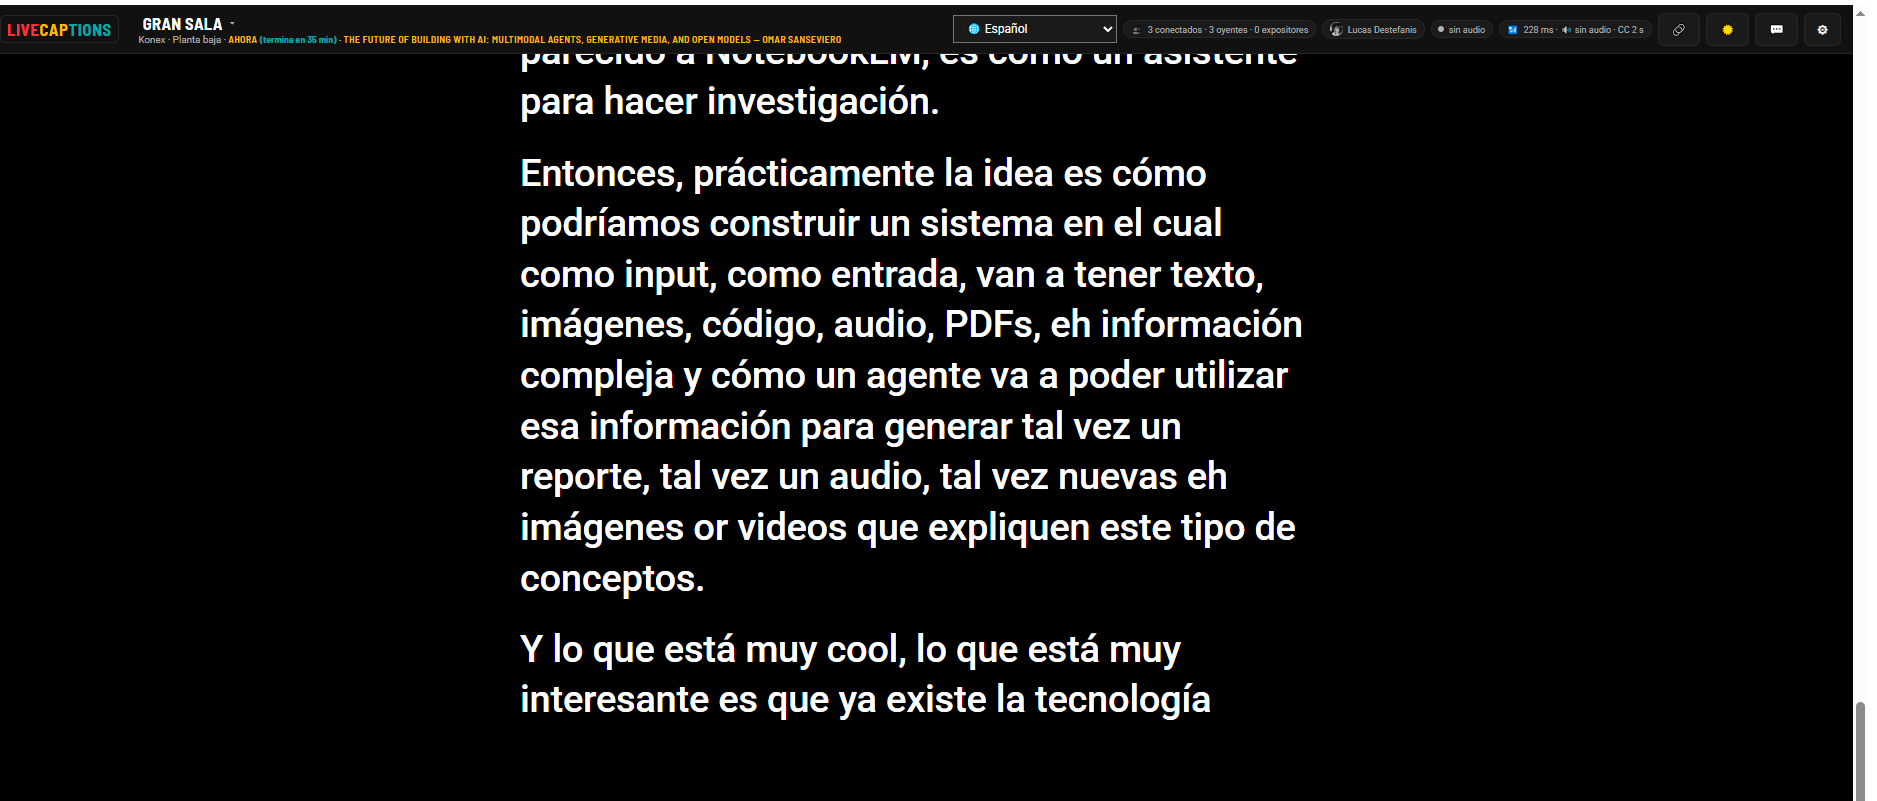
Probado en vivo en Nerdearla 2026: subtitulo real en espanol de la charla de Omar Sanseviero (Google DeepMind)
-
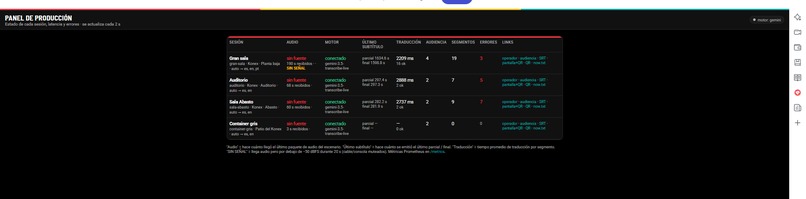
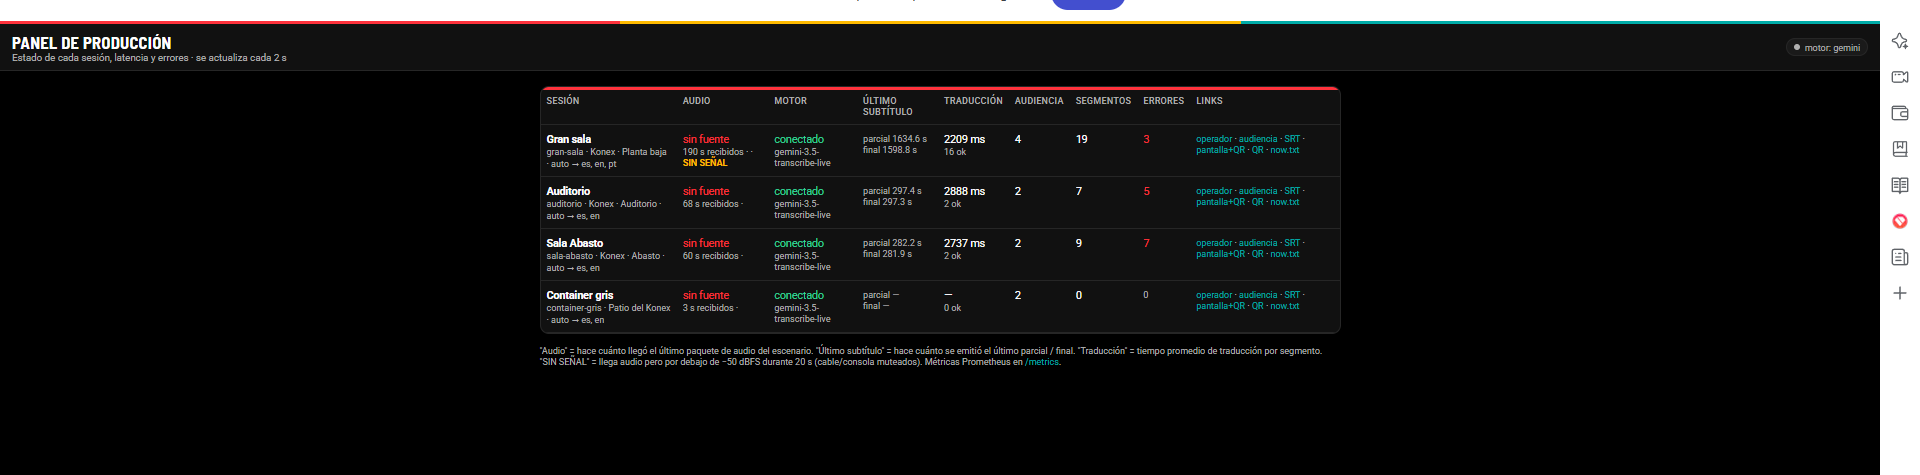
Probado en vivo en Nerdearla 2026: panel /admin con las 4 salas activas, audio, motor y latencia en tiempo real
-
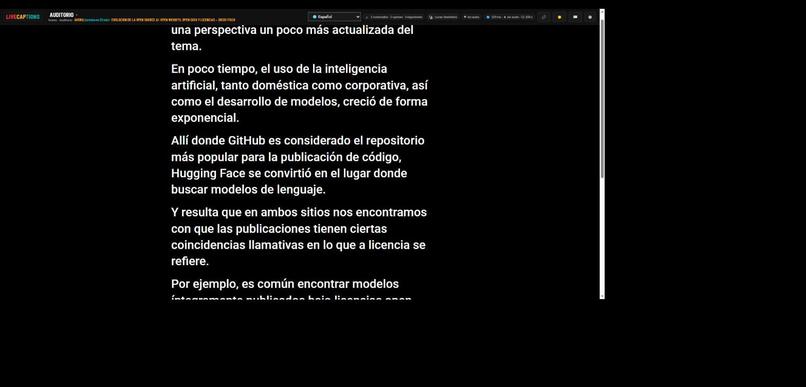
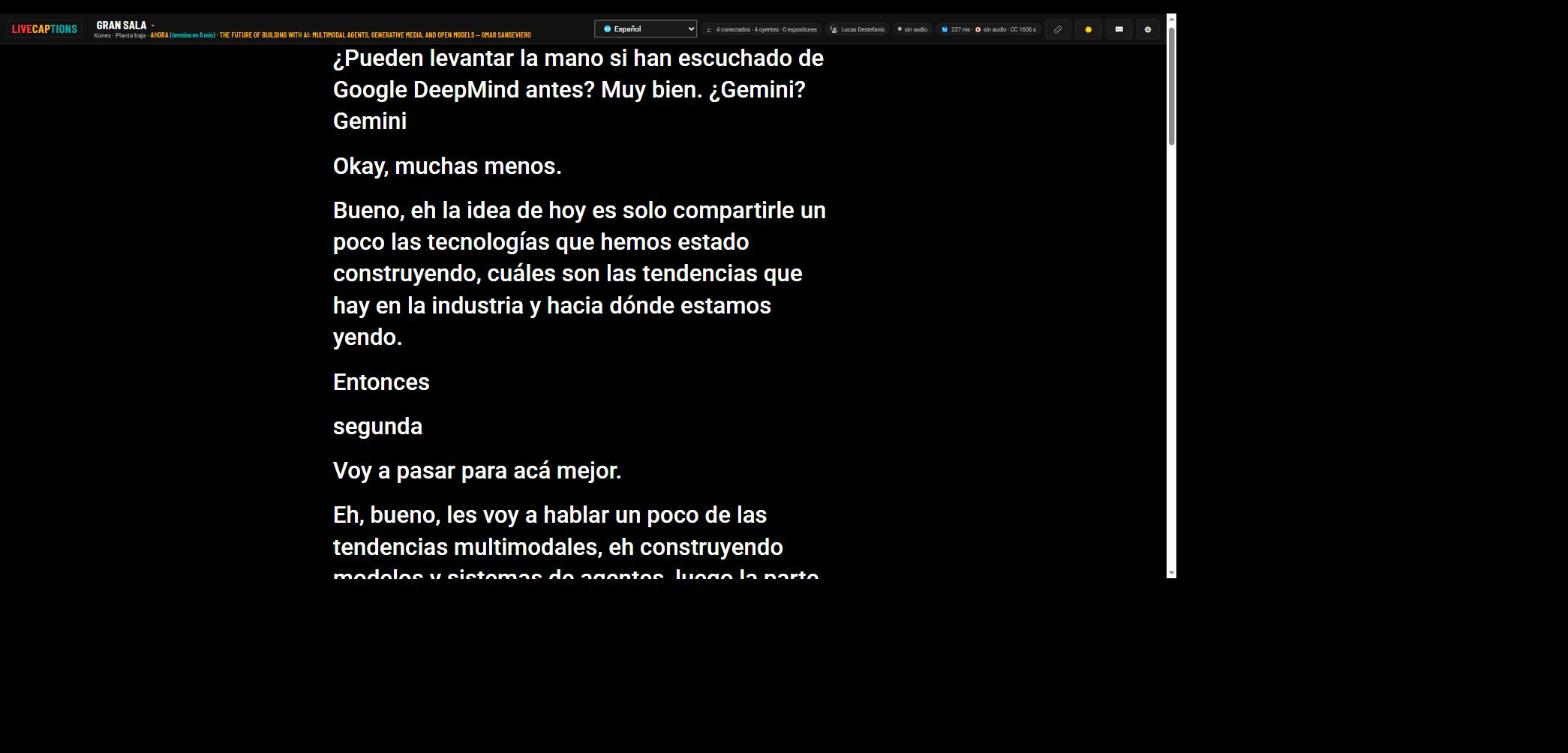
Probado en vivo en Nerdearla 2026: subtitulos reales en la Gran Sala, charla de Omar Sanseviero
-
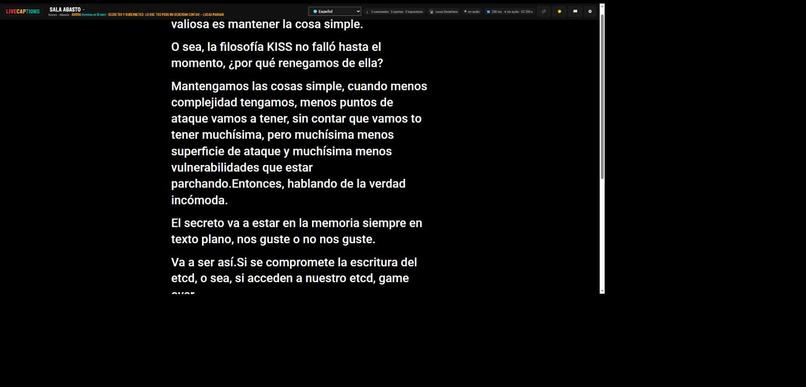
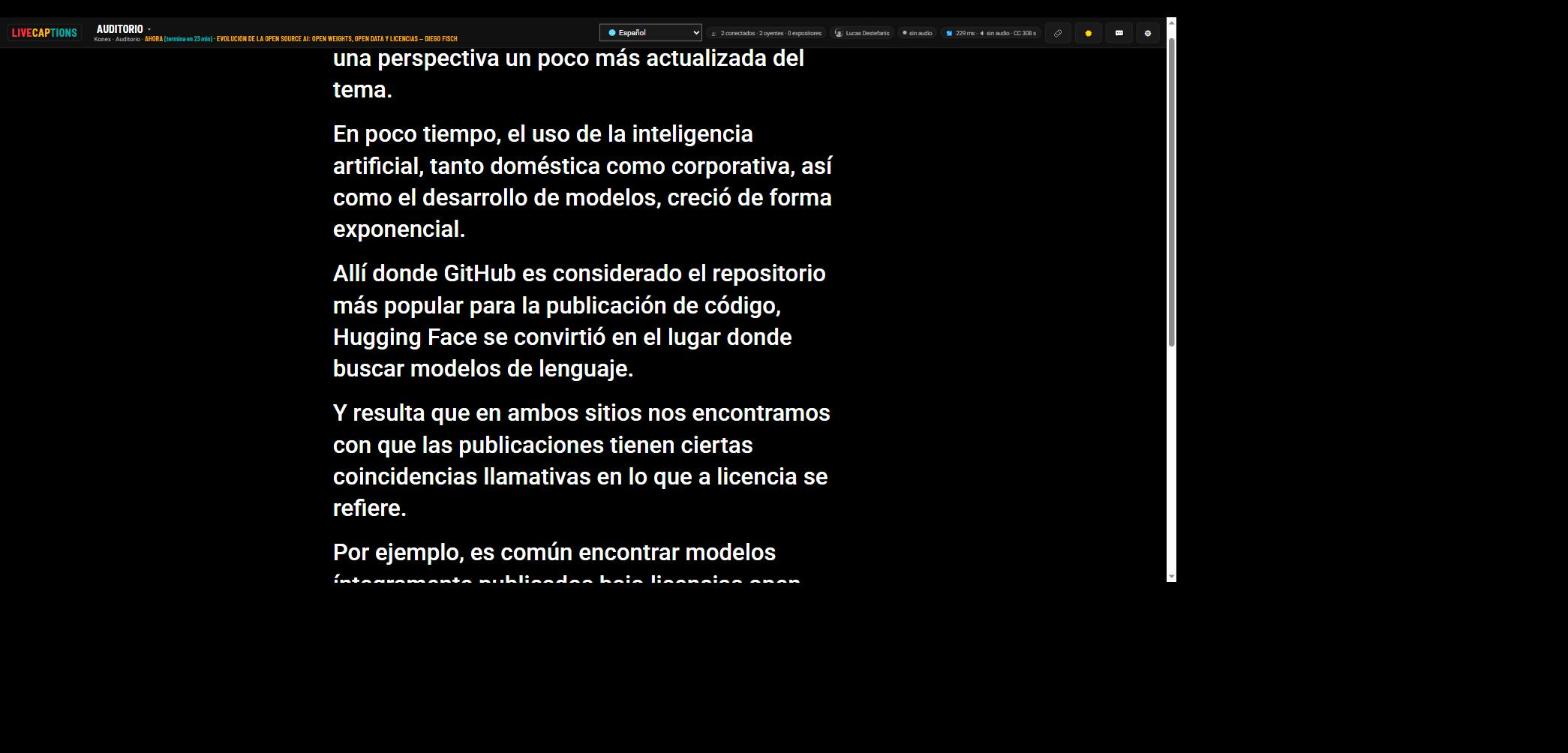
Probado en vivo en Nerdearla 2026: subtitulos reales en el Auditorio, charla de Diego Fisch
-
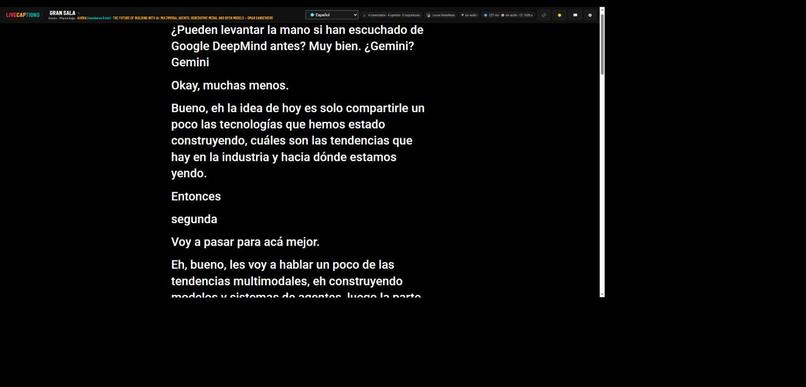
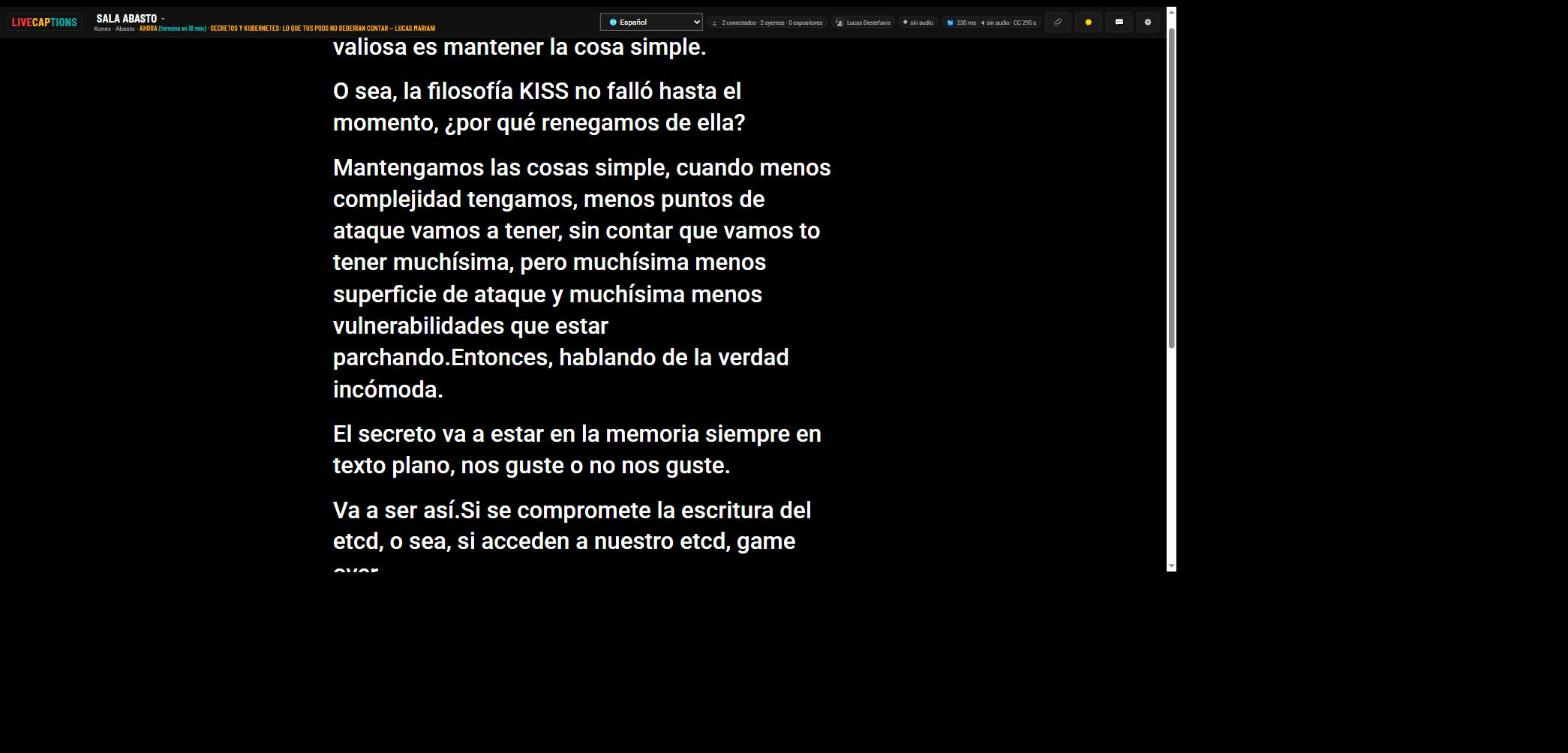
Probado en vivo en Nerdearla 2026: subtitulos reales en Sala Abasto, charla de Lucas Mariani
Inspiration
Nerdearla ofrece transcripción simultánea hace varios años, pero hoy la resuelve con dos herramientas comerciales (una para español→español, otra para inglés→español) y mucha operación manual. Este año son más de 30 sesiones en inglés, muchas en simultáneo, y ese esquema ya no escala: es caro, depende de gente atenta a cada escenario, y no se puede replicar fácilmente en otra conferencia. Casi ningún evento open source tiene una alternativa. Construimos la que nos gustaría que existiera: abierta, gratis de operar (o casi) y desplegable en una tarde.
Cómo responde al desafío, punto por punto
Lo obligatorio de la consigna:
- ✅ Audio en vivo → subtítulos en tiempo real, transcripción en el idioma original y traducción al español (y viceversa): arranca con español ⇄ inglés, y cualquier otro idioma se suma a pedido sin reiniciar nada — hasta 30 idiomas de traducción distintos probados.
- ✅ Varias sesiones al mismo tiempo: probado en vivo en Nerdearla 2026 con 4 escenarios reales simultáneos (Gran sala, Auditorio, Sala Abasto, Container gris); el diseño es una sesión independiente por escenario, así que 10 o más en paralelo no cambian la arquitectura, solo el costo (lineal).
- ✅ Licencia aprobada por OSI + documentación clara para desplegar en cualquier conferencia: Apache-2.0, manual completo paso a paso (docs/MANUAL.md, también en PDF para leer online o descargar), y un click para desplegar en Render, Railway, Google Cloud Run, Kubernetes o Docker.
- ✅ Vista para la audiencia: página web (
/s/<id>?lang=es) donde cada persona elige su sesión y su idioma, sin instalar nada.
Los opcionales — los sumamos todos:
- ✅ Integración con OBS/vMix: modo overlay con fondo transparente como browser source, y
now.txt/now.jsoncomo ticker de texto para quemar el subtítulo en el stream. - ✅ Más idiomas de entrada y salida: no solo español/inglés/portugués — cualquiera de los ~30 idiomas que soporta Gemini, agregado en caliente por sala.
- ✅ Glosario de términos técnicos y nombres propios, configurable por evento, sala y sesión para mejorar la traducción; ahora se completa solo con los oradores que se cargan en la agenda.
- ✅ Exportación completa al final de cada charla: SRT, VTT, TXT y JSON, más envío directo por mail (SMTP o Resend).
- ✅ Panel de monitoreo para producción (
/admin): estado de audio (con nivel dBFS y aviso de "sin señal"), motor, latencia de subtítulos y traducción, audiencia conectada y errores, por sesión.
Y fuimos más allá de la consigna:
- Panel de organizadores (
/admin/sessions, con login de Google): crear salas, cargar y editar la agenda —título, orador, horario, idioma, fuente de audio— sin tocar ningún archivo a mano ni reiniciar el servidor, con persistencia en disco. - Sala social, no solo subtítulos: chat con emojis y audios cortos, mano levantada con aprobación del expositor, resumen con IA de "¿Qué me perdí?", modo alto contraste y pausa para releer, cuentas con Google o GitHub.
- Agenda real del evento: cada sala muestra qué charla está "ahora" y cuál "sigue", tomado en vivo de la agenda cargada — nadie tiene que adivinar a qué sesión entrar.
- Métricas Prometheus en
/metrics, QR de acceso a cada sala, y 21+ pruebas automáticas corriendo en CI en cada push.
Probalo ahora (demo pública, Gemini real)
https://nerdearla-live-captions.onrender.com — son las salas reales de Nerdearla 2026 (Gran sala, Auditorio, Sala Abasto, Container gris) con la agenda del viernes tomada de nerdearla.com: 35 charlas con orador, horario e idioma. Elegí una sala, entrá como expositor y apretá Transmitir micrófono; desde otro celular entrá como oyente en otro idioma. Video (2:47, demo real): https://youtu.be/y4v_iiF91rE
How we built it
Node 22 + Express + WebSockets, sin base de datos: el audio PCM 16 kHz llega por WebSocket desde el navegador del expositor (AudioWorklet) o desde tools/ingest.js (ffmpeg: archivo, RTMP/SRT/HLS, dispositivo). Cada sala abre una sesión de gemini-3.5-transcribe-live con rotación antes del límite de 10 minutos y sin perder audio; la traducción usa gemini-3.5-flash-lite con una sola llamada para todos los idiomas destino y rotación de modelo ante cuotas. Opcional: traducción 100 % local con Gemma (Ollama). La agenda y las salas viven en un archivo JSON editable desde /admin/sessions (Google-gated), con DATA_DIR apuntando a un disco persistente en producción. Docker, render.yaml, railway.json, deploy/cloudrun.sh y deploy/kubernetes.yaml.
Challenges we ran into
Cuotas del nivel gratuito de Gemini con muchas salas (resuelto con una llamada por frase para todos los idiomas, rotación de modelos y traducción de parciales configurable), parciales que repetían texto ya finalizado (de-duplicación por prefijo normalizado), detección de idioma inestable en las primeras frases (votación por mayoría), y hacer que todo —transmitir, leer, chatear, exportar, y ahora también armar la agenda— viva en una sola pantalla sin consola aparte. Ya en vivo el día del evento (26/09) descubrimos que un orador fluido, sin pausas de silencio reales, podía dejar minutos enteros de charla sin traducir porque el corte de "frase final" dependía de esa pausa: lo resolvimos cortando y traduciendo por puntuación apenas se detecta una oración completa, sin esperar ningún silencio, con deduplicación contra el corte tardío del motor para no repetir texto.
Accomplishments that we're proud of
Cubrir el 100% de lo obligatorio y de lo opcional de la consigna, y sumar todavía más. Demo pública con Gemini real que cualquiera puede probar desde el celular. 21+ pruebas automáticas (unit + end-to-end + features) en GitHub Actions. Números medidos con tools/bench.js (docs/EVIDENCIA.md): 10 salas × 50 espectadores → 2.100 mensajes/s, fan-out p95 2 ms, 4 % CPU, 119 MB RAM en 2 vCPU; con Gemini real, traducción disponible ≤ 2,7 s (p95) después de la frase final.
What we learned
Que la transcripción en streaming ya alcanza para reemplazar el esquema manual, y que el trabajo real está en la operación y en la audiencia: que un expositor lo arranque en un minuto, que producción vea de un vistazo qué escenario se quedó sin audio, y que quien llega tarde o no ve bien tenga una respuesta en la misma pantalla.
What's next
Whisper local como motor alternativo de transcripción, doblaje en vivo por audio, diarización de oradores, y que el glosario de cada sala cambie automáticamente según la charla que está "ahora" en la agenda (hoy se acumulan todos los términos de la sala).


Log in or sign up for Devpost to join the conversation.