-
-
Logo
-
Output final del programa
Inspiration
En Latinoamérica, el teléfono históricamente es uno de los canales favoritos para realizar fraude bancario: es rápido, personal y fácil de manipular por medio de falsificaciones. Con el auge de la inteligencia artificial generativa esto se volvió todavía más peligroso, porque hoy basta con unos segundos de audio para clonar una voz y hacerse pasar por cualquier persona frente a un banco. La inteligencia artificial ha sido tema de conversación constante este último año, pero casi nadie habla de lo que pasa detrás de una llamada, de cómo saber si la voz al otro lado del teléfono es real o no. Eso fue lo que nos motivó a construir Lfant, entender qué señales delatan a una IA antes de que logre engañar a un sistema bancario.
What it does
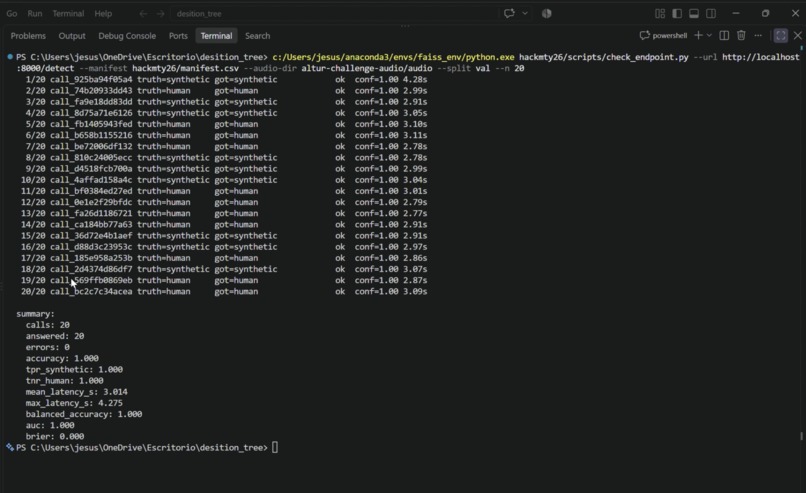
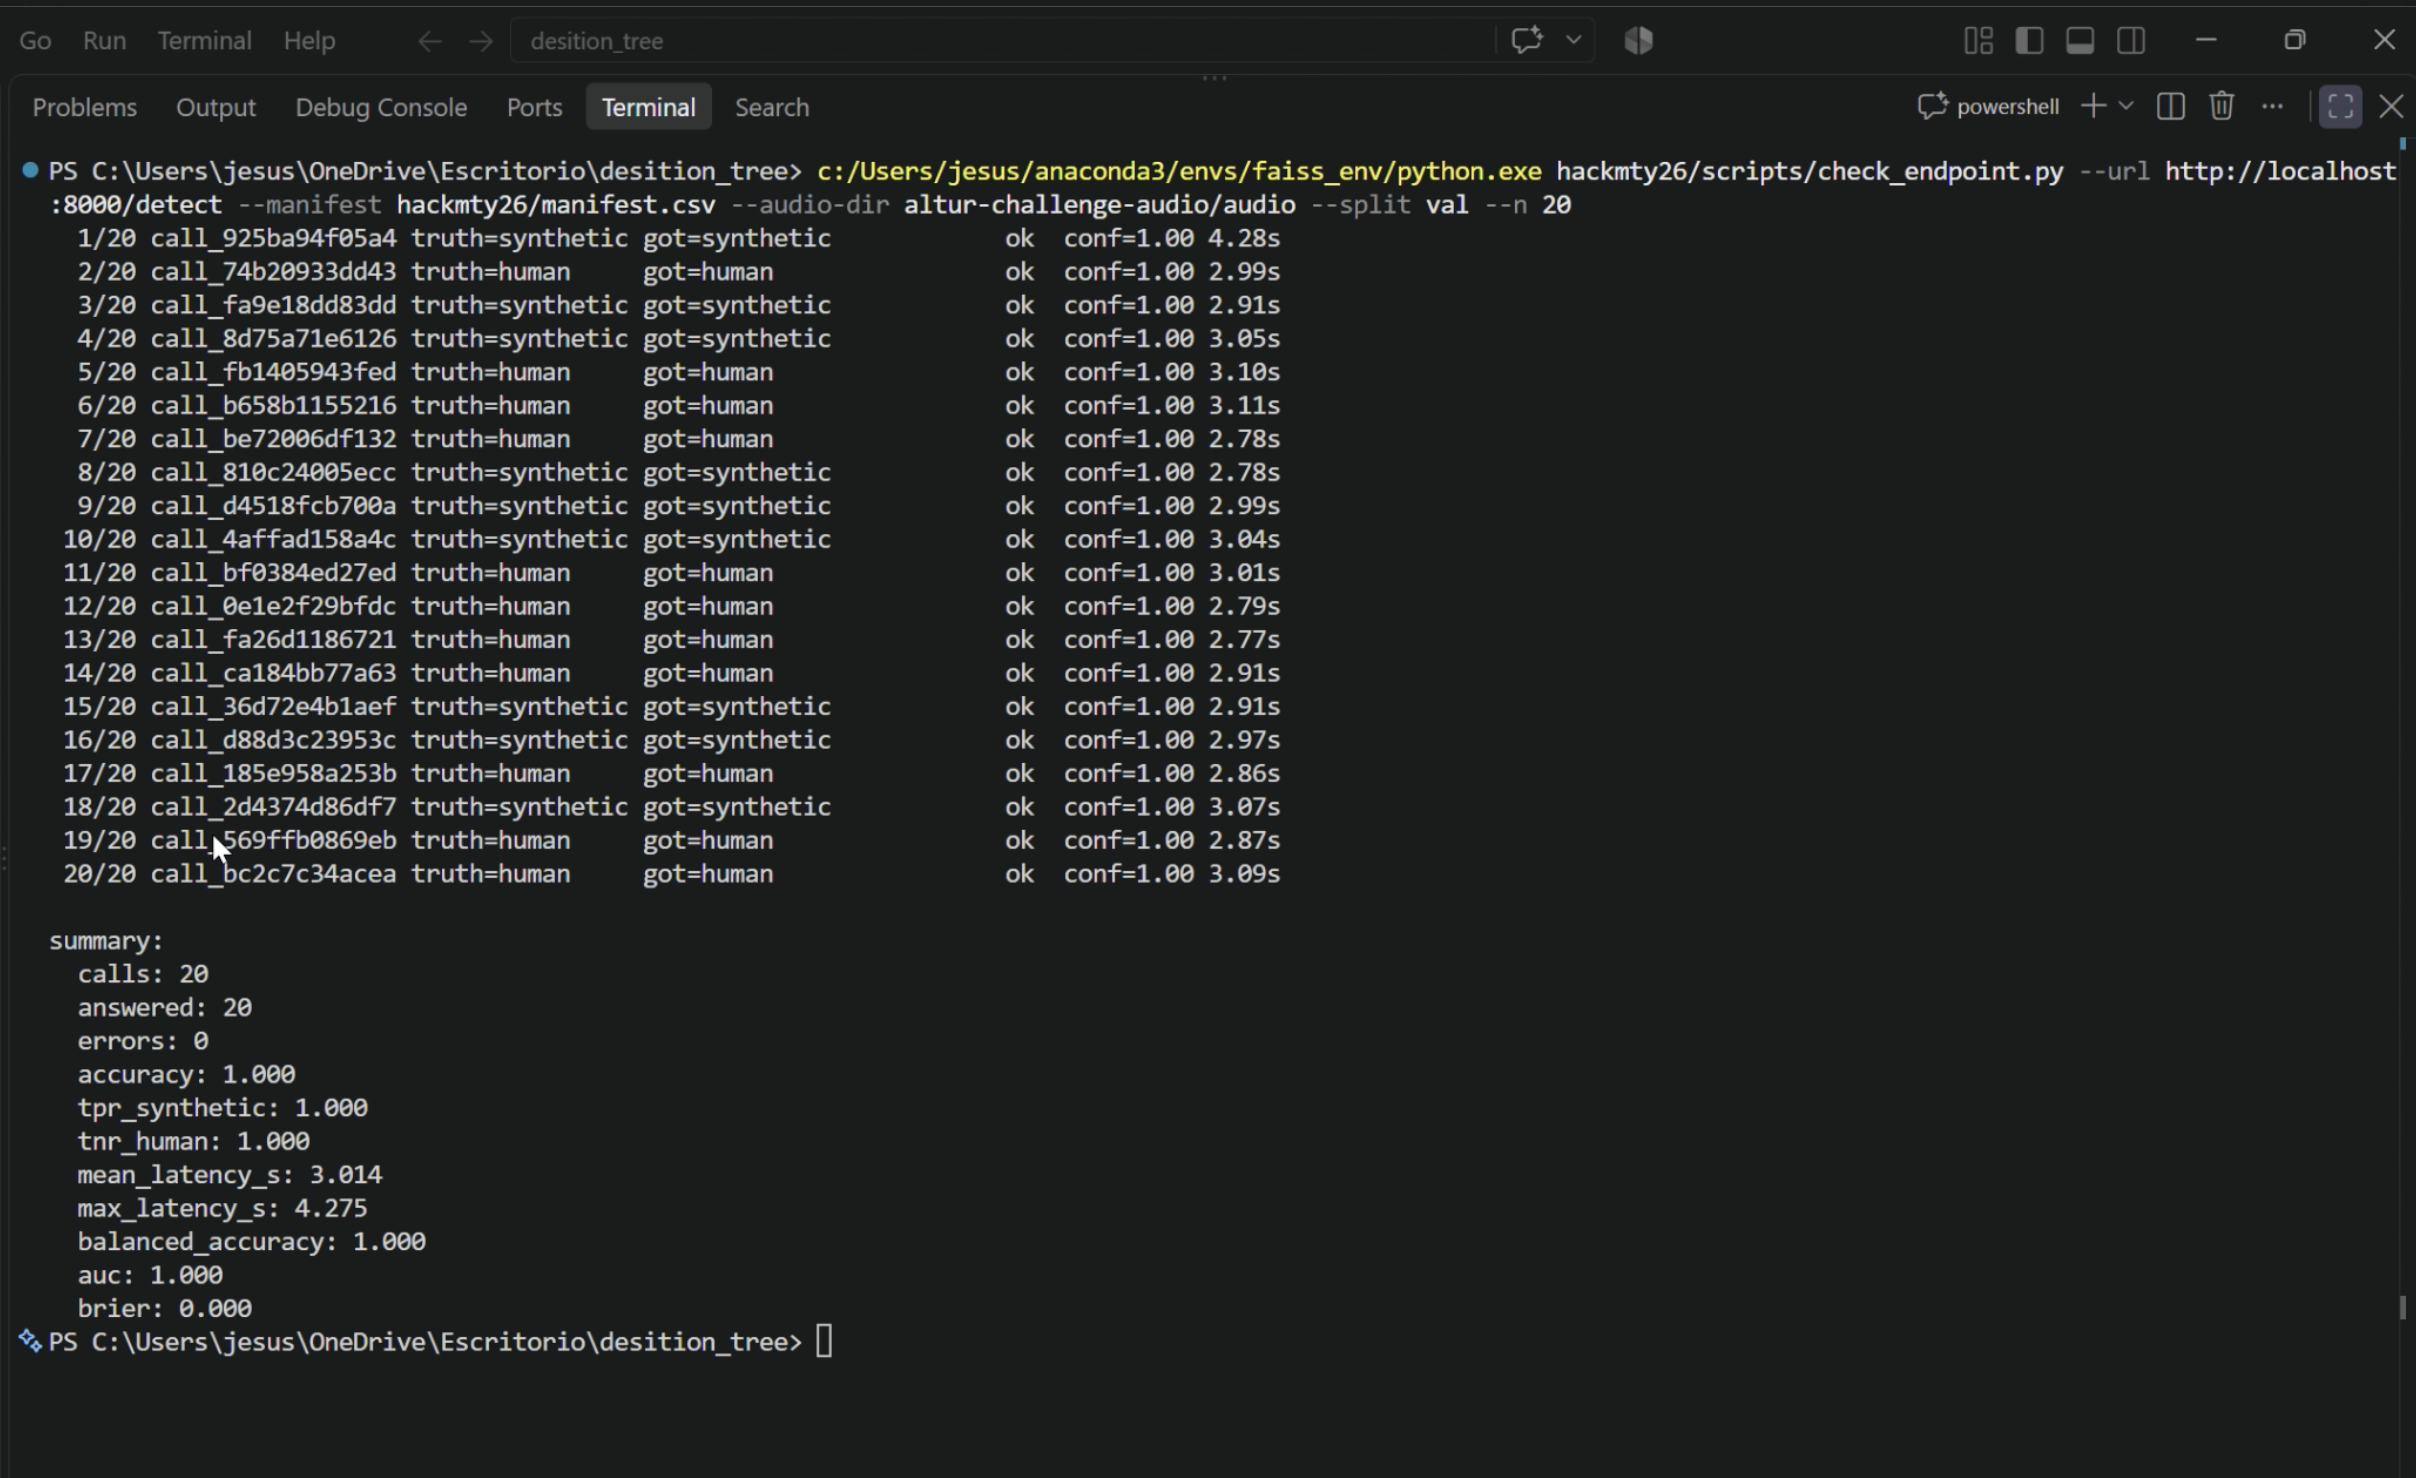
Lfant escucha una llamada bancaria y decide si quien está hablando es una persona real o una voz sintética o generada por una inteligencia artificial. No se fija solo en cómo suena la voz,: mira cómo se comporta la conversación completa, cuánto tarda el caller en responder, cómo puede solapar o interrumpir con el agente y la duración de los turnos. Esa información, junto con el análisis directo del audio, pasa por cuatro modelos distintos que dan su propio veredicto, y al final un Random Forest junta esos cuatro veredictos en una sola probabilidad. Todo corre detrás de un endpoint que responde en menos de 30 segundos por llamada.
How we built it
Empezamos separando el problema en dos partes que no tenían nada que ver entre sí: por un lado el comportamiento de la conversación (tiempos, pausas, turnos), por otro el audio en sí. Para lo primero entrenamos dos redes neuronales chicas, una que solo ve cinco números de tiempos de reacción y otra que ve 24 características de la llamada completa. Para el audio probamos dos enfoques: MiniAST, que convierte la voz en un espectrograma y lo pasa por un transformer pequeño, y un Wav2Vec2 preentrenado que afinamos con nuestros propios datos. Al final metimos las cuatro salidas a un Random Forest que programamos nosotros mismos en vez de usar scikit-learn directamente, y montamos todo detrás de una API con FastAPI.
Challenges we ran into
Teníamos experiencia previa desigual dentro del equipo, y aun así hubo cosas completamente nuevas para todos: procesamiento de audio, espectrogramas, cómo afinar un modelo como Wav2Vec2. Los primeros días se nos fueron entendiendo las tecnologías a punta de documentación y prueba y error, hasta que logramos armar el pipeline completo.
Ya con el sistema funcionando nos topamos con otro problema: teníamos overfitting en el modelo base de inteligencia artificial. Al entrenarlo y evaluarlo, sus predicciones salían demasiado optimistas. Tuvimos que ajustar el learning rate y el número de árboles, y con eso el modelo empezó a comportarse de forma mucho más consistente con lo que esperábamos.
Accomplishments that we're proud of
Nosotros somos estudiantes de primer semestre de la universidad y este es el sistema de inteligencia artificial más complejo que hemos construido. Logramos armar una red neuronal e implementar un Random Forest sin saber prácticamente nada de esto antes del hackathon, aprendiendo todo sobre la marcha. Salir de un fin de semana con algo que de verdad funciona, y no solo con conceptos a medias, es de lo que más orgullosos estamos.
What we learned
Aprendimos que un sistema inteligente de este tipo depende de que todas sus partes trabajen bien en conjunto, no solo de tener un buen modelo aislado, la complejidad real está en cómo se combinan todas las características. También nos dimos cuenta de lo pesados que son los datos de audio, trabajar con dimensiones tan grandes nos hizo entender que se necesita infraestructura considerable para procesar este tipo de información sin que todo se vuelva lentísimo. Y quizás lo más importante: hay que tener muchísimo cuidado con los datos, porque una pequeña variación en cómo los preparas puede cambiar por completo el resultado del modelo.
What's next for Lfant
Nos gustaría meter más variedad de audios al dataset, con distintos acentos y estilos de habla, para que el sistema generalice mejor fuera de las voces con las que entrenamos. También queremos optimizar la infraestructura para que el pipeline sea más rápido y ligero, sobre todo en la parte de procesamiento de audio, y probar el sistema contra técnicas de clonación de voz más nuevas.
Más allá del proyecto, queremos seguir compitiendo en más eventos de este estilo donde podamos desarrollar nuestras habilidades y trabajar como equipo.
Built With
- argparse
- base64
- collections
- contextlib
- csv
- dataclasses
- functools
- http
- importlib
- io
- json
- math
- os
- pathlib
- random
- shutil
- struct
- sys
- time
- typing
- urllib
- warnings
- wave


Log in or sign up for Devpost to join the conversation.