Inspirasi
Meeting online sudah jadi kebutuhan sehari-hari, tapi bagi teman Tuli dan tunarungu pengguna Bahasa Isyarat Indonesia (BISINDO), berpartisipasi setara masih sulit. Penerjemah manusia tidak tersedia setiap saat, dan hampir tidak ada alat bantu yang murah dan realtime untuk komunikasi antara peserta dengar dan tunarungu di video call.
Kami membuat IsyaratKu Cam untuk menutup celah itu dengan sesuatu yang sudah dimiliki setiap peserta: webcam. Targetnya adalah alat yang benar-benar bekerja dari ujung ke ujung, bukan demo palsu.
Apa yang dilakukan
IsyaratKu Cam adalah aplikasi desktop Windows yang mendeteksi isyarat BISINDO dari webcam secara realtime, lalu mengubahnya menjadi teks dan suara langsung di dalam Zoom atau Google Meet.
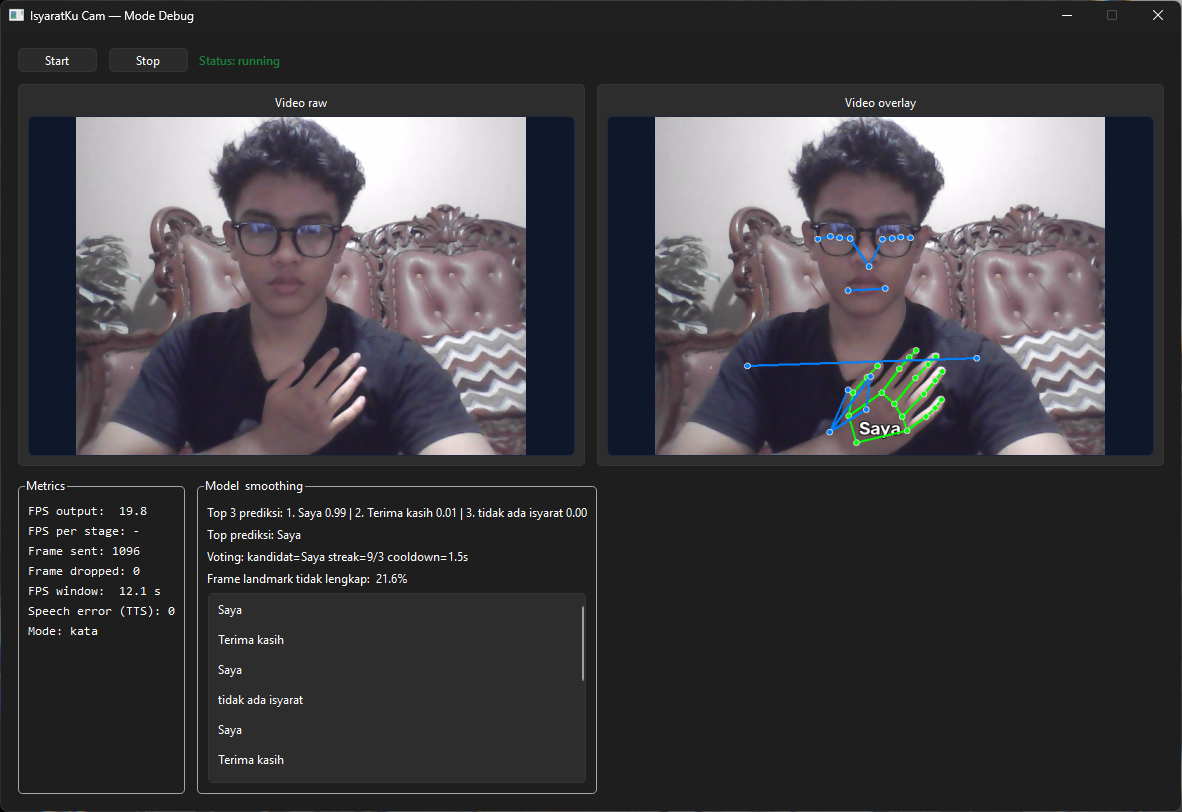
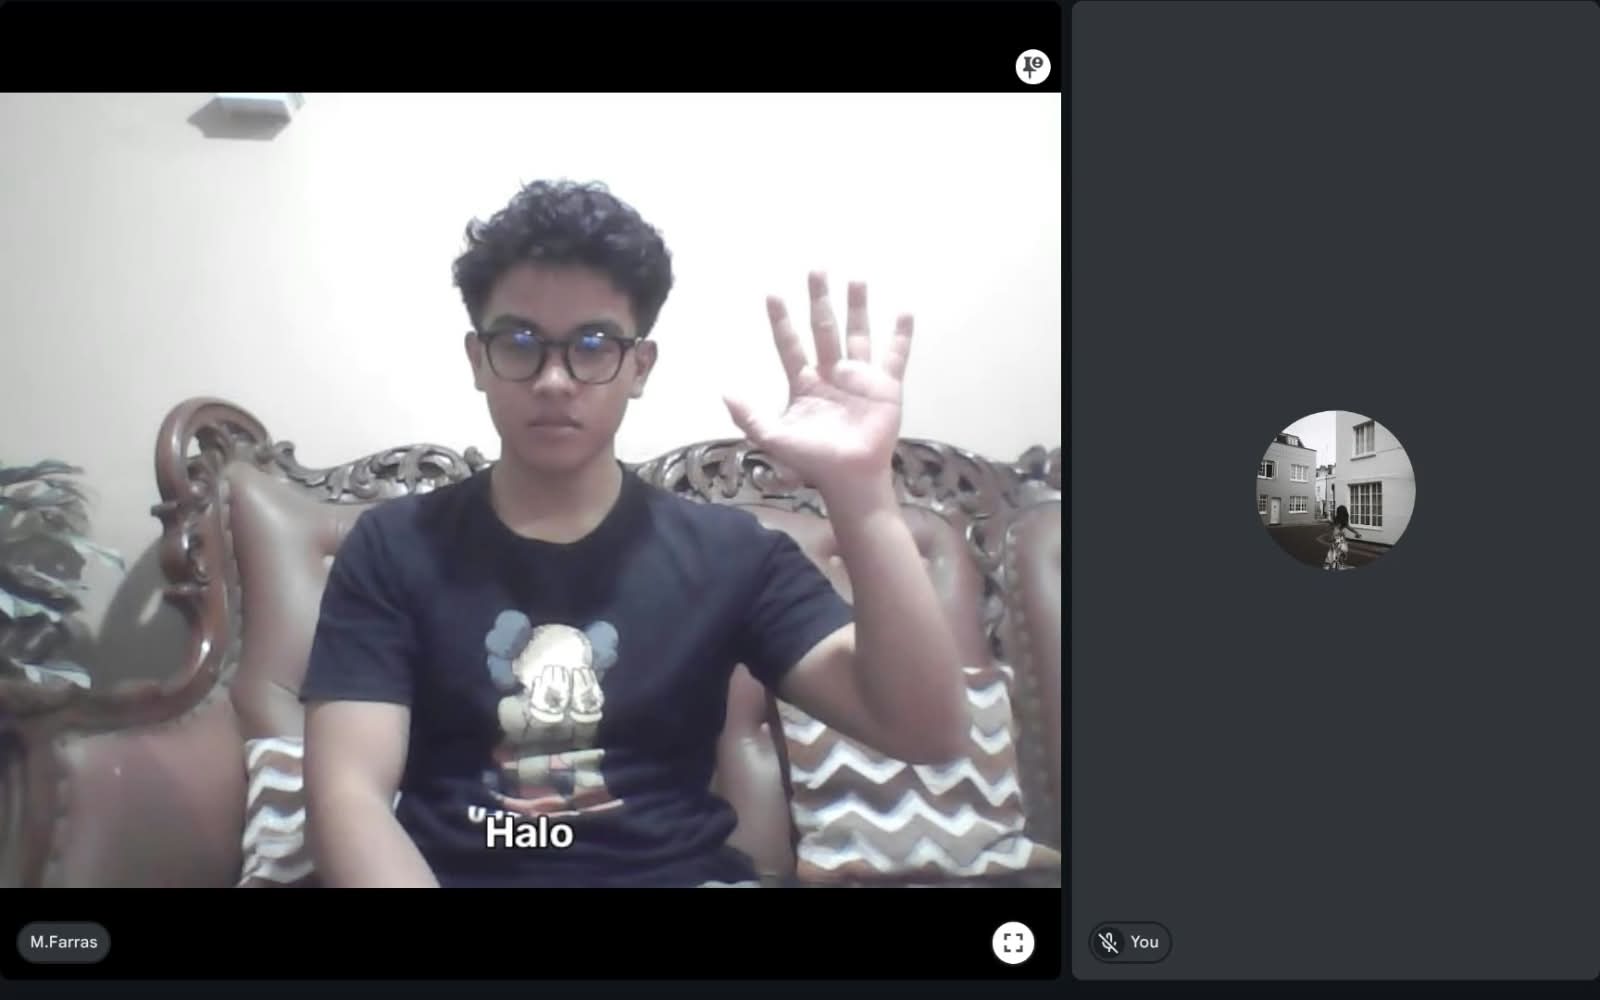
- Isyarat ke teks: kata hasil prediksi tampil sebagai overlay di atas video.
- Isyarat ke suara: kata yang sama diucapkan oleh TTS offline dan dialirkan ke aplikasi meeting lewat virtual audio cable (VB-Cable).
- Jalan di dalam meeting: aplikasi menjadi sumber virtual camera (OBS Virtual Camera), sehingga peserta lain langsung melihat video berikut teksnya tanpa perlu memasang apa pun.
- Dua mode, satu pipeline:
- Mode ready-to-use: hanya tombol Start dan Stop. Saat Start, aplikasi otomatis memeriksa kamera, OBS Virtual Camera, dan VB-Cable, lalu menampilkan pesan jelas jika ada yang belum terpasang.
- Mode debug: satu dasbor berisi video raw dan overlay, FPS, frame terkirim dan terbuang, Top 3 prediksi beserta confidence, status voting dan cooldown, persentase frame dengan landmark tidak lengkap, serta log kata yang sudah diucapkan.
Scope sengaja dibatasi: isyarat kata (isolated sign) lebih dulu, lalu angka, lalu huruf jika waktu cukup. Continuous signing dan speech-to-sign belum dikerjakan.
Cara kami membangunnya
Pipeline berjalan satu arah dan setiap tahap bisa diuji terpisah:
kamera -> landmark MediaPipe -> normalisasi + fitur gerak
  -> windowing 30 frame / stride 5 -> prediksi per window (+ kelas "tidak ada isyarat")
  -> gating -> smoothing (threshold, voting, cooldown)
  -> overlay teks -> virtual camera
  -> kata -> cache audio -> TTS -> audio meeting
- Landmark: MediaPipe Hands dan Pose mengeluarkan landmark tangan dan tubuh.
- Normalisasi: landmark dinormalisasi terhadap titik acuan (pergelangan atau tengah bahu) dan diskala dengan lebar bahu. Fitur gerak berupa selisih antarframe ditambahkan.
- Landmark hilang: memakai kebijakan zero-fill dengan flag kehadiran per tangan.
- Windowing: sliding window 30 frame dengan stride 5, jadi inference berjalan beberapa kali per detik sementara video tetap lancar.
- Smoothing: prediksi mentah tidak pernah langsung diucapkan. Output harus lolos confidence threshold, voting antarprediksi berurutan, dan cooldown agar satu isyarat tidak terucap berulang. Kelas "tidak ada isyarat" memastikan tanpa isyarat tidak ada teks atau suara.
- Threading: tiga pekerja (capture + landmark, inference, output) dihubungkan queue berbatas, ditambah thread TTS tersendiri.
Arsitektur: kode dipisah menjadi core/ (logika murni, tanpa GUI, hardware, atau framework model), adapters/ (kamera, MediaPipe, virtual camera, TTS, classifier), dan ui/. Dependensi hanya satu arah: ui -> core <- adapters. Setiap adapter punya versi fake sehingga seluruh pipeline bisa diuji tanpa kamera dan perangkat audio. Semua parameter tuning (threshold, panjang window, stride, cooldown, ukuran queue) ada di satu berkas configs/app.toml, tanpa angka ajaib di kode.
Distribusi: aplikasi dibuild menjadi EXE lewat PyInstaller dalam dua varian, isyaratku-ready dan isyaratku-debug.
Data dan model: [TODO: sebutkan dataset yang dipakai, jumlah kelas, jumlah sample, dan jenis model setelah diinspeksi dan diputuskan].
Tantangan
- TTS yang diam-diam salah perangkat. Endpoint capture bernama mirip ("CABLE Output", 2 in / 0 out) ikut cocok saat pencarian nama, sehingga audio jatuh ke speaker lokal dan aplikasi meeting hanya menerima keheningan. Solusinya, pencocokan device kini mensyaratkan nama cocok dan
max_output_channels > 0, dan jika tidak ada yang cocok aplikasi gagal dengan error jelas, bukan diam-diam memutar di speaker lokal. - Kamera yang gagal sesaat.
read()yang mengembalikanNonekembali dalam sekitar 0,1 ms, jadi menghitung jumlah gagal tidak masuk akal. Kami memakai batas waktu toleransi dan polling 20 Hz agar loop tidak berputar secepat CPU, sambil tetap mengantar frame segera setelah kamera pulih. - Landmark yang hilang sebagian saat tangan keluar frame atau tertutup, ditangani lewat zero-fill dengan flag kehadiran, dengan jalur upgrade ke interpolasi carry-forward.
- Menjaga video tetap lancar sambil menjalankan MediaPipe dan model: queue berbatas, pekerja output tidak menunggu inference, dan UI hanya membaca snapshot terbaru.
- Debugging UI yang membeku: log harian per berkas dengan tahap terakhir yang berjalan, sehingga penyebab bisa dilacak dari baris terakhir.
- Perubahan API: MediaPipe Tasks API tidak punya padanan
model_complexity, jadi key itu dipertahankan di konfigurasi agar kontrak lama tidak putus.
Pencapaian yang kami banggakan
- Pipeline penuh bisa dijalankan dan diuji tanpa hardware lewat fake adapter, termasuk smoke run headless.
- Pemeriksaan otomatis saat Start yang memberi pesan jelas jika OBS Virtual Camera atau VB-Cable belum terpasang, jadi pengguna tidak perlu langkah manual tersembunyi.
- Satu codebase untuk dua mode: mode debug hanya mengamati pipeline yang sama, tanpa logika terpisah.
- Hasil terukur: [TODO: akurasi, FPS output, dan latensi prediksi setelah diukur di mode ready-to-use. Target: video 25 sampai 30 FPS dan latensi 0,3 sampai 0,5 detik].
Yang kami pelajari
- Pada sistem realtime, menahan output (voting dan cooldown) sama pentingnya dengan akurasi model, karena prediksi mentah yang langsung diucapkan terasa kacau.
- Fake adapter membuat bug di core terlihat sebelum hardware tersedia, dan membuat test tetap bisa dijalankan di komputer lain.
- Integrasi dengan perangkat nyata (virtual camera, audio cable) punya banyak kegagalan senyap, jadi pemeriksaan dan pesan error yang jelas harus jadi bagian produk.
- Mengukur performa harus dilakukan di mode ready-to-use, karena mode debug menambah beban render.
Langkah selanjutnya
- Menyelesaikan dan menstabilkan isyarat kata, lalu menambah isyarat angka, kemudian huruf.
- [TODO: perluasan kosakata dan pengujian bersama pengguna BISINDO, jika memang direncanakan].
- Pengukuran performa dan akurasi yang lebih lengkap di berbagai webcam dan komputer.

Log in or sign up for Devpost to join the conversation.