-
-
captaloxsubs
💡 Inspiración Conferencias como Nerdearla reúnen a ingenieros, contribuidores de código abierto y líderes tecnológicos de todo el mundo. Sin embargo, las charlas técnicas en vivo presentan una barrera importante de accesibilidad:
Fricción del idioma: Quienes no son nativos suelen tener dificultades para seguir un discurso técnico rápido, lleno de jerga, acrónimos y nombres de frameworks. Accesibilidad: Las personas con discapacidad auditiva quedan frecuentemente excluidas cuando no hay taquígrafos humanos disponibles por el alto costo. La trampa de esperar la oración completa: Los sistemas convencionales de subtítulos con IA esperan a que el orador termine una frase y haga una pausa para enviar todo el bloque a una API de traducción. Eso genera un retraso de 5 a 15 segundos que rompe la inmersión y desconecta a la audiencia de las diapositivas y del orador.
Nuestra inspiración fue simple pero ambiciosa: ¿y si pudiéramos entregar traducción en vivo, palabra por palabra, con una latencia casi imperceptible, tanto en el proyector del escenario como en los celulares de los asistentes, y todo con un presupuesto de $0? Esa visión se convirtió en CaptaloxSubs.
⚡ Qué hace CaptaloxSubs es una plataforma completa de subtitulado y traducción en vivo:
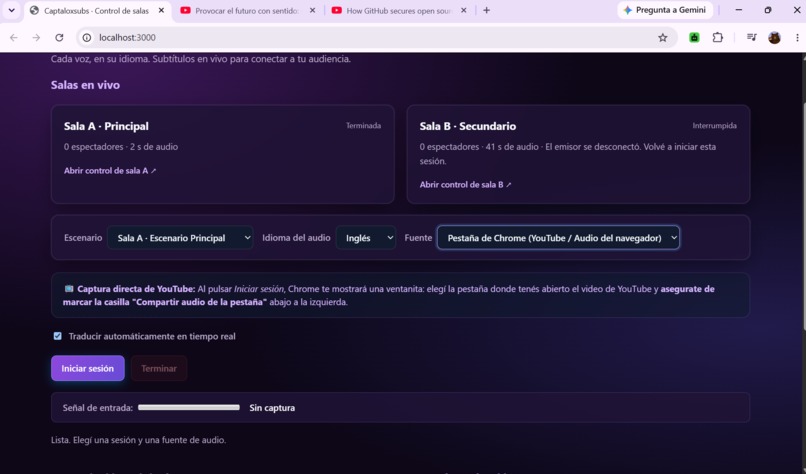
Streaming palabra por palabra: En lugar de esperar párrafos completos, los subtítulos se muestran token a token en tiempo real (aprox. 200-300 ms por ráfaga). Mientras el orador habla en inglés, los subtítulos en español aparecen de forma sincrónica en pantalla. Soporte bidireccional completo: Inglés ⟷ Español. El presentador puede hablar en inglés (traduciendo al español) o en español (traduciendo al inglés). Captura de audio flexible: Captura directa de pestaña de Chrome (YouTube / streaming) mediante getDisplayMedia, sin cables virtuales ni hardware extra. Micrófono o entrada de línea de la placa de sonido. Reproductor de archivos WAV a velocidad 1x para ensayos deterministas.
Arquitectura de dos puertos: Puerto 3000 (Operador / Stage Manager): panel de control completo, selección de sesión, monitoreo de audio y estadísticas. Puerto 3001 (Visor de audiencia): vista de solo lectura, aislada de rutas sensibles y configuraciones administrativas.
Acceso móvil instantáneo con QR local: El panel del presentador genera un código QR con la IP local de la red del evento. Los asistentes solo tienen que apuntar la cámara del celular y ver los subtítulos sin instalar ninguna app. Modos de auditorio y transmisión: Modo escenario / pantalla completa: tipografía de alto contraste y escalable para pantallas LED grandes. Overlay para OBS / vMix: fondo transparente (/viewer?session=A&overlay=1) para Twitch, YouTube y eventos híbridos. Exportación instantánea: descarga de la transcripción completa en .txt y subtítulos sincronizados en .srt.
🛠️ Cómo lo construimos CaptaloxSubs se diseñó desde cero con un stack limpio y con pocas dependencias, optimizado para alto rendimiento y streaming sin asignaciones innecesarias: textCopiarCopiado┌──────────────────────┐ PCM 16-bit 16 kHz ┌─────────────────────────┐ │ Chrome Tab / Mic / │ ──────────────────────────────> │ AudioWorklet personalizado│ │ Stream de audio WAV │ (paquetes de 100 ms) │ (pcm-worklet.js) │ └──────────────────────┘ └───────────┬─────────────┘ │ WebSocket ▼ ┌──────────────────────┐ WebSocket de baja latencia ┌─────────────────────────┐ │ Google Gemini Live │ <═══════════════════════════════> │ Servidor Node.js │ │ Modelo Live Translate│ Tokens bidireccionales │ (server.js & room.js) │ └──────────────────────┘ └───────────┬─────────────┘ │ Pub/Sub local ▼ ┌───────────────────────────┐ │ Pantallas del escenario │ │ y audiencias │ │ (localhost:3000 / 3001) │ └───────────────────────────┘
Procesamiento de señal en el frontend (DSP)Creamos un AudioWorkletProcessor que corre en hilos dedicados de audio. Reduce y normaliza el audio entrante a PCM lineal firmado de 16 bits little-endian a 16.000 Hz, y lo envía en buffers de 100 ms (1.600 muestras = 3.200 bytes). Esto elimina los 200-400 ms de latencia típicos de los filtros estándar de WebRTC. Motor backendServidor HTTP y WebSocket nativo de Node.js (ws). Gestores de salas con estado que aíslan escenarios concurrentes (A, B, C…) sin que se mezcle el contenido. Un acumulador de oraciones en streaming muestra la cláusula actual en vivo y confirma las oraciones completas al detectar puntuación ([.!?]). Integración con Google Gemini LiveConexión directa a la API Multimodal Live de Gemini mediante WebSockets bidireccionales persistentes. El modelo recibe el stream continuo de PCM y devuelve tokens de outputTranscription.text de forma incremental a medida que reconoce el habla.
🧮 Desafíos que enfrentamos y la matemática de la latencia
- Romper la barrera de latencia por lotes de oraciones En las arquitecturas tradicionales basadas en REST, la latencia total está limitada por la duración de la oración: $$T_{\text{latencia}} = T_{\text{fragmento de habla}} + T_{\text{silencio VAD}} + T_{\text{RTT de red}} + T_{\text{generación LLM}}$$ Cuando alguien dice una frase de 15 palabras: $$T_{\text{fragmento}} \approx 4{,}5\,\text{s},\quad T_{\text{silencio}} \approx 1{,}5\,\text{s},\quad T_{\text{RTT}} \approx 0{,}3\,\text{s},\quad T_{\text{LLM}} \approx 1{,}5\,\text{s} \quad\Rightarrow\quad T_{\text{latencia}} \approx 7{,}8\,\text{s}$$ Un retraso de casi 8 segundos es inutilizable en una conferencia en vivo. Al pasar a streaming nativo de audio a texto, los tokens se generan con solapamiento de pipeline: $$T_{\text{latencia de streaming}} \approx \tau_{\text{AudioWorklet}} + \tau_{\text{modelo acústico}} \approx 100\,\text{ms} + 600\,\text{ms} \approx 700\,\text{ms}$$
- Ajuste de umbrales de detección de actividad de voz (VAD) Por defecto, los modelos conversacionales esperan $\tau_{\text{default}} = 1500\,\text{ms}$ de silencio antes de cerrar un turno. Configurando: $$\tau_{\text{silencio}} = 100\,\text{ms},\quad \tau_{\text{prefix padding}} = 50\,\text{ms}$$ logramos que Gemini emita hipótesis fonéticas intermedias de inmediato, reduciendo la latencia de detección de turno en un 93 %.
- Evitar el lag de DSP del navegador Los navegadores Chromium aplican de forma agresiva cancelación de eco (AEC), reducción de ruido (NS) y control automático de ganancia (AGC). Estos filtros agregan 200-300 ms de latencia oculta. Forzando: JavaScriptCopiarCopiadonew AudioContext({ sampleRate: 16000, latencyHint: 'interactive' }) y desactivando noiseSuppression en capturas de línea limpia, logramos que Windows WASAPI use buffers de hardware de menos de 10 ms.
- Superar congelamientos de CPU y límites de memoria Los primeros intentos con modelos ONNX locales saturaban el event loop de Node al 100 % de CPU durante más de 15 segundos por traducción y colapsaban las sesiones. Desacoplar el pipeline y usar la inferencia en la nube de Gemini resolvió el problema, manteniendo el uso de CPU del servidor por debajo del 1,5 % incluso con varias salas concurrentes.
🏆 Logros de los que estamos orgullosos
Streaming real palabra por palabra: Escuchar una palabra en inglés y ver su traducción al español aparecer en la pantalla del auditorio en menos de un segundo se siente mágico. 38/38 tests unitarios pasando en ≈ 1,4 s: Cobertura completa de parsing de WAV, cuantización del AudioWorklet, traducción bidireccional, protocolos simulados de Gemini, aislamiento de salas y concurrencia. Costo cero ($0): Funciona completamente dentro del Free Tier de Google AI Studio, sin gastos recurrentes de infraestructura. Tolerancia a fallos sólida: Las salas aisladas garantizan que un problema de red o desconexión en la Sala B nunca interrumpa la Sala A.
📚 Qué aprendimos
Cómo implementar y afinar WebSockets bidireccionales de baja latencia con los modelos Gemini Live más recientes. Los detalles del Web Audio API y los AudioWorklets, incluyendo transferencia de memoria con desprendimiento zero-copy de ArrayBuffers. La diferencia crítica entre la traducción por oraciones completas y el streaming incremental de tokens acústicos en entornos de producción en vivo.
🚀 Próximos pasos para CaptaloxSubs
Fan-out multi-idioma: Transmitir una charla en inglés a español, portugués, francés y alemán al mismo tiempo mediante workers de WebSocket en paralelo. Diarización de hablantes: Colorear los subtítulos según la detección de múltiples oradores en mesas redondas y paneles. Relay por Data Channel de WebRTC: Escalar el servidor de distribución de audiencia a más de 10.000 asistentes móviles concurrentes mediante relés mesh asistidos por pares. Agregar al chatProfundiza en el AudioWorkletExplora WebRTC Data Channels
Built With
- css
- html
- javascript
- powershell
- python

Log in or sign up for Devpost to join the conversation.