Inspiration
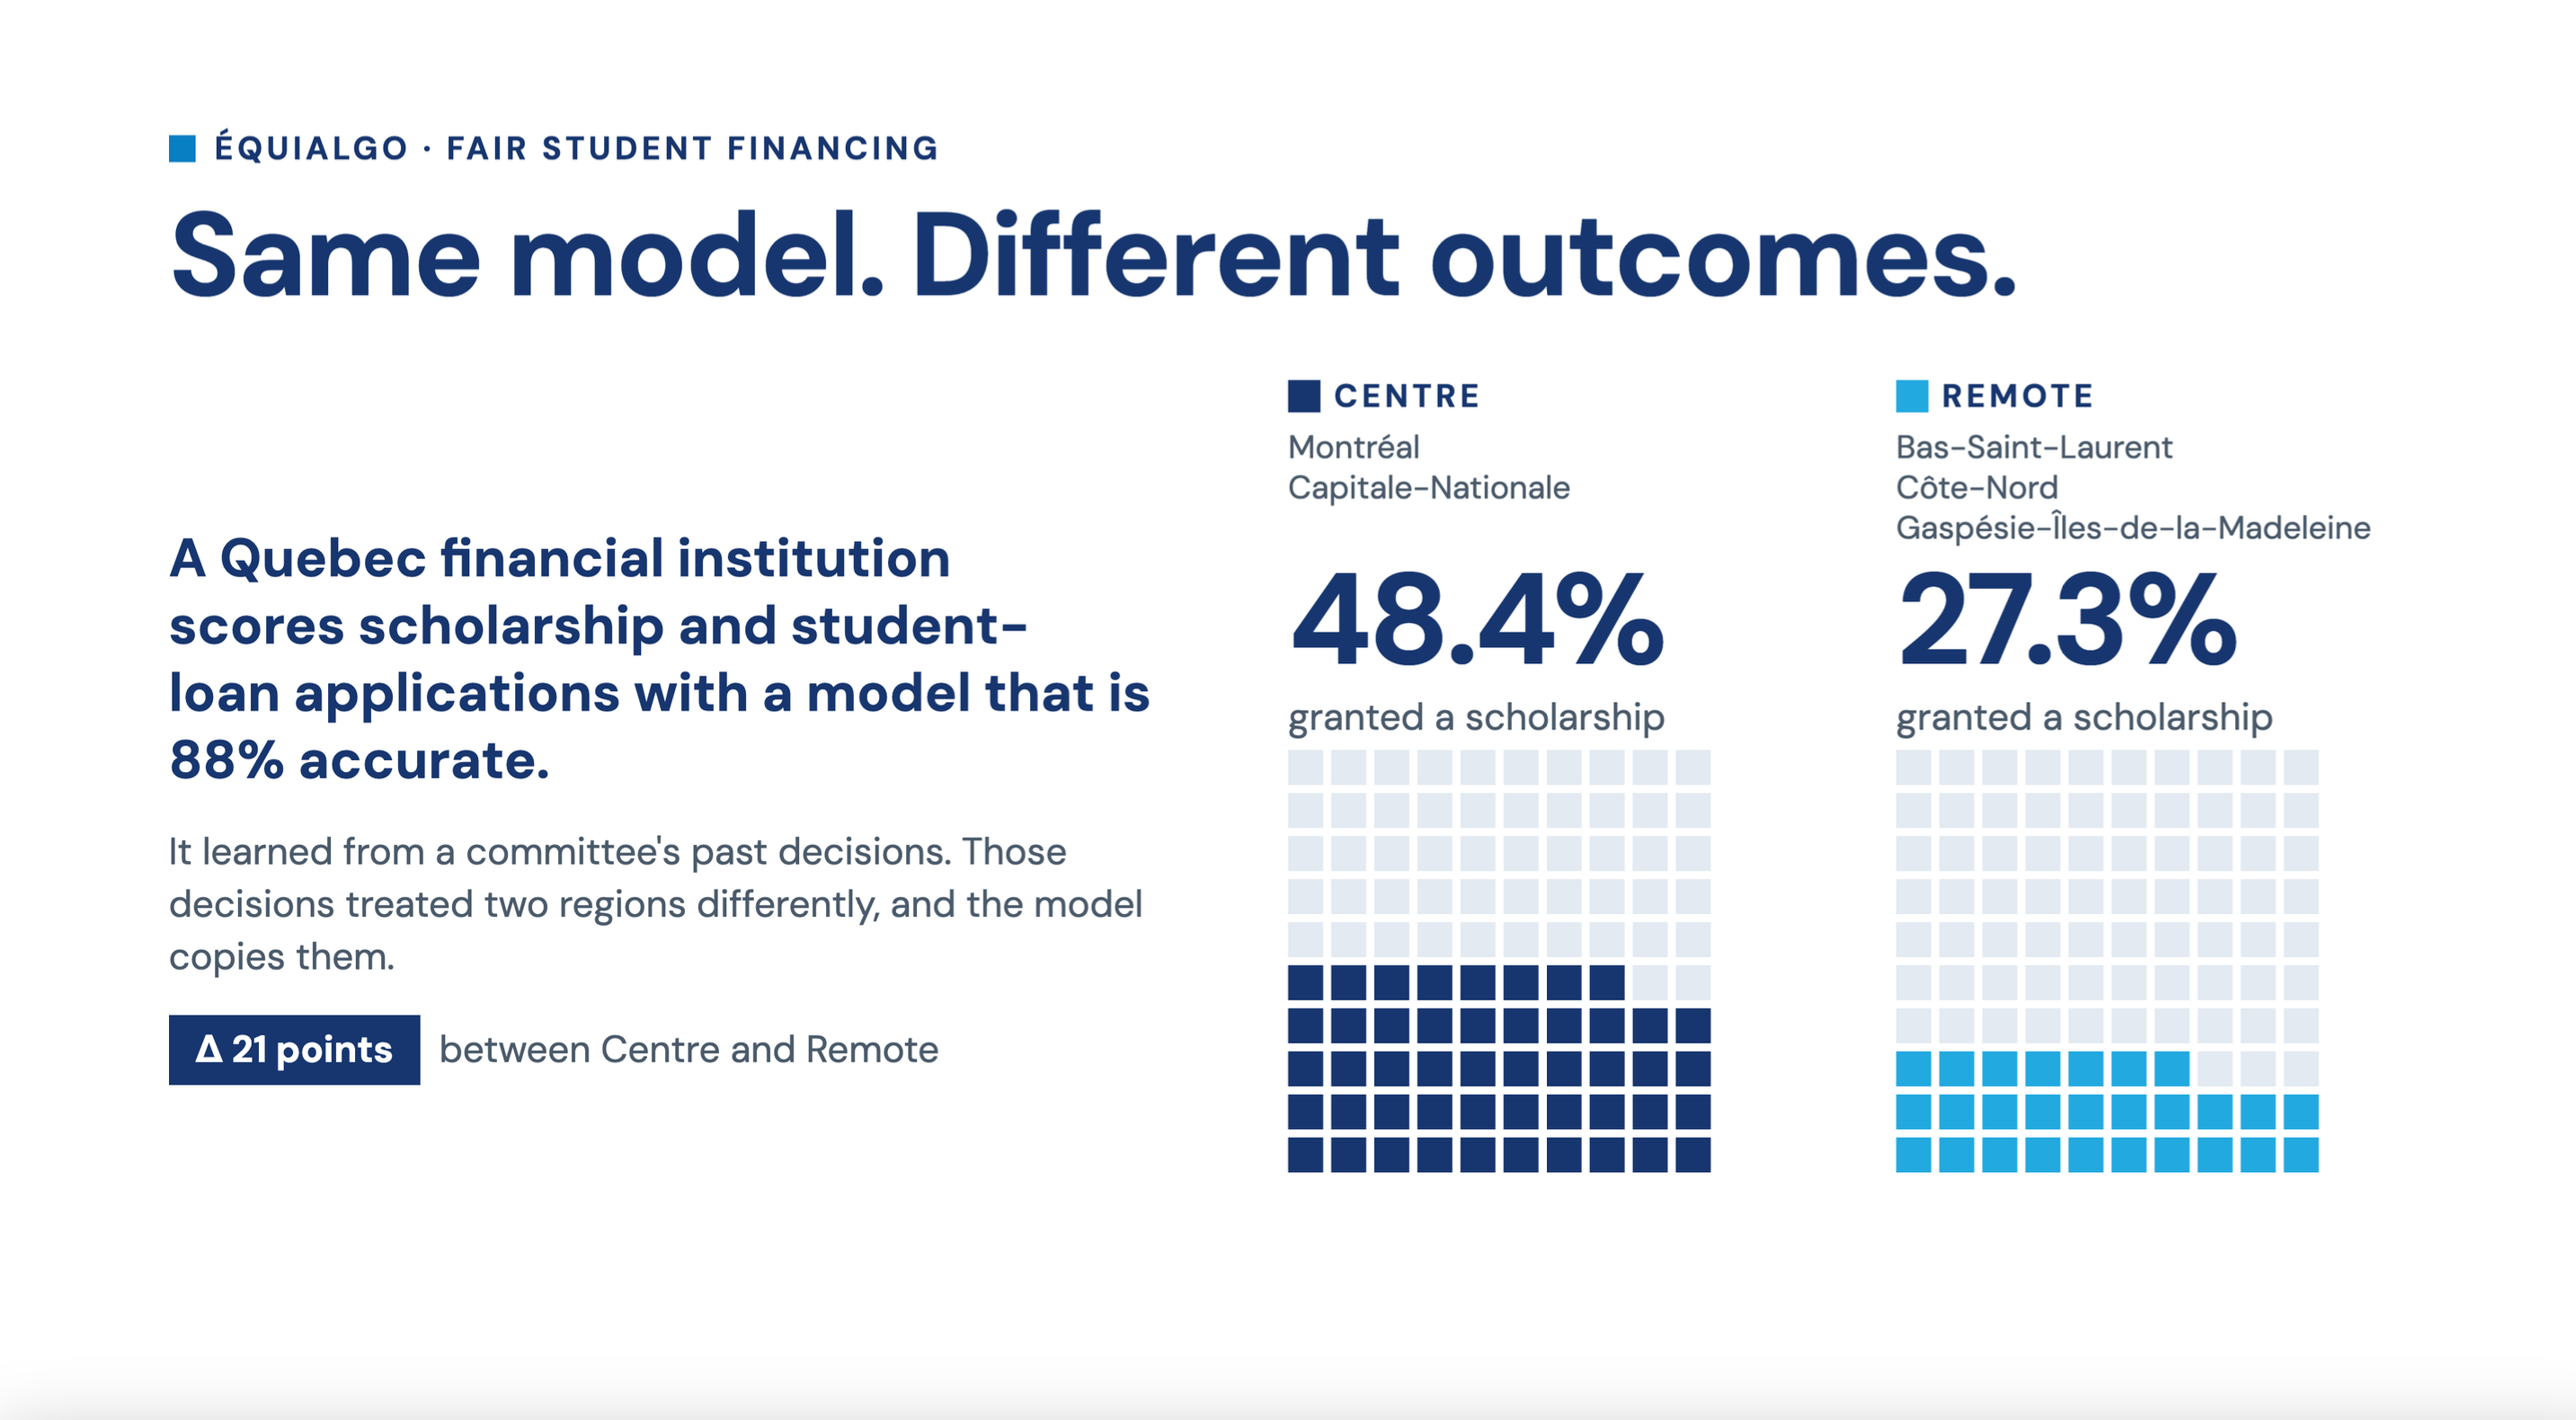
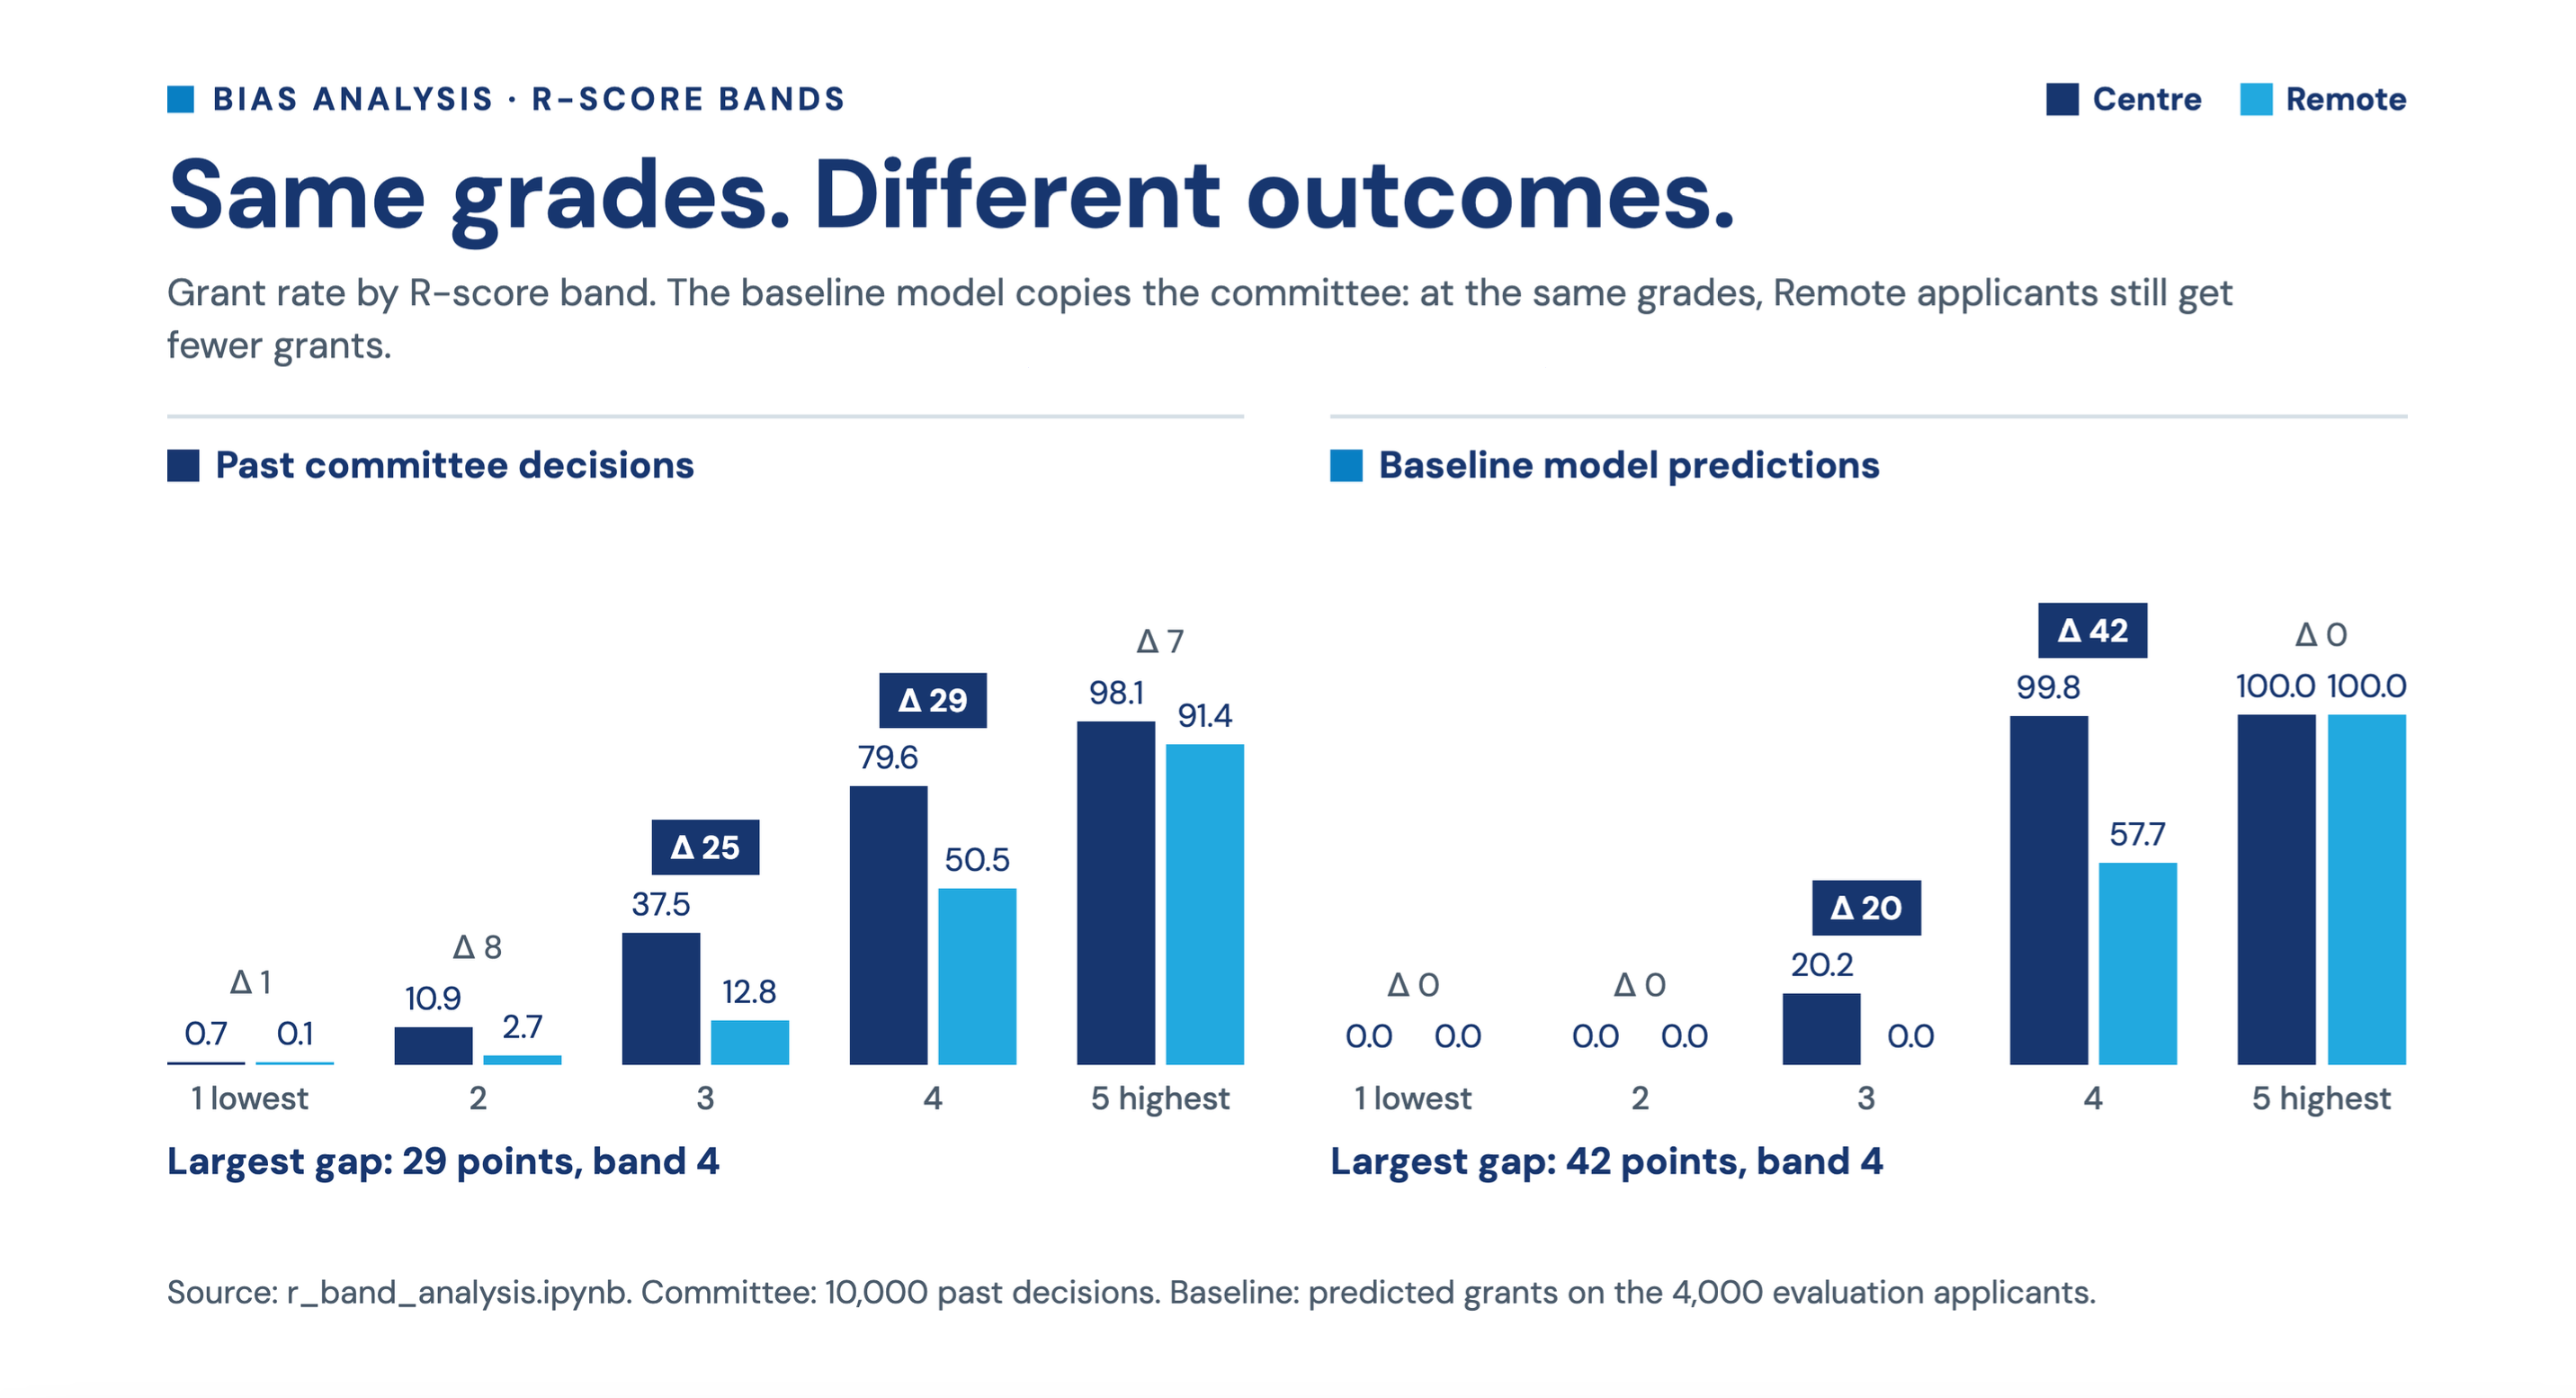
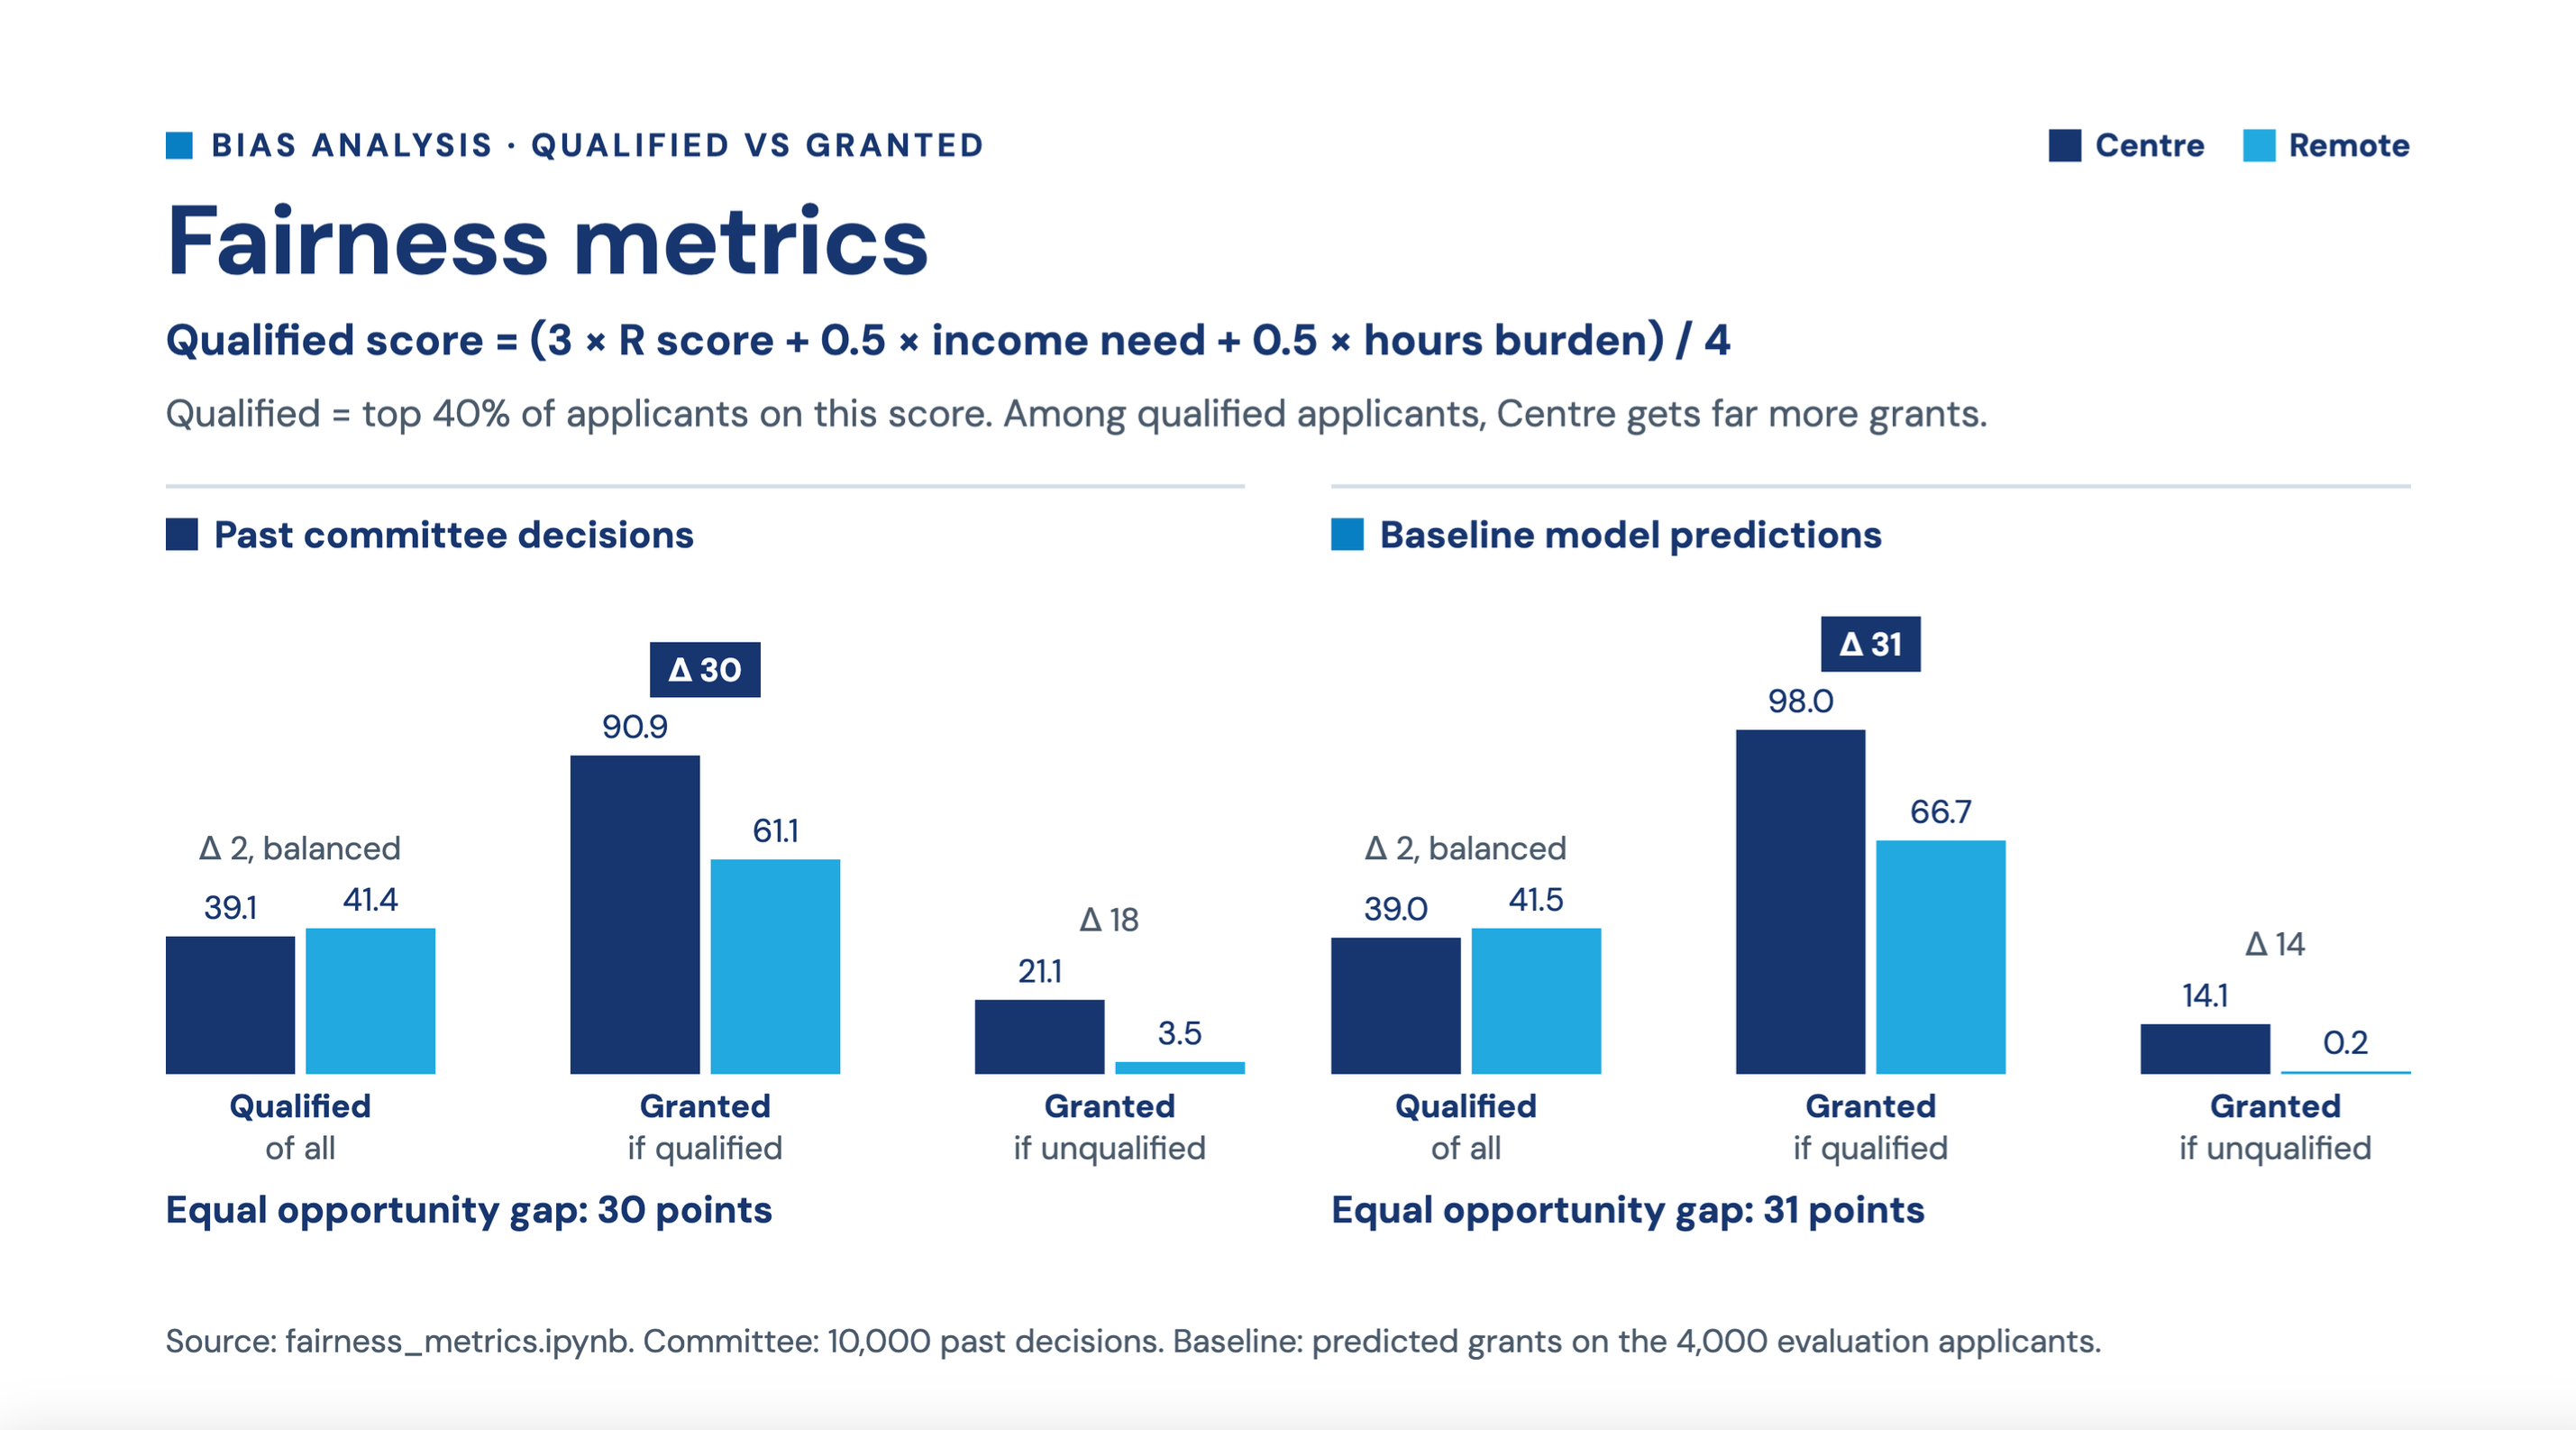
Les modèles de financement étudiant peuvent sembler précis tout en reproduisant des schémas inéquitables issus des décisions sur lesquelles ils ont été entraînés. D’après nos données, les décisions historiques des comités ont accordé un financement à 48,4 % des demandeurs des régions du Centre, mais à seulement 27,3 % des demandeurs des régions éloignées. Même parmi les demandeurs présentant des résultats scolaires similaires, d’importants écarts régionaux subsistaient.
Cela nous a amenés à nous poser une question simple : pouvons-nous préserver les renseignements prédictifs utiles tout en rendant les décisions de financement plus équitables, explicables et mesurables?
ÉquiAlgo a été conçu autour de l’idée qu’une IA responsable ne doit pas se contenter de supprimer une variable protégée. Les biais doivent être détectés, expliqués, atténués et surveillés en continu.
Fonctionnement
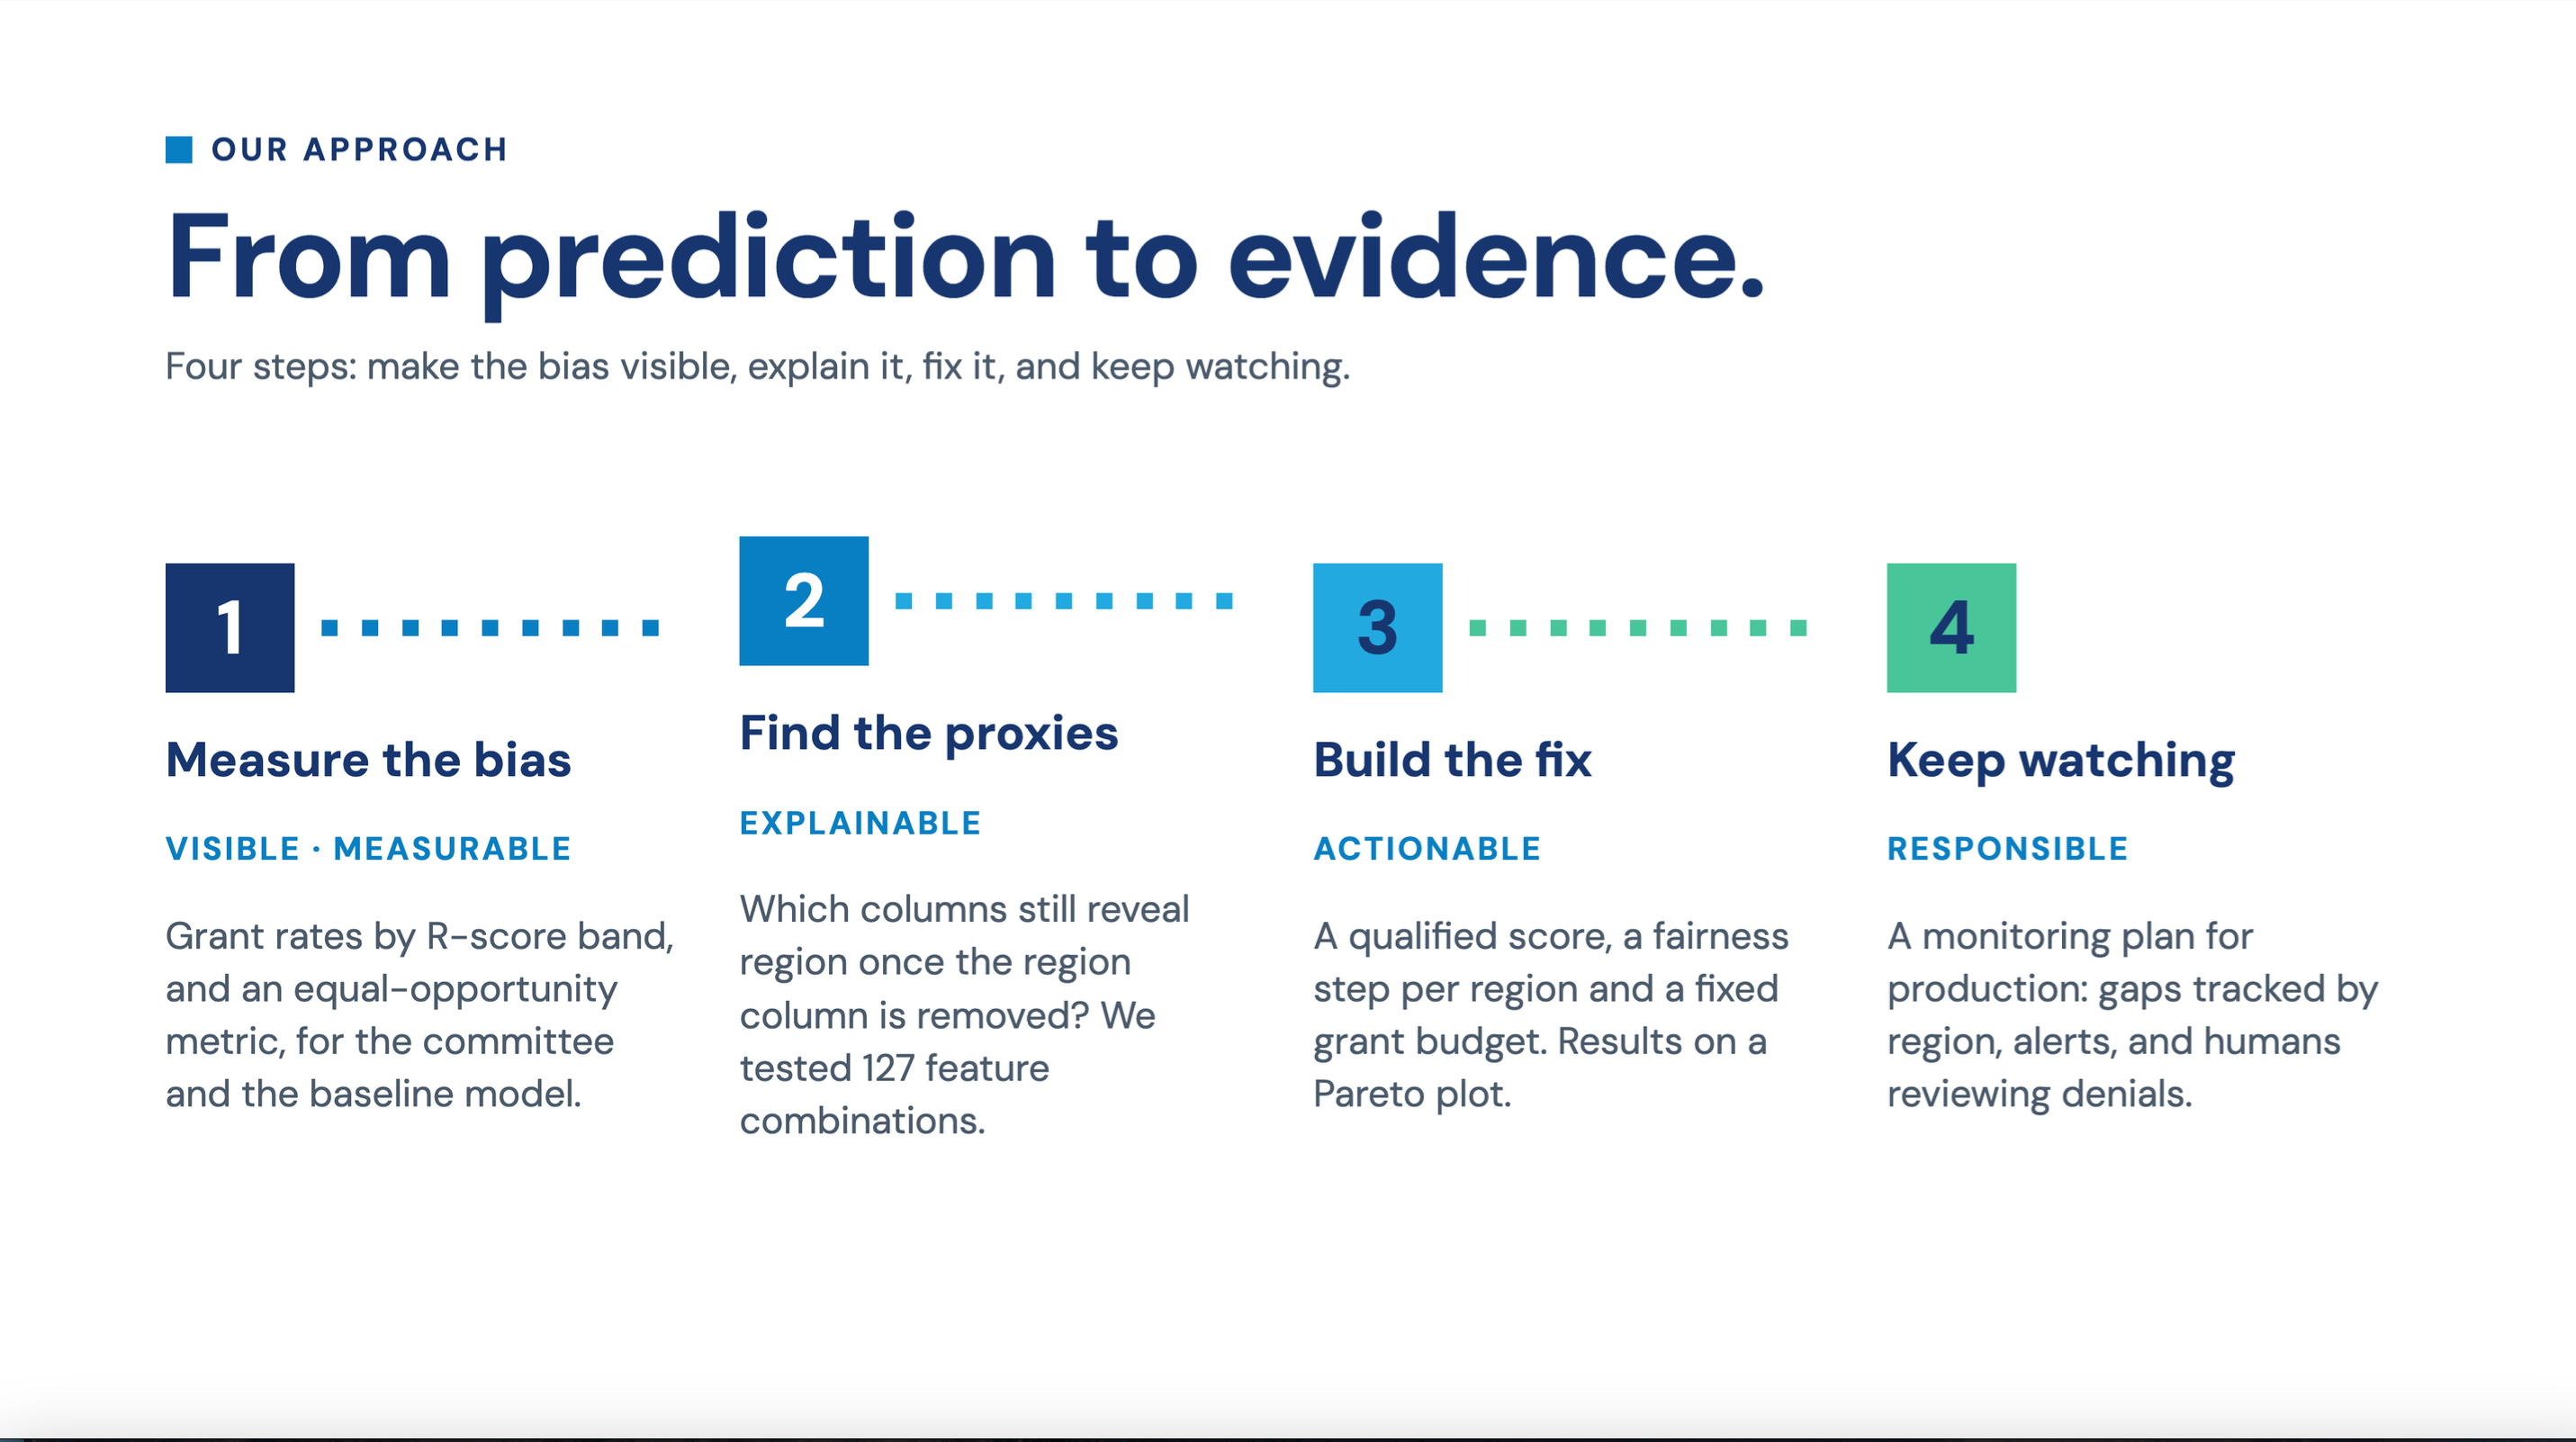
ÉquiAlgo est un processus décisionnel tenant compte de l’équité pour le financement des études.
Il analyse l’historique des décisions de financement afin d’identifier les disparités entre les demandeurs des régions du Centre et des régions éloignées, examine quelles caractéristiques servent d’indicateurs de la région et compare plusieurs stratégies visant à produire des recommandations de financement plus équitables tout en respectant un budget de subventions fixe.
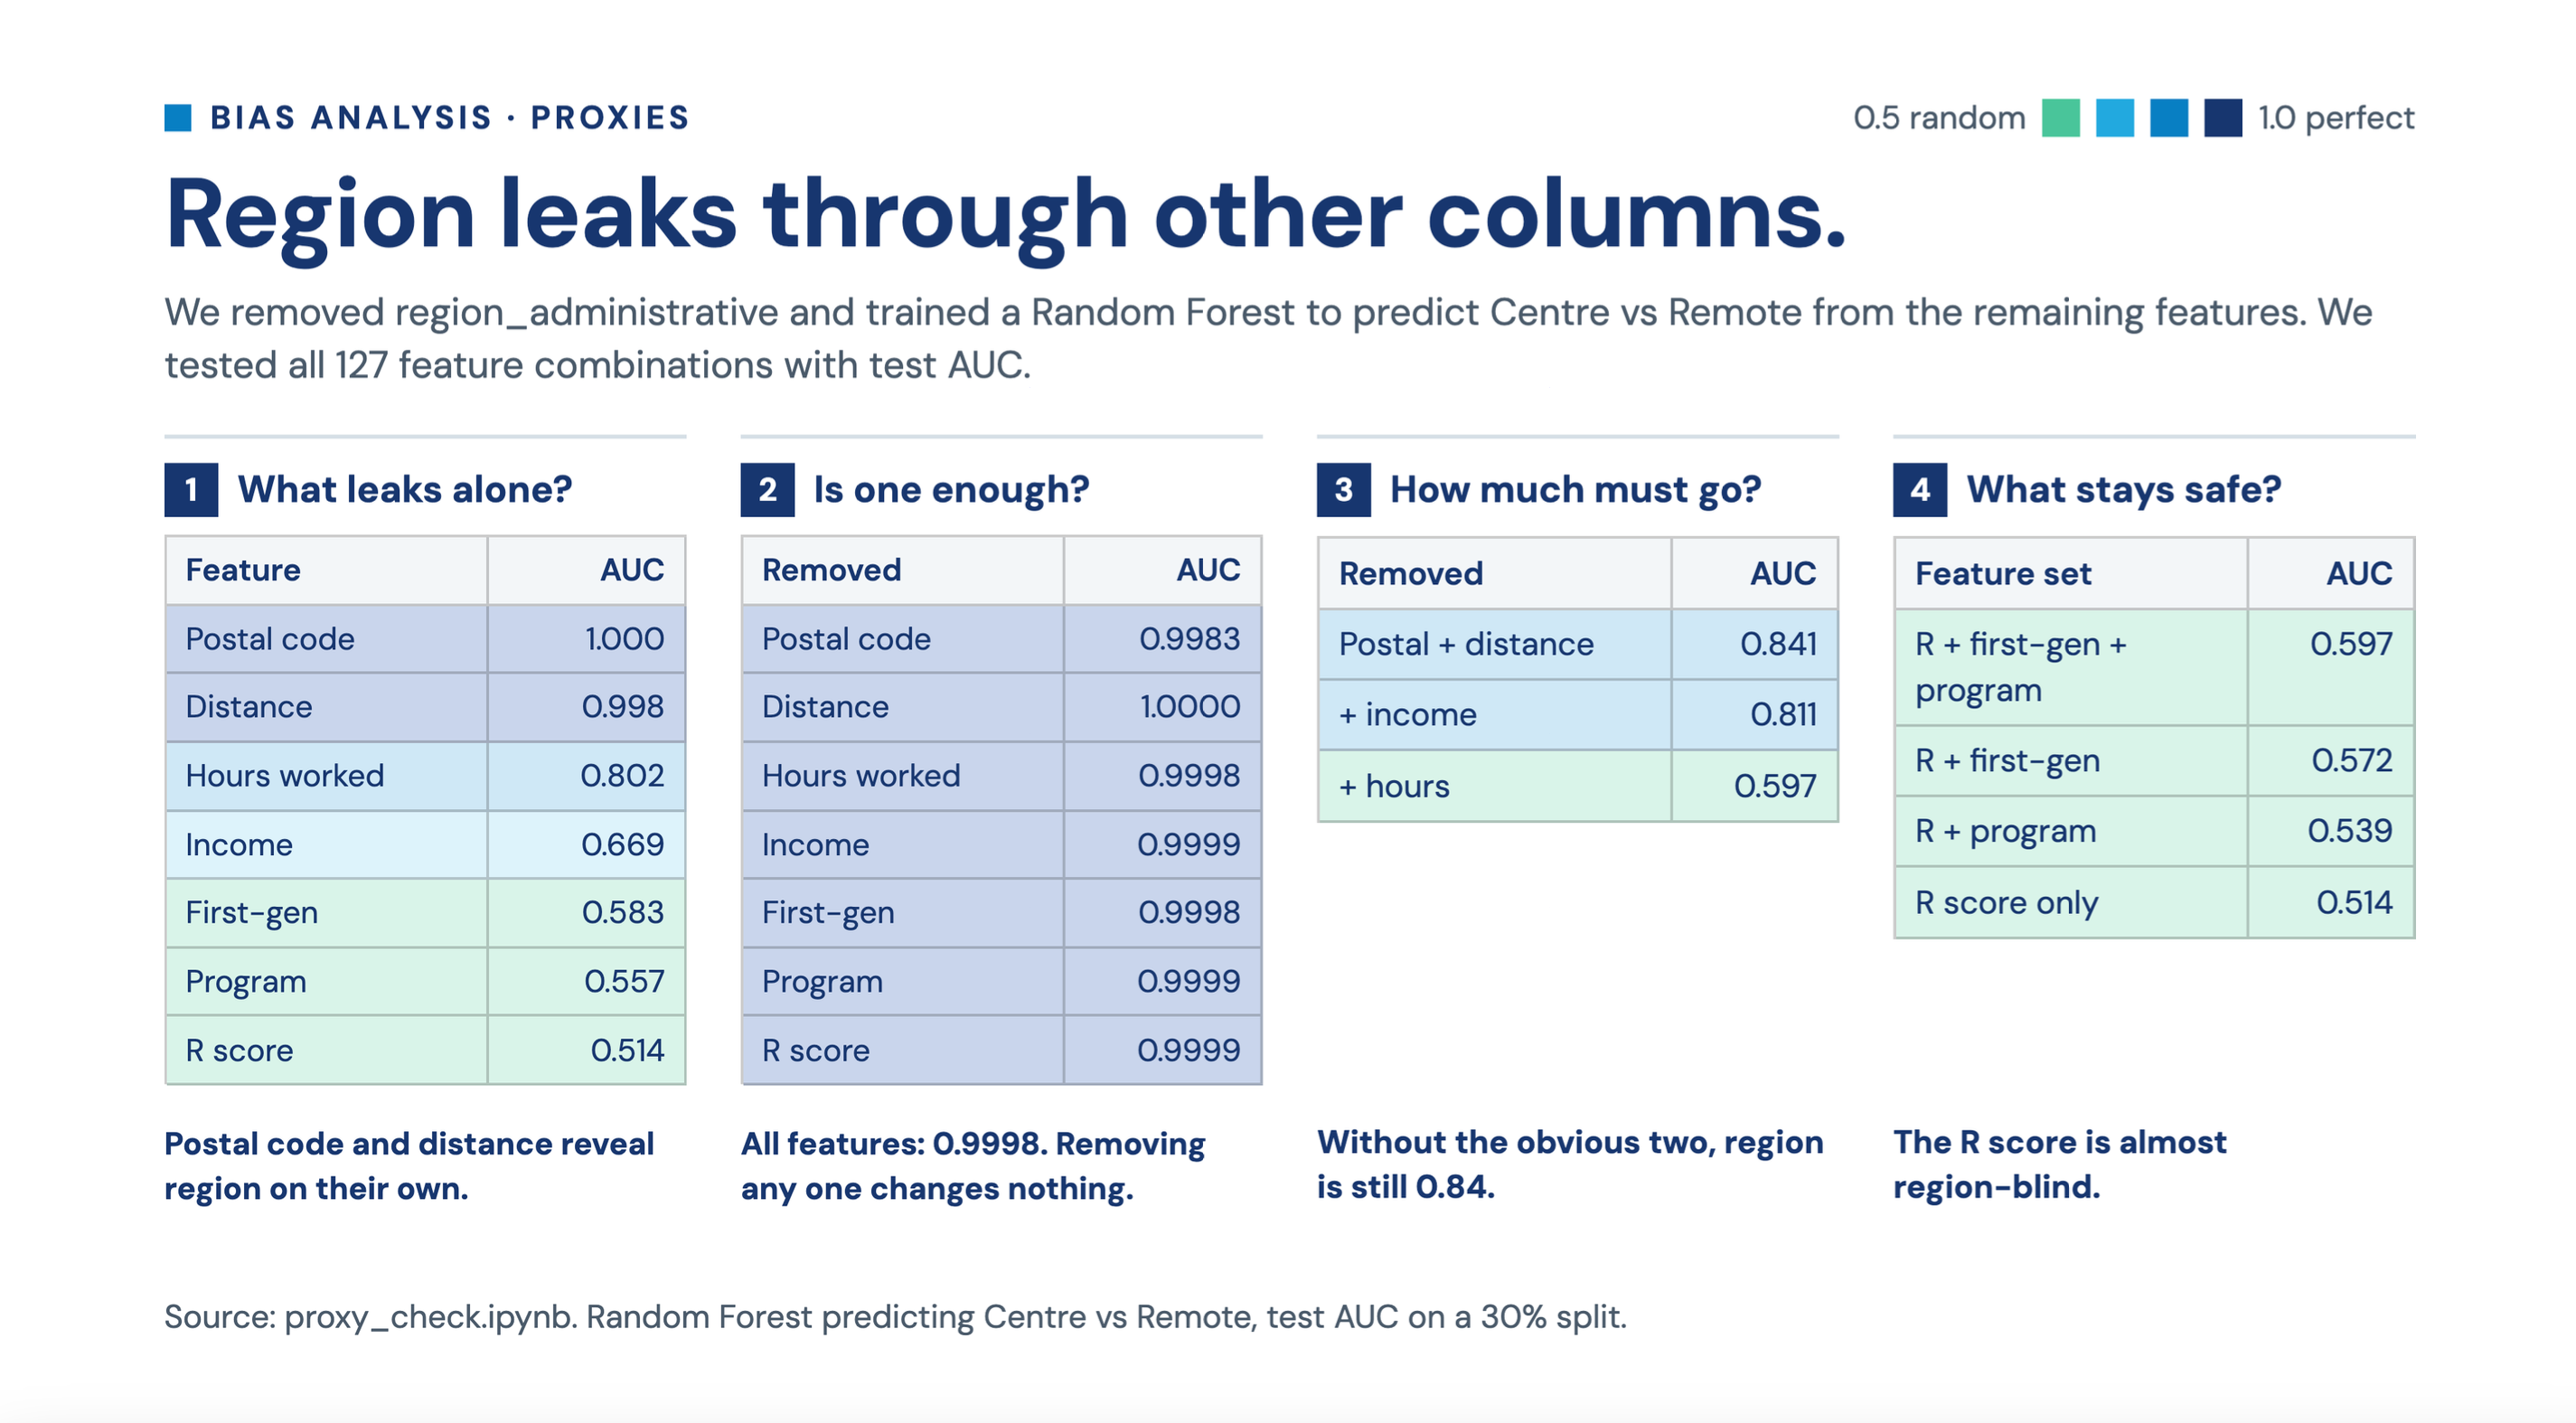
Notre analyse a démontré pourquoi la simple suppression de la variable region_administrative est insuffisante : le code postal et la distance révèlent presque parfaitement la région, tandis que les heures de travail et le revenu contiennent également des renseignements régionaux. En revanche, le R-score était pratiquement indépendant de la région.
Le système final intègre donc l’équité au cœur du processus décisionnel, plutôt que de supposer que « l’équité par ignorance » suffit.
Comment nous l’avons mis au point
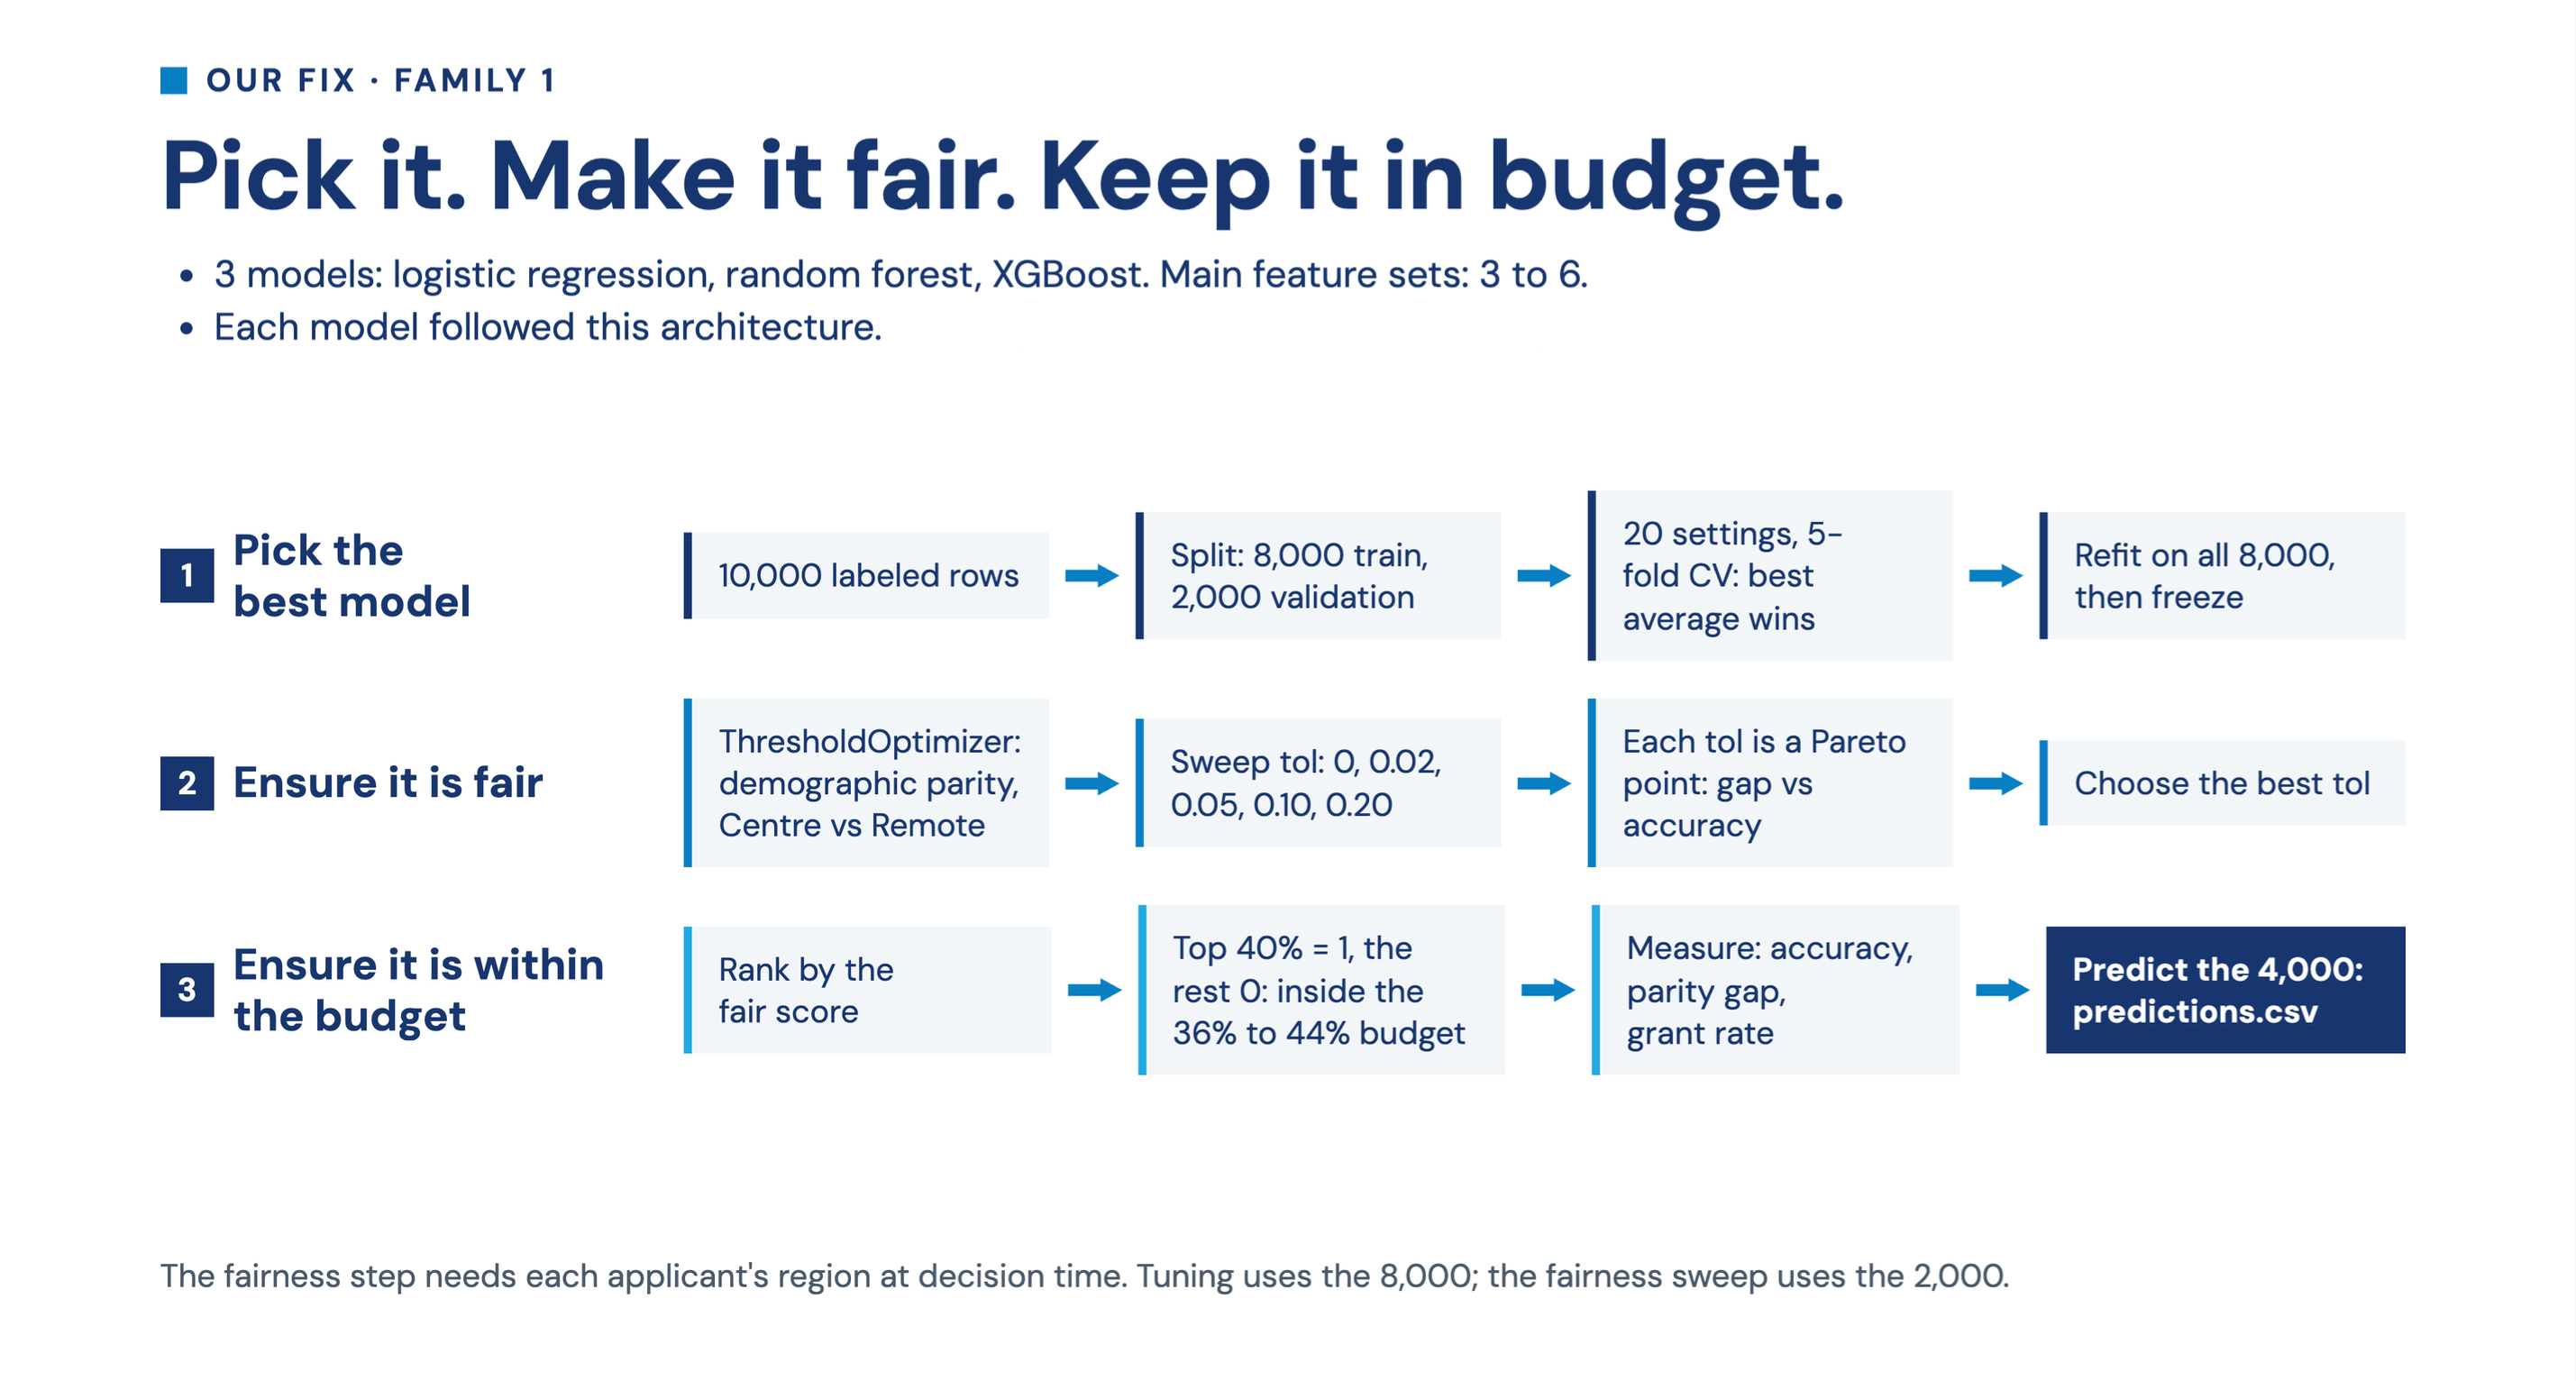
Nous sommes partis de 10 000 décisions historiques prises par le comité et avons évalué plusieurs familles de modèles, notamment la régression logistique, la forêt aléatoire et XGBoost. Nous avons utilisé la séparation entre les ensembles d’entraînement et de validation ainsi que la validation croisée pour comparer les configurations des modèles.
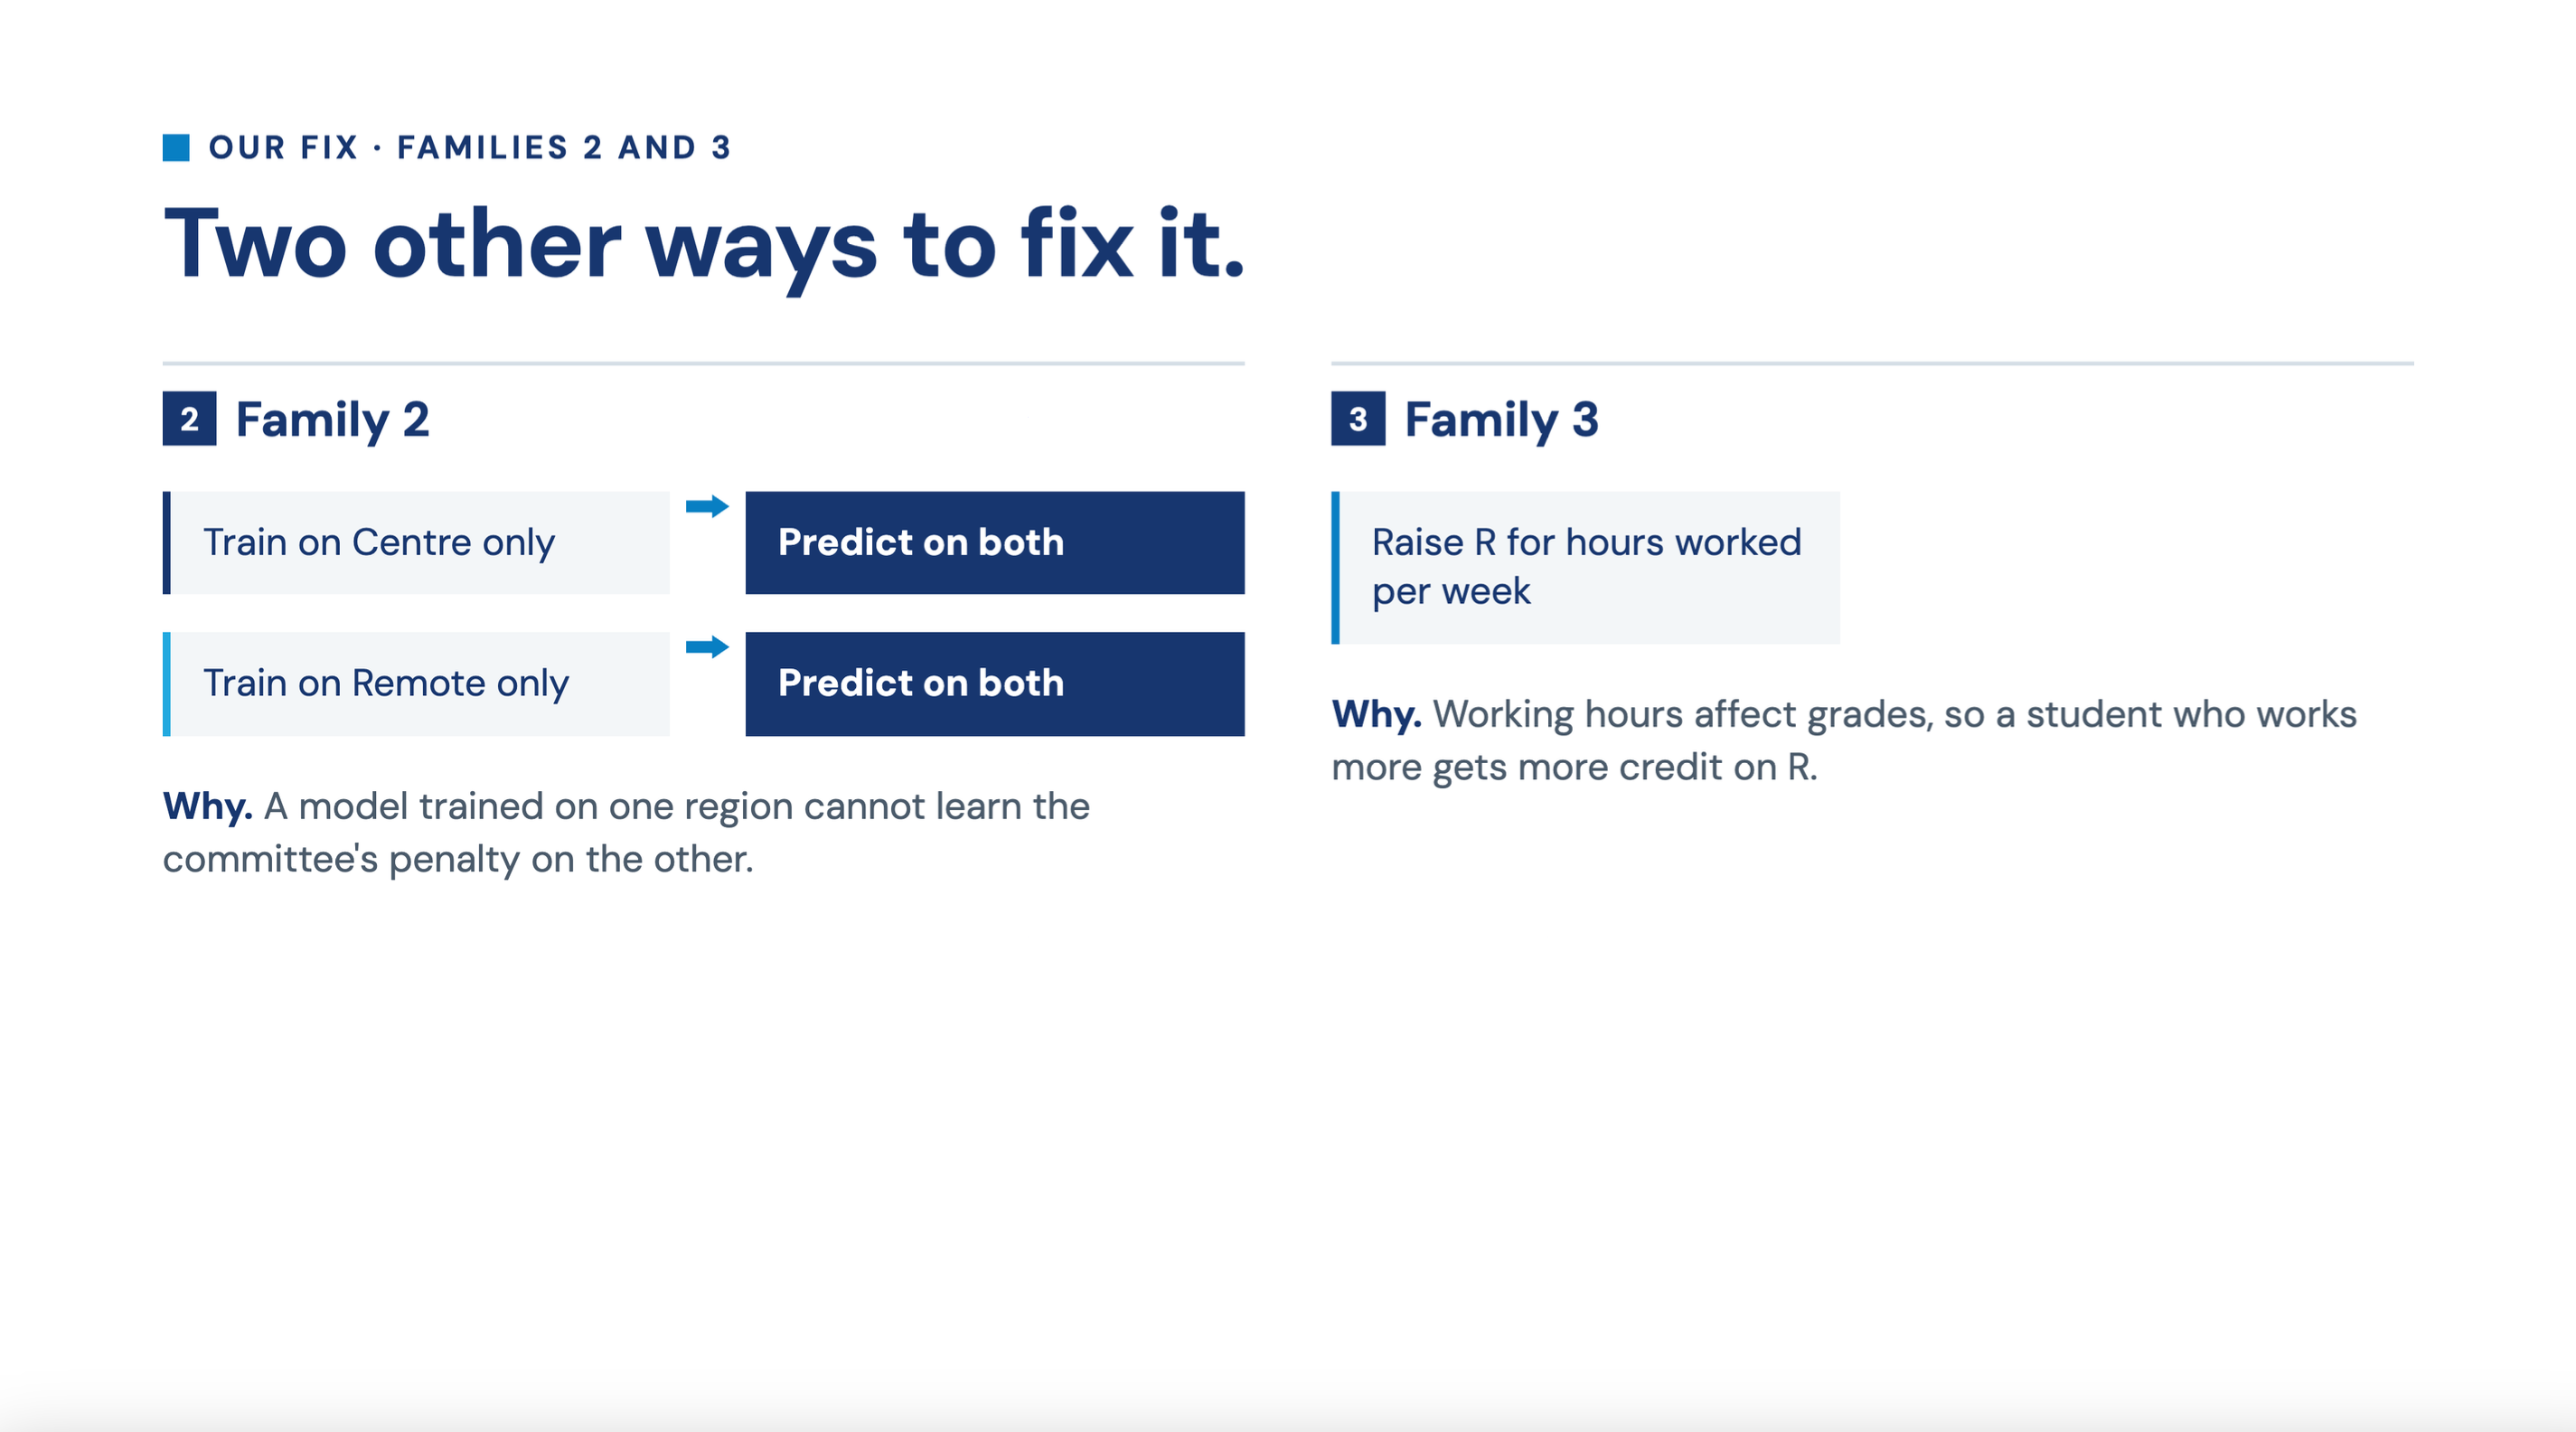
Nous avons ensuite exploré plusieurs approches en matière d’équité : le post-traitement des scores des modèles à l’aide de contraintes d’équité, l’entraînement des modèles sur des populations régionales individuelles afin d’étudier comment les effets régionaux historiques se répercutent, et l’élaboration de scores d’admissibilité mettant l’accent sur les renseignements pertinents sur le plan académique tout en tenant compte de la charge de travail des étudiants.
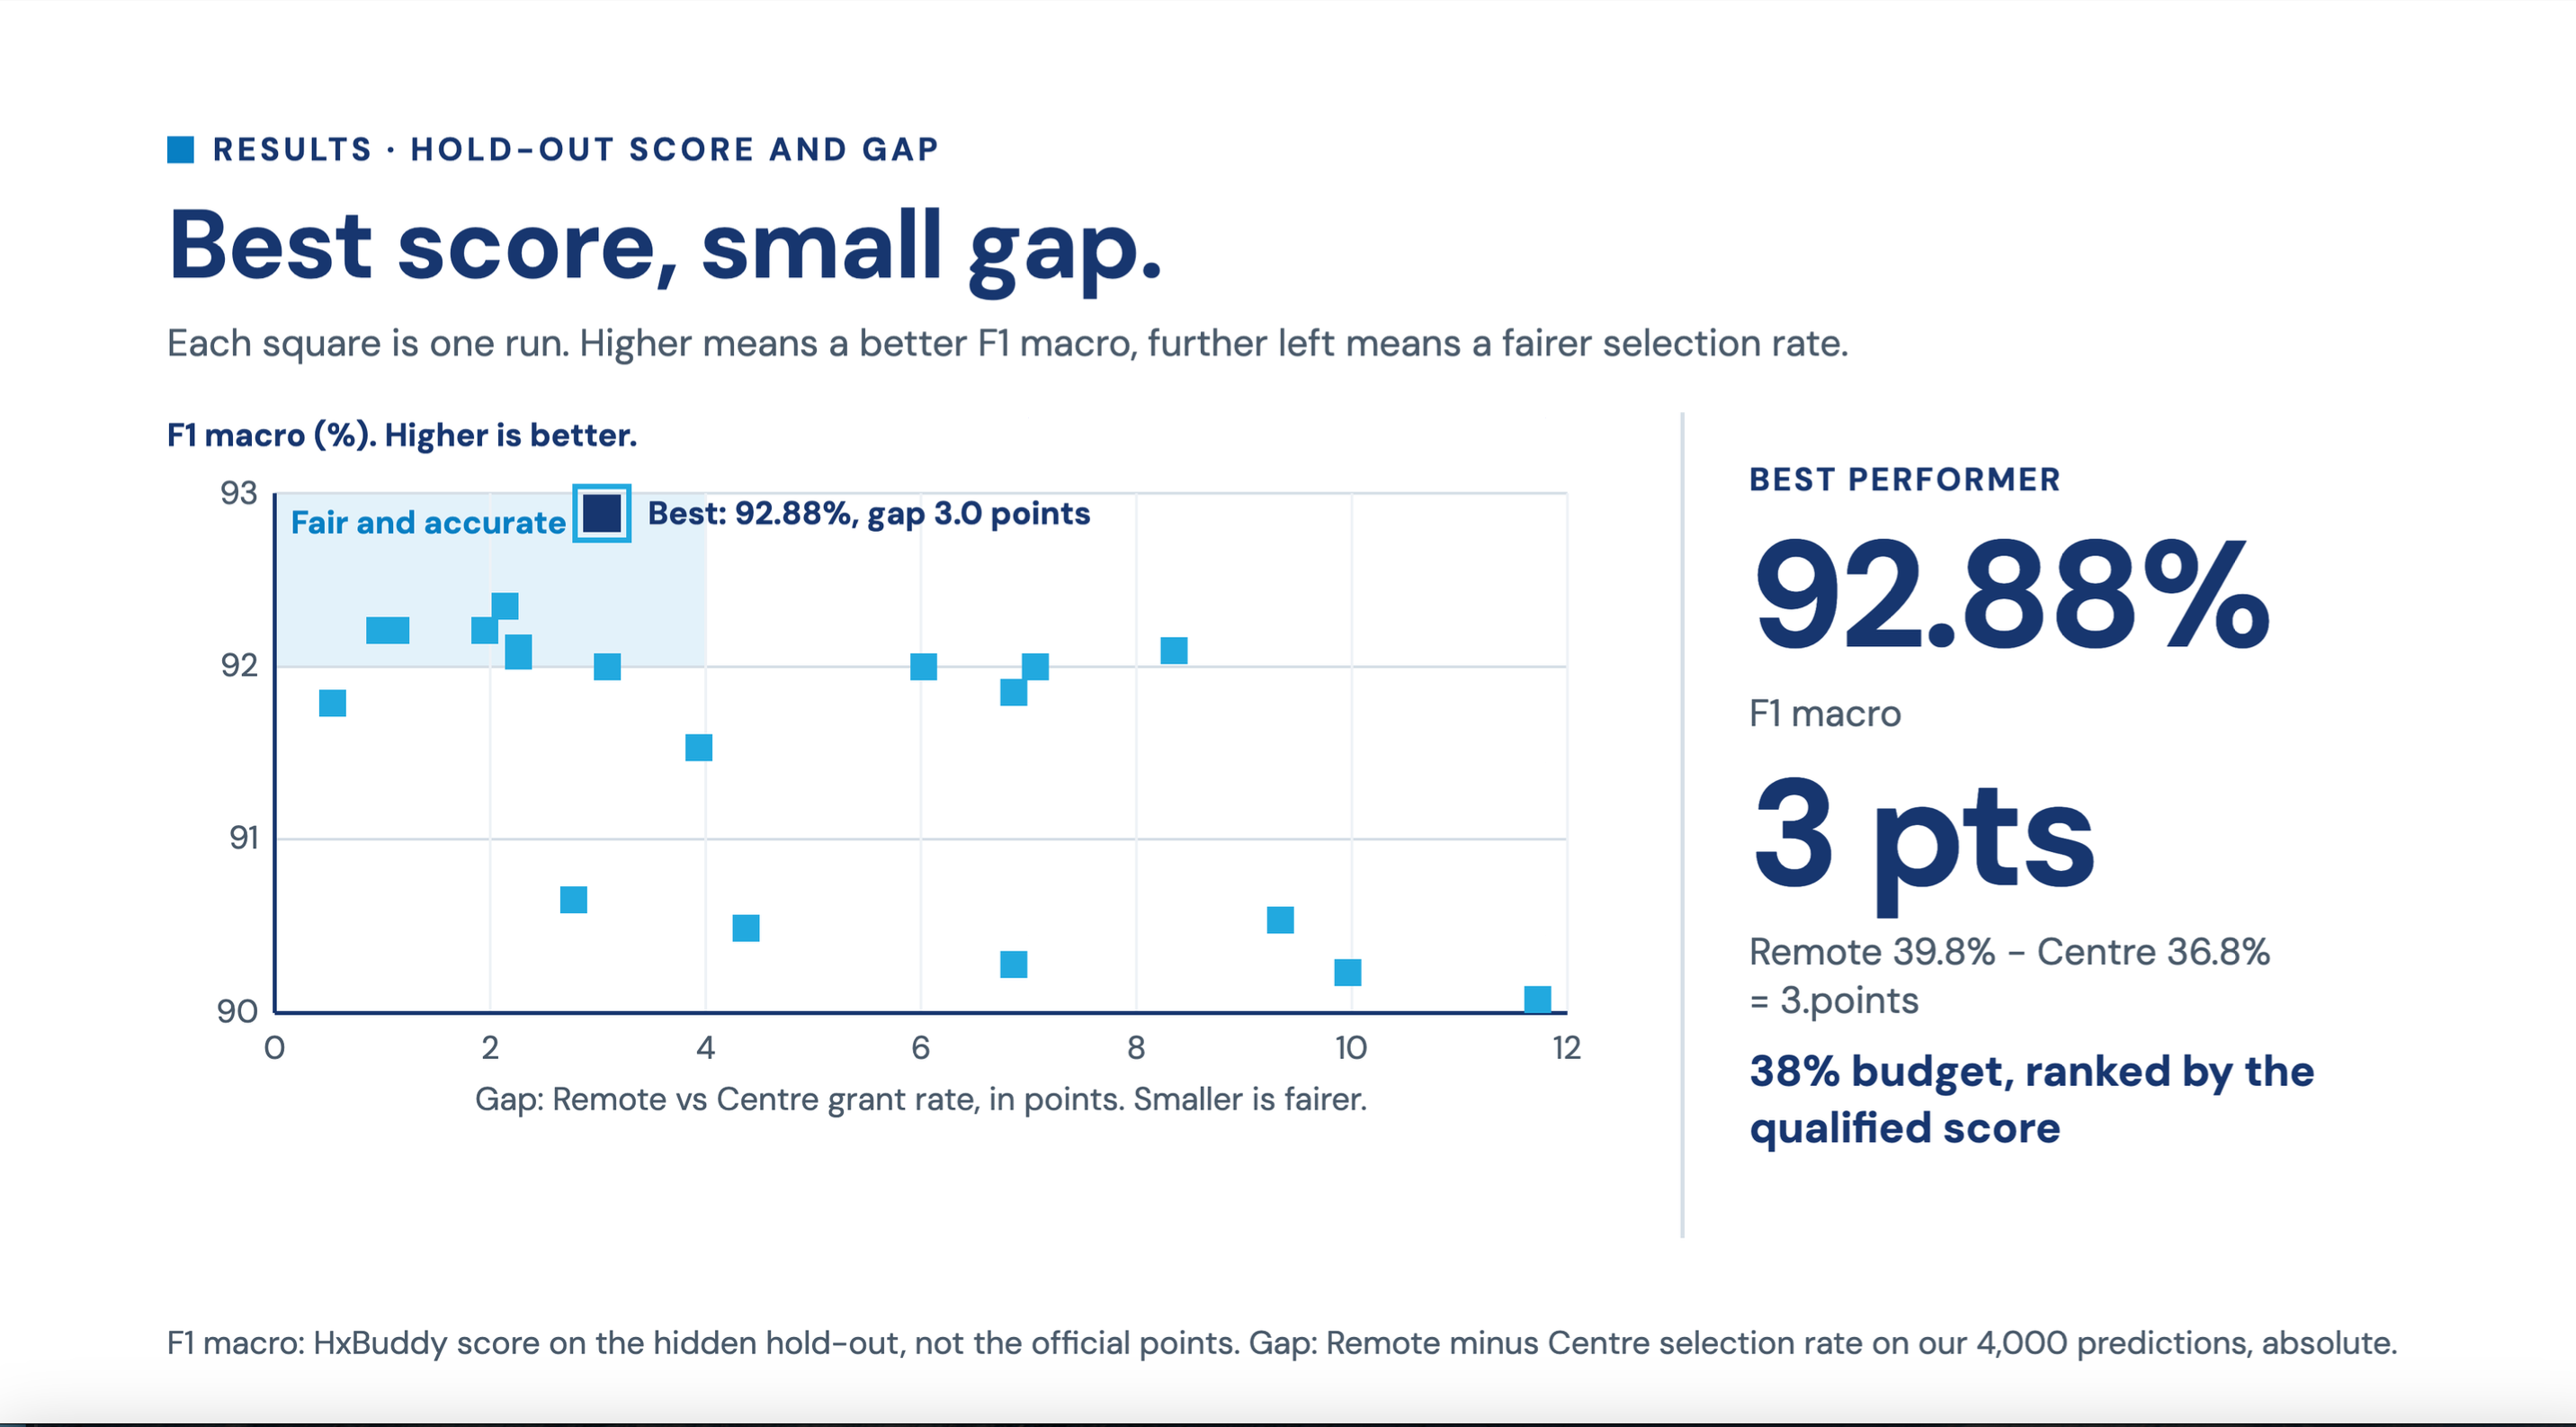
Plutôt que d’évaluer uniquement la précision, nous avons comparé les modèles en fonction de leur performance prédictive, des disparités régionales et du budget de financement disponible. Cela nous a permis de considérer la sélection des modèles comme un compromis entre équité et performance, plutôt que comme l’optimisation d’un seul indicateur.
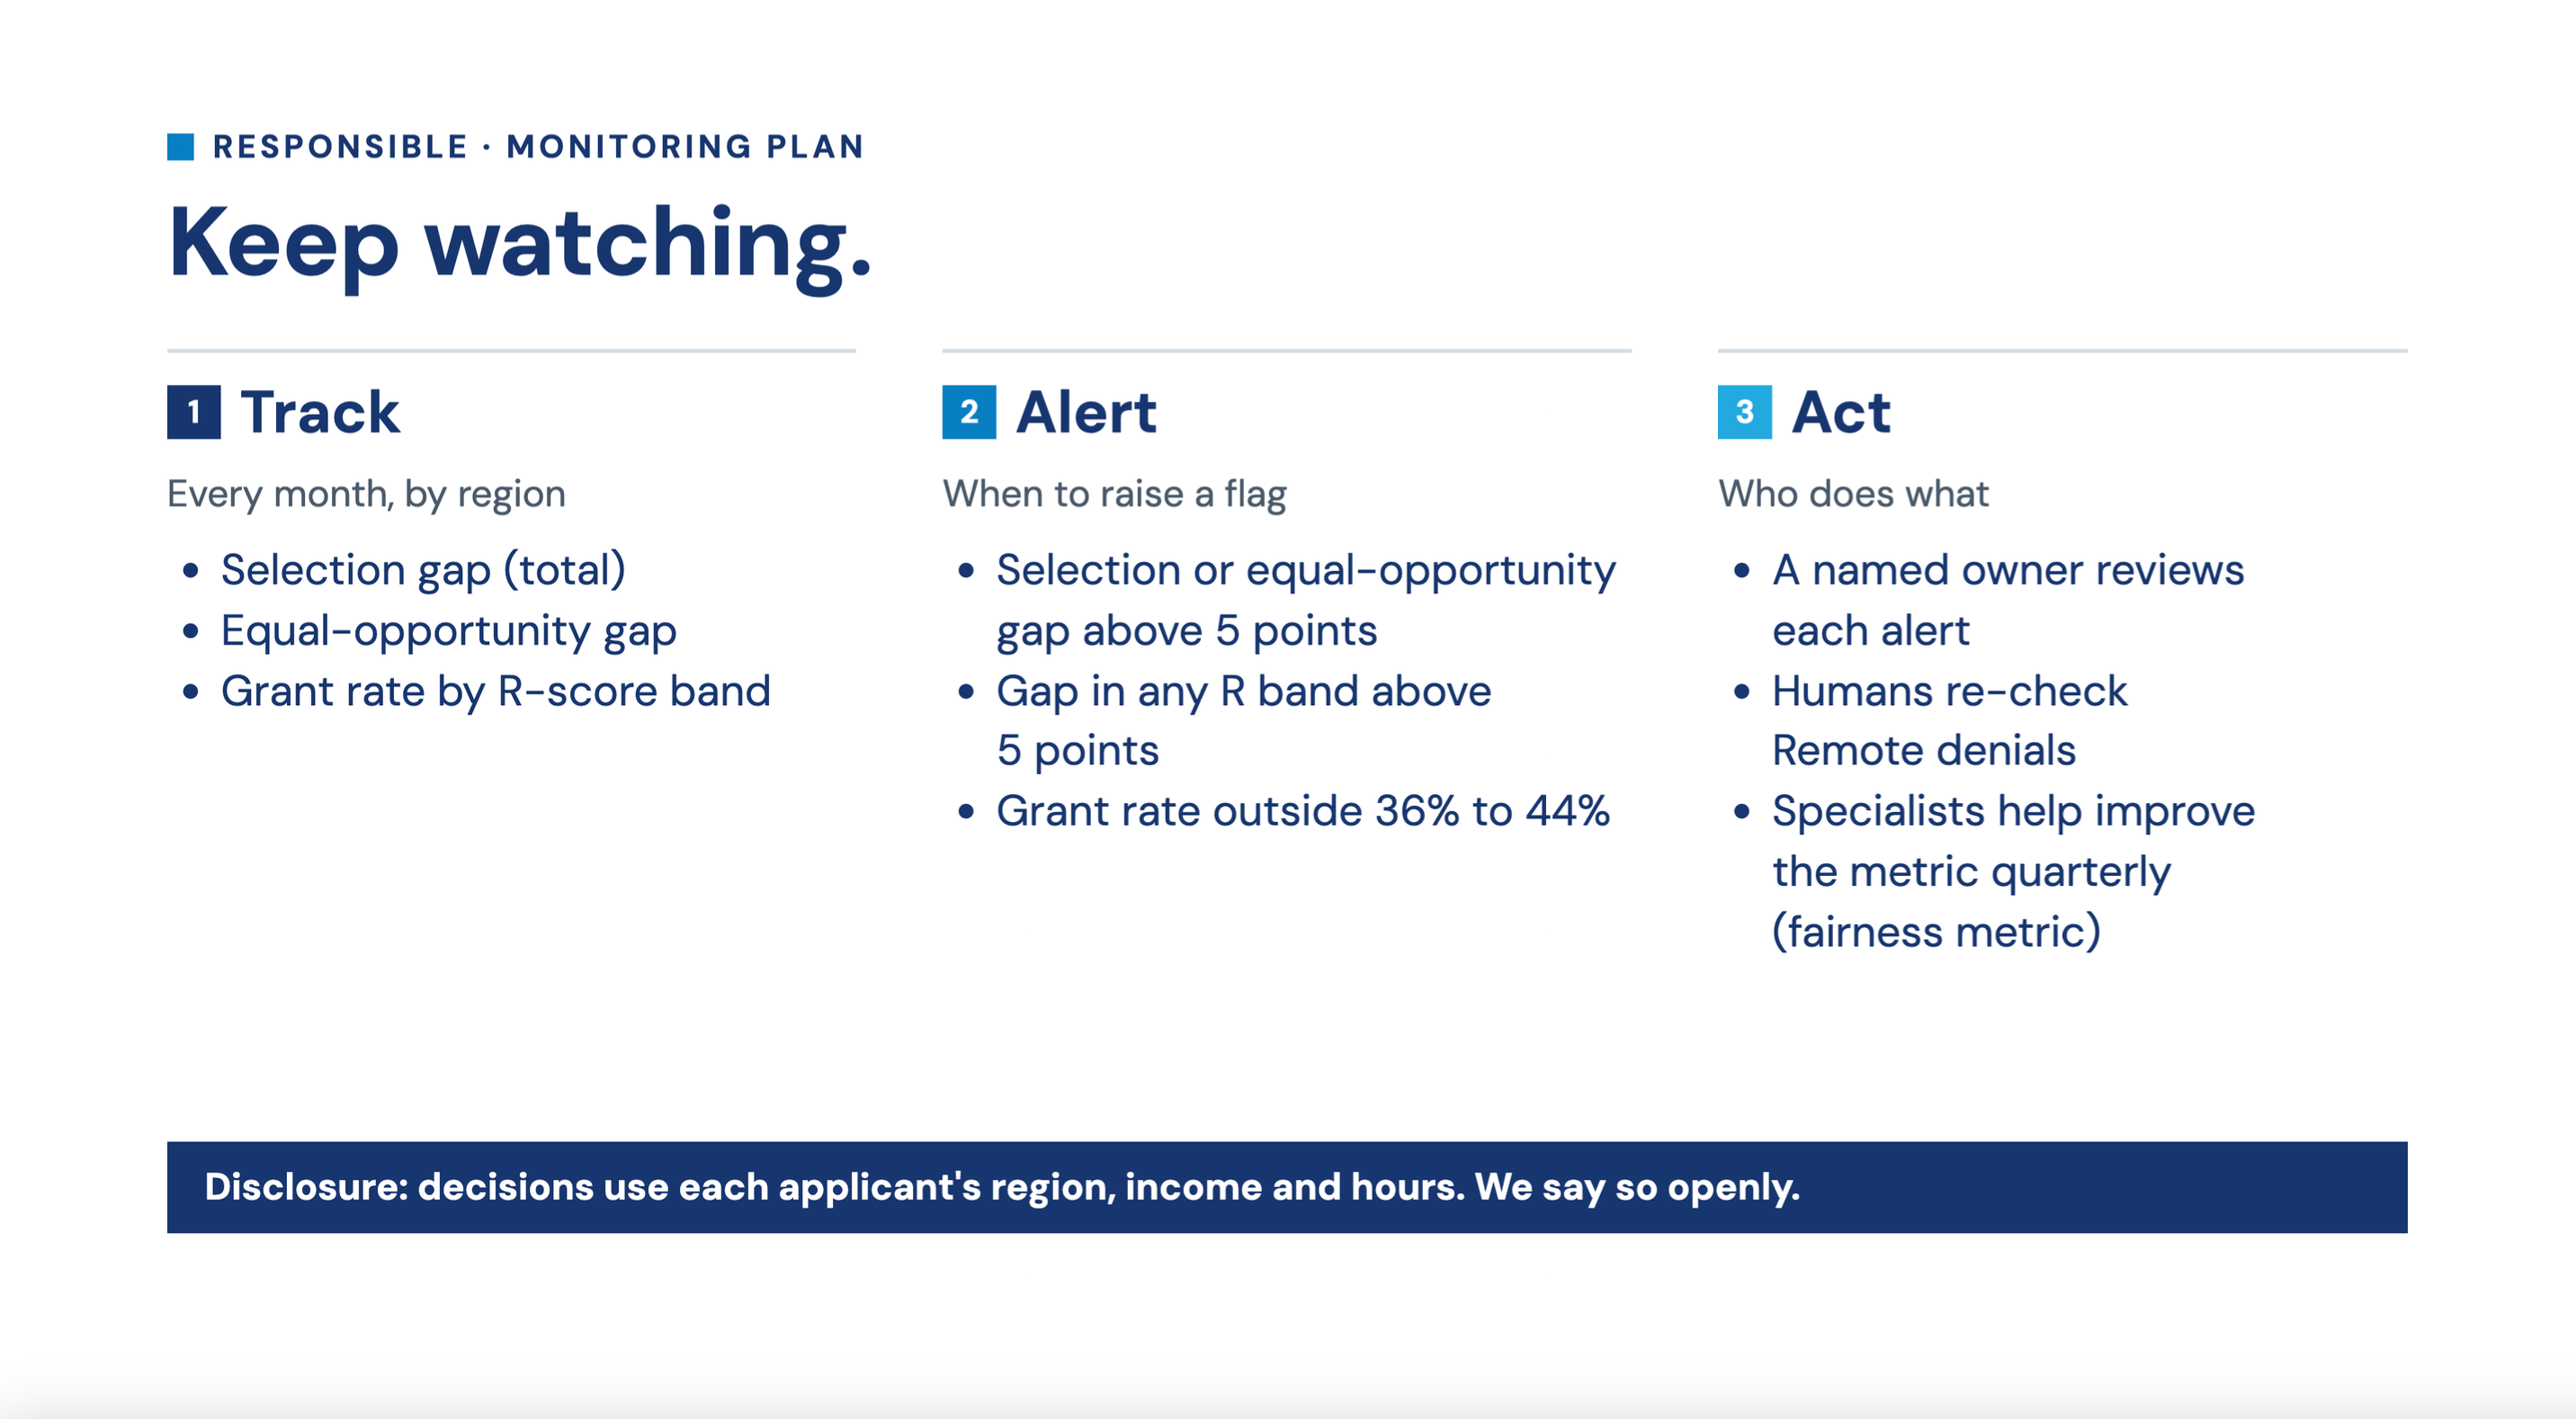
Enfin, nous avons conçu un cadre de surveillance qui suit les écarts de sélection, les écarts en matière d’égalité des chances et les taux d’octroi de subventions par tranches de rendement scolaire, avec un examen humain lorsque les disparités dépassent des seuils prédéfinis.
Les défis auxquels nous avons été confrontés
Notre plus grand défi tenait au fait que le biais était réparti dans l’ensemble de données. Le fait de supprimer la région ne supprimait pas pour autant les informations régionales.
Un deuxième défi consistait à définir ce que devait signifier le terme « équitable ». La parité démographique, l’égalité des chances et la performance prédictive peuvent mener à des décisions différentes, surtout dans le cadre d’un budget limité.
Enfin, nous devions éviter de remplacer une règle arbitraire par une autre. Chaque mesure d’équité devait rester interprétable et défendable, plutôt que de viser simplement à maximiser un pointage au classement.
Les réalisations dont nous sommes fiers
Nous sommes particulièrement fiers qu’ÉquiAlgo aille au-delà de la simple production d’un classificateur plus précis.
Nous avons mis au point une analyse de bout en bout capable de mesurer les biais historiques, de mettre en évidence les variables de substitution, de comparer les mesures d’équité, de respecter un budget de financement et de surveiller le système résultant au fil du temps.
Nous avons également testé 127 combinaisons de caractéristiques afin de comprendre dans quelle mesure la région pouvait être reconstituée même après sa suppression explicite, démontrant ainsi quantitativement pourquoi la suppression d’un attribut sensible à elle seule ne garantit pas l’équité.
Plus important encore, nos expériences montrent que l’équité et la performance prédictive ne sont pas nécessairement des objectifs contradictoires : des interventions soigneusement conçues peuvent réduire considérablement les disparités régionales tout en conservant une forte performance prédictive.
Ce que nous avons appris
Nous avons appris qu’un apprentissage automatique responsable repose autant sur la mesure et la conception du système que sur le choix d’un algorithme.
Un modèle peut être extrêmement précis tout en reproduisant des discriminations historiques. Des renseignements sensibles peuvent subsister à travers des variables intermédiaires. Et un indicateur d’équité ne suffit pas à lui seul à déterminer quelle devrait être la politique appropriée.
Nous avons également appris l’importance de rendre explicites les hypothèses : quelles variables constituent des signaux de qualification légitimes, quelles disparités doivent être limitées, quel budget doit être respecté et à quel moment les humains doivent intervenir.
Prochaines étapes pour ÉquiAlgo
La prochaine étape consiste à faire d’ÉquiAlgo, qui n’est pour l’instant qu’un prototype issu d’un hackathon, un système pouvant être évalué de manière prospective.
Nous validerions la politique d’équité avec des experts du domaine, la testerions sur de nouvelles cohortes, vérifierions si les relations observées demeurent stables au fil du temps et élargirions la couche de surveillance afin de détecter automatiquement toute dérive en matière d’équité.
En fin de compte, ÉquiAlgo ne vise pas à affirmer qu’un algorithme peut définir l’équité.
Il s’agit plutôt de rendre l’inéquité visible.
Built With
- ai-fairness
- jupyter
- logistic-regression
- numpy
- pandas
- python
- random-forest
- responsible-ai
- scikit-learn
- xgboost


Log in or sign up for Devpost to join the conversation.