Le problème
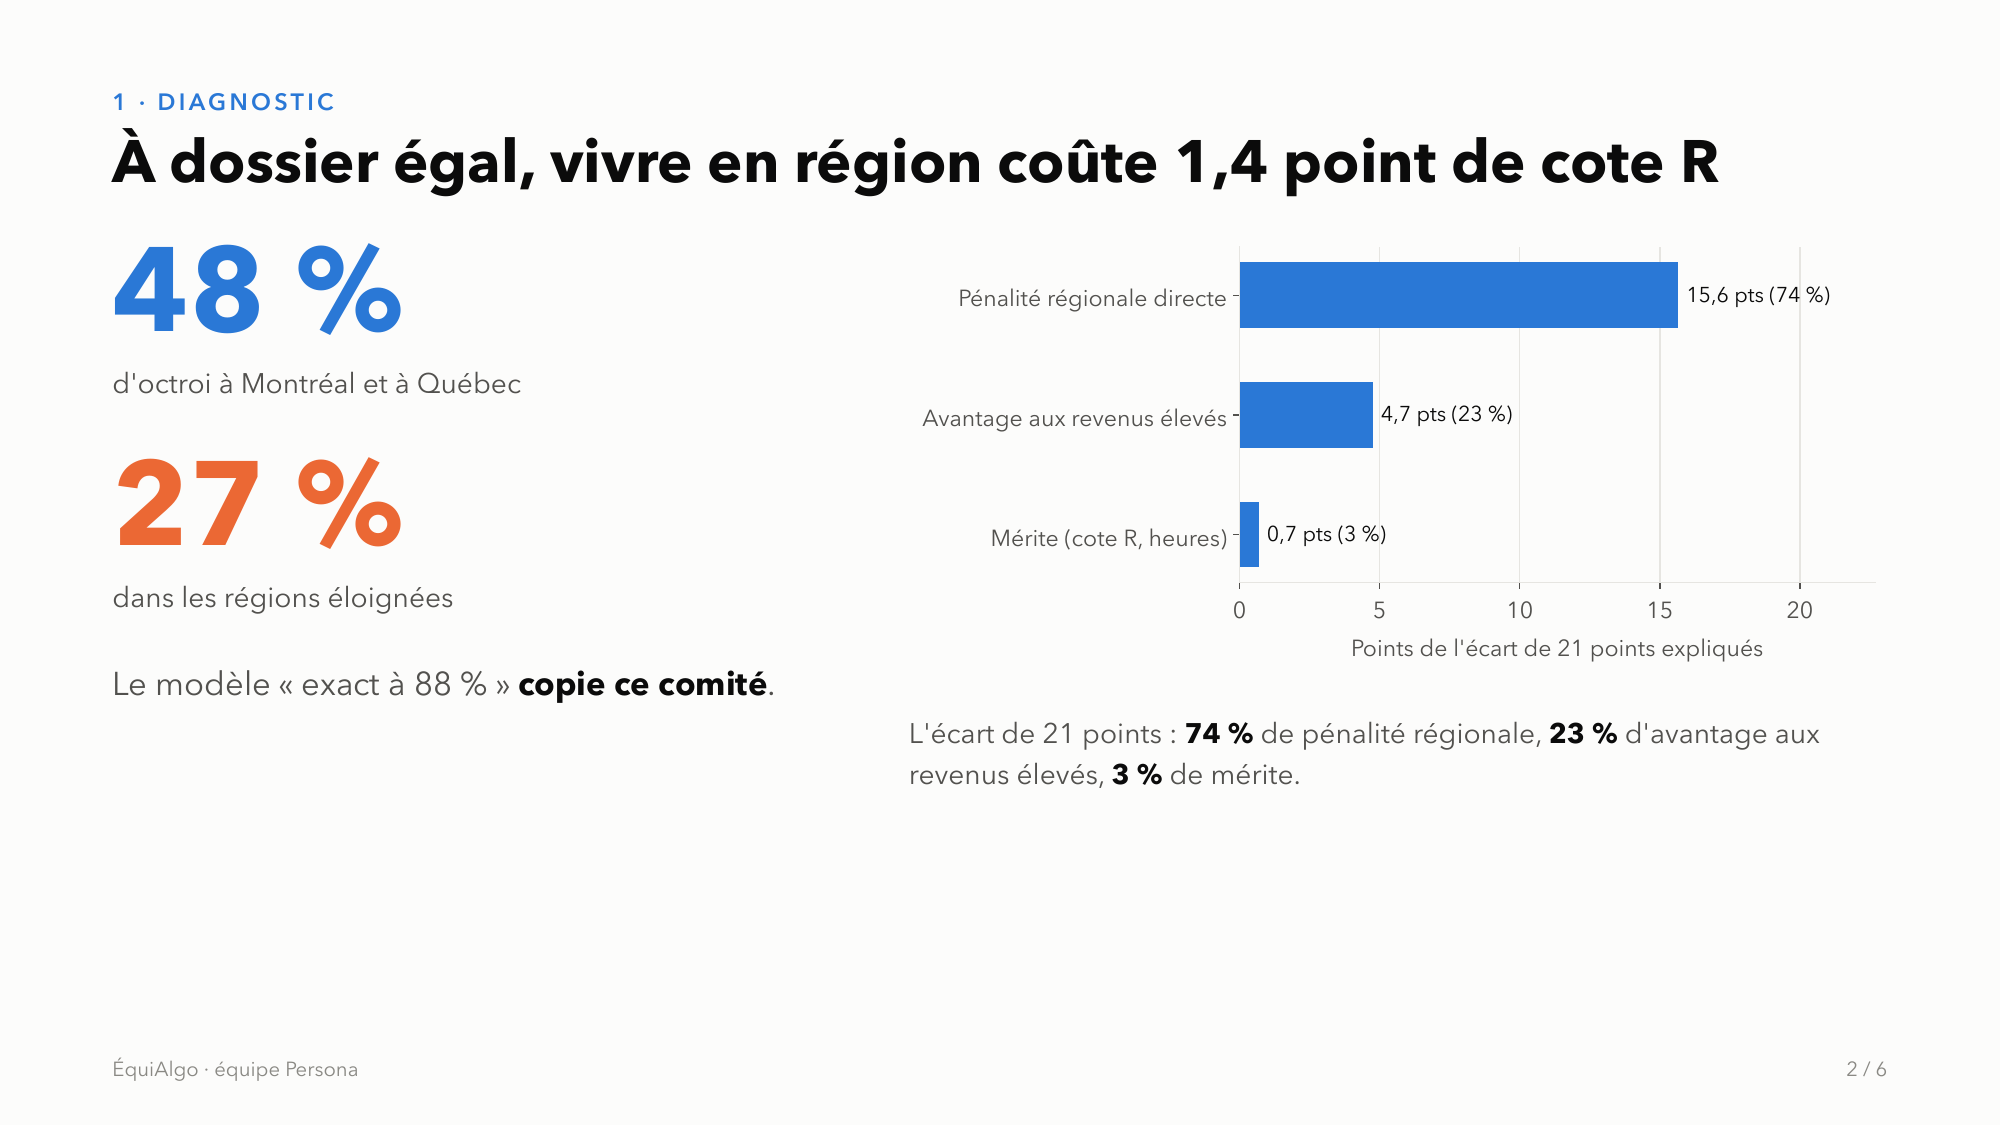
Un modèle d'octroi de bourses exact à 88 % accordait une bourse à 48 % des candidat·es de Montréal et de la Capitale-Nationale, contre 27 % au Bas-Saint-Laurent, sur la Côte-Nord et en Gaspésie. Son exactitude était mesurée contre les décisions d'un comité… biaisé.
- À dossier égal, vivre en région éloignée coûtait 1,4 point de cote R.
- L'écart de 21 points se décompose en 74 % de pénalité régionale directe, 23 % d'avantage aux revenus élevés et 3 % de mérite.
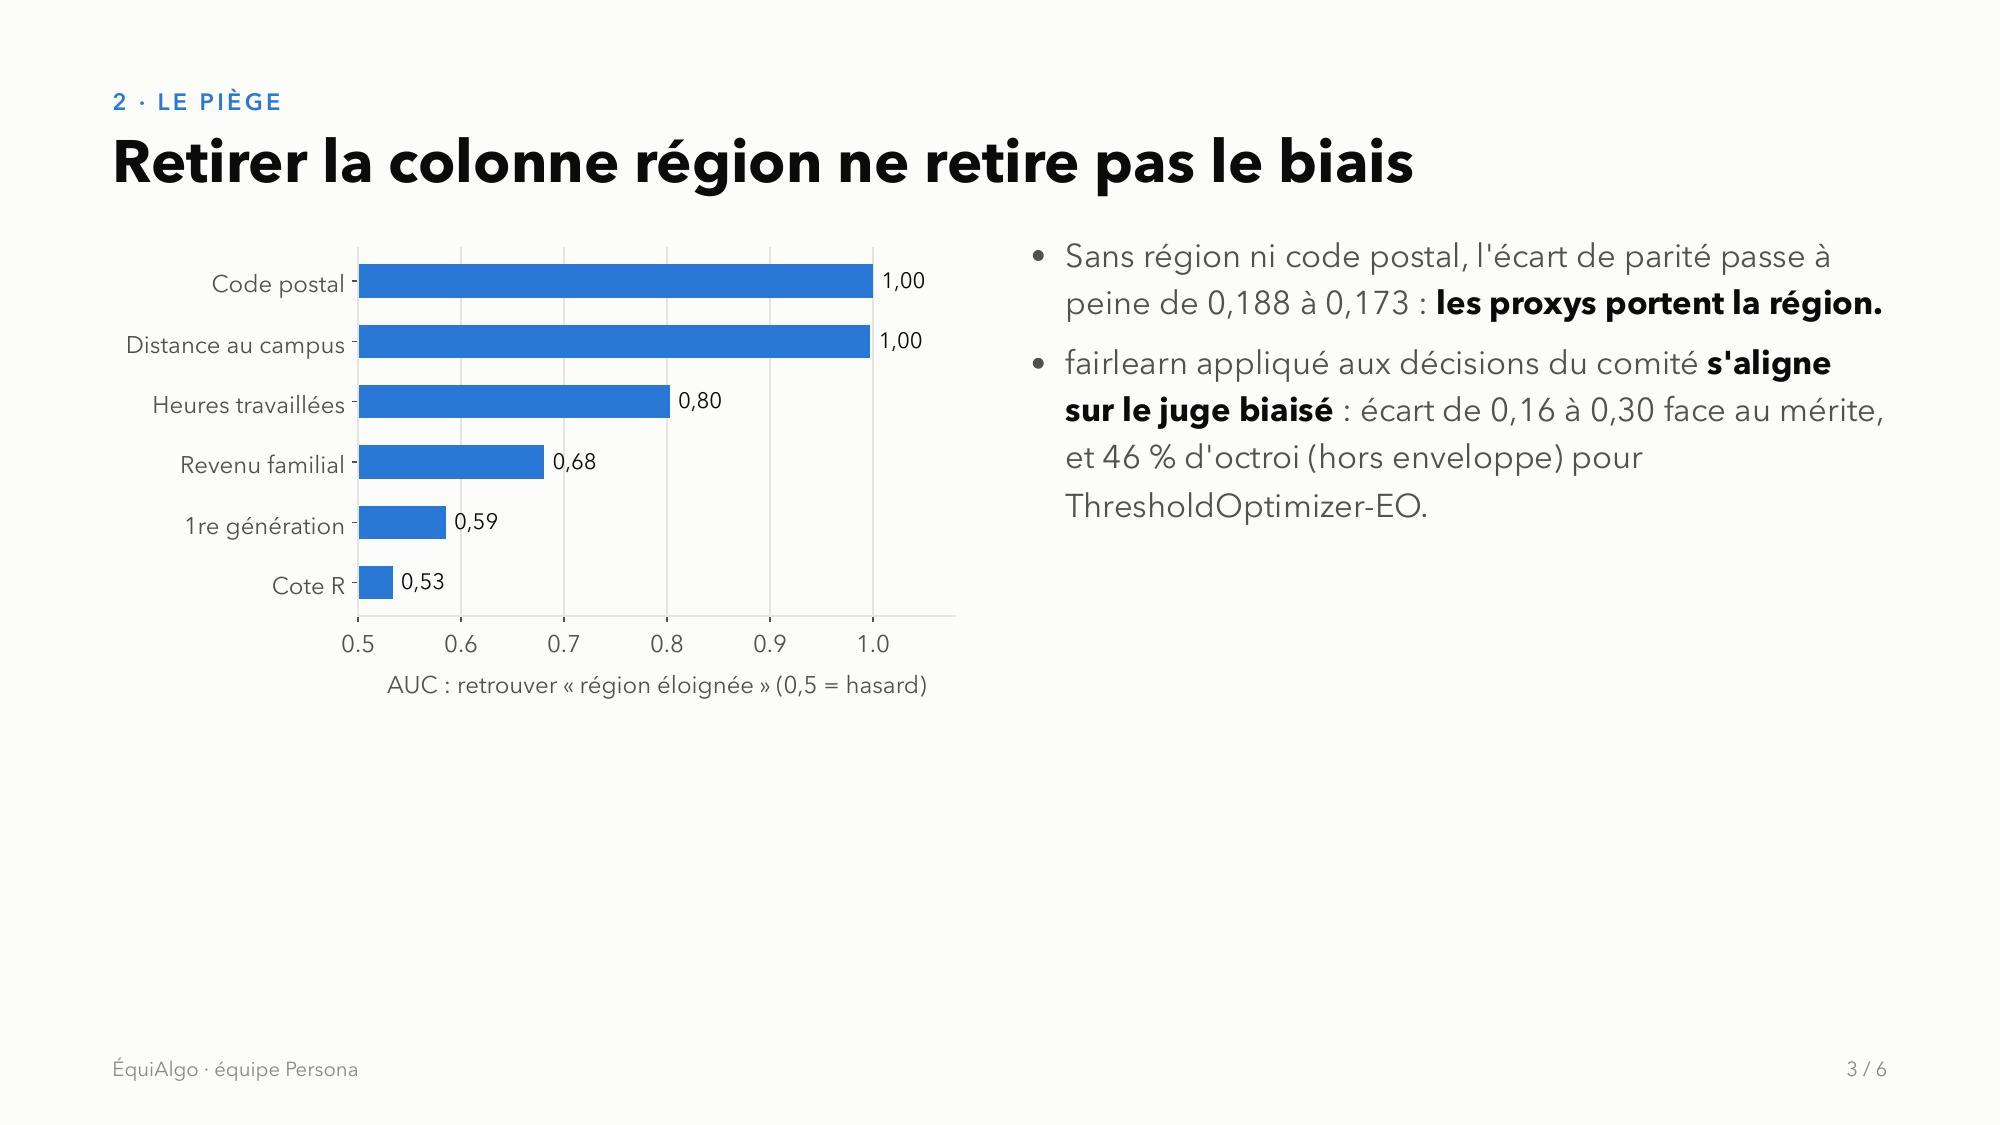
- Retirer la colonne région ne suffit pas : code postal (AUC 1,00), distance (1,00), heures travaillées (0,80) et revenu (0,68) la reconstituent.
- Égaliser l'égalité des chances contre les décisions du comité revient à s'aligner sur le juge biaisé : les méthodes fairlearn appliquées ainsi gardent un écart de 0,16 à 0,30.
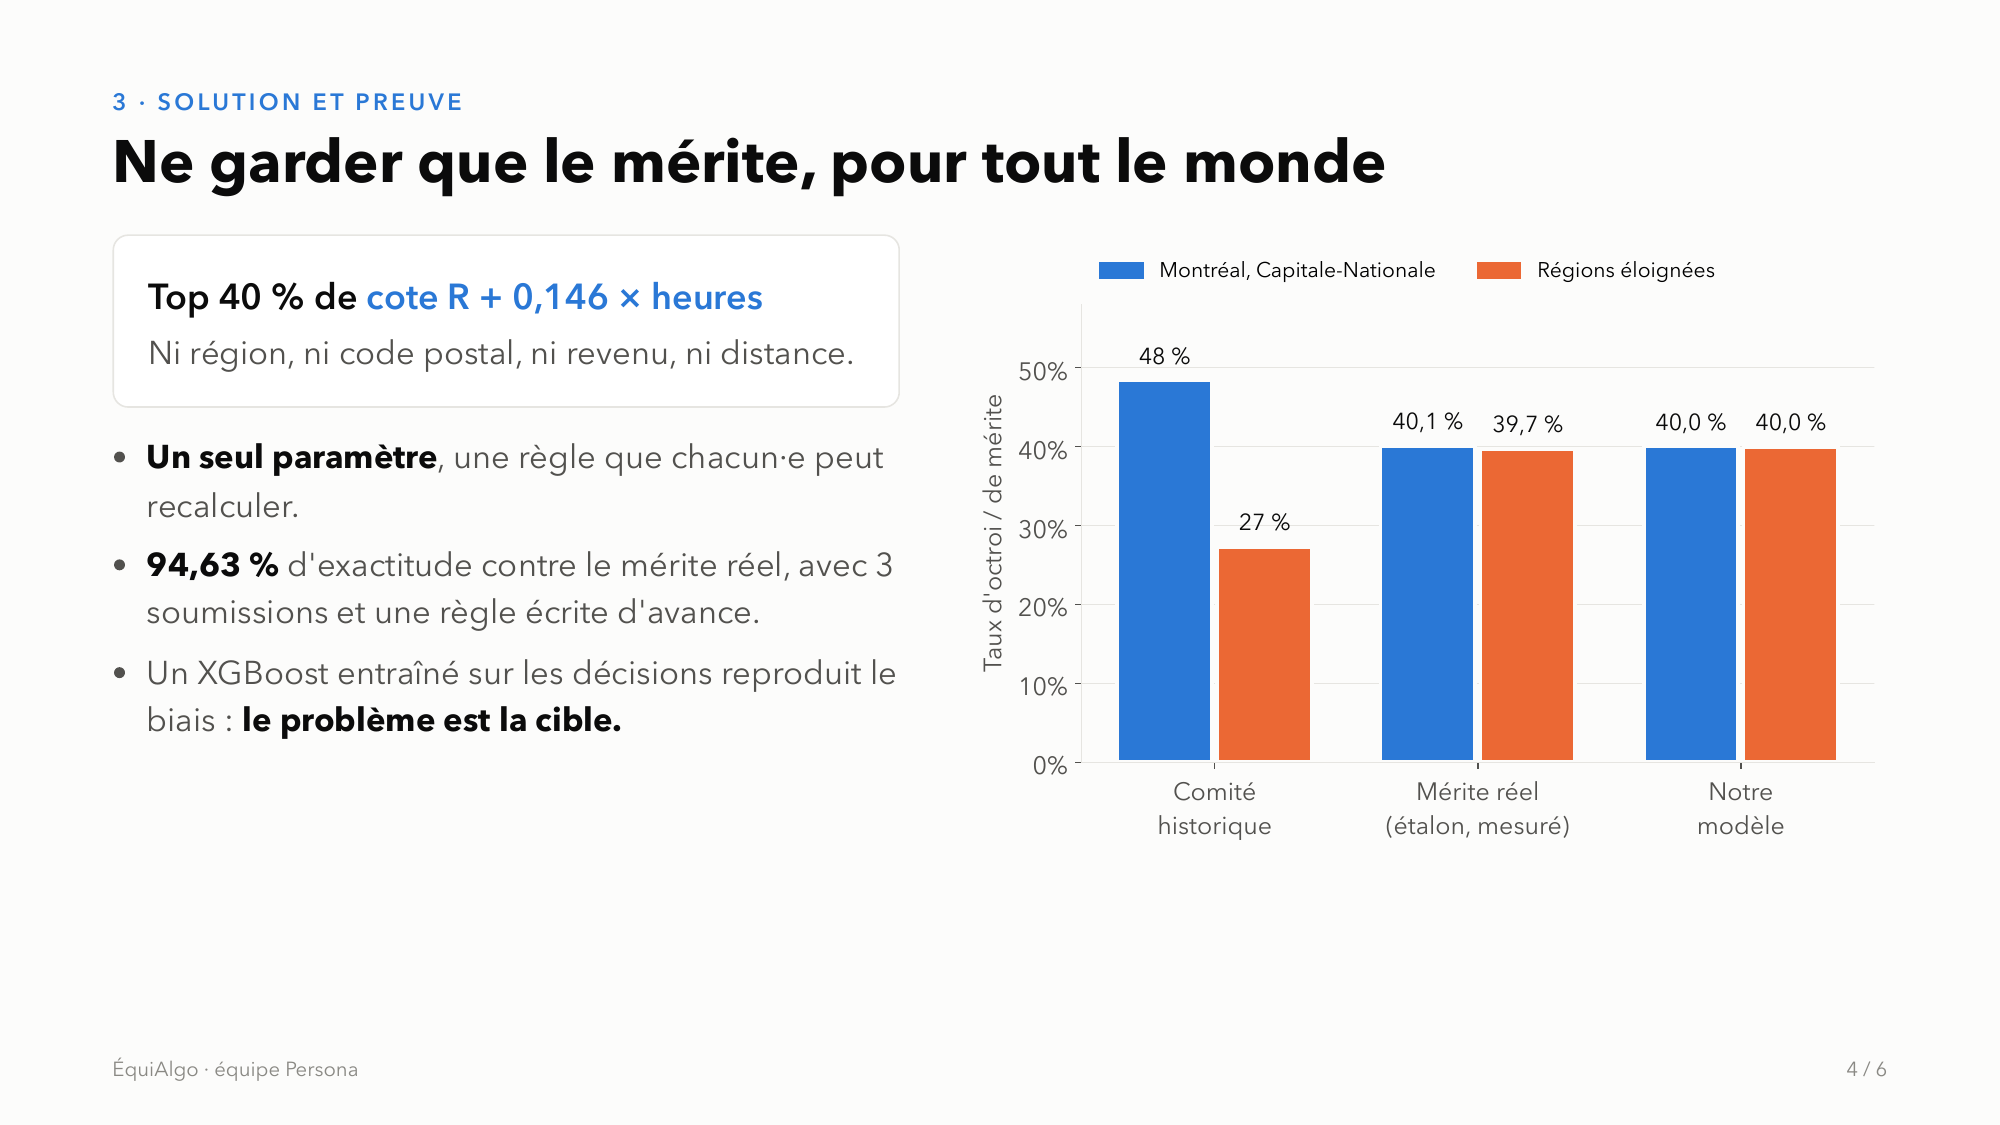
## Notre solution Nous modélisons le comité (régression logistique structurelle), séparons son mérite (cote R + 0,146 × heures travaillées) de son biais (région, revenu), puis accordons la bourse aux 40 % les plus méritants. La décision n'utilise ni la région, ni le code postal, ni le revenu, ni la distance. Un seul paramètre estimé, une règle que chaque candidat·e peut recalculer.
## Résultats
- Trois soumissions agrégées, selon une règle de décision écrite avant de soumettre : le mérite réel concerne 40,05 % des candidat·es au centre et 39,74 % en région.
- 94,63 % d'exactitude et 94,4 % de F1 macro contre ce mérite.
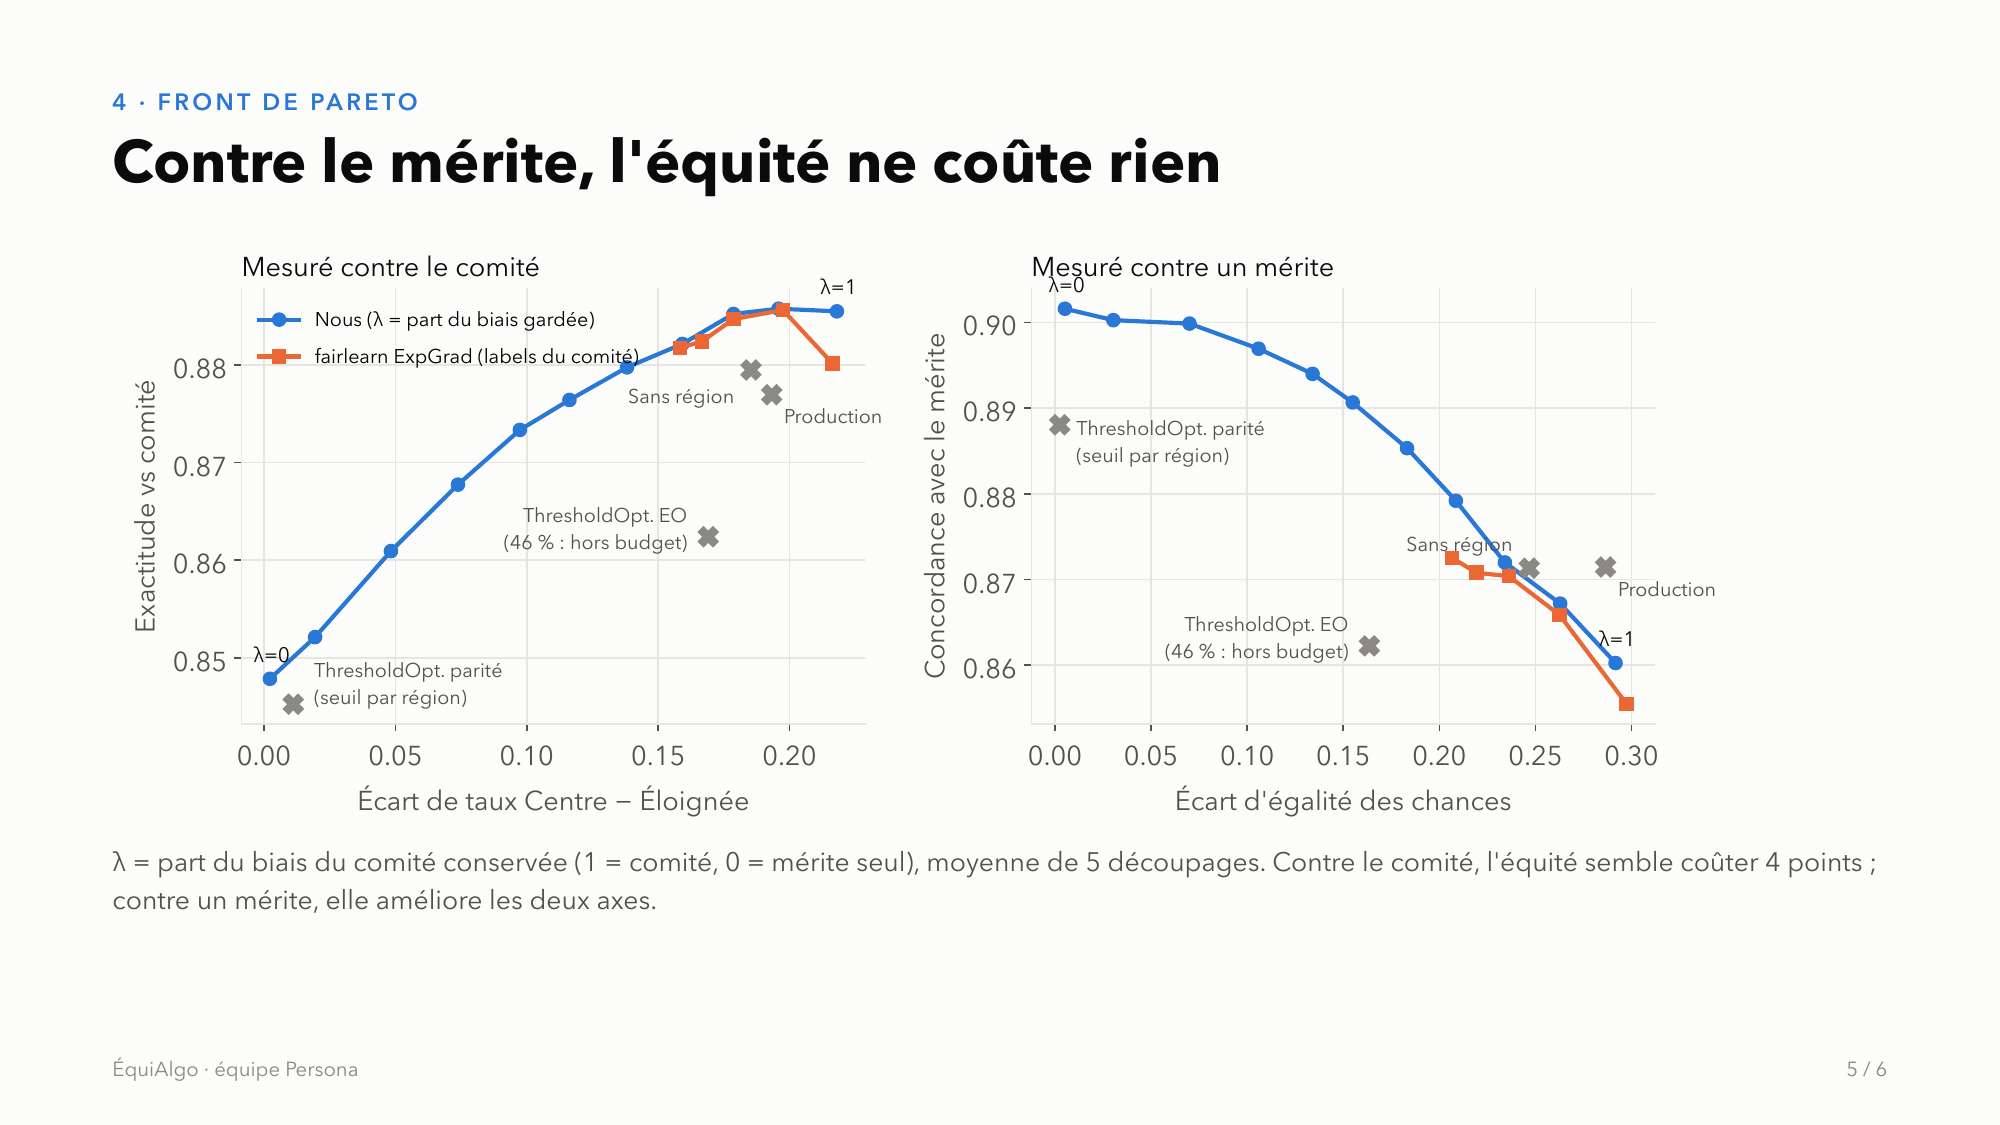
- Front de Pareto : contre le comité, l'équité semble coûter 4 points ; contre un mérite, elle améliore les deux axes.
- Un boosting (type XGBoost) entraîné sur les décisions reproduit le biais (écart ≈ 0,28) : le problème est la cible, pas la puissance du modèle.
## Gouvernance
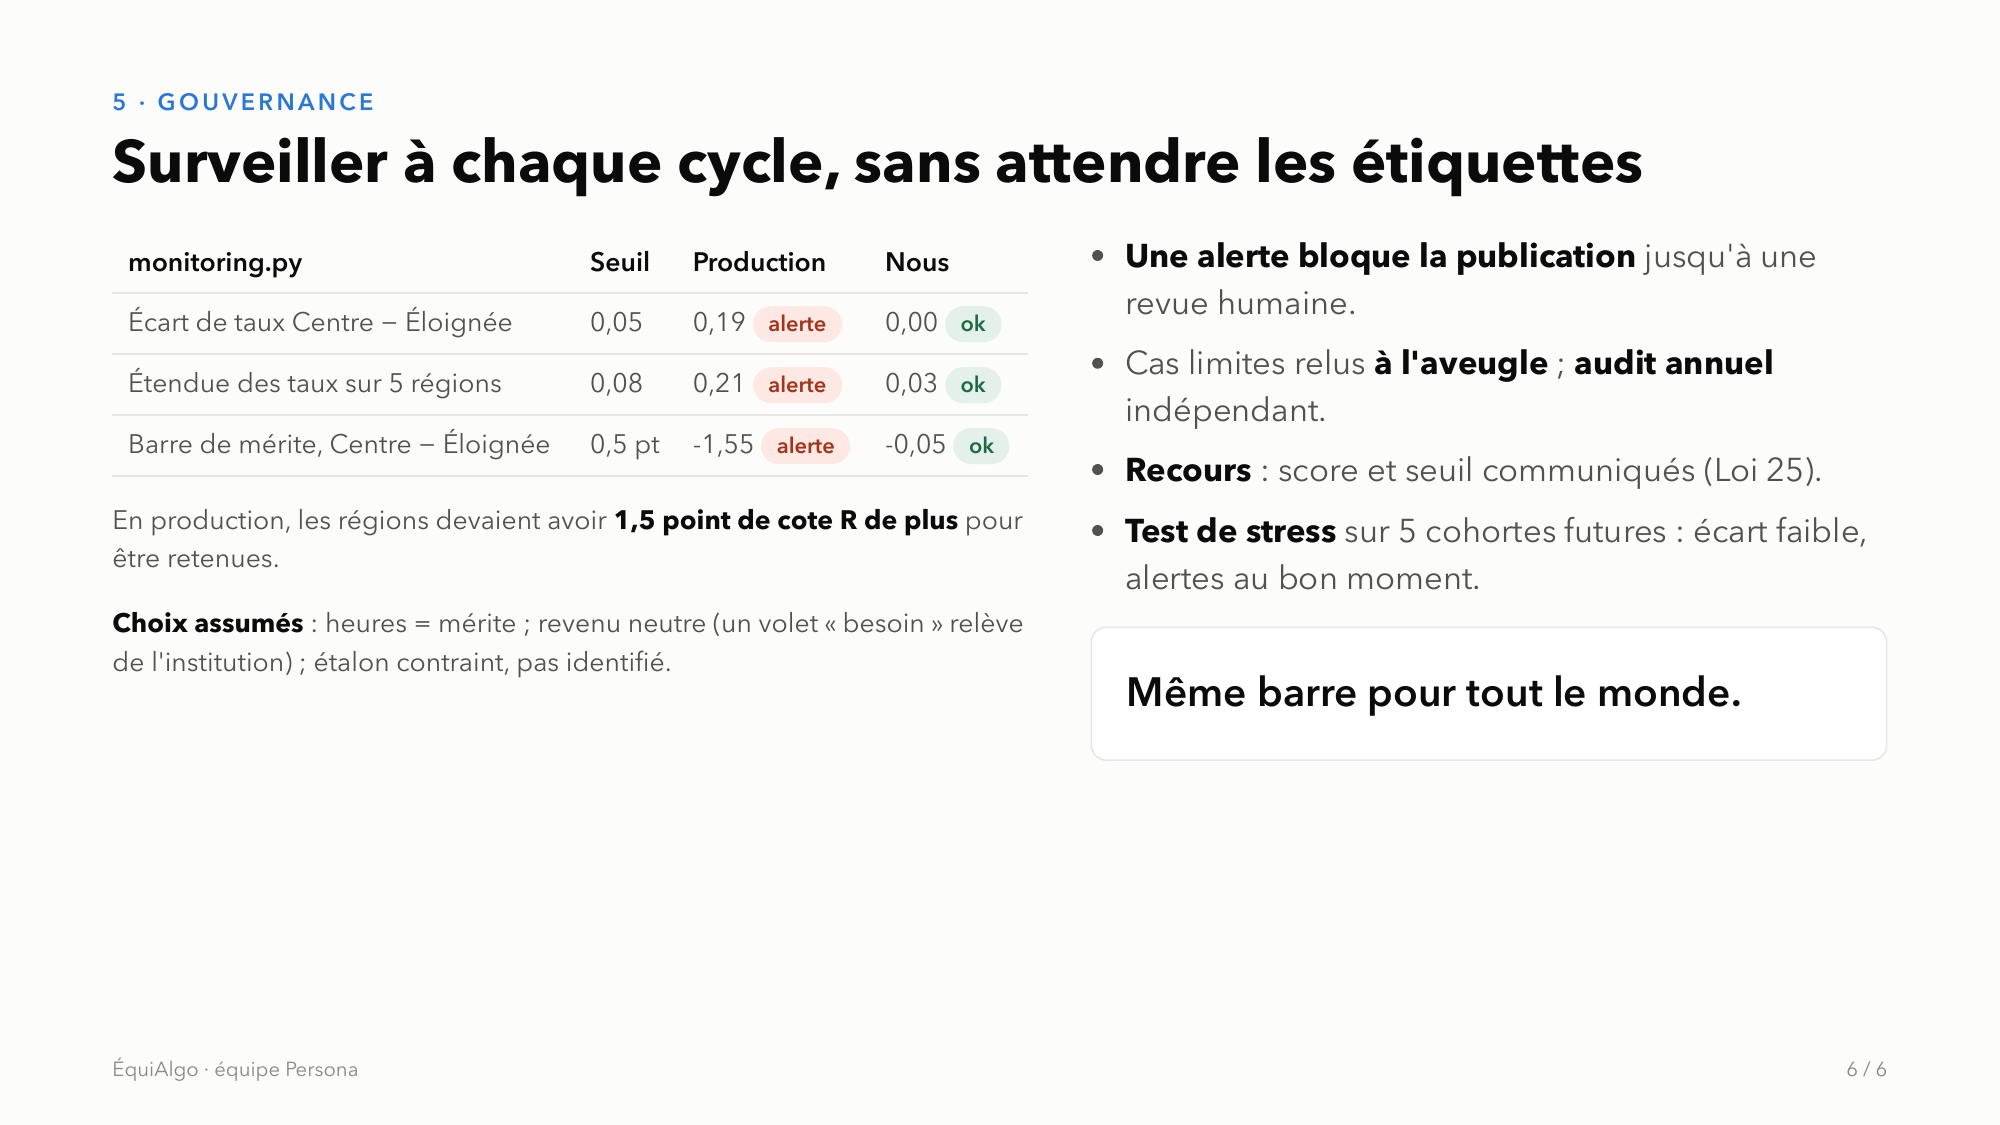
monitoring.py produit un rapport d'équité à chaque cycle, sans attendre d'étiquettes : écarts de taux, barre de mérite par
groupe, dérive des variables. Il aurait levé 3 alertes sur le modèle de production, où les régions devaient franchir une barre
plus haute de 1,5 point de cote R. Une alerte bloque la publication jusqu'à une revue humaine. Les cas limites sont relus à
l'aveugle, un audit annuel compare la règle à un étalon indépendant, et un recours est prévu (Loi 25). Un test de stress sur 5
cohortes futures montre un écart faible sans réentraînement.
## Limites Les heures comptent comme mérite (choix normatif assumé) ; l'étalon est contraint par nos mesures, pas identifié exactement ; audit en deux blocs régionaux ; données synthétiques.
## Outils, sources et modèles Python, pandas, NumPy, scikit-learn, statsmodels (régression logistique), fairlearn (ThresholdOptimizer, ExponentiatedGradient comme comparaisons), matplotlib, Jupyter, pytest. Données et modèle de départ fournis par IVADO. Développement assisté par Claude Code (Anthropic) ; analyses et choix validés par l'équipe.
Built With
- fairlearn
- jupyter
- matplotlib
- numpy
- pandas
- pytest
- python
- scikit-learn
- statsmodels

Log in or sign up for Devpost to join the conversation.