Inspiration
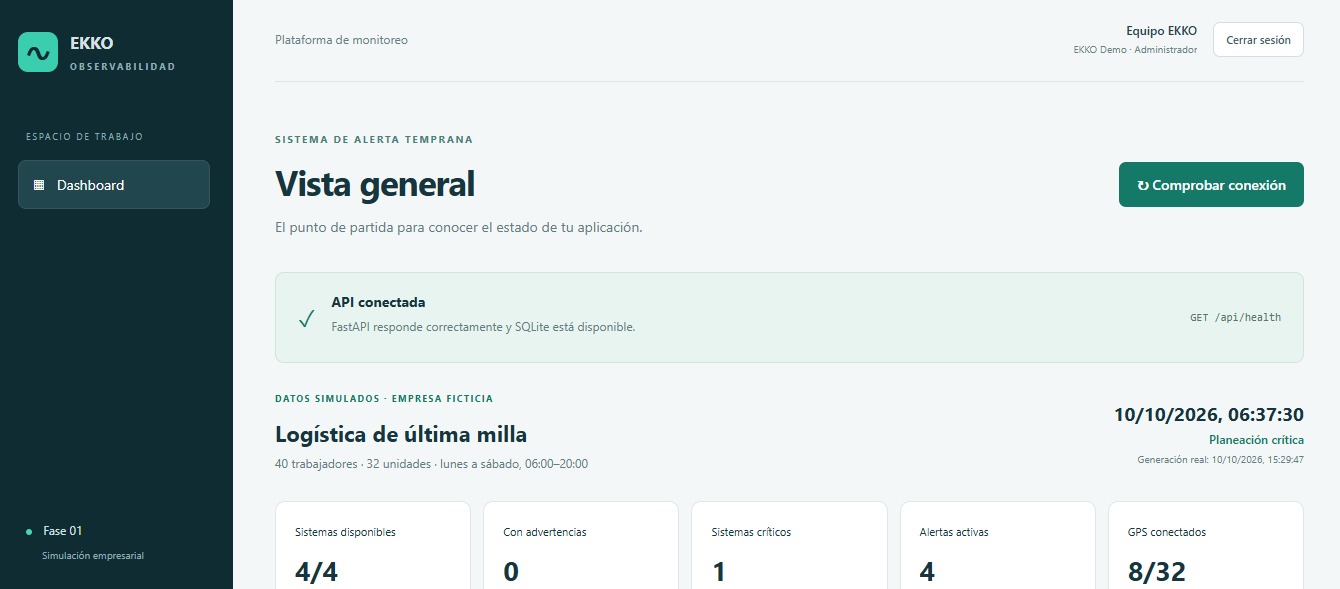
Nos inspiró la idea de adelantarnos a esa llamada: detectar la anomalía, correlacionar sus síntomas en un solo incidente explicable y, cuando sea seguro, intentar una recuperación sin que un humano tenga que estar despierto a las 2 a.m. Modelamos una empresa ficticia realista (40 empleados, 32 unidades GPS, TMS, VPN y app de choferes) para que todo tuviera un contexto creíble en lugar de datos abstractos.
What it does
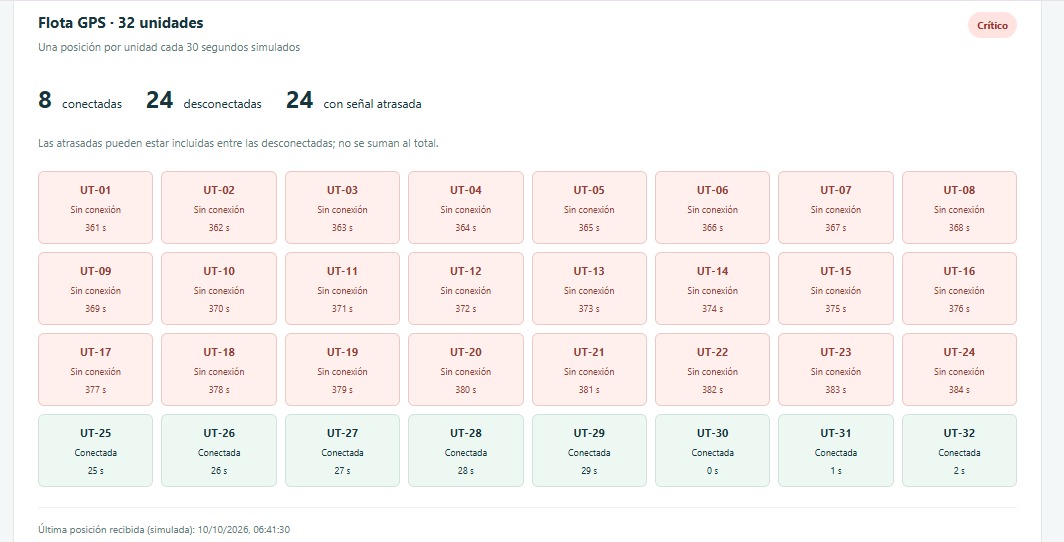
Aprendimos a construir reglas deterministas que agrupan síntomas por causa raíz (shared:srv-tms-01, network:fw-01, etc.) en vez de vender un modelo predictivo que no podíamos justificar. Si no sabemos clasificar algo, se escala a intervención manual en lugar de inventar una acción. Las migraciones de base de datos deben ser aditivas. Aprendimos a usar ALTER TABLE ... ADD COLUMN, tablas e índices nuevos y registro idempotente de migración, de forma que una instalación previa se actualice sin perder una sola fila ni los incidentes históricos. Verificar contra el estado real, no contra el color del frontend. La recuperación solo se da por buena si todas las condiciones anómalas desaparecen de verdad (p. ej. GPS: 32 unidades reconectadas sin posiciones atrasadas), no porque una tarjeta se puso verde. Seguridad por defecto en APIs. Sesiones, CSRF, cabecera propia X-EKKO-Request, roles (admin/analyst/viewer), Cache-Control: no-store y SQL siempre parametrizado. Diseñar los límites también es diseño. Documentar lo que no hace (sin multitenencia, sin infraestructura real, recuperación 100% simulada) nos obligó a ser honestos sobre el alcance.
How we built it
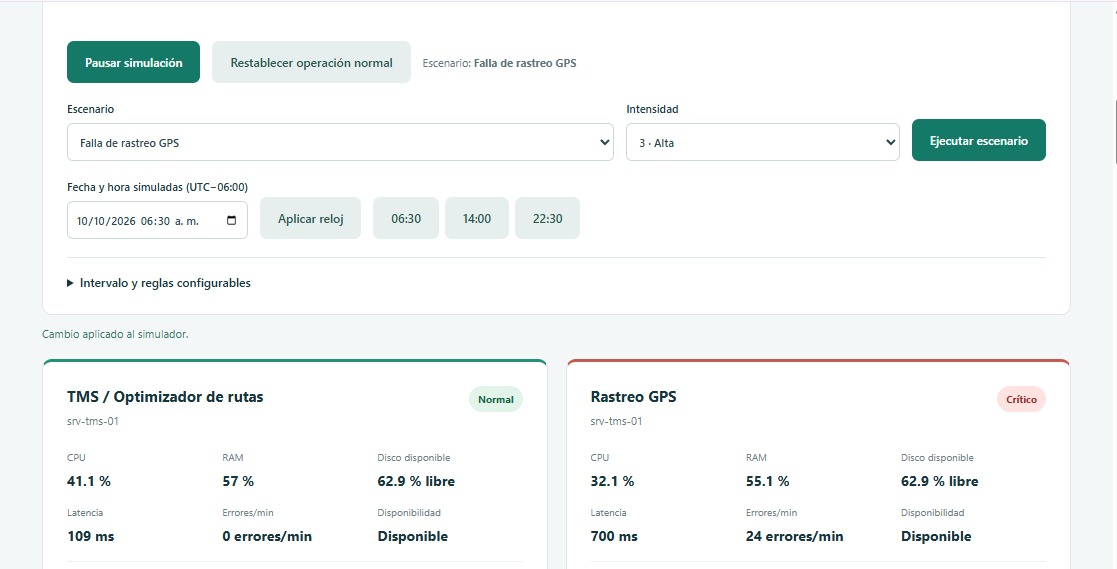
Backend (FastAPI + SQLite): el motor de simulación de Fase 1 sigue siendo el único planificador. Dentro de una sola transacción por muestra se evalúa el mantenimiento, se aplica una etapa de recuperación pendiente, se generan métricas, se evalúan umbrales, se persisten alertas y se correlacionan incidentes. El módulo recovery/ se divide en responsabilidades claras: storage (migración), maintenance (ventanas), policy (correlación y catálogo de acciones), service (transiciones y verificación), models (Pydantic) y routes (API protegida). Máquina de estados de incidentes: detected → active → recovering → recovered → closed, con ramas a recovery_failed y requires_intervention. Máximo 2 intentos, exclusión por servicio mediante bloqueos, y perfiles didácticos (success, failure, partial, fail_once) para demostrar cada escenario. Recuperación simulada: cada acción aplica un efecto numérico persistente sobre las métricas del generador (p. ej. GPS reconecta progresivamente 16→24→32). Nunca ejecuta comandos del sistema, reinicios de procesos ni cambios de firewall: todo vive en SQLite. Bitácora persistente (event_journal): separada de la telemetría, registra detección, severidad, intentos, resultados, escalamientos, cierres y mantenimiento, con origen (automatic/user/simulator). No guarda contraseñas ni tokens. Frontend (React + Vite + Recharts): conserva el login y el dashboard de Fase 1. En esta fase el foco fue la API; las pantallas de incidentes/bitácora quedan para Fase 2B. Verificación: 71 pruebas backend, 6 del cliente HTTP, build, prueba en navegador real y una prueba de persistencia con dos procesos Uvicorn sucesivos.
Challenges we ran into
Correlación con dependencias cruzadas: que un fallo de VPN arrastre a la app móvil solo cuando el escenario expresa esa dependencia, sin falsos positivos. Mantenimiento inteligente: una ventana sembrada (10/10/2026, 22:00–23:00) donde la caída esperada del servidor compartido es informativa, pero una sobrecarga TMS propia a esa misma hora no se silencia. Reemplazamos la regla ingenua de Fase 1 de "todo lo nocturno es mantenimiento". No permitir reintentos infinitos: agotar el límite escala a intervención; los intentos cancelados también cuentan, así nadie elude el tope. Reloj simulado que puede retroceder: calcular duración no negativa conservando el máximo alcanzado aunque el usuario mueva el reloj hacia atrás. Compatibilidad hacia atrás: mantener status=open/resolved para incidentes viejos mientras introducimos workflow_status detallado, sin inventar transiciones para el historial. Habilitación segura: la recuperación automática arranca desactivada para no romper el comportamiento de Fase 1; se enciende explícitamente por API.
Accomplishments that we're proud of
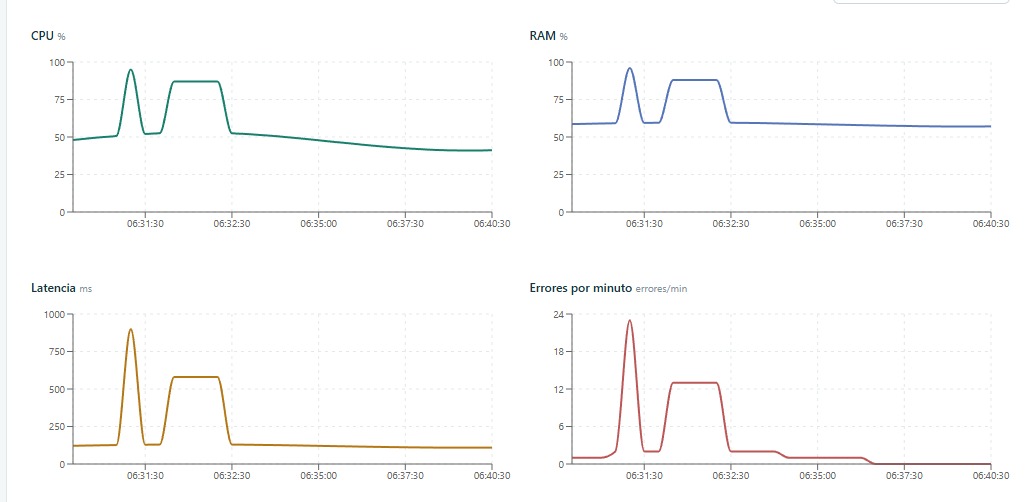
Correlación explicable que de verdad funciona. Logramos agrupar síntomas dispersos (CPU, RAM, disco, errores, disponibilidad, flota GPS) en un solo incidente con causa raíz clara (shared:srv-tms-01, network:fw-01), y que las dependencias cruzadas (VPN → app móvil) solo se activen cuando el escenario realmente lo justifica. Cero "IA mágica", todo justificable. Recuperación simulada verificada contra el estado real. Un incidente solo se cierra cuando todas las condiciones anómalas desaparecen de verdad (por ejemplo, GPS: 32 unidades reconectadas sin posiciones atrasadas), nunca porque una tarjeta se puso verde. Migración aditiva sin pérdida de datos. Una instalación de Fase 1 se actualiza a Fase 2A sin perder una sola fila ni los incidentes históricos, con registro de migración idempotente y claves foráneas verificadas. Máquina de estados robusta y a prueba de abusos. Transiciones validadas y registradas cronológicamente, tope de 2 intentos, bloqueos de exclusión por servicio y ninguna forma de provocar reintentos infinitos (hasta los intentos cancelados cuentan). Mantenimiento "inteligente". Reemplazamos la regla ingenua de Fase 1 ("todo lo nocturno es mantenimiento") por una ventana sembrada que distingue la caída esperada de un fallo real a la misma hora. Seguridad por defecto. Sesiones, CSRF, cabecera propia, roles (admin/analyst/viewer), Cache-Control: no-store y SQL siempre parametrizado. Verificación seria. 71 pruebas backend, 6 del cliente HTTP, build, prueba en navegador real y una prueba de persistencia con dos procesos Uvicorn sucesivos. Honestidad de alcance. Documentamos con claridad lo que el sistema no hace, para no prometer de más.
What we learned
Verificar contra el estado real, no contra el frontend. El "verde" se gana con métricas, no se asume. Diseñar los límites también es diseño. Escribir lo que queda fuera de alcance nos hizo tomar mejores decisiones. Seguridad desde el primer endpoint, no como un parche al final. El tiempo simulado es traicionero: calcular duraciones correctas cuando el reloj lógico puede retroceder nos obligó a conservar el máximo alcanzado.
What's next for EKKO
Pantallas nuevas en el frontend: vistas dedicadas de incidentes, bitácora y recuperaciones, hoy la lógica vive en la API pero sin UI propia. Presentación visual y recorrido de demostración automático, para mostrar el flujo completo sin comandos manuales de PowerShell. Editor de calendario de mantenimiento: hoy el plan es fijo y solo se consulta por API. Modelado de fallas múltiples e independientes a la vez (actualmente el simulador mantiene un escenario activo por vez). Retención automática y auditoría más robusta de la bitácora (hoy un admin con acceso directo al archivo SQLite podría modificarla). Pruebas de carga prolongada y endurecimiento para escenarios de mayor volumen. Explorar multitenencia / aislamiento por empresa y, eventualmente, conexión a infraestructura real (hoy todo es simulado sobre datos ficticios).

Log in or sign up for Devpost to join the conversation.