Inspiration
El teléfono sigue siendo la puerta de entrada del banco, sobre todo para la gente que no usa apps. Y ya no es una puerta segura, con unos segundos de audio público, cualquiera puede clonar una voz. Nos hicimos una pregunta simple: ¿cómo sabe un banco, que al otro lado de la línea hay una persona real?
What it does
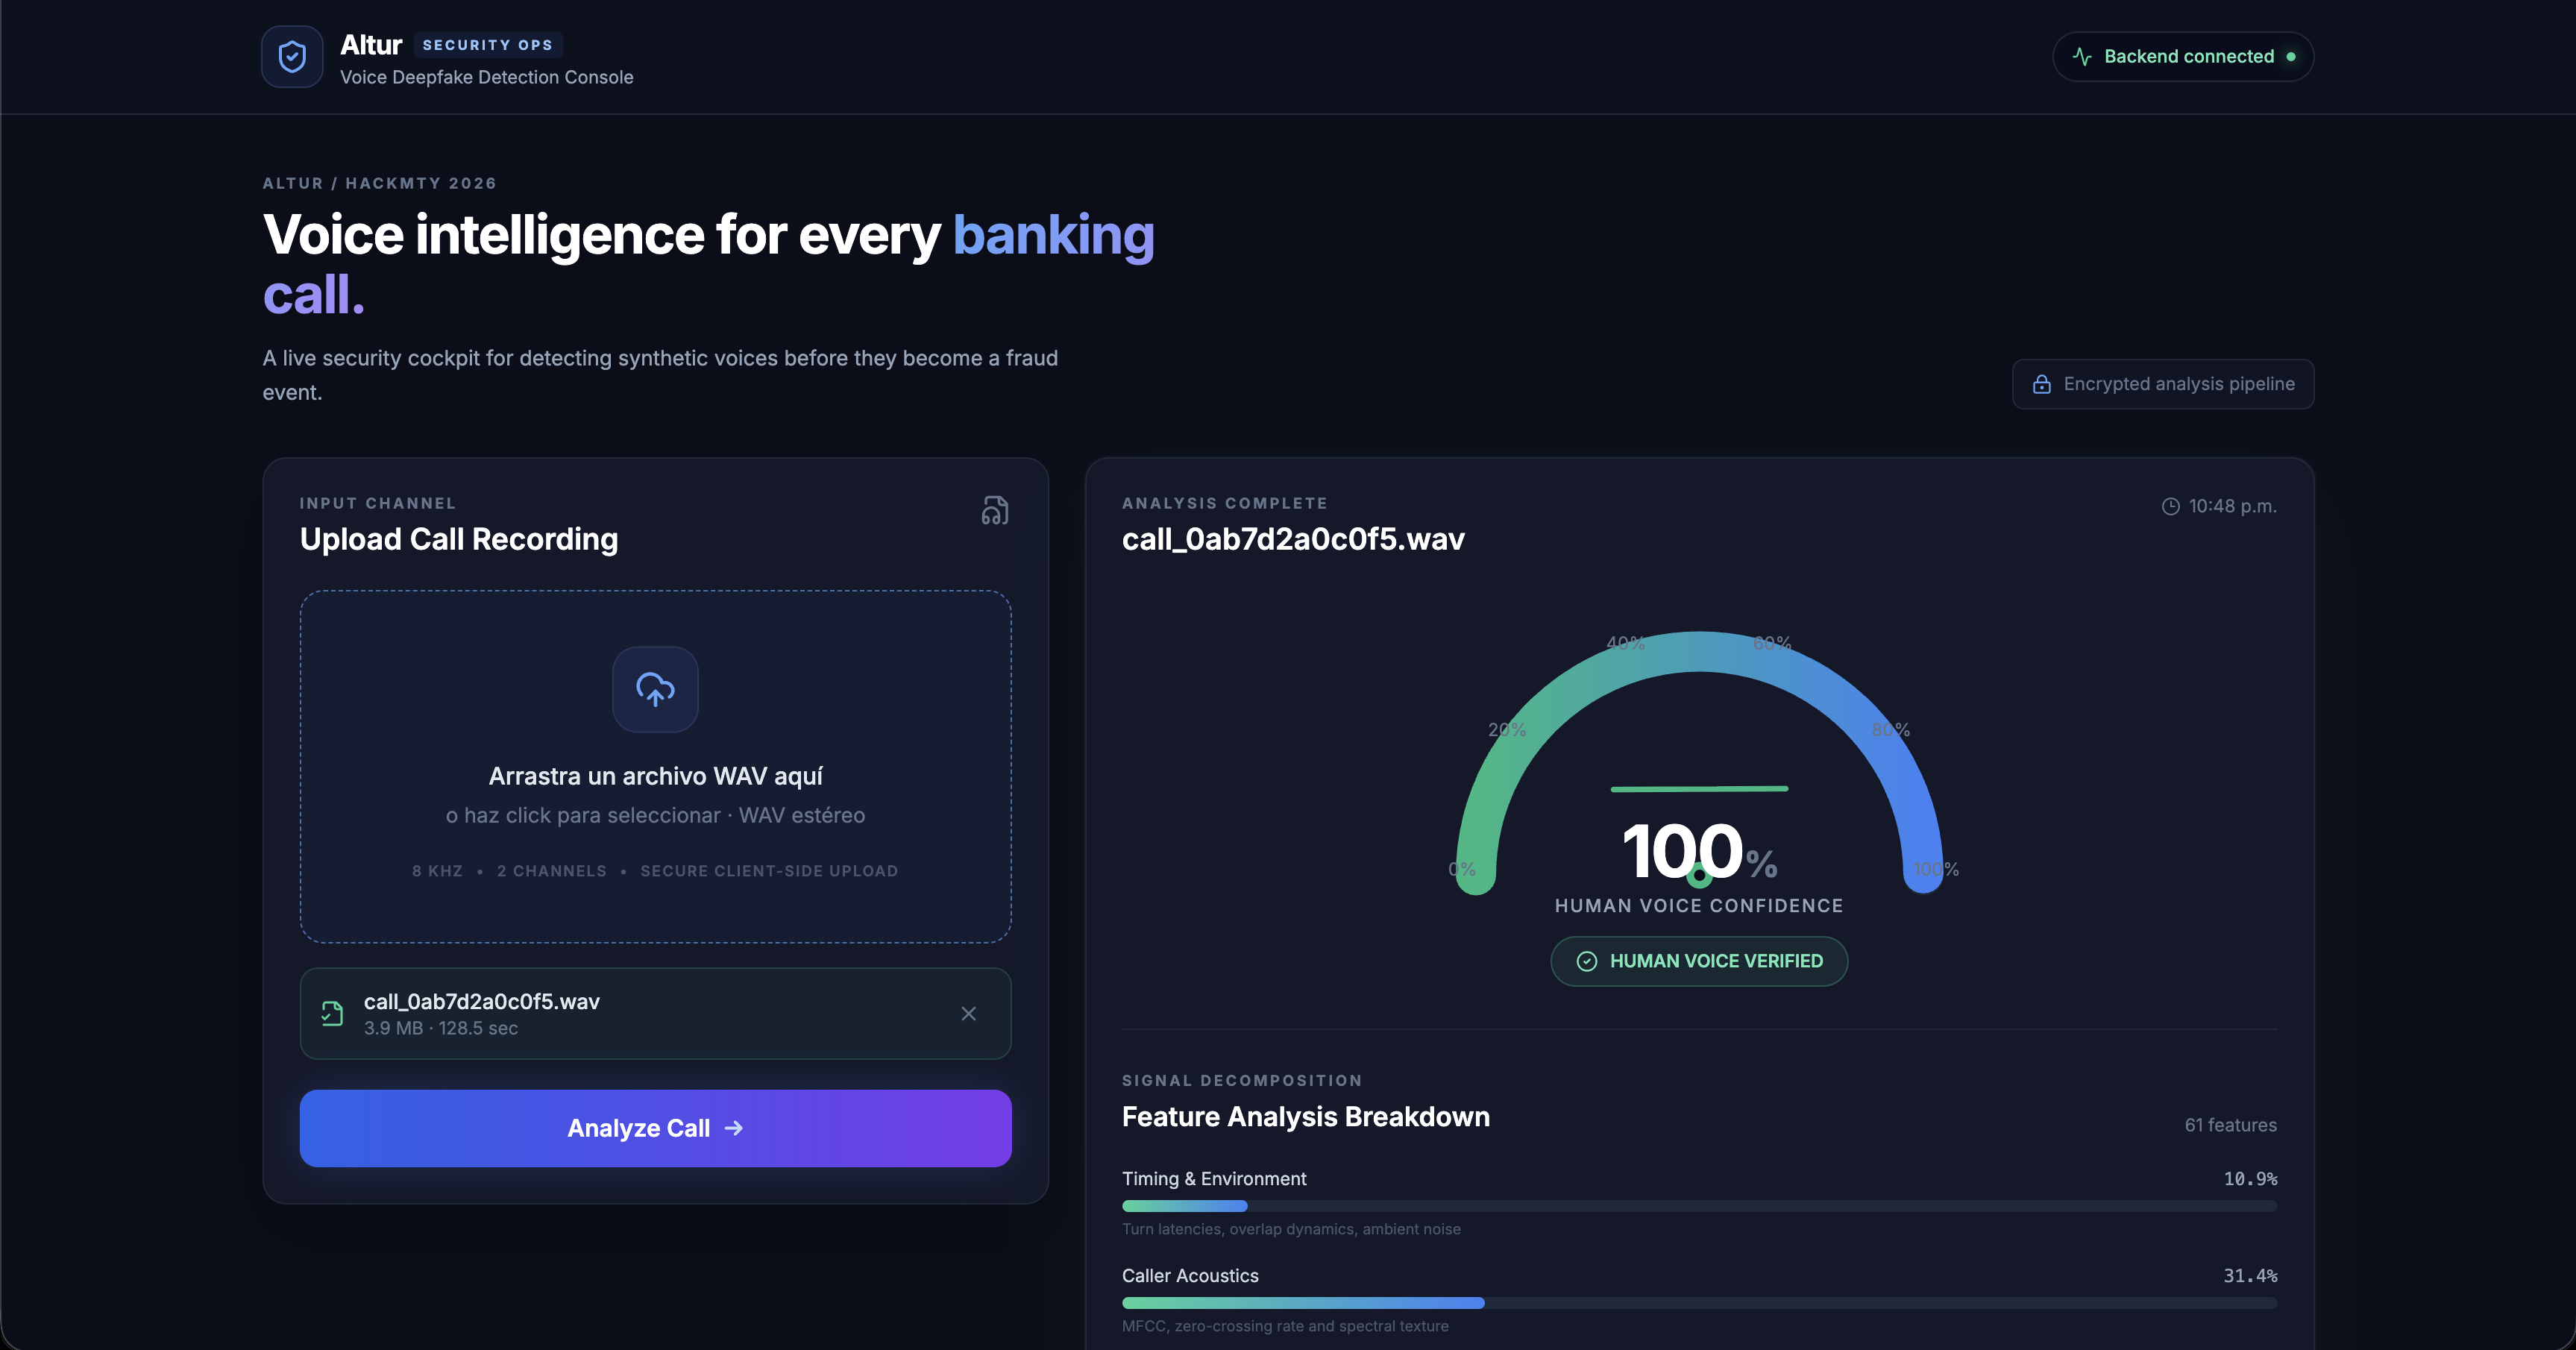
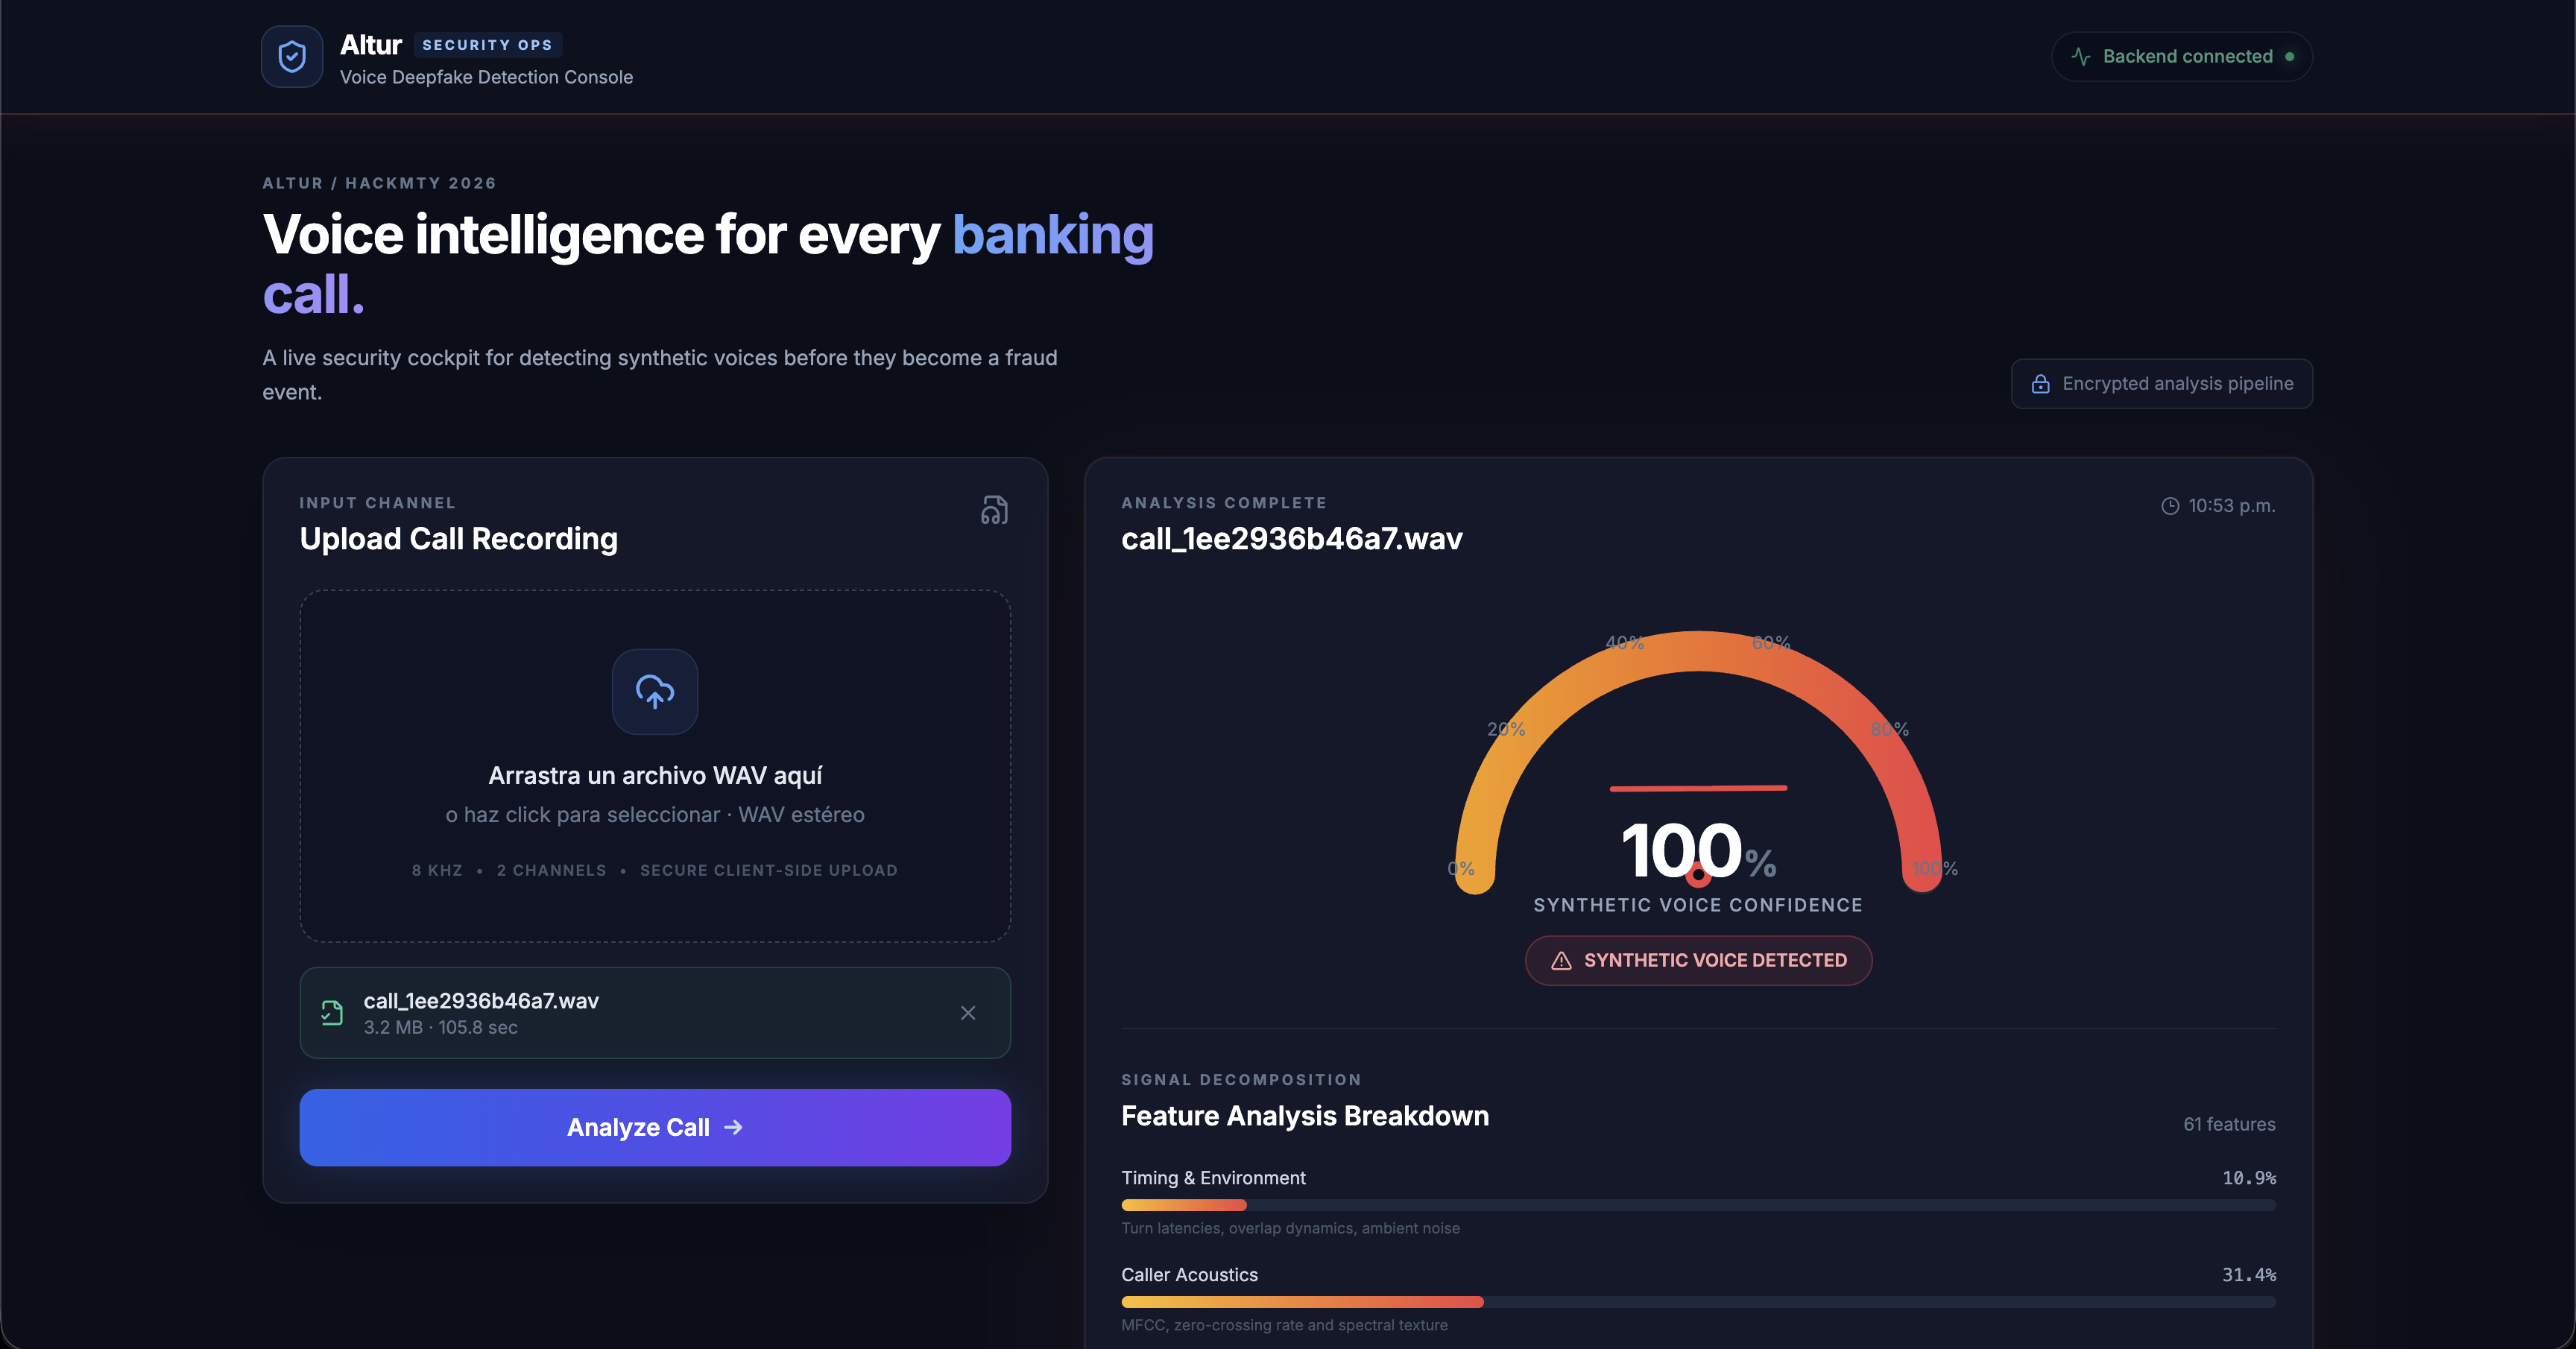
VoiceShield escucha una llamada bancaria y decide si el que llama es humano o una voz sintética. Analiza tres cosas al mismo tiempo: cómo suena la voz, cómo se comporta en la conversación (interrupciones, turnos, latencias) y qué dice exactamente (titubeos, repeticiones). Devuelve un veredicto con nivel de confianza calibrado y una acción recomendada: dejar pasar la llamada o disparar una verificación por WhatsApp.
How we built it
Backend en FastAPI con un modelo de gradient boosting calibrado. Tres capas de features:
- Acústica: MFCCs, spectral bandwidth, ZCR. La voz humana varía mucho más dentro de una frase; un TTS es demasiado consistente.
- Comportamiento conversacional: aprovechamos los dos canales del audio (llamante y agente) para medir interrupciones, latencias y solapamiento.
- Semántica: transcribimos con Whisper y detectamos cosas que un LLM no hace, como repetir palabras ("sí sí sí") o titubear.
Frontend en React + TypeScript con un dashboard oscuro: gauge animado, radar de las 6 categorías, historial y breakdown dinámico por análisis.
Challenges we ran into
Whisper tardaba demasiado al reentrenar. Metimos un cache en disco por llamada: pasamos de 2 horas a 30 segundos.
Accomplishments that we're proud of
- Confianza calibrada y útil, no solo un sí/no.
- Breakdown dinámico: cada análisis muestra qué features pesaron más, no valores fijos.
- Sistema modular que combina señales ortogonales, si una es engañada, las otras dos siguen defendiendo.
- Latencia de ~2 segundos por llamada.
What we learned
Que la detección de deepfakes de voz no se resuelve con un clasificador más grande. Se resuelve combinando señales que fallan por razones distintas. La voz es acústica, pero también es conversación y es contenido.
Función secundaria: Detección de voz en tiempo real
También desarrollamos un detector experimental de voz en tiempo real, disponible en la rama "live-feature". El sistema captura audio directamente desde el micrófono, lo procesa en ventanas cortas y superpuestas, extrae espectrogramas Log-Mel y utiliza un clasificador CNN empleado en el análisis de audio. Las predicciones se combinan mediante suavizado e histéresis, permitiendo acumular evidencia en lugar de reaccionar a cada ventana individual.
Debido a que cada predicción utiliza una cantidad limitada de audio, la precisión por segundo puede ser inconsistente. Sin embargo, cuando una persona habla continuamente durante ~5 segundos o más, las predicciones acumuladas se vuelven considerablemente más estables y precisas.
Esta función es una característica experimental secundaria y no el método principal de evaluación. El análisis mediante archivos de audio continúa siendo el método más confiable.
Built With
- audio-processing
- docker
- fastapi
- javascript
- machine-learning
- numpy
- pandas
- python
- react
- typescript
- vite
Log in or sign up for Devpost to join the conversation.