-
-
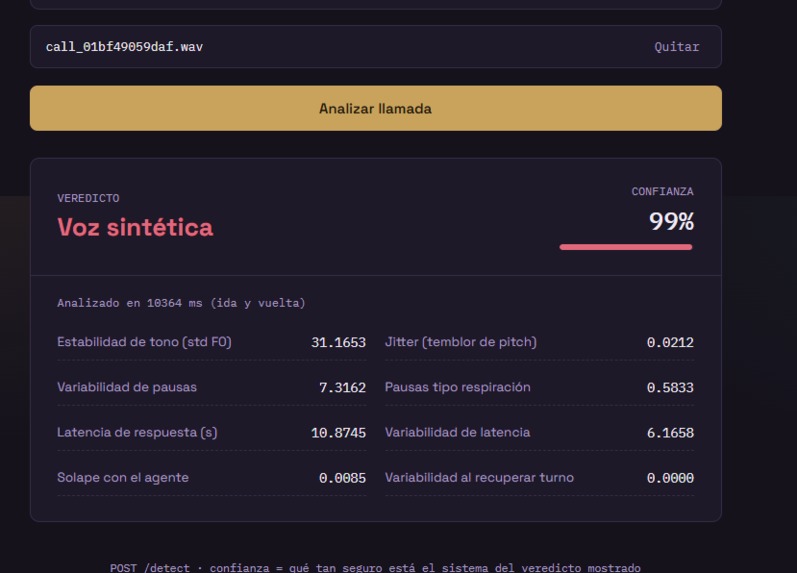
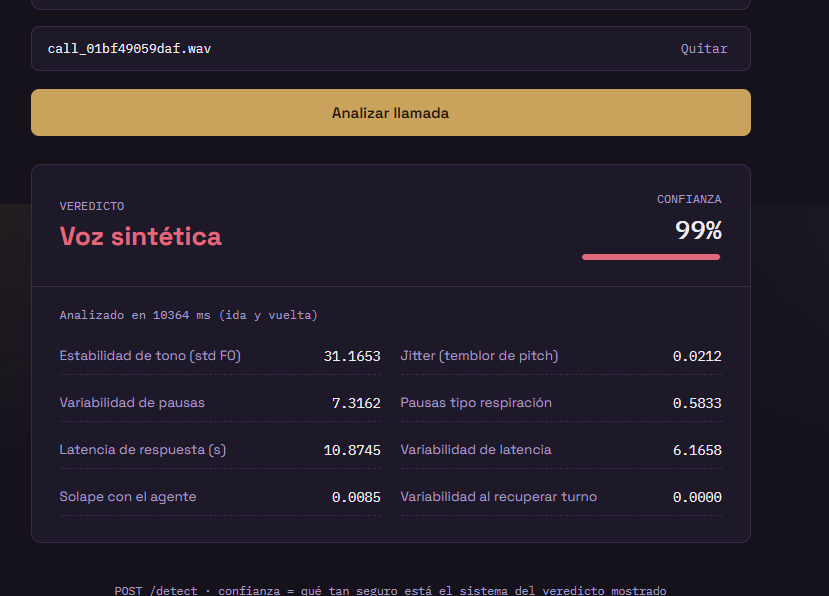
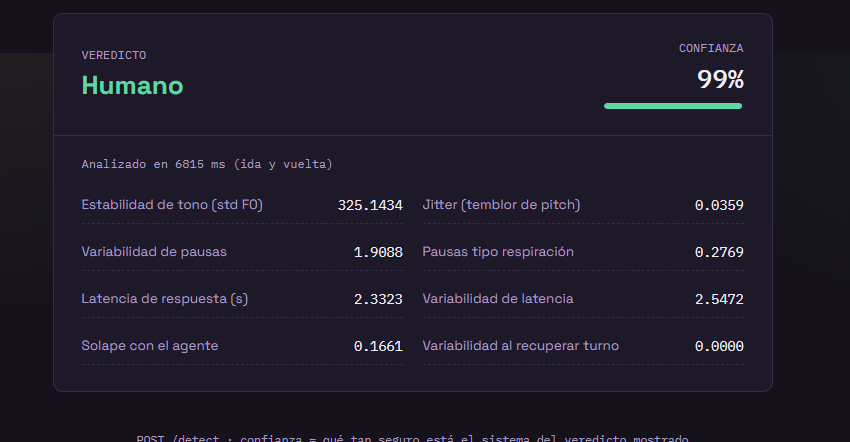
Resultado de la llamada
-
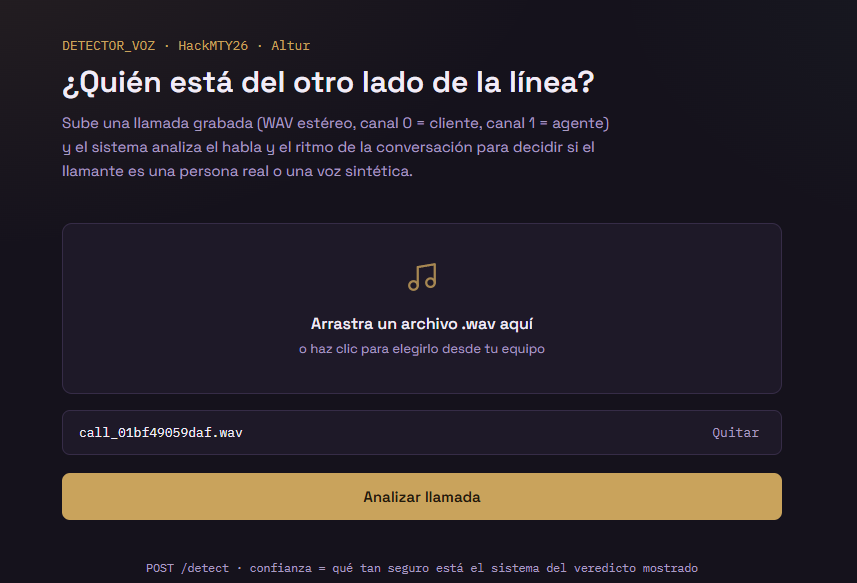
Selección de otra llamada
-
Inicio del proyecto
-
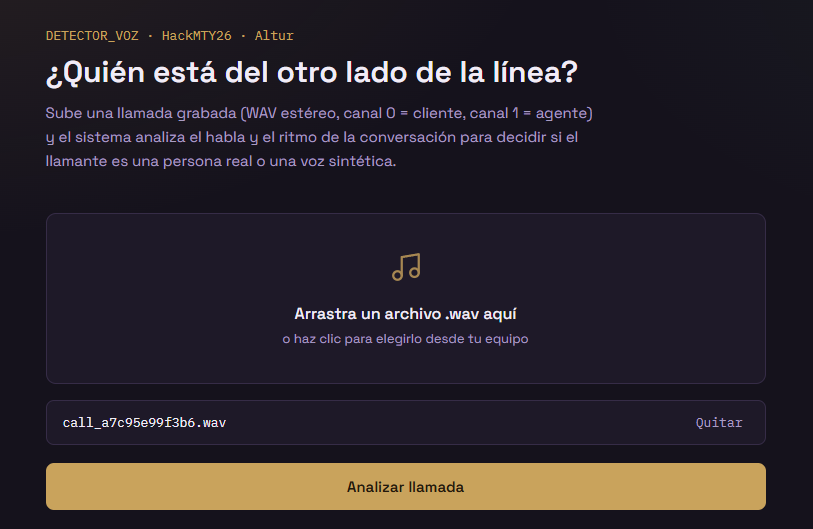
Selección de una llamada
-
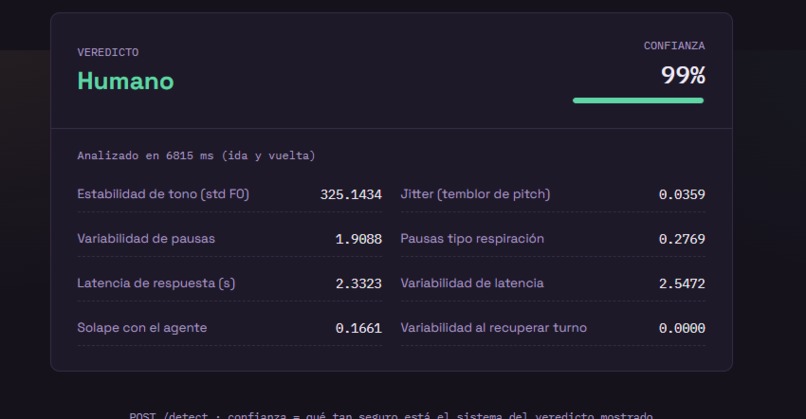
Resultado de la otra llamada
Inspiración
El teléfono sigue siendo la única puerta de entrada al banco para millones de personas en América Latina — las que no usan o no pueden usar una app. Hoy, con unos segundos de audio público, cualquiera puede clonar una voz lo suficientemente bien para engañar a una persona o a una máquina. Nos inspiró proteger justo a quienes no tienen otra opción: si la línea deja de ser confiable, son ellos los que más pierden.
Qué hace
detector_voz recibe una llamada grabada y decide si quien llama es una persona real o una voz sintética, combinando tres señales:
- Acústica: estabilidad del tono, jitter, planitud espectral, respiración natural.
- Conversacional: qué tan irregular es el llamante al recuperar la palabra tras una interrupción del agente (un humano es rápido pero desordenado; una máquina es consistente, y esa consistencia es la pista).
- Semántica: si el agente pregunta algo, ¿el llamante admite "no sé" o inventa una respuesta con demasiada seguridad?
Cómo lo construimos
Python + Flask, con librosa para el análisis de audio y un RandomForest de scikit-learn entrenado con el dataset de llamadas etiquetadas de Altur. Le agregamos una interfaz web para probar llamadas a mano, y validamos todo contra el script oficial del juez para asegurar que el contrato de respuesta y los tiempos fueran exactos.
Retos que enfrentamos
El más grande fue la latencia: nuestro primer análisis de tono tardaba más de 30 segundos en llamadas largas, justo el límite del reto. Cambiamos el algoritmo de extracción de tono y acotamos el análisis, bajando el tiempo de +37s a menos de 12s por llamada.
Qué aprendimos
Que las señales más simples y explicables (una pausa, un silencio, una duda) pueden decir tanto como un modelo sofisticado — y que en un sistema pensado para un banco, poder explicar por qué se marcó una llamada como sospechosa importa tanto como acertar.

Log in or sign up for Devpost to join the conversation.