-
-
Decilo — subtítulos en vivo para que ninguna idea quede afuera.
-
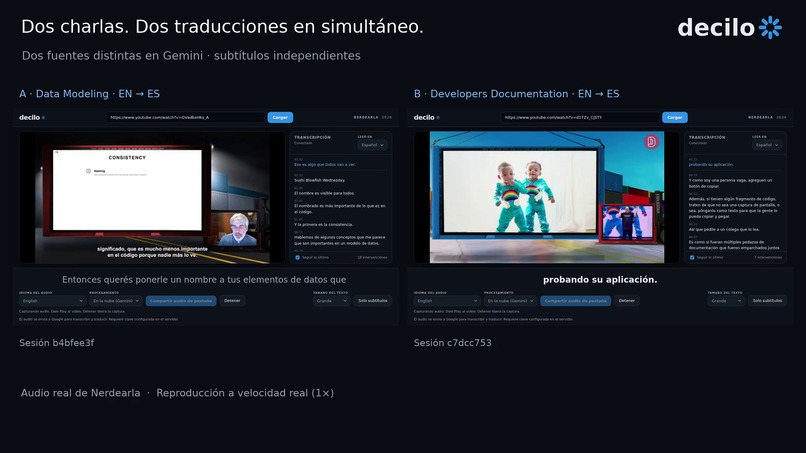
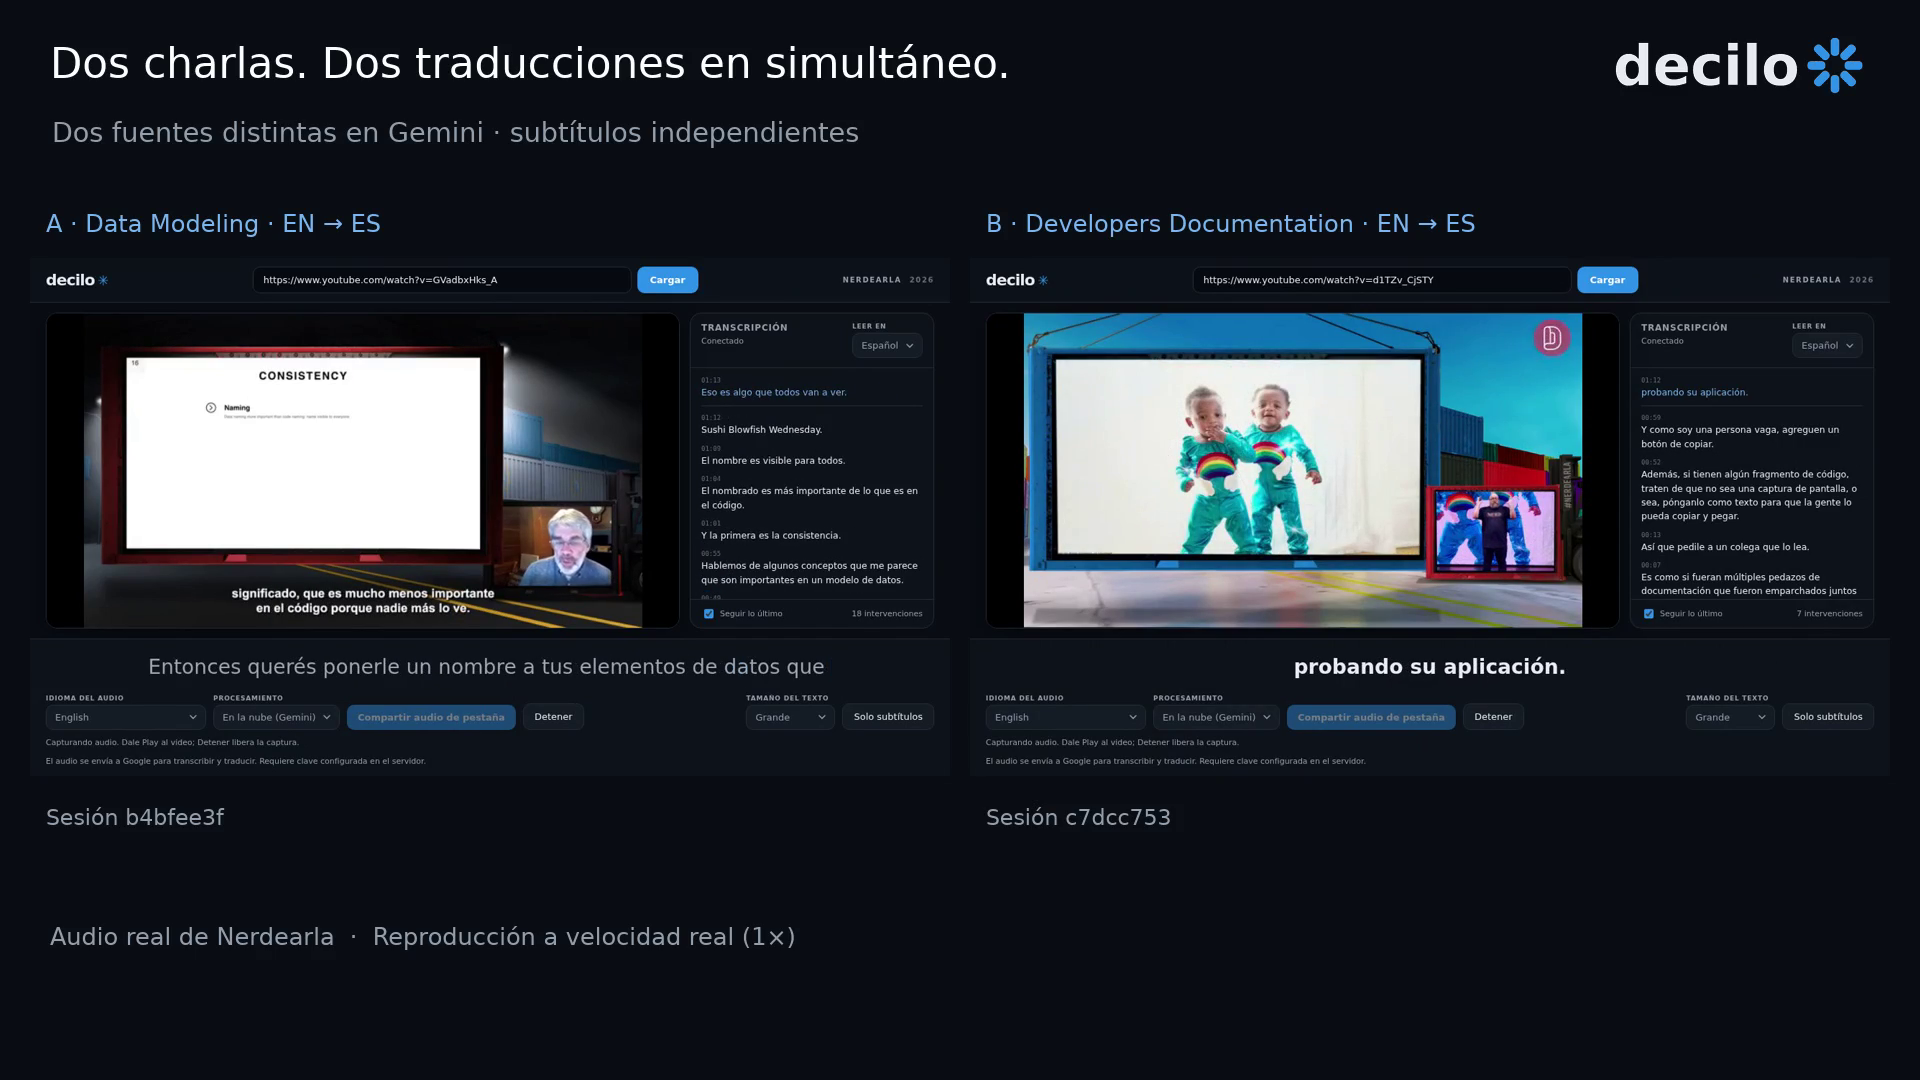
Dos charlas EN→ES en nube, con audio y subtítulos independientes. Captura del mismo intervalo real.
-
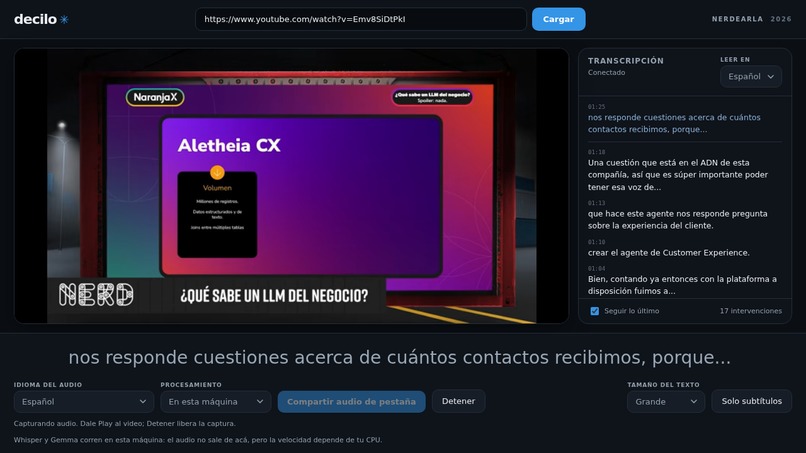
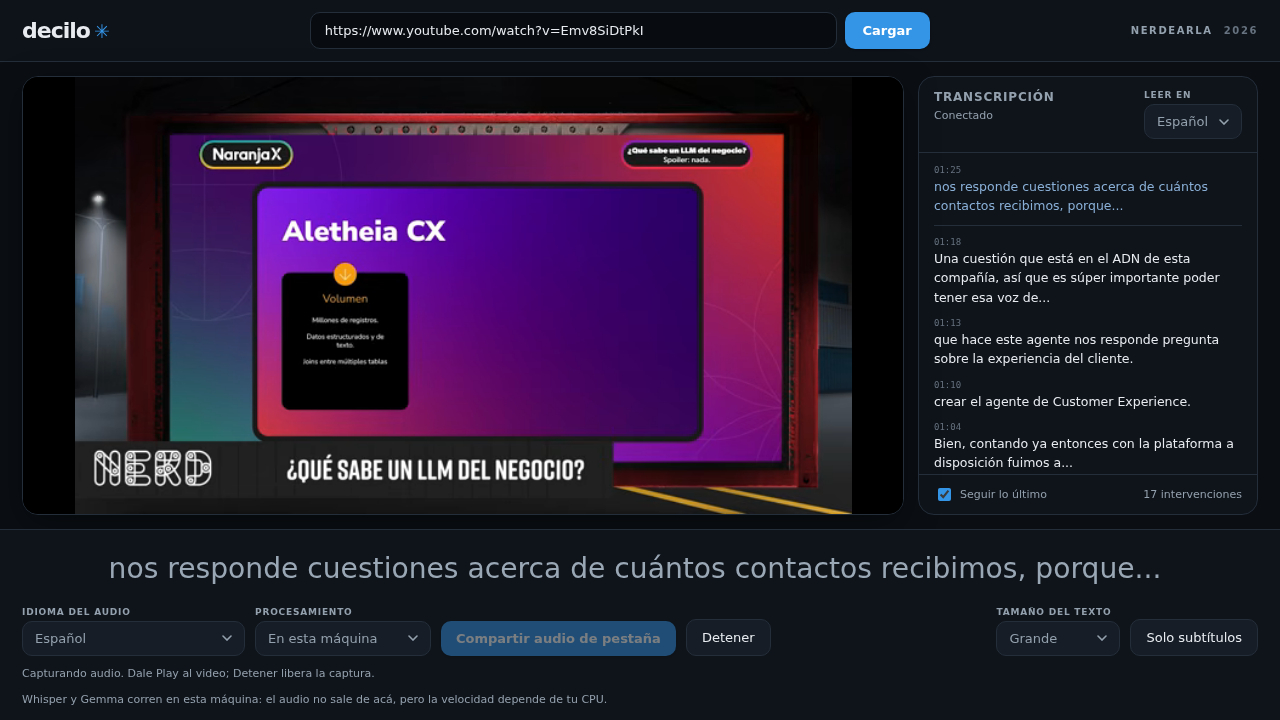
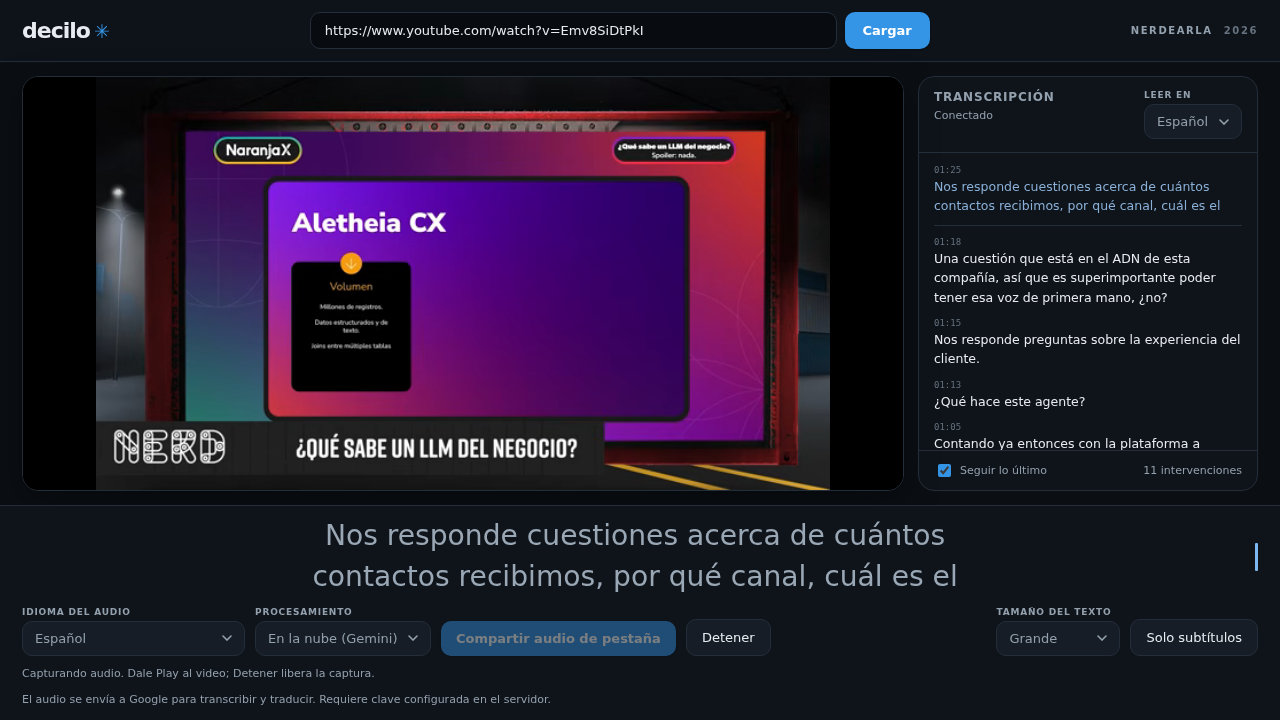
Modo local: transcripción de una charla en español con Whisper e historial reciente.
-
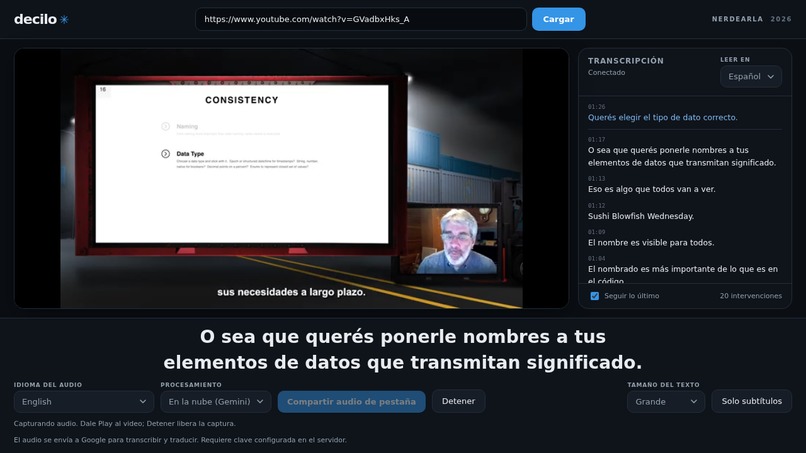
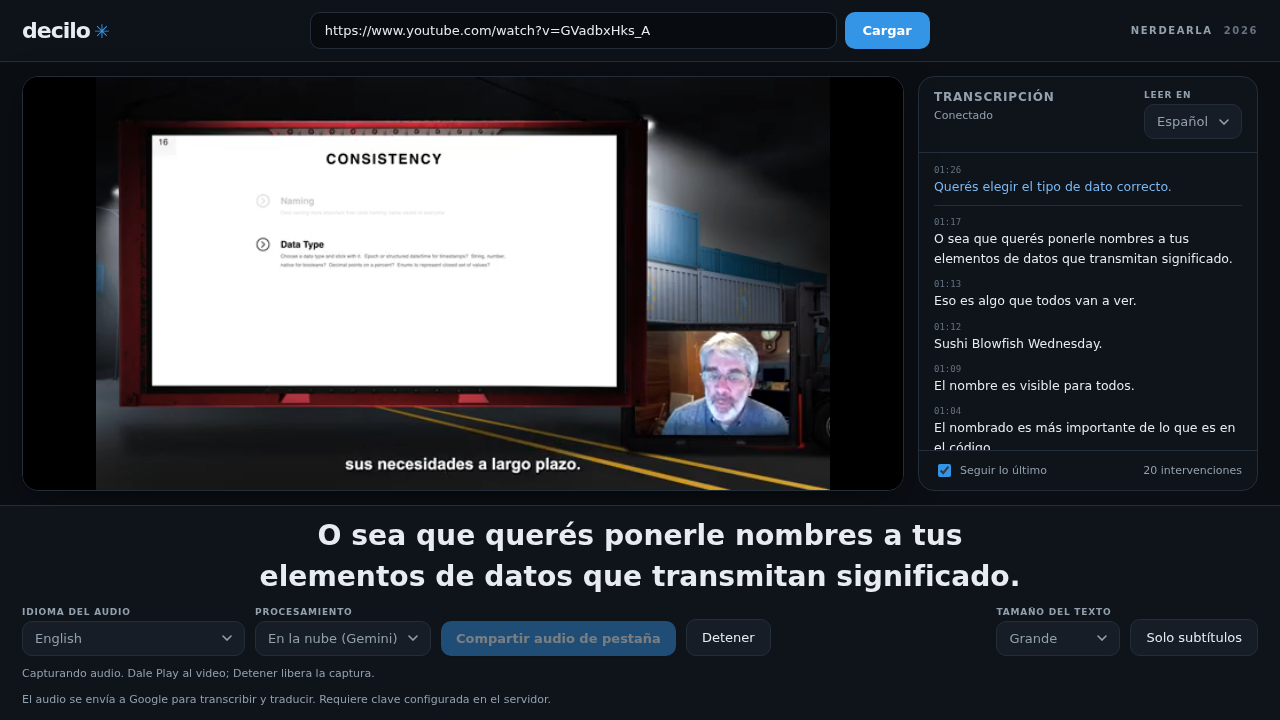
Modo nube: charla en inglés, traducción al español y texto incremental con Gemini.
-
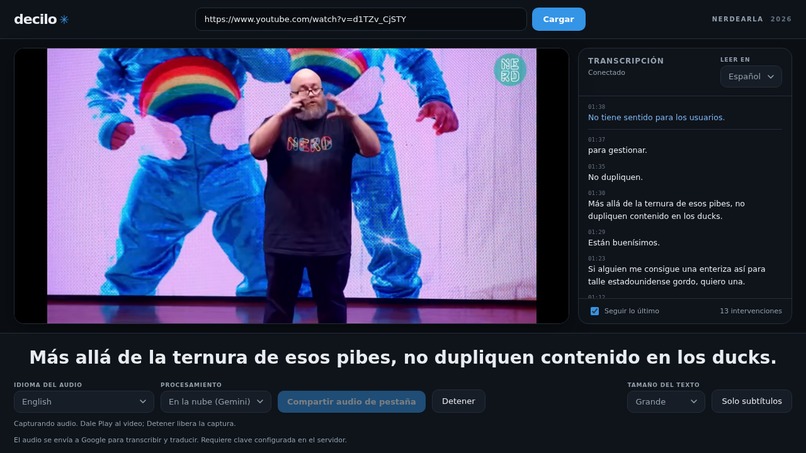
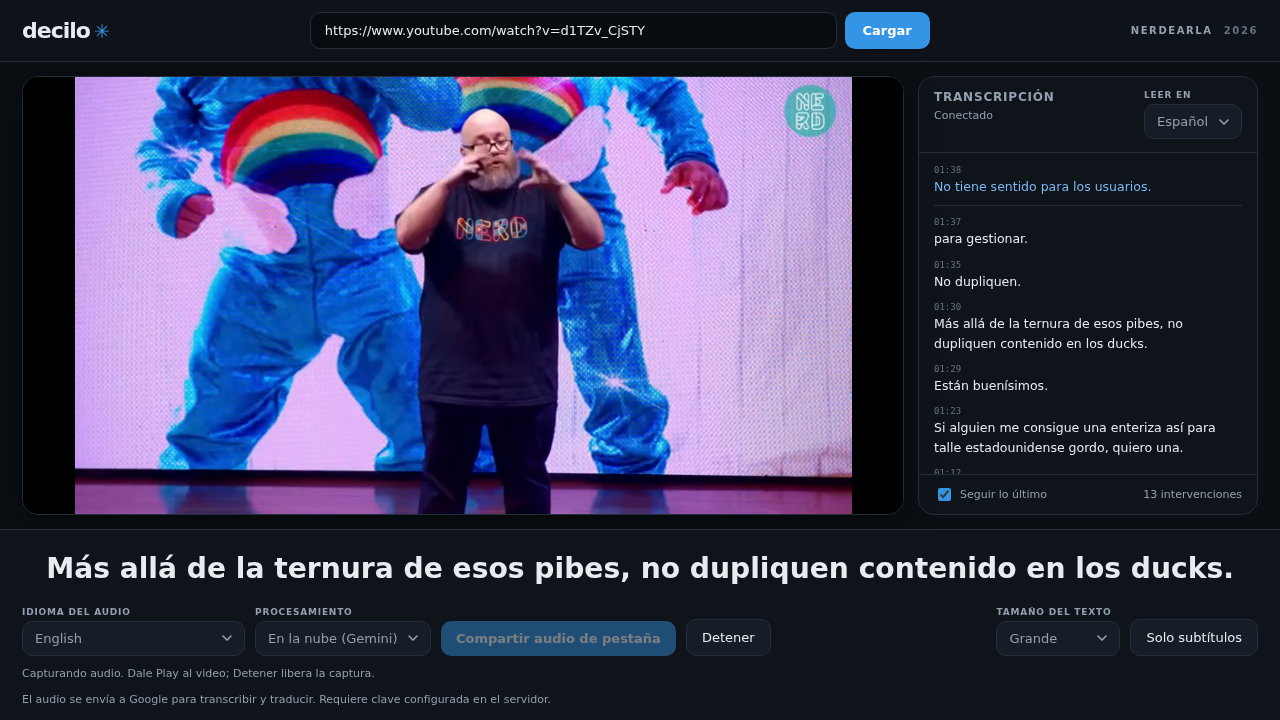
Otra fuente en inglés: Developers Documentation, con su propia sesión y traducción.
-
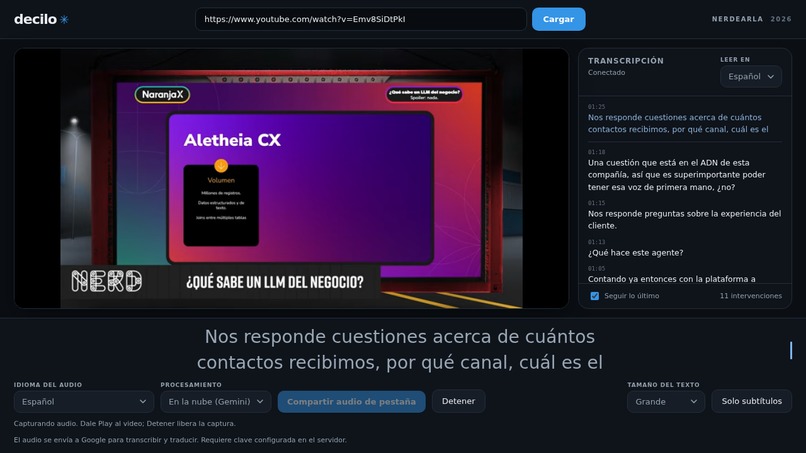
Transcripción original en español con Gemini Live; selección del proveedor desde la interfaz.
-
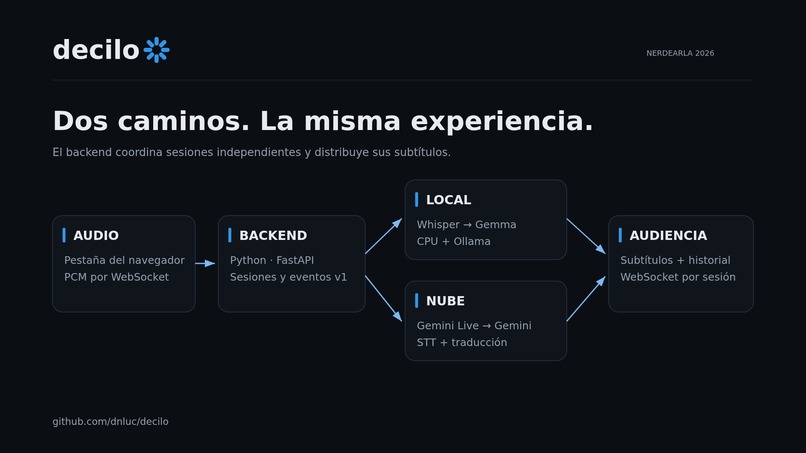
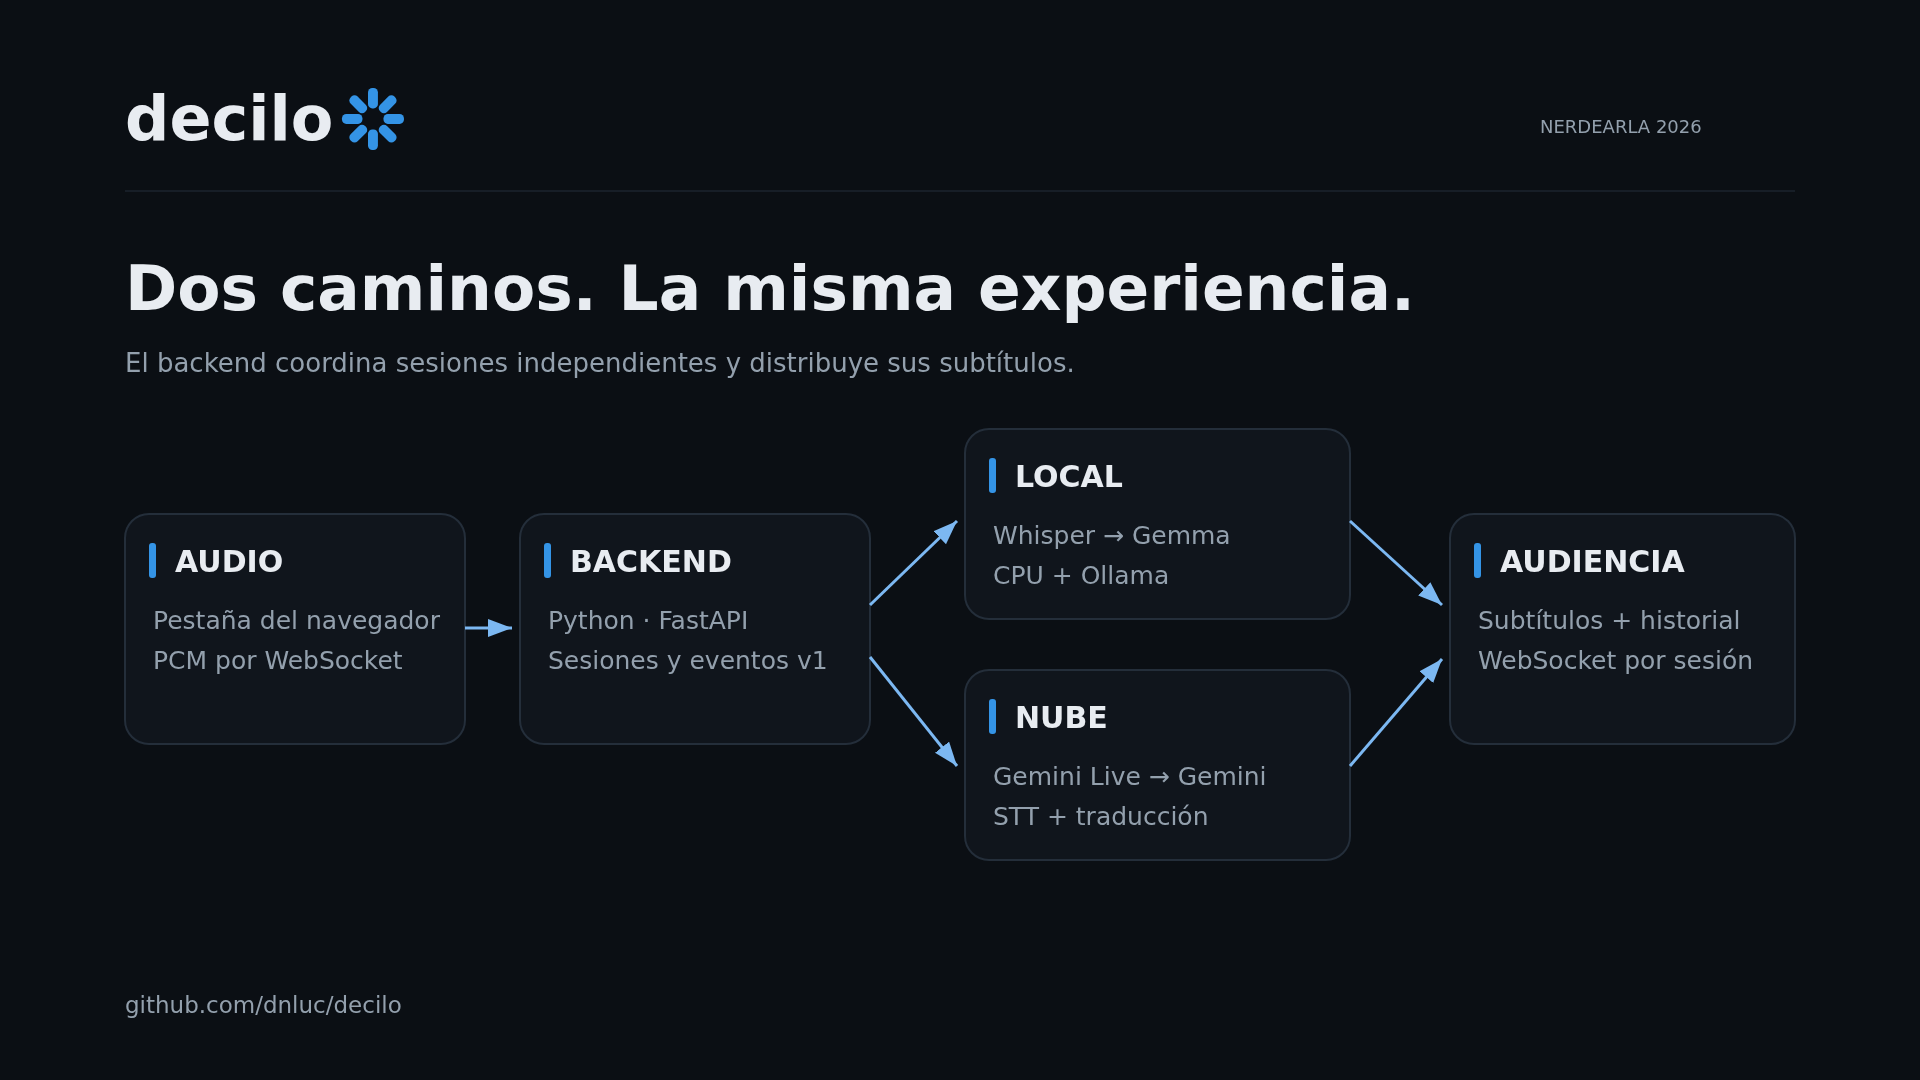
Arquitectura: audio por WebSocket, backend Python/FastAPI, motores local/nube y audiencias por sesión.
Inspiración
Una charla técnica puede abrirte una puerta. El idioma o la dificultad para seguir el audio no deberían dejarte afuera. Decilo nace para hacer más accesibles conferencias como Nerdearla: una solución abierta que los organizadores puedan instalar y adaptar a sus escenarios.
Nuestra idea guía es avanzar hacia unidades de sentido, en lugar de depender solamente de cortes arbitrarios de audio, y mostrar resultados progresivos mientras llega más contexto.
Qué hace
Decilo recibe audio real de una pestaña del navegador y produce subtítulos con historial reciente. Permite:
- Transcribir en el idioma original, inglés o español, y traducir de inglés a español.
- Elegir desde la interfaz procesamiento local con Whisper y Gemma, o en la nube con Gemini.
- Mantener varias sesiones de captura independientes. Otros espectadores pueden seguir una misma sesión sin duplicar la inferencia.
- Mostrar texto provisional y confirmado, traducción incremental, selección de idioma de lectura, tamaño de texto y modo de solo subtítulos.
- Recuperar el estado de una sesión después de una reconexión.
Para probarlo: seguí el README, abrí Decilo en Chrome, pegá una charla de YouTube, elegí el idioma y el proveedor, y compartí el audio de esa pestaña. Para dos charlas, repetí el recorrido en otra pestaña con una fuente distinta.
Cómo lo construimos
El navegador captura audio mediante getDisplayMedia y un AudioWorklet. Envía PCM16 mono a 16 kHz en paquetes de 100 ms por WebSocket. El backend Python + FastAPI + asyncio coordina sesiones, procesamiento y distribución de eventos. La interfaz usa JavaScript, HTML, CSS y Vite.
En local, faster-whisper genera hipótesis y transcripciones finales; Gemma 3n e2b mediante Ollama traduce. En nube, Gemini Live recibe el audio continuo y Gemini traduce el texto. Las credenciales permanecen en el servidor. Elegir local mantiene la inferencia de audio y texto en la máquina del backend.
El contrato de subtítulos versiona segmentos y traducciones. Las colas acotadas, la invalidación de respuestas obsoletas y los snapshots ayudan a evitar mezclar sesiones o presentar traducciones de una revisión anterior. La segmentación combina pausas y límites textuales inferidos, con un máximo de espera; el detector semántico adaptativo completo sigue como evolución.
Usamos OpenSpec, worktrees separados y revisión cruzada para coordinar el desarrollo con Claude y Codex. El repositorio registra el trabajo paso a paso y tiene licencia Apache 2.0, instrucciones para modelos y credenciales, pruebas y diagramas de arquitectura.
Desafíos
Un subtítulo puede llegar rápido y aun así ser difícil de leer si cambia todo el tiempo. Trabajamos tanto en el procesamiento incremental como en sostener una presentación estable, distinguir provisionales y confirmados, y conservar el contexto de lectura.
El otro desafío fue la carga de inferencia local. Las pruebas de traducción en CPU registraron sobrecarga y pérdidas de audio en algunos casos. Lo documentamos y mostramos la alternativa en nube. Algunos cierres residuales de Gemini Live todavía pueden quedar sin traducción. Estas limitaciones forman parte de la evidencia y no se presentan como resueltas.
Logros
La demo de 1 minuto 55 segundos muestra la aplicación funcionando con audio real de Nerdearla: local, nube, transcripción en español y dos charlas distintas en inglés traduciéndose simultáneamente en la nube.
Completamos siete casos de prueba usando los cuatro enlaces de charlas seleccionados. En la toma principal, las dos sesiones en nube se mantuvieron activas durante unos 100 segundos sin eventos de pérdida de audio ni errores publicados. El video conserva un intervalo común continuo a velocidad real. También probamos transcripción en español con ambos proveedores, sin pérdidas en esas tomas.
El video tiene narración argentina, música original y subtítulos editoriales en inglés para el jurado. El texto visible dentro de Decilo proviene del procesamiento real. La evidencia y el alcance de las pruebas están en el repositorio. Esta demostración breve no equivale a un benchmark sostenido ni a una garantía de latencia.
Qué aprendimos
La experiencia depende de todo el recorrido: captura, colas, reconocimiento, traducción y lectura. Agregar concurrencia o acortar un segmento no garantiza reducir el retraso; puede aumentar la competencia por recursos. Separar los motores del contrato de sesión permitió comparar local y nube sin rehacer la interfaz.
También aprendimos que más espectadores y más fuentes son problemas distintos. Compartir subtítulos de una sesión evita repetir inferencia por espectador; sumar escenarios requiere capacidad y enrutamiento por sesión.
Próximos pasos
Medir calidad y latencia durante pruebas más largas, optimizar la traducción local y completar el despliegue para eventos. El README explica los límites actuales y por qué escalar exige dirigir captura y audiencia a la instancia dueña de cada sesión; todavía no hay scheduler distribuido ni persistencia.
Queremos evolucionar hacia segmentación semántica adaptativa, glosarios técnicos, perfiles regionales y control de latencia. Traducción español→inglés, otros idiomas, diarización y contexto visual son extensiones futuras. Hoy el video aporta la charla y su audio; Decilo todavía no analiza sus imágenes.
English summary
Decilo is an open-source live captioning system for technical conferences. It transcribes English and Spanish, translates English into Spanish, and lets users choose local Whisper/Gemma or cloud Gemini processing. The demo shows real audio, incremental captions and two independent English talks translated concurrently in the cloud. Python/FastAPI coordinates sessions and distributes captions over WebSocket. The repository includes setup instructions, an Apache 2.0 license, architecture diagrams and test evidence. Long-running performance validation and the experimental semantic/multimodal roadmap remain future work.

Log in or sign up for Devpost to join the conversation.