-
-
Vignette
-
Results
-
Exemple correction lecture OCR
Inspiration
Dans les milieux à faibles ressources, les sages-femmes consignent toute la grossesse, l'accouchement et le post-partum dans un registre papier rempli à la main. Une fois écrite, l'information ne suit pas la femme d'une visite à l'autre et ne remonte jamais au système de santé. Ressaisir est trop long, et la connexion manque souvent.
Notre contrainte de départ : ne rien changer au travail de la sage-femme. Le registre papier reste l'outil de référence. Le numérique s'y greffe : une photo suffit. Surtout, l'IA ne doit jamais cacher ses doutes. Une valeur fausse présentée comme sûre est pire qu'une case vide.
Ce que fait le projet
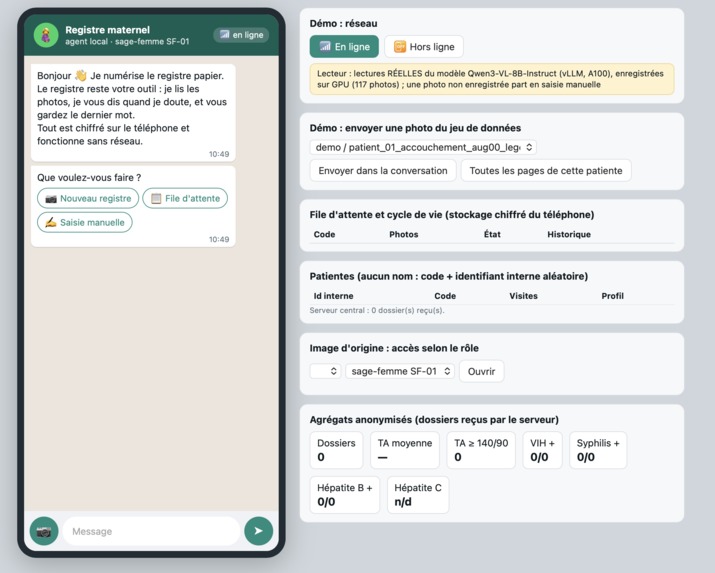
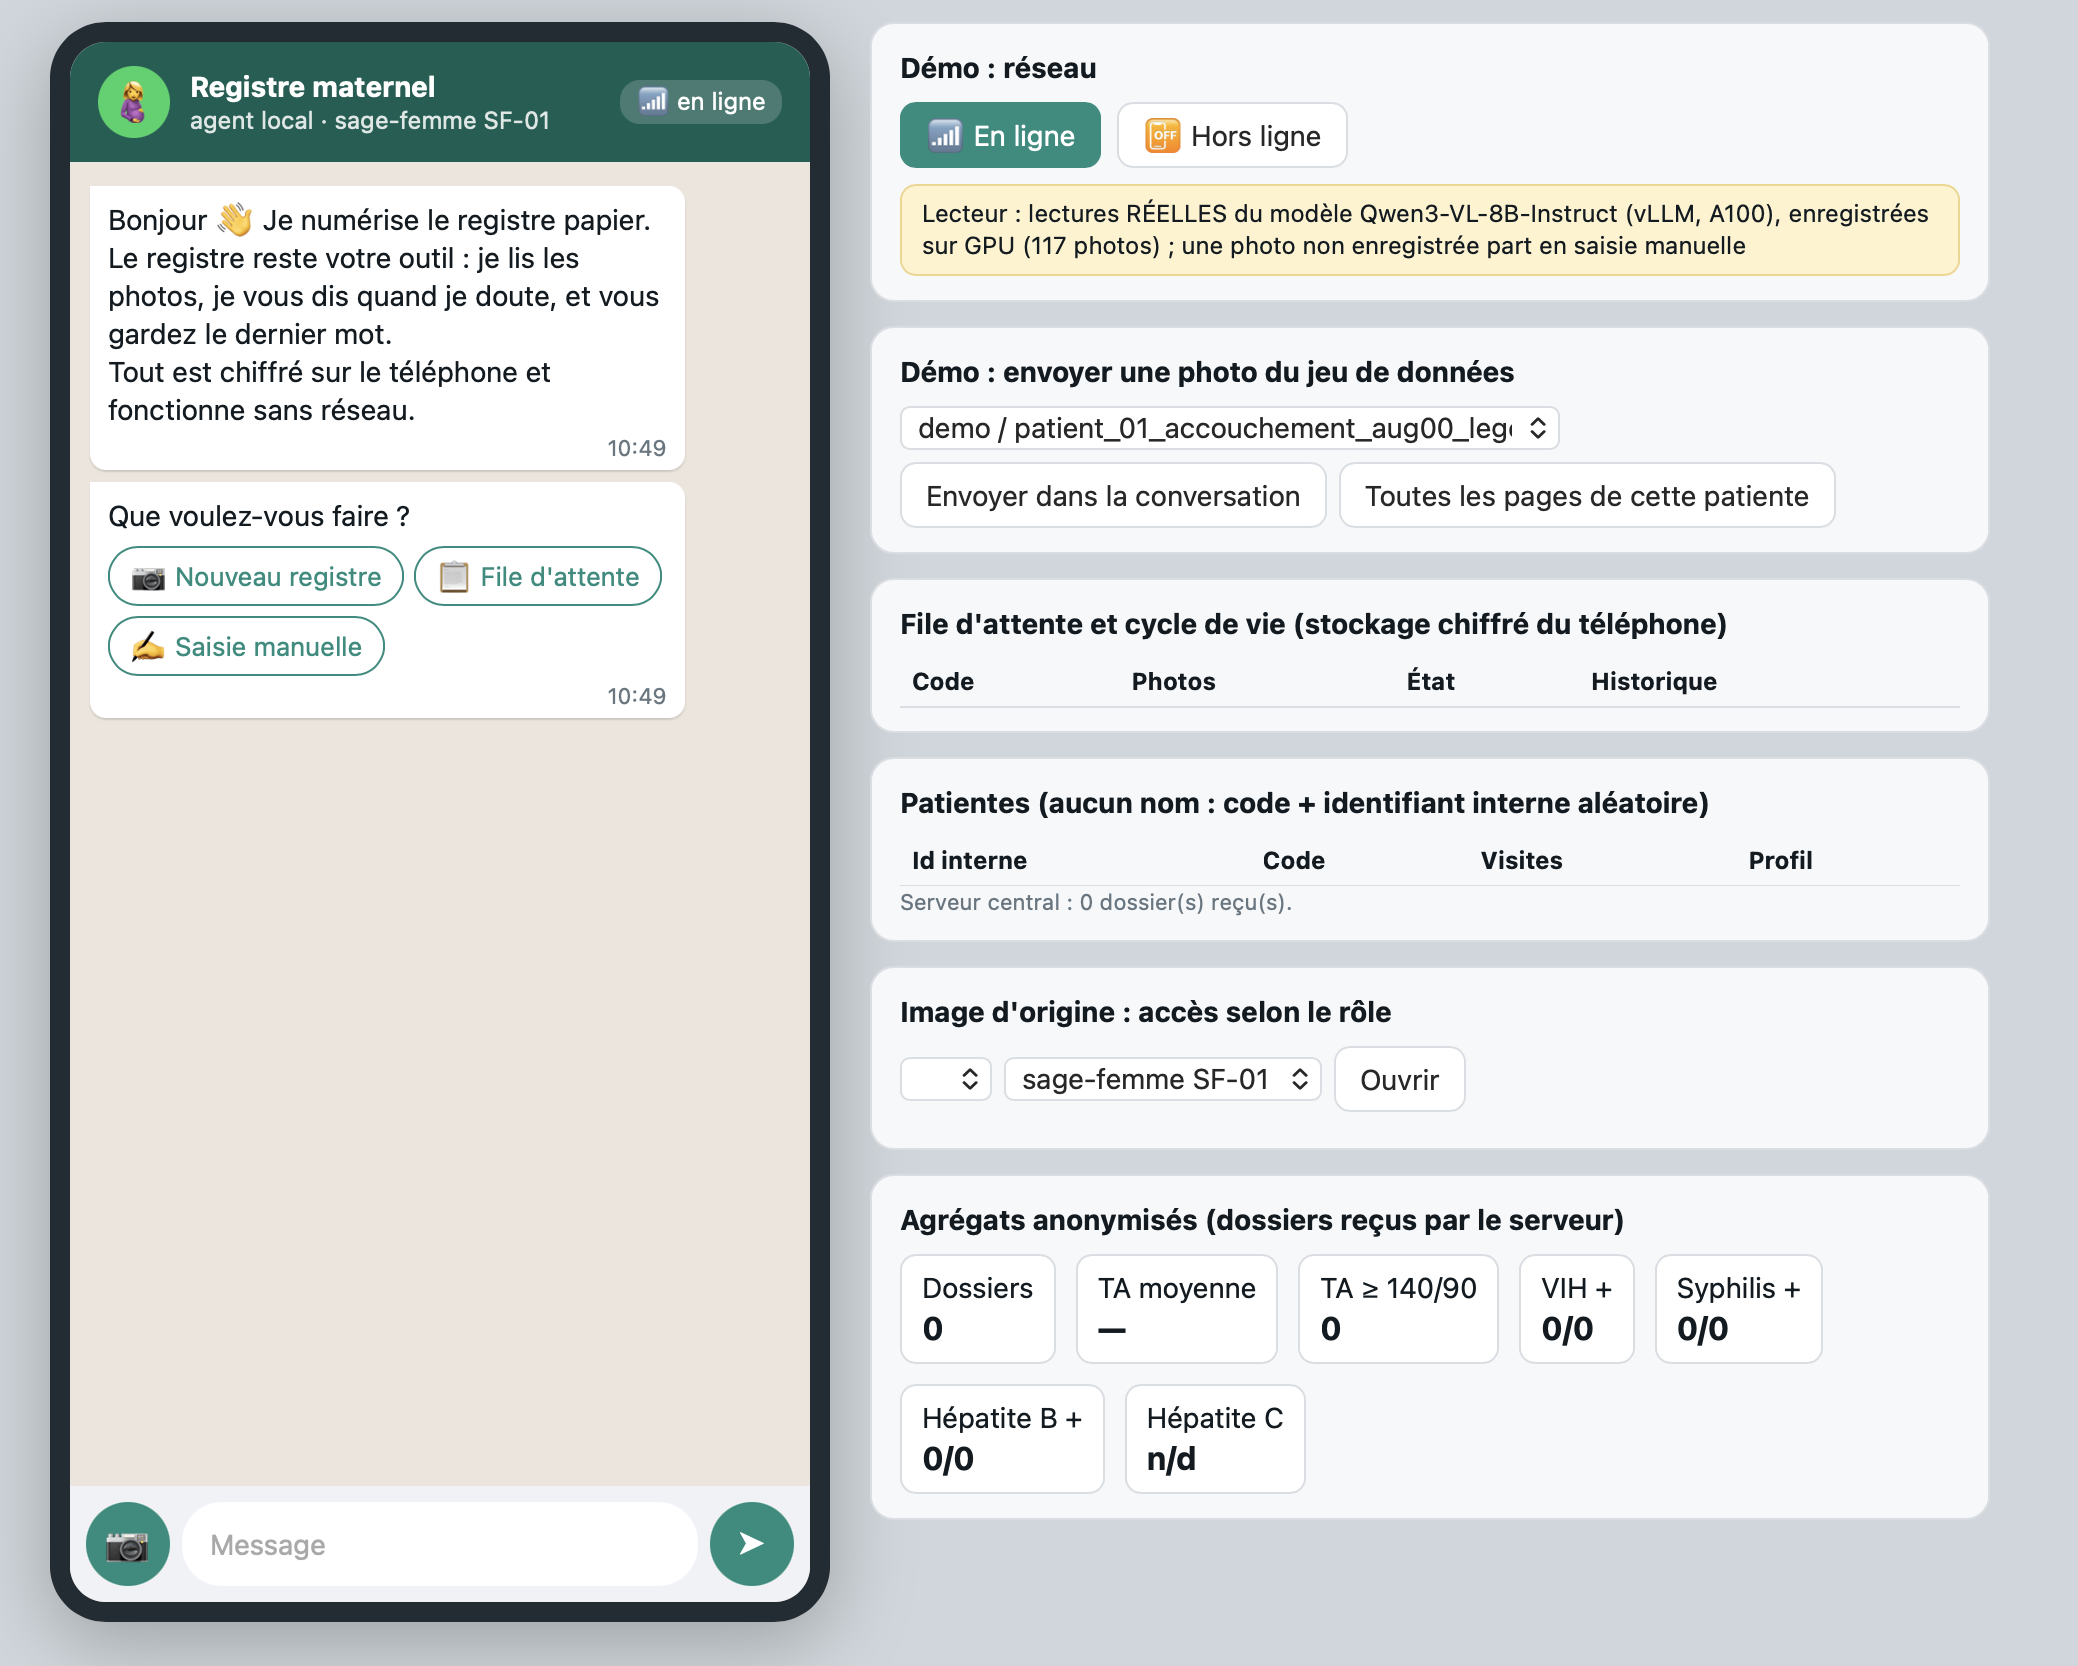
Un agent conversationnel de type WhatsApp, hors ligne d'abord :
- Capture sans réseau. La sage-femme saisit le code aléatoire écrit sur le registre (jamais de nom), puis photographie les pages. Chaque photo est chiffrée sur le téléphone et sa qualité est vérifiée tout de suite (flou, reflet, page coupée), avec un conseil concret pour la reprendre.
- File d'attente. L'enregistrement attend dans « En attente de traitement IA ». Au retour du réseau, la file repart toute seule.
- Lecture structurée. Environ 600 champs sur 8 pages (antécédents, grossesse, accouchement, post-partum, nouveau-né, sérologies). Chaque champ reçoit un statut explicite (CONNU, NON_FOURNI, ILLISIBLE, INCONNU, NON_APPLICABLE, À_RÉVISER), une confiance et la raison de son statut.
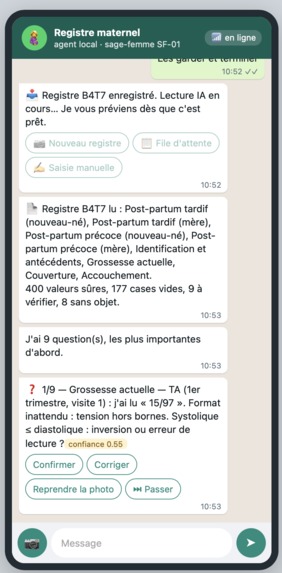
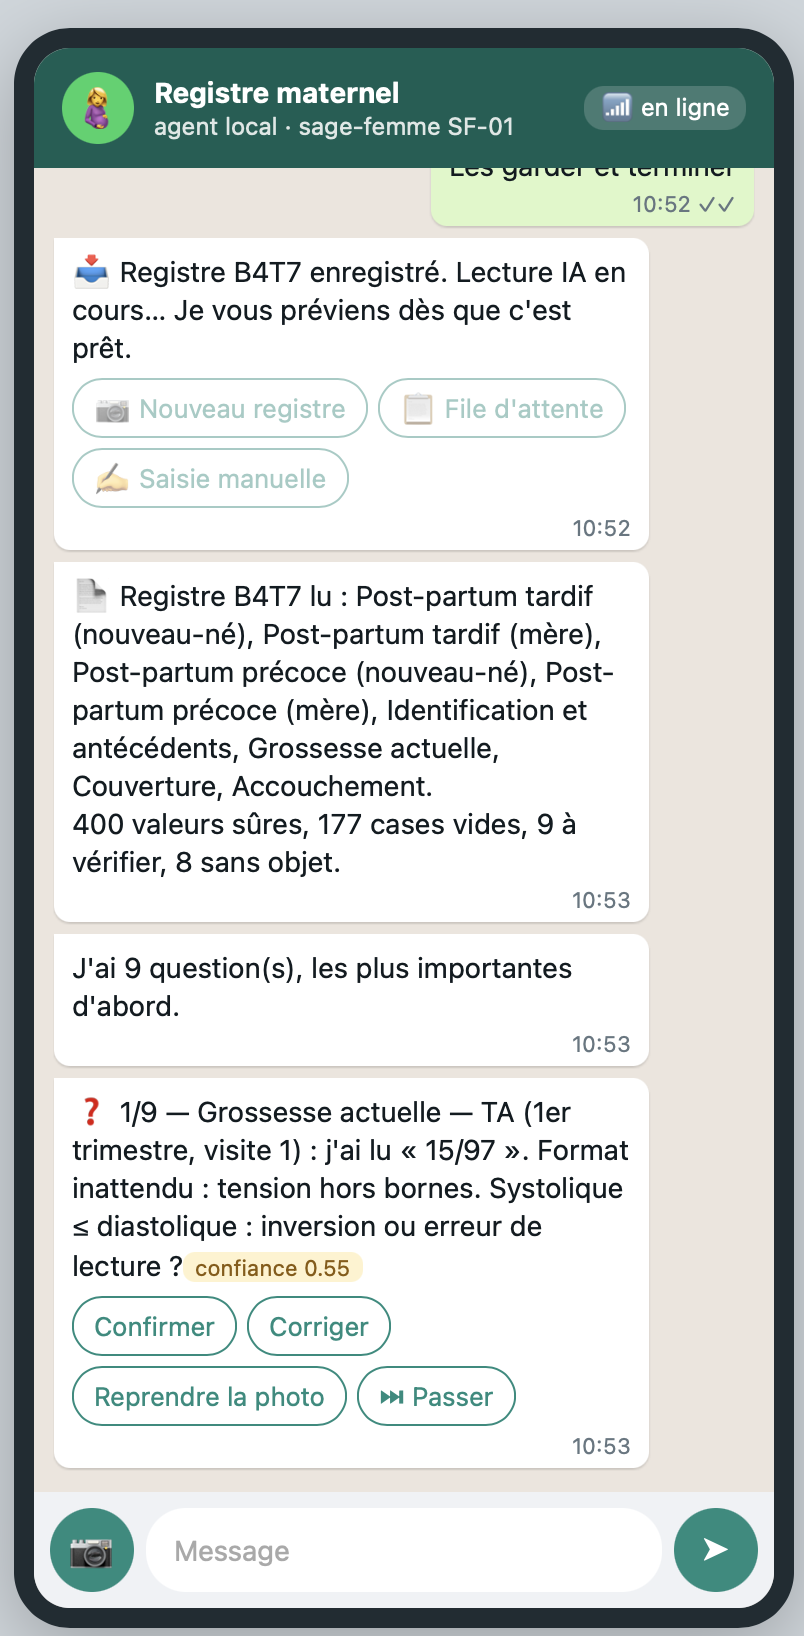
- Vérification conversationnelle. L'agent présente un bilan, puis pose ses questions par priorité, en disant pourquoi il doute : « TA lue 15/97 : systolique ≤ diastolique, erreur de lecture ? ». Boutons Confirmer / Corriger / Reprendre la photo / Laisser vide. Une saisie manuelle complète est possible si l'IA est indisponible.
- Liaison patiente. L'agent propose les correspondances (même code, ou code à une lettre près, B4T7 contre B4T8), et la sage-femme tranche : [Patiente 1] [Aucune, créer] [Je ne sais pas]. Il ne crée jamais de patiente automatiquement. L'identifiant interne est un UUID aléatoire.
- Renumérisation. Le même registre est rephotographié à chaque visite. Les nouvelles informations s'ajoutent, et une valeur qui change n'est jamais écrasée sans accord. Dans notre démo, c'est ainsi qu'une erreur de l'IA (« Sauvrance fœtale ») est rattrapée.
- Cycle de vie complet. CAPTURÉ → EN_ATTENTE_IA → TRAITÉ_IA → À_RÉVISER → VALIDÉ → PATIENTE_LIÉE → ENREGISTRÉ → SYNCHRONISÉ, avec les états d'échec (traitement, synchronisation, doublon suspecté, révision manuelle requise). Chaque transition est vérifiée et journalisée. Une coupure en plein envoi ne perd rien et ne crée pas de doublon côté serveur.
- Image d'origine conservée, chiffrée, jamais modifiée (SHA-256). L'accès dépend du rôle et chaque tentative est journalisée.
Comment nous l'avons construit
Partir du schéma, pas de l'OCR. Le PDF spécimen a une couche vectorielle : nous en avons extrait automatiquement les gabarits des 8 pages (libellés imprimés comme repères, zones d'écriture, cases à cocher) et la vérité terrain.
Un pipeline où le modèle ne fait qu'une chose : lire.
- contrôle qualité : estimation du rayon de flou en pixels, reflets, exposition, cadrage ;
- type de page et alignement : SIFT, puis recherche par corrélation de chaque libellé imprimé, puis homographie ;
- masquage des identifiants (nom, CIN, téléphone, adresse) avant toute lecture ;
- cases à cocher lues par OpenCV (densité d'encre), sans modèle ;
- texte lu par un VLM local (Qwen3-VL-8B-Instruct) à partir de mosaïques numérotées de recadrages, avec un JSON imposé ;
- fusion des signaux (lecture, encre détectée, format, visibilité, alignement, qualité) : un champ n'est CONNU que si ces signaux concordent ;
- règles de cohérence : bornes physiologiques, G/P/avortements, DPA = DDR + 280 j, chronologie des visites. Elles signalent sans jamais corriger.
Mode libre pour les mises en page inconnues : le modèle classe la page, transcrit chaque tableau ligne par ligne, et nous rapprochons ses libellés de notre schéma.
Application : Python standard (serveur HTTP, SQLite), chiffrement Fernet (AES + HMAC) avec une clé dérivée du PIN (PBKDF2), une machine à états et un travailleur de synchronisation. L'interface reproduit WhatsApp. Une console de démo simule le réseau et le serveur central.
Calcul : évaluations et fine-tuning sur le superordinateur Narval (GPU A100) avec vLLM et LLaMA-Factory. En local, avec Ollama sur Mac. Les vraies lectures du modèle sont enregistrées et rejouables sans GPU : le jury peut tout reproduire sur un simple portable.
Résultats
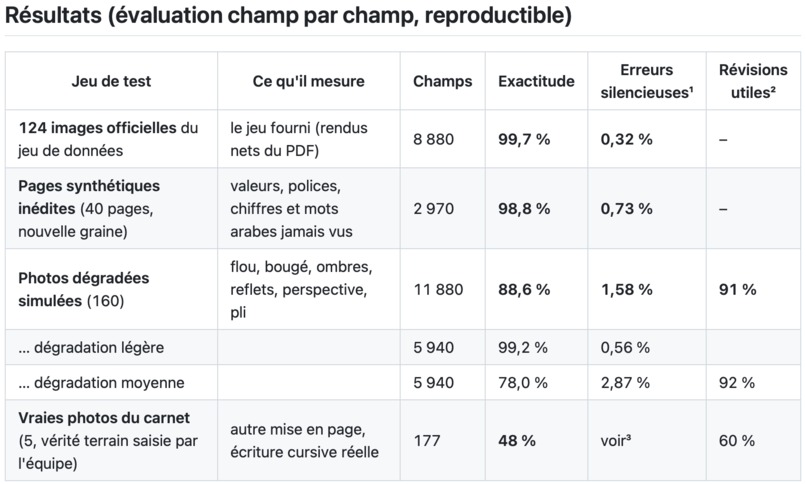
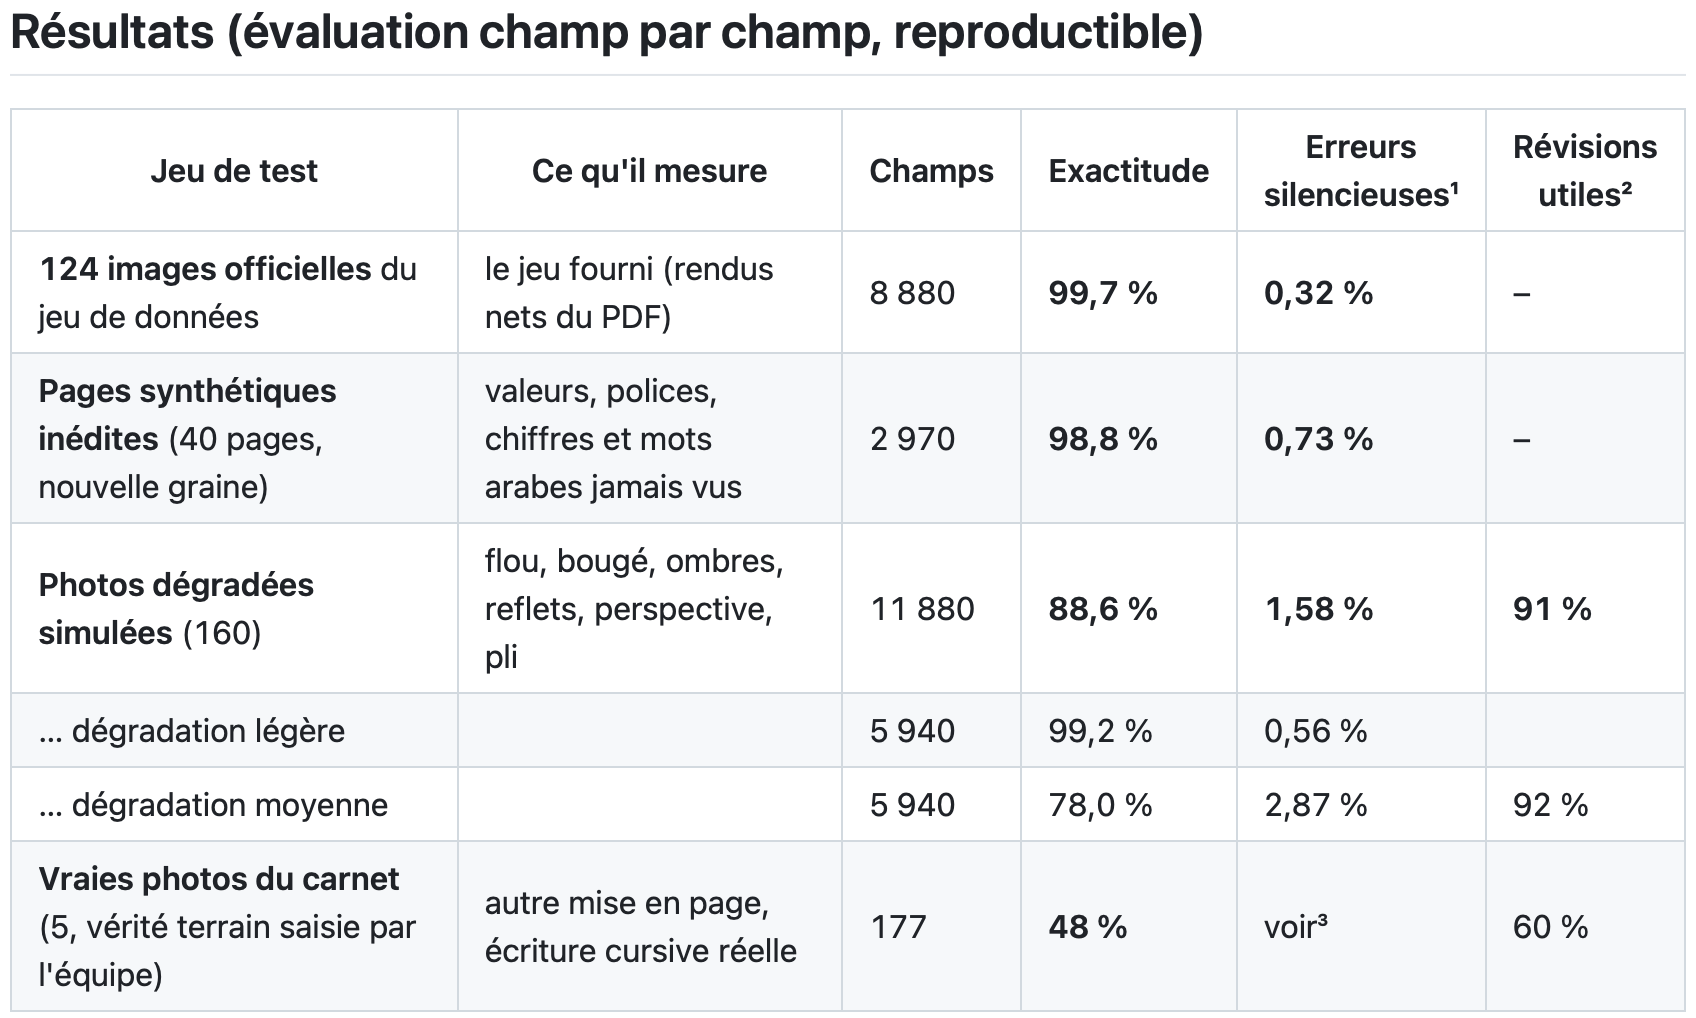
| Jeu de test | Champs | Exactitude | Erreurs silencieuses |
|---|---|---|---|
| 124 images officielles du jeu de données | 8 880 | 99,7 % | 0,32 % |
| Pages synthétiques inédites (autres écritures, chiffres et mots arabes) | 2 970 | 98,8 % | 0,73 % |
| Photos dégradées simulées (flou, ombres, perspective, pli) | 11 880 | 88,6 % | 1,6 % |
| 5 vraies photos du carnet (vérité terrain saisie par l'équipe) | 177 | 48 % | tout est « à vérifier » |
Une erreur silencieuse est une erreur que l'agent ne signale pas. Quand il demande une vérification, il avait raison de douter 9 fois sur 10.
Les défis rencontrés
- Les erreurs silencieuses. Sur photo dégradée, le modèle lit parfois une année fausse (2024 au lieu de 2026) avec une confiance de 97 %. Aucun seuil de confiance ne l'attrape. Nous avons ajouté des règles de chronologie, la détection d'écriture inattendue (le modèle bascule parfois en chiffres arabes-indiens ou en cyrillique) et un rapprochement avec le vocabulaire du registre. Les erreurs silencieuses sont passées de 2,6 % à 1,6 %.
- Les vraies photos. Le vrai carnet n'a pas la même typographie que le spécimen, et une page de droite photographiée seule n'a pas les libellés de ses lignes. Nous avons réécrit le mode libre (transcription des tableaux, rapprochement des libellés, rejet des réponses dégénérées). Résultat : 17 % → 48 %, et l'agent demande désormais de photographier la double page.
- Le terrain réel. Tensions notées en cmHg (« 11/7 »), âges gestationnels « 16 SA+3j », « NF » pour « non fait », « 1G » pour la gestité : autant de normalisations ajoutées.
- Le calcul. Files d'attente Slurm, nœuds de calcul sans Internet, contrôle de version de LLaMA-Factory qui refusait les roues de l'Alliance… tout cela en une nuit.
Ce dont nous sommes fiers
- Un agent qui mesure et expose son incertitude au lieu de la masquer, avec une métrique dédiée.
- Un parcours hors ligne complet et testé (30 tests automatiques), y compris les coupures en plein traitement et en plein envoi.
- Aucun identifiant direct n'est jamais lu ni stocké.
- Une démo reproductible sans GPU avec les vraies sorties du modèle.
- Des résultats négatifs assumés et documentés.
Ce que nous avons appris
- Le fine-tuning n'est pas magique. Notre LoRA (6 000 exemples synthétiques, 52 min sur A100) a fait moins bien que le modèle de base : 4,0 % d'erreurs silencieuses contre 1,6 %, et 14 % contre 48 % sur les vraies photos. Il s'est trop spécialisé sur le synthétique. Nous ne l'avons pas retenu. Pour progresser sur le terrain, il faut de vraies données annotées.
- La confiance d'un modèle ne suffit pas. La cohérence entre champs attrape ce que les probabilités ratent.
- Confidentialité. Nous avons choisi de ne pas utiliser l'API WhatsApp réelle : avec l'API Cloud de Meta, les messages sont déchiffrés sur les serveurs de Meta avant d'atteindre le système de santé. Pour des données de santé, nous avons préféré reproduire l'expérience WhatsApp en local.
La suite
- Un gabarit construit sur le vrai carnet, et une vérité terrain réelle plus large, pour évaluer puis affiner sur de vraies écritures.
- Une application mobile native : clé de chiffrement dans le Keystore ou la Keychain, synchronisation en tâche de fond.
- Une vraie authentification par rôle, et la gestion de plusieurs sages-femmes et structures de santé.
- Un tableau de bord épidémiologique (TA, VIH, syphilis, hépatites) alimenté uniquement par des champs vérifiés.

Log in or sign up for Devpost to join the conversation.