-
-
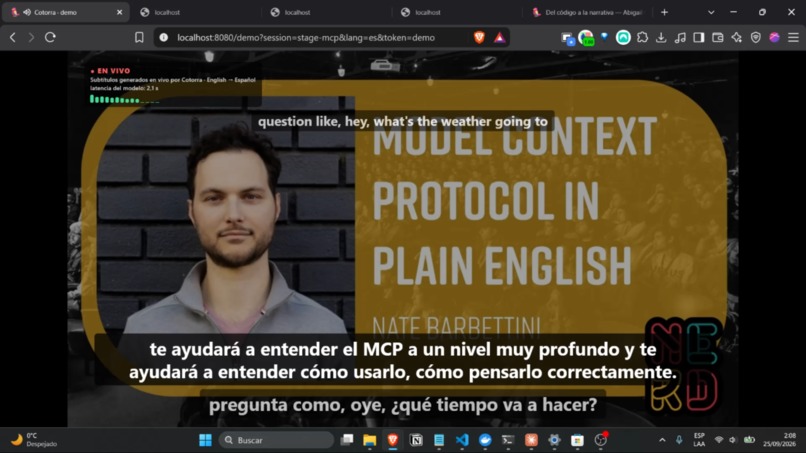
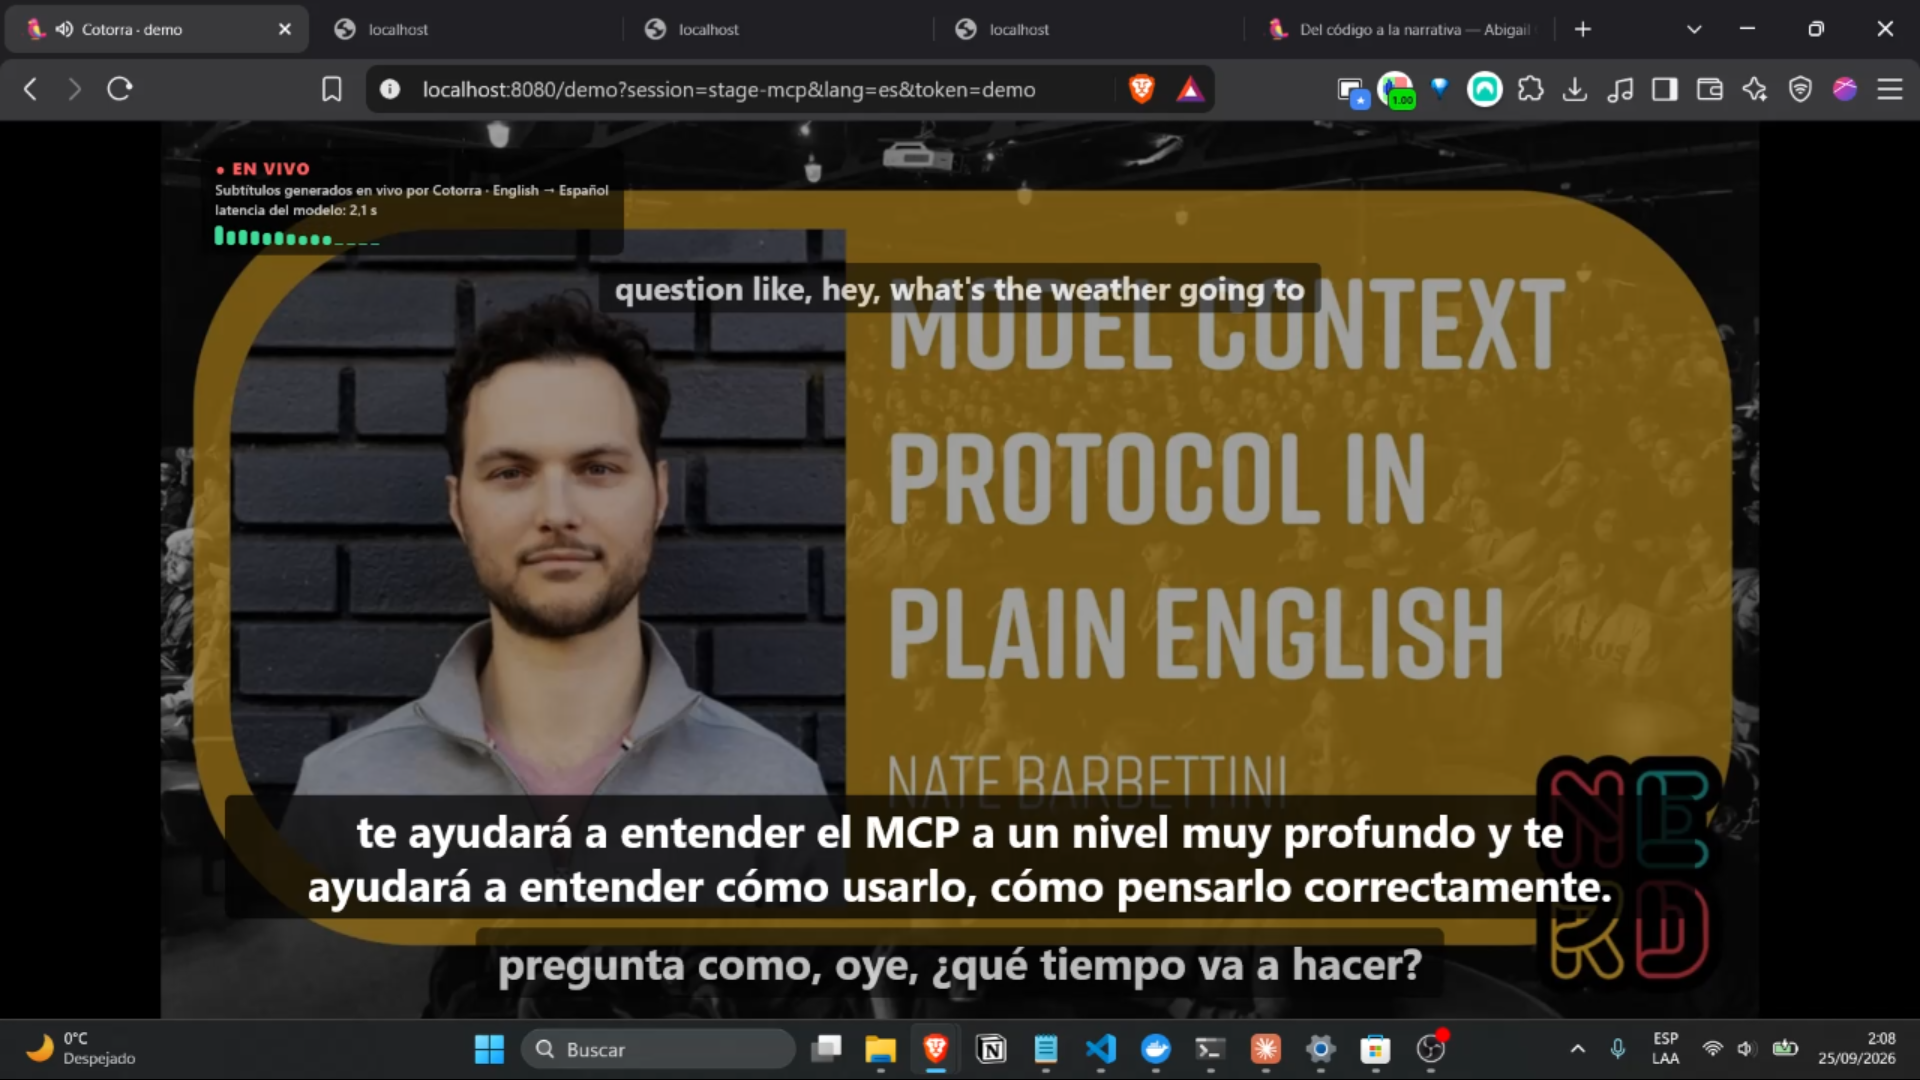
Subtitles with video
-
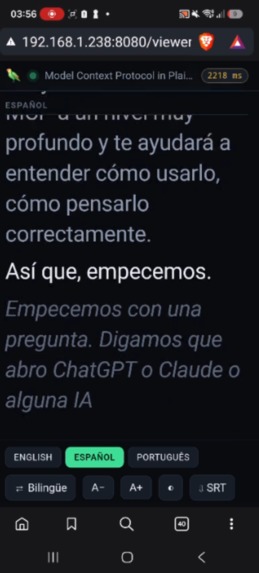
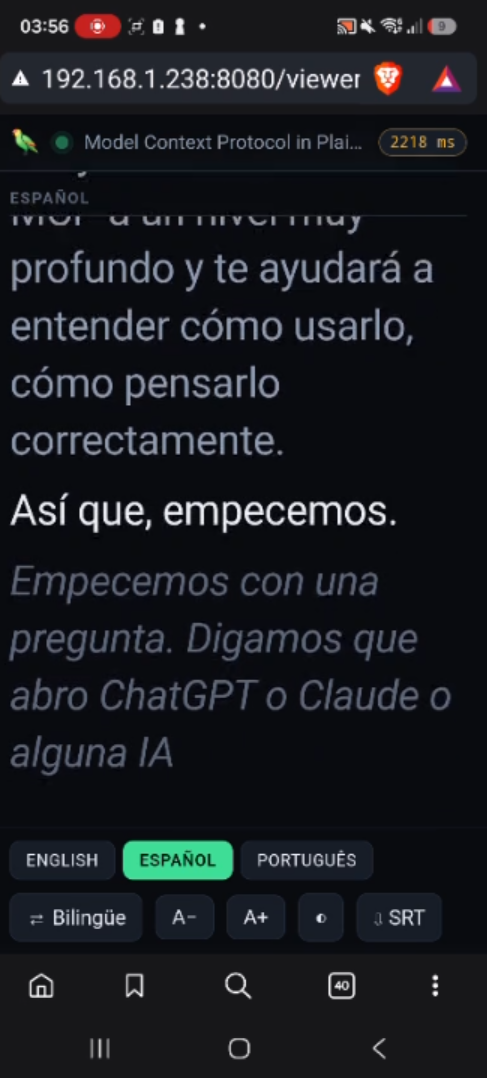
Phone user subtitles view
-
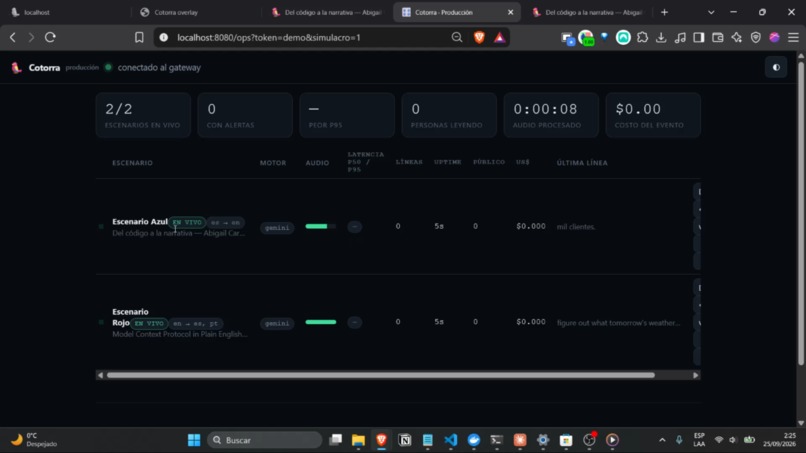
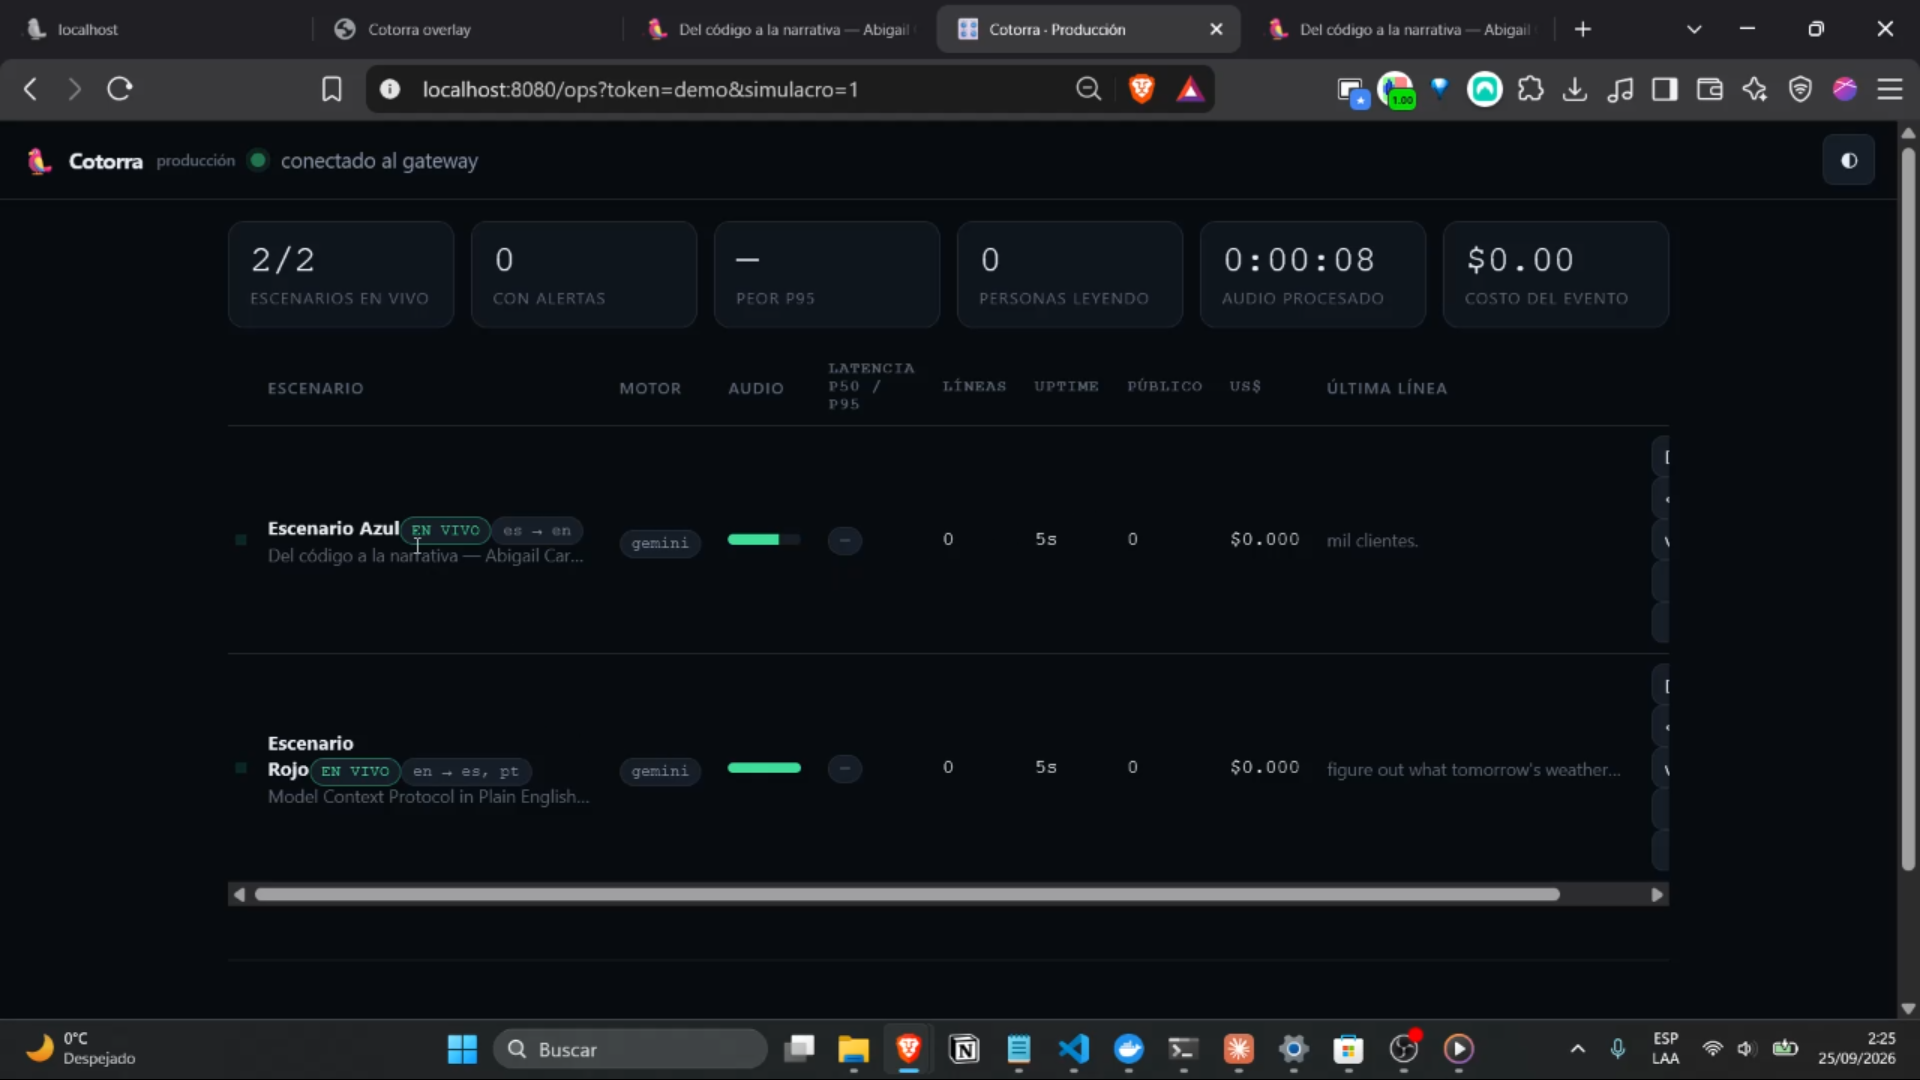
Dashboard for production
-
Project Card
Inspiration
Nerdearla tiene varias salas en simultáneo, con charlas en español y en inglés, y no todo el público, en la sala o en línea, puede seguir todas las charlas. Empezamos Cotorra para resolver eso con algo open source que cualquier evento pueda correr. Mientras lo construíamos, alguien preguntó en el Discord de Nerdearla cómo funciona hoy el subtitulado, y la respuesta describió exactamente el problema en el que estábamos trabajando: cada sala manda el audio a una mini PC que corre un servicio pago en un navegador, alguien entra por escritorio remoto a apretar F5 cuando se congela, y el público en línea no recibe ninguna traducción. Funciona, pero no se le puede pasar a otra conferencia, y la accesibilidad no debería ser algo que solo pueden pagar los eventos con mucho presupuesto.
What it does
Cotorra toma el audio en vivo de cualquier cantidad de salas (RTMP, HLS, SRT, YouTube, un archivo o un micrófono) y lo convierte en subtítulos en tiempo real, en el idioma original y traducidos.
- Público: elige la charla y el idioma desde cualquier celular. Sin app, sin cuenta. Un modo bilingüe muestra el original y la traducción lado a lado.
- Pantalla del escenario: subtítulos grandes y un QR para seguirlos desde el asiento.
- Transmisión: un overlay transparente para vMix / OBS.
- Producción: un panel con semáforo por sala, latencia en vivo, un medidor de audio que detecta silencios y un contador de costo. Las salas que se caen se levantan solas.
- Después: cada charla se exporta a SRT, VTT, TXT o JSON.
How we built it
Una sola llamada multimodal a Gemini devuelve la transcripción y todas las traducciones juntas. El pipeline clásico ASR → traductor hace dos viajes de ida y vuelta, y el traductor nunca escucha el audio. Con una sola llamada es más rápido y más barato, y sumar un idioma agrega un campo, no una llamada.
Un gateway corre un proceso del sistema operativo por sala: ffmpeg normaliza cualquier fuente, un detector de voz adaptativo corta en las pausas del orador, Gemini transcribe y traduce, y los WebSockets le mandan a cada persona solo el idioma que eligió. Si en una sala se cae ffmpeg o una llamada se cuelga, las demás ni se enteran. Python y FastAPI en el backend; HTML y JS sin frameworks en el frontend, para que la página del público cargue rápido aunque el wifi del evento esté saturado.
Challenges we ran into
- Un subtítulo tiene fecha de vencimiento. Contra la API real, una llamada que se agotó por tiempo se reintentó y entregó un subtítulo correcto 26 s tarde, frenando todas las líneas que venían detrás. Darle a cada subtítulo un presupuesto de tiempo total, en lugar de un timeout por intento, bajó la latencia máxima a 9 s.
- Orden vs. velocidad. Las llamadas corren en paralelo para seguirle el ritmo a oradores rápidos, pero terminan desordenadas, así que los resultados se publican en el orden en que se enviaron.
- Los fragmentos pierden contexto. Le pasamos al modelo los últimos tres subtítulos como contexto, marcados como "no repetir", porque si no vuelve a transcribir la oración anterior.
- Costos reales. Los subtítulos provisorios cuestan 3,1 veces más, no el 44% que habíamos estimado. Solo lo descubrimos corriendo contra la API real.
Accomplishments that we're proud of
- US$0,31 por hora de sala, medido en charlas reales de Nerdearla con Vertex AI: menos de US$10 para una conferencia de 30 charlas (US$29 con subtítulos provisorios).
- 10 salas en paralelo en una notebook sin errores, y ~2,6–3,0 s de latencia de punta a punta con Gemini real sobre una charla real.
- Un panel pensado para el equipo técnico: el medidor de audio detecta un cable desconectado, que es lo que realmente falla en un evento.
- 140 tests que corren sin red, sin claves de API y sin GPU.
- Funciona sin credenciales:
docker compose upmuestra todo el pipeline con un motor de demo claramente señalizado.
What we learned
Lo difícil no es el modelo. Es la segmentación, el orden, las cuotas y darse cuenta de cuándo dejó de llegar el audio. Las claves gratuitas permiten 15–20 pedidos por día por modelo, y una hora de subtitulado necesita 400–900; lo descubrimos quedándonos sin cuota en plena prueba. Y un glosario de nombres y términos corrige la mayoría de los errores vergonzosos por fracciones de centavo por hora.
What's next for Cotorra
Gemini Live API para bajar la latencia, identificación de quién habla, correcciones en vivo desde el panel, un supervisor en Kubernetes para más de 50 salas, y lengua de señas como objetivo a largo plazo. Hay nueve issues abiertos, seis de ellos good first issue.
Built With
- css3
- docker
- fastapi
- ffmpeg
- gemini
- github-actions
- google-cloud
- html5
- javascript
- prometheus
- python
- uvicorn
- vertex-ai
- websockets


Log in or sign up for Devpost to join the conversation.