Inspiration
Chez Loto-Québec, une corroboration compare déjà, champ par champ, l'extraction du système maître RH (Système A) et celle du système de gestion du temps (Système B). Mais « différent » ne veut pas dire « erroné »! Un code de statut traduit par une jointure, un libellé concaténé ou une date au format Excel sont des écarts légitimes. Aujourd'hui, une personne doit les valider à la main, avec une bonne connaissance des systèmes et des interprétations qui varient d'une personne à l'autre.
Notre objectif : que l'attention humaine aille uniquement aux vraies erreurs, et que chaque verdict puisse être compris, retracé et reproduit.
What it does
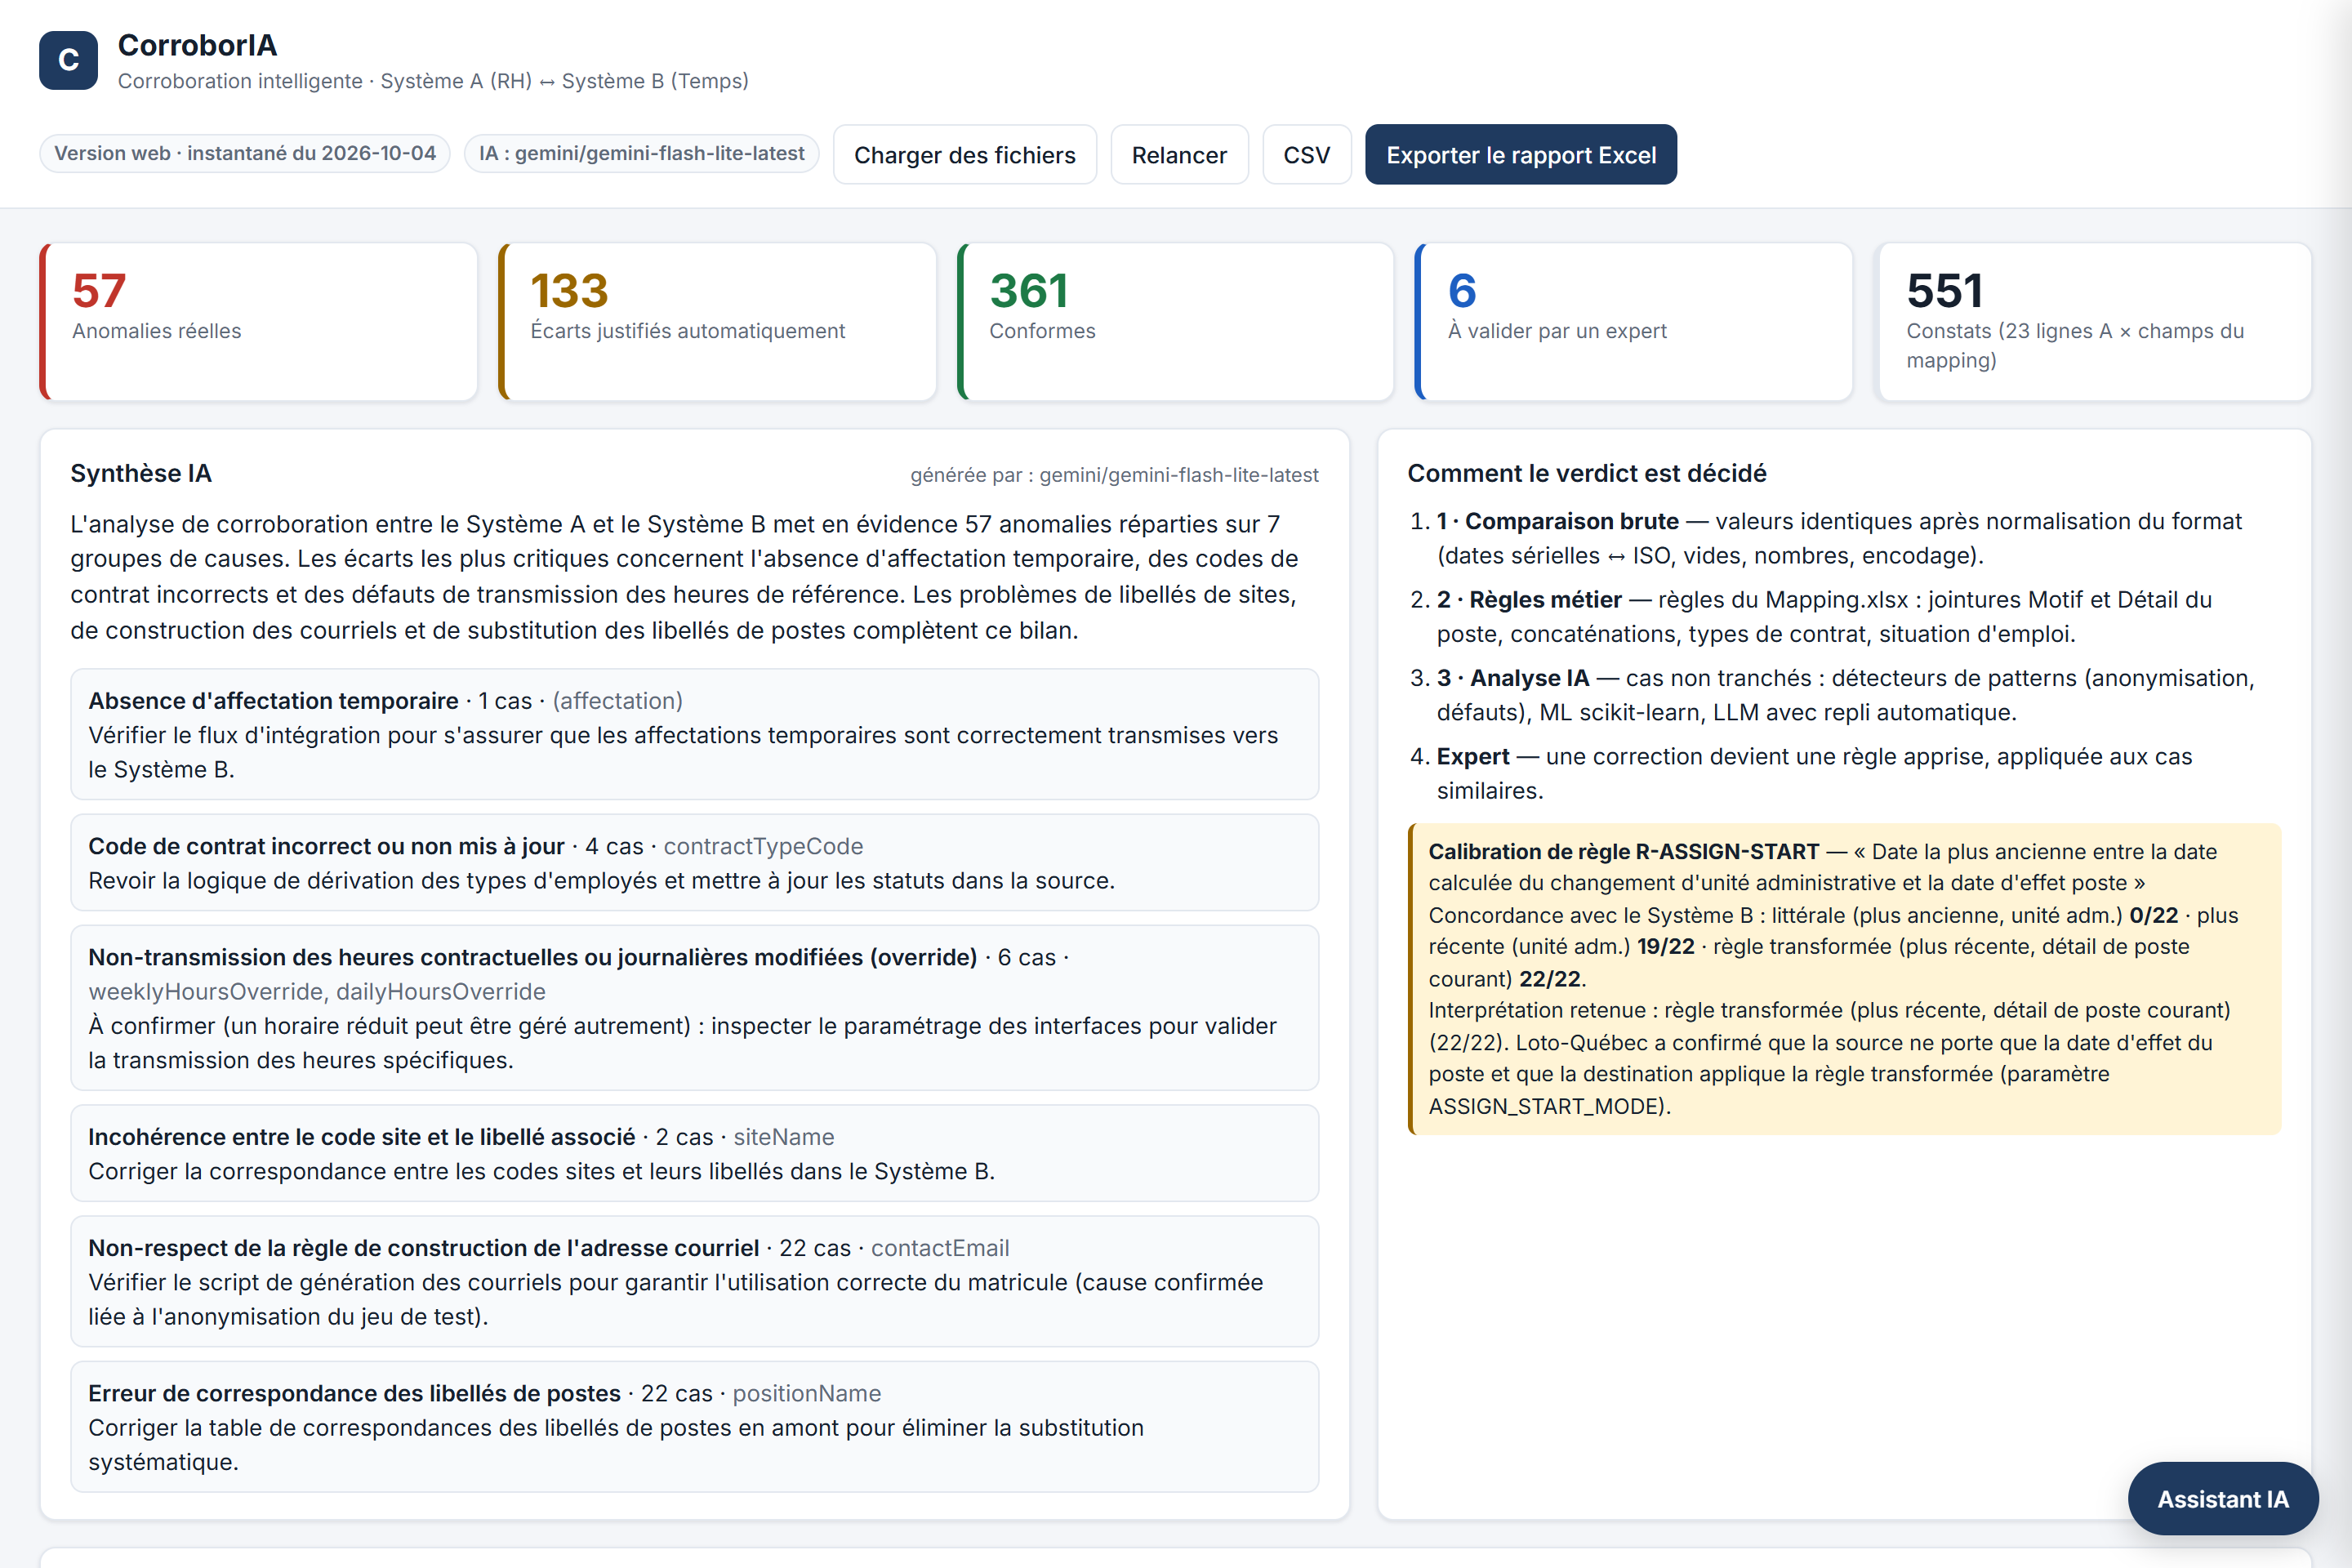
CorroborIA compare les deux extractions selon le fichier de mapping et classe chacun des 551 constats :
- Conforme (361) : même valeur après normalisation (dates sérielles Excel ↔ ISO, vides, nombres, encodage).
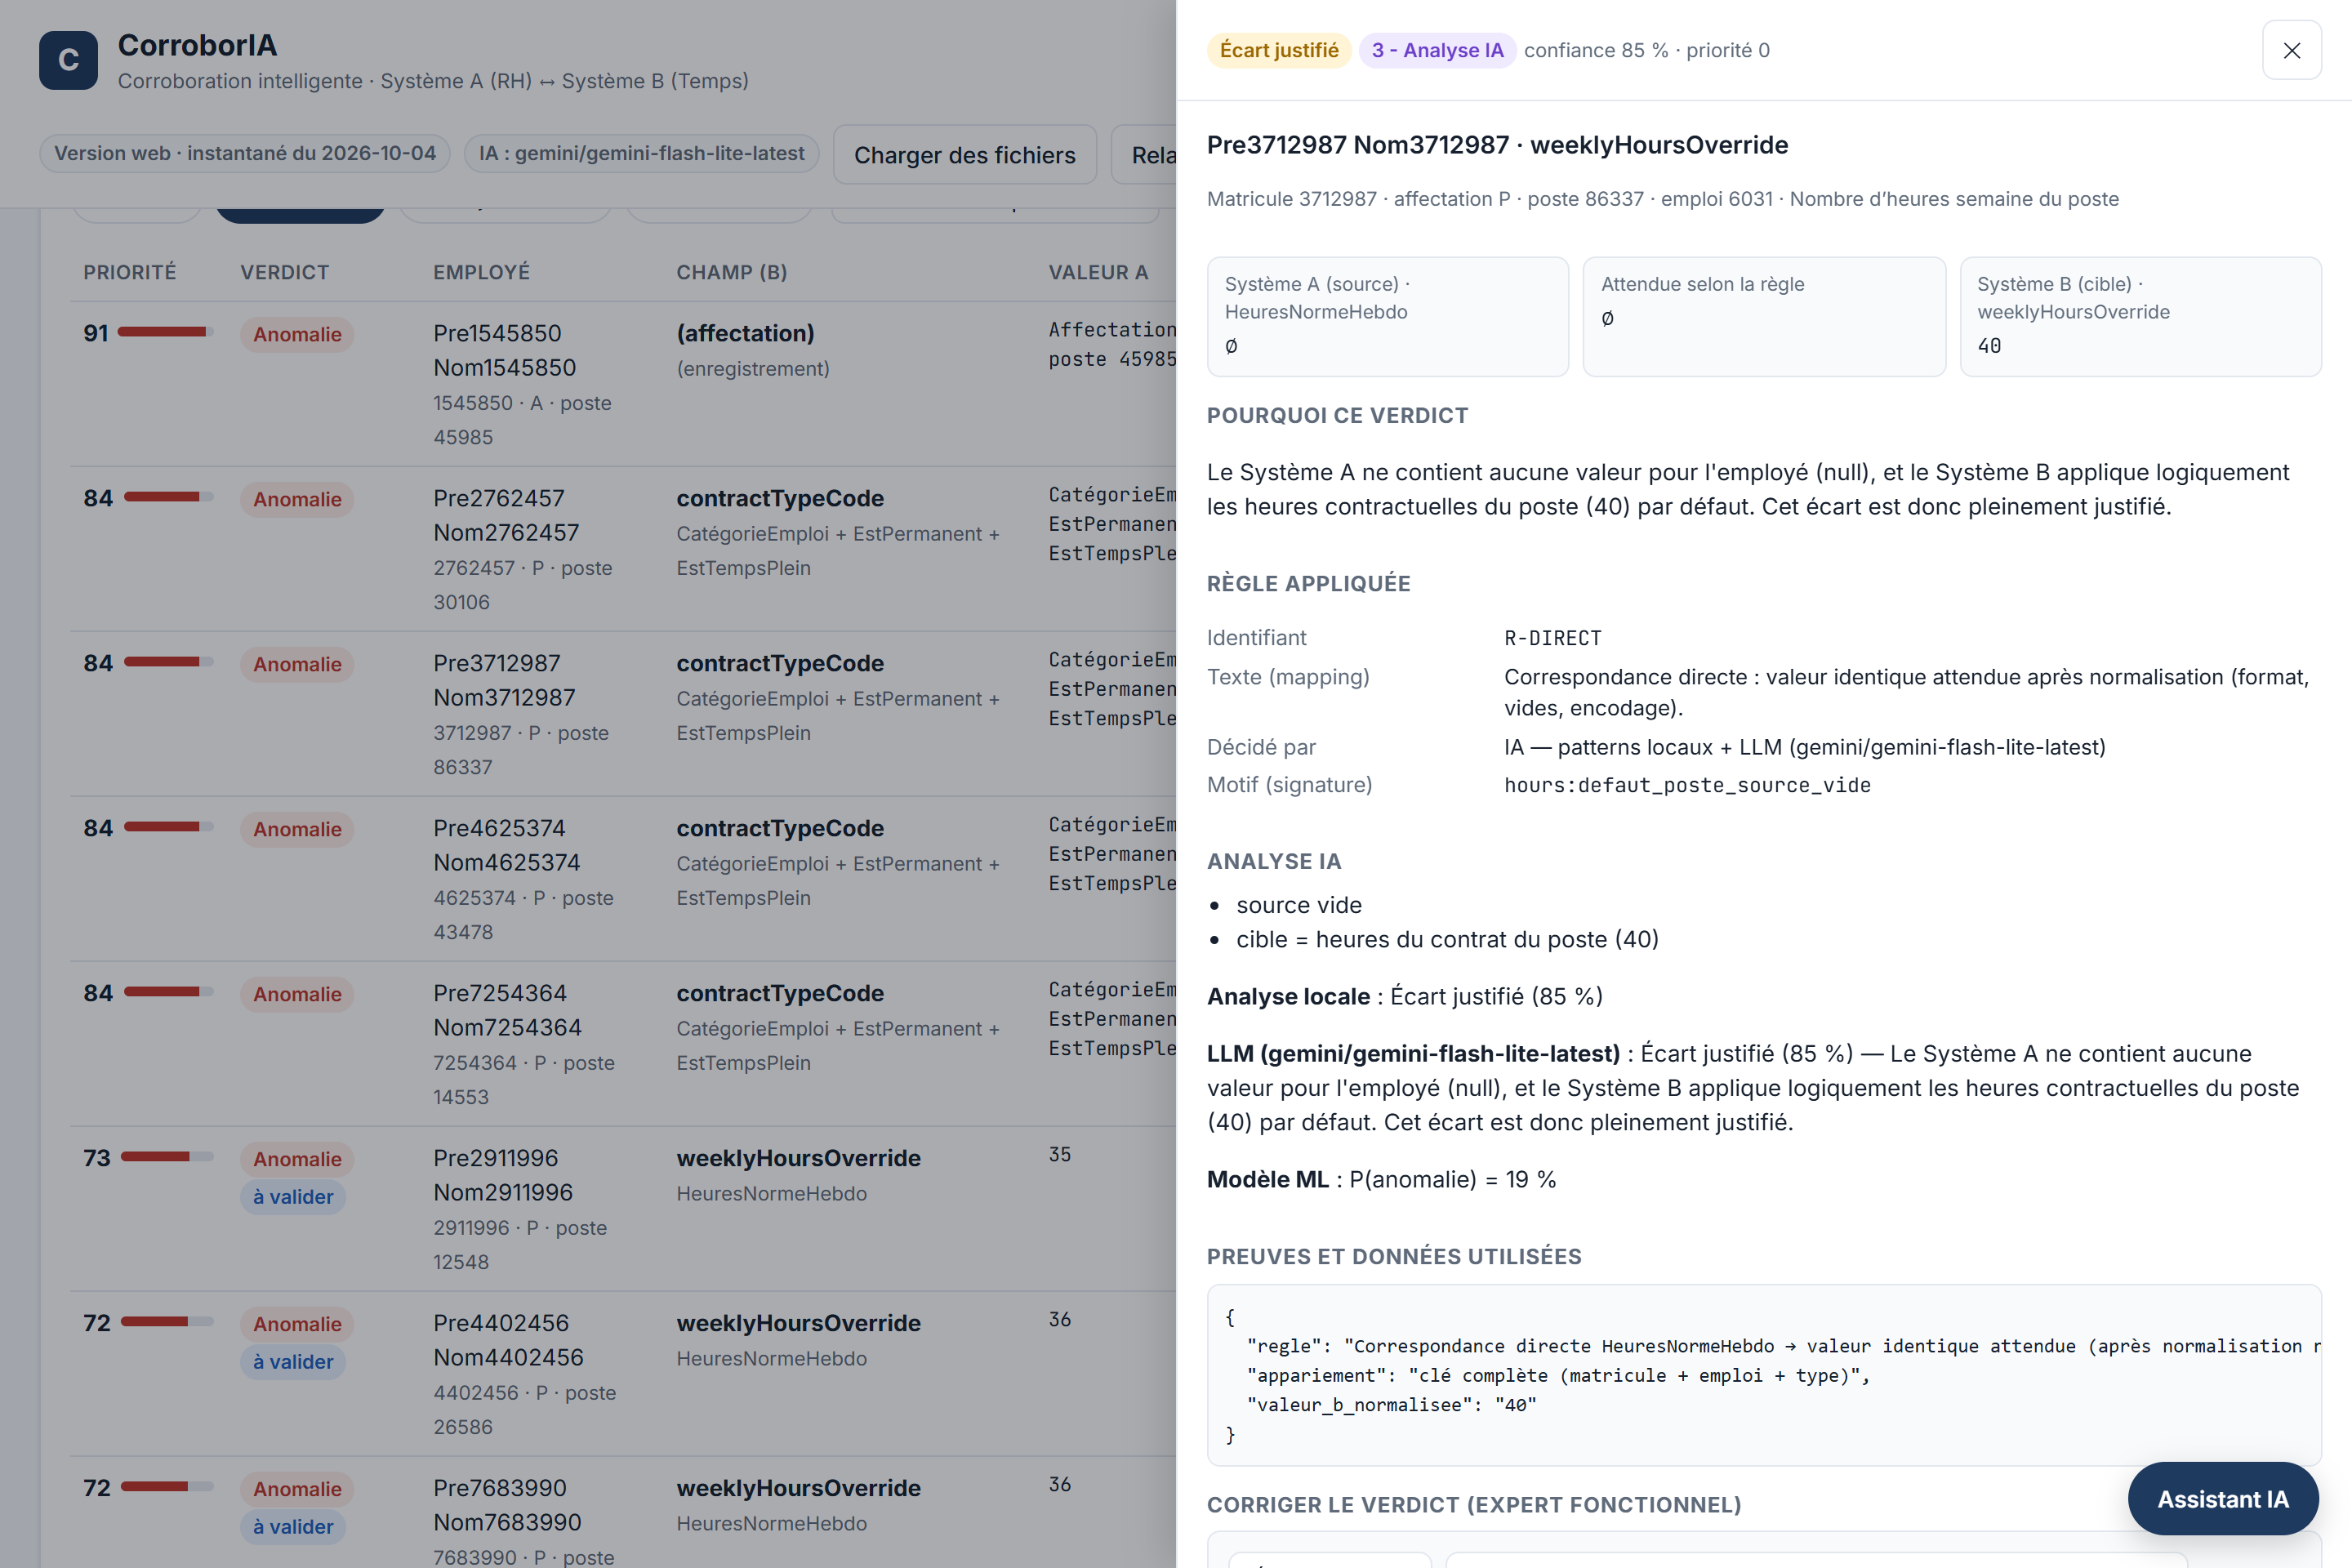
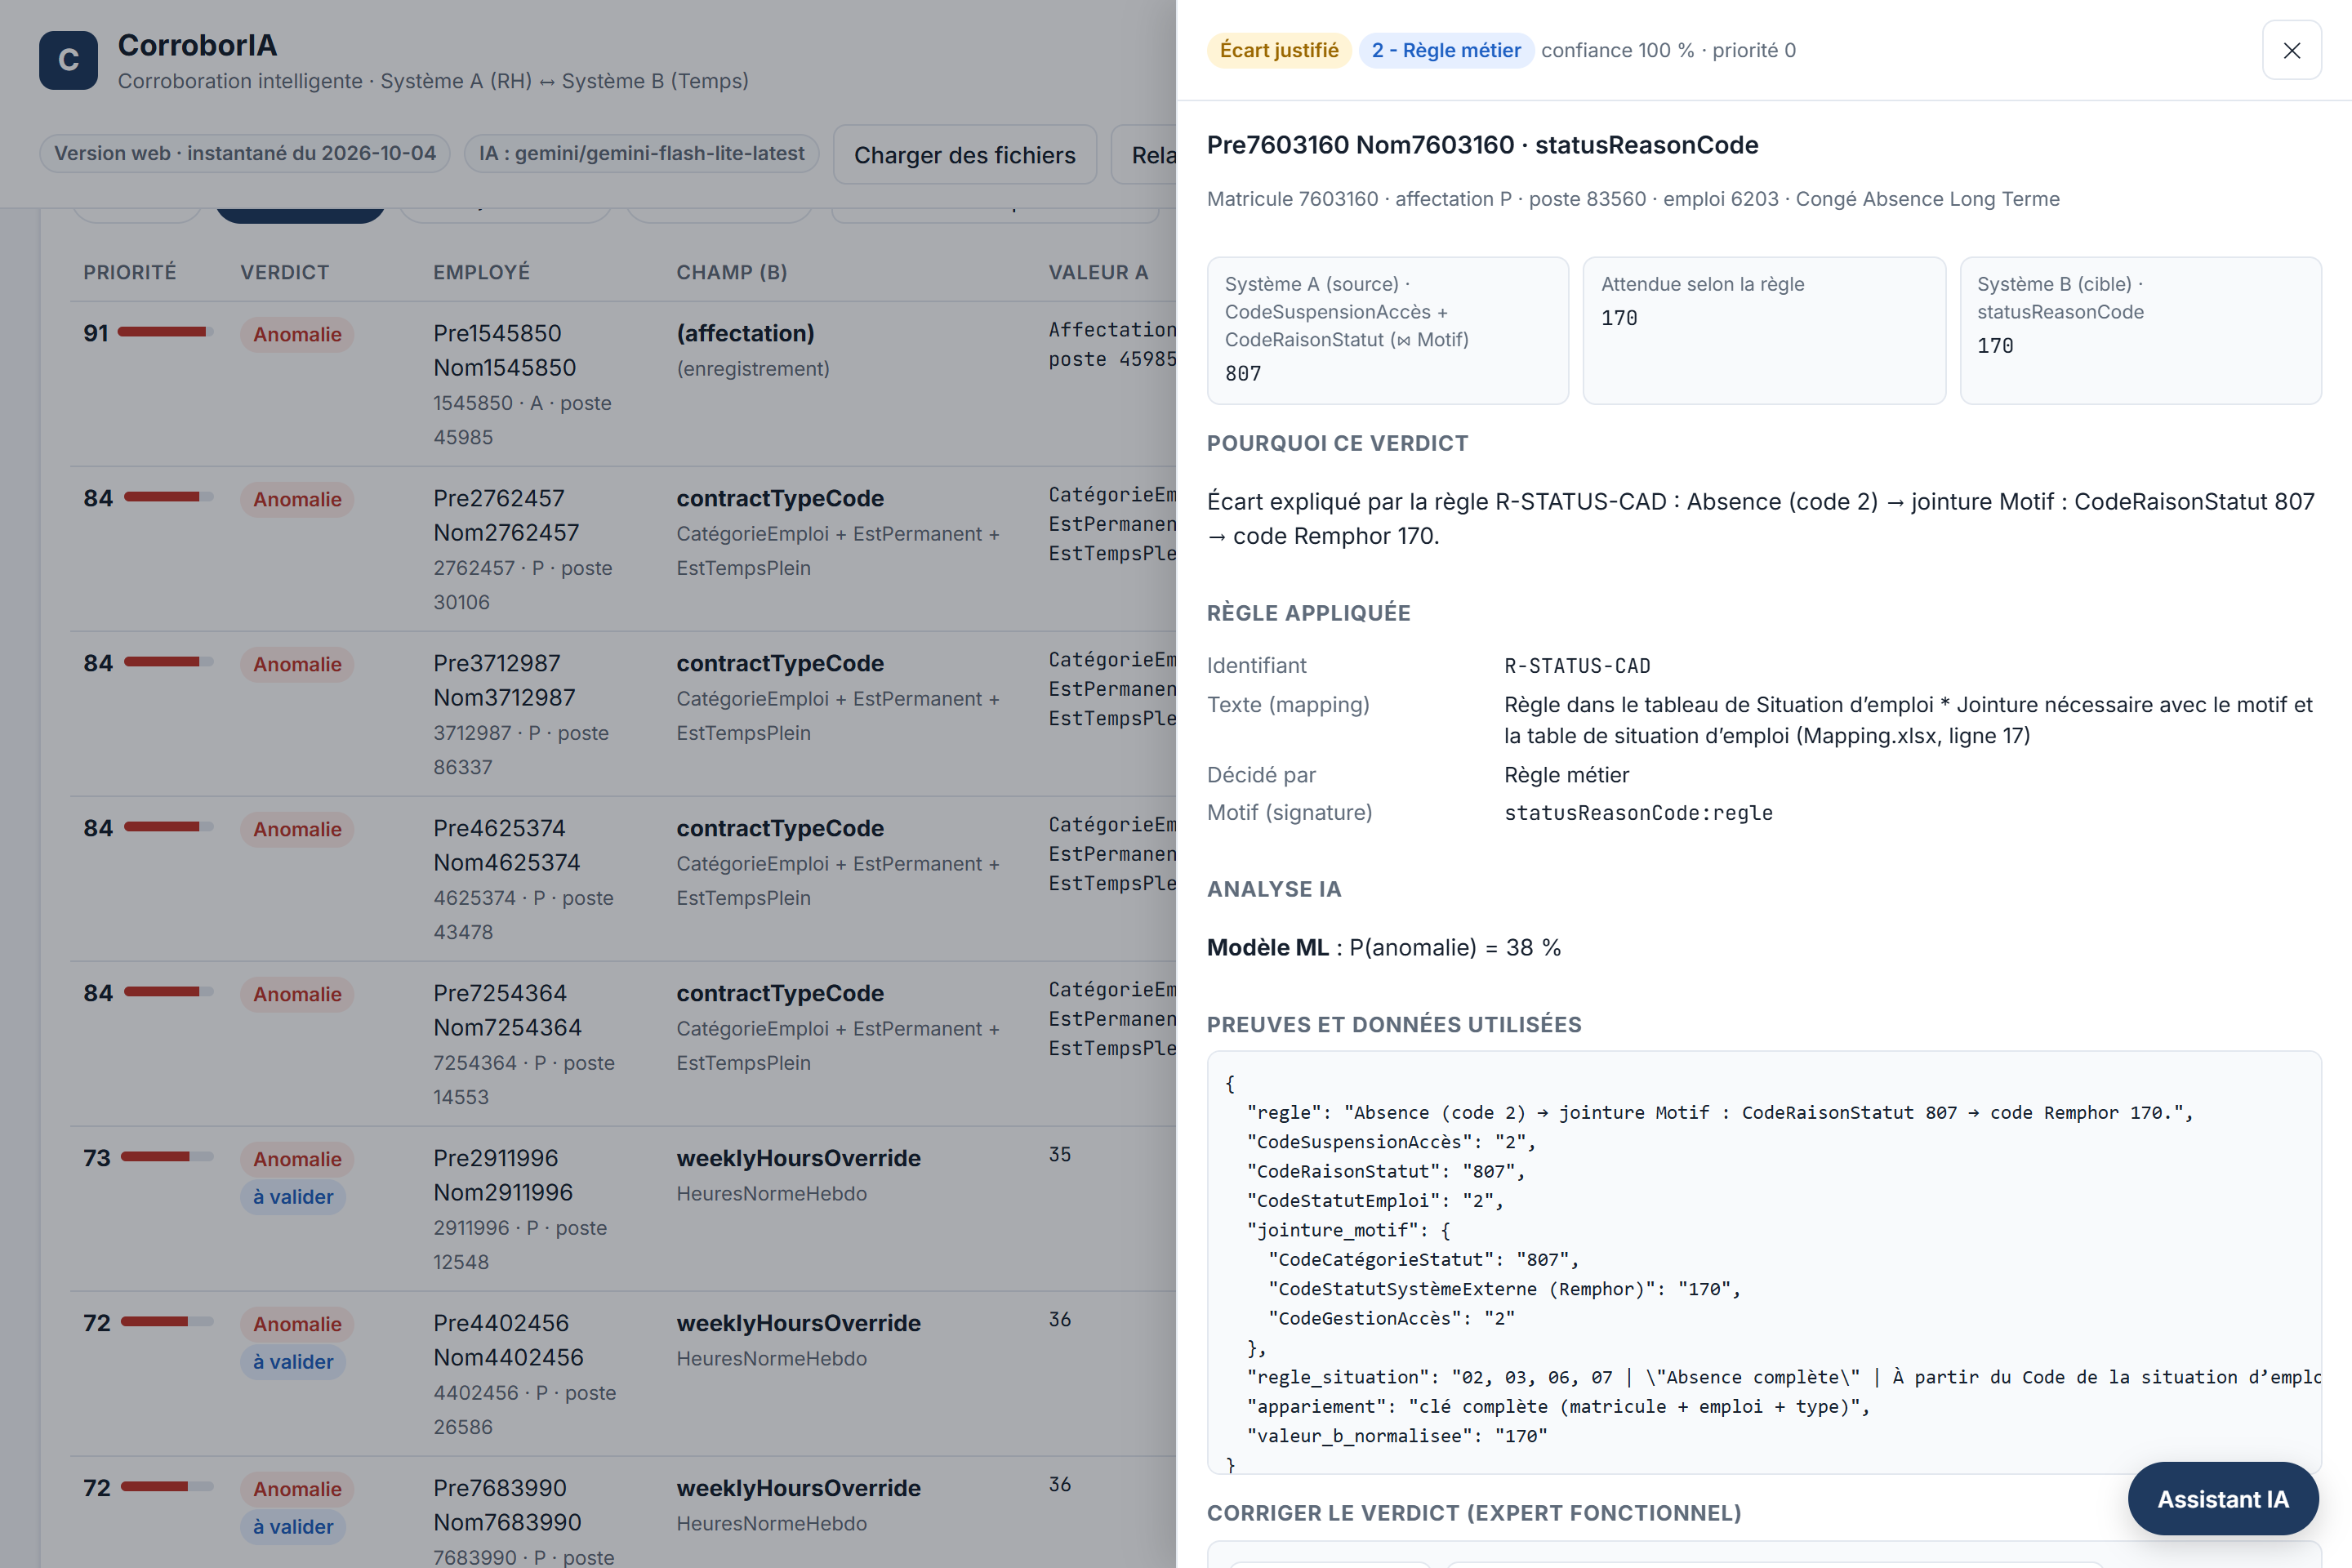
- Écart justifié (133) : différence expliquée par une règle métier (jointure Motif → code Remphor, type de contrat, P/A/S → booléens, concaténations, règle transformée de la date d'affectation), par un défaut d'encodage ou par l'IA (heures par défaut du poste).
- Anomalie (57), priorisée et expliquée :
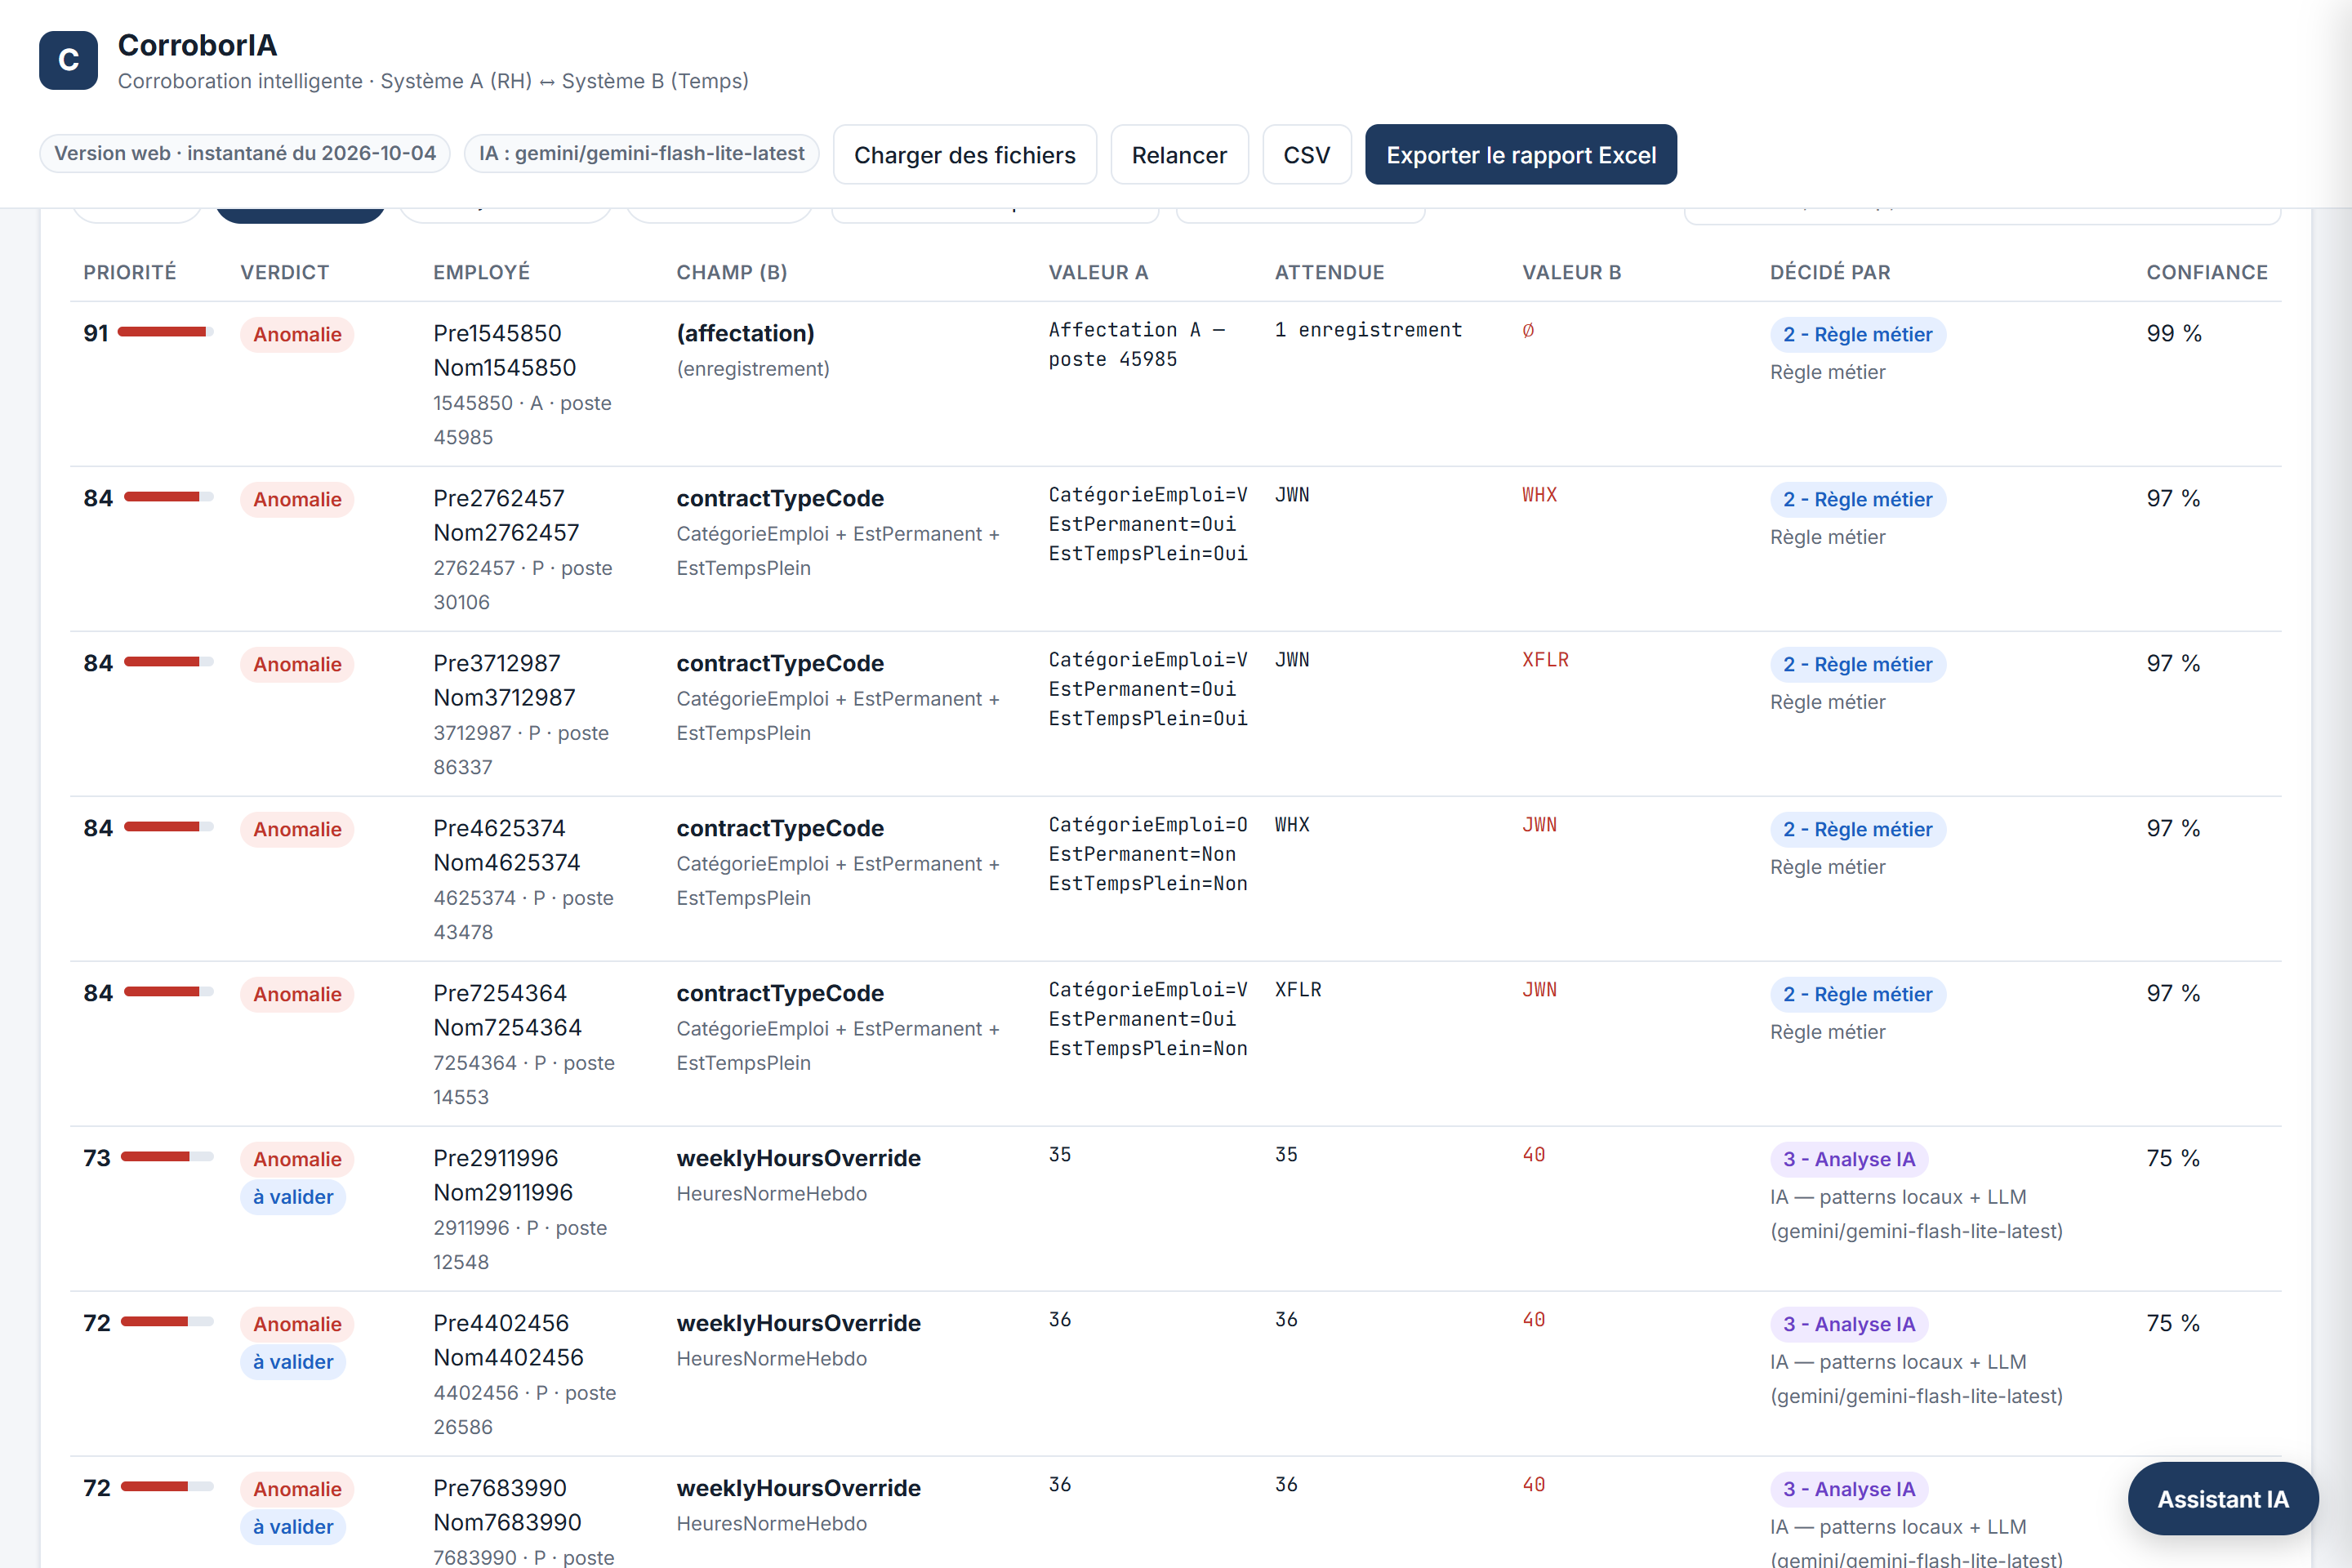
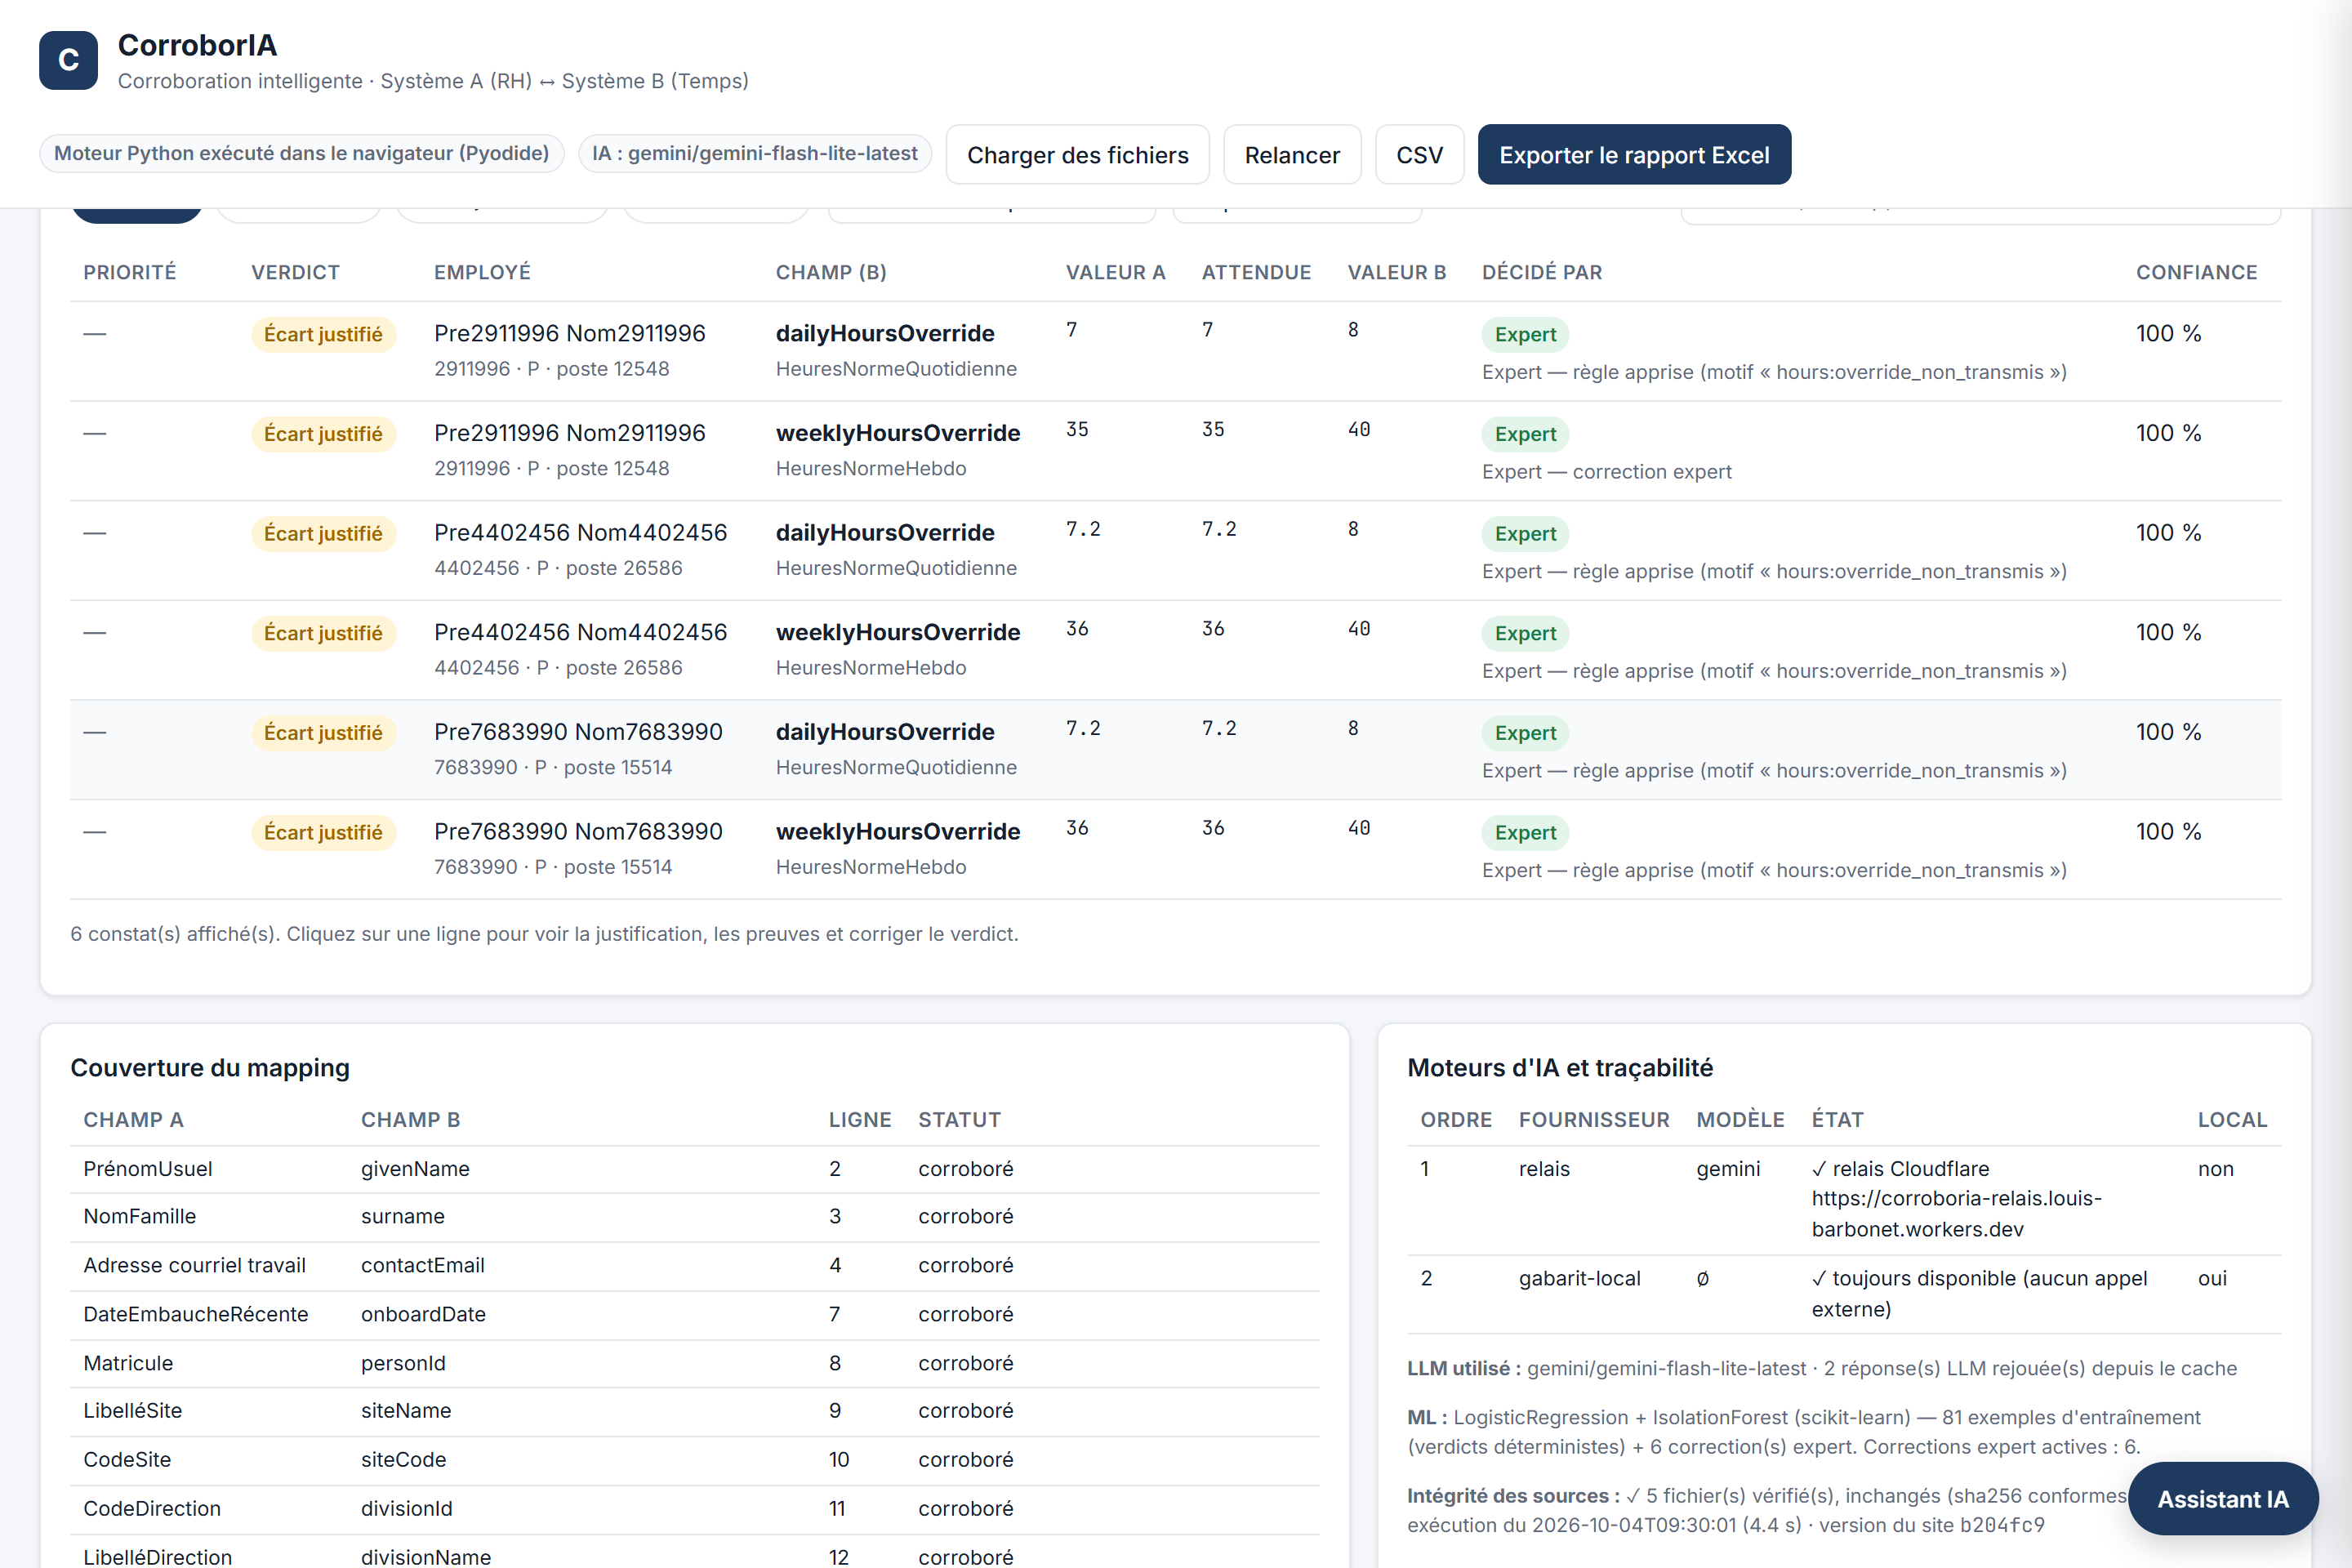
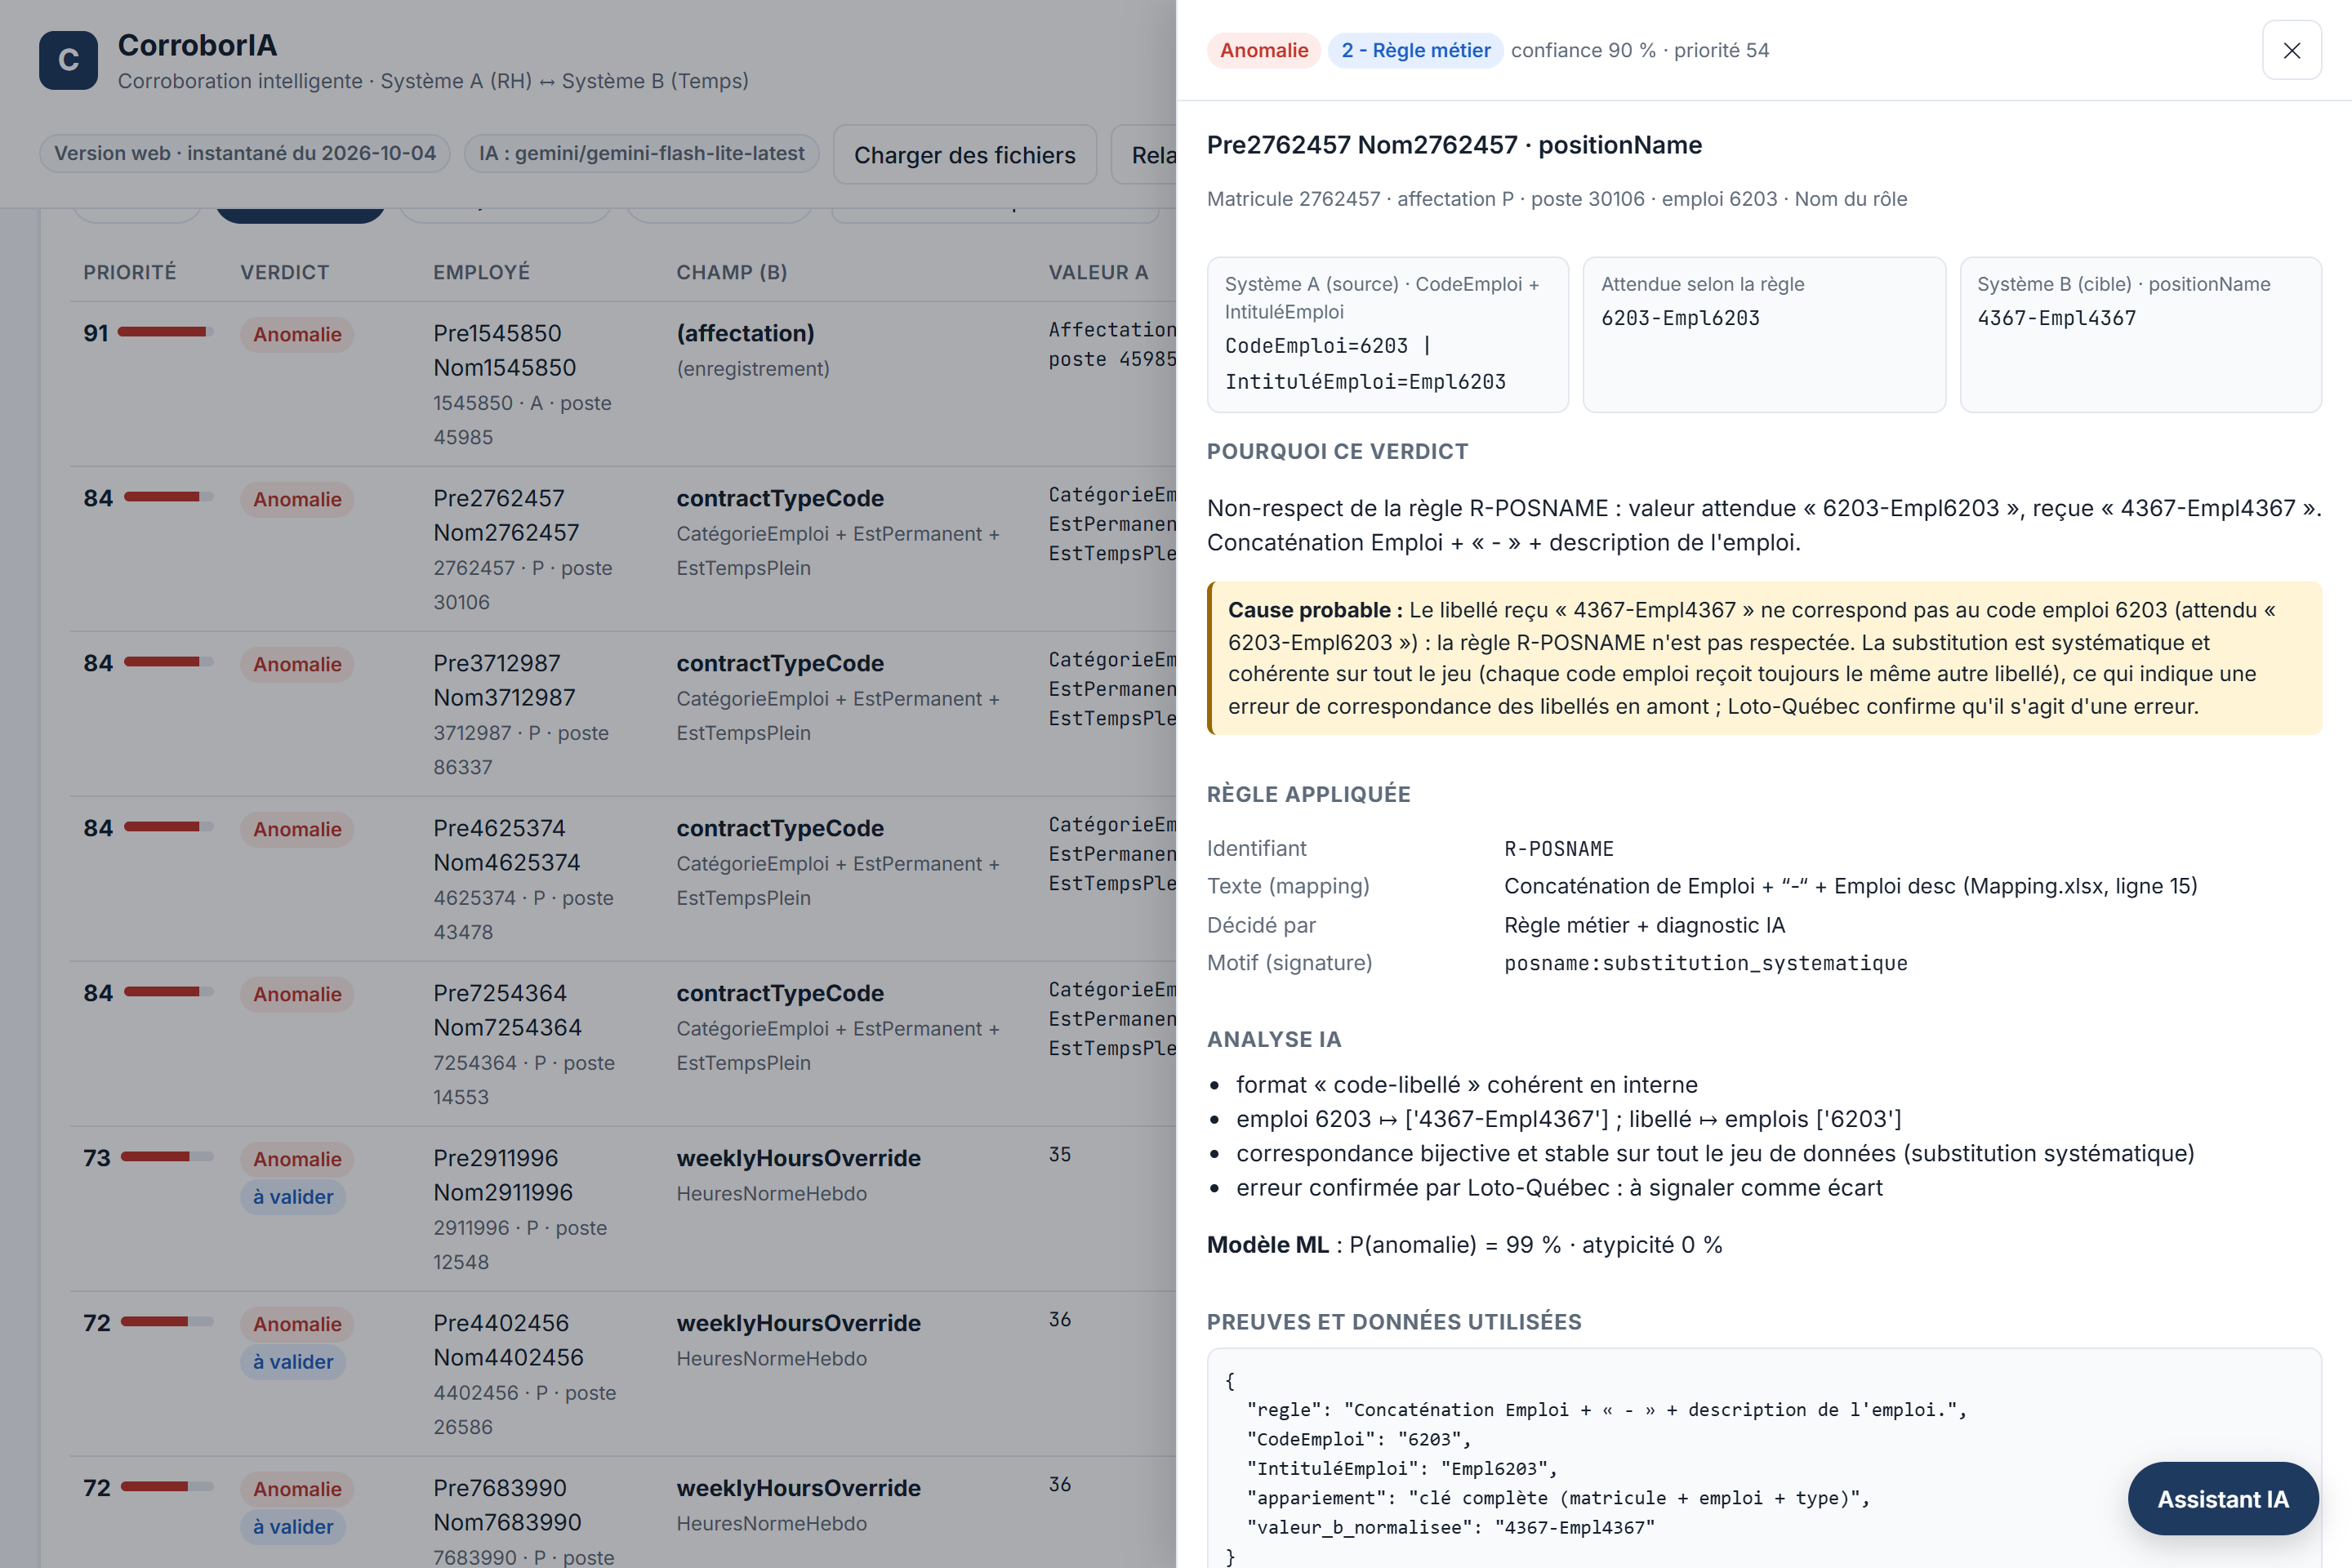
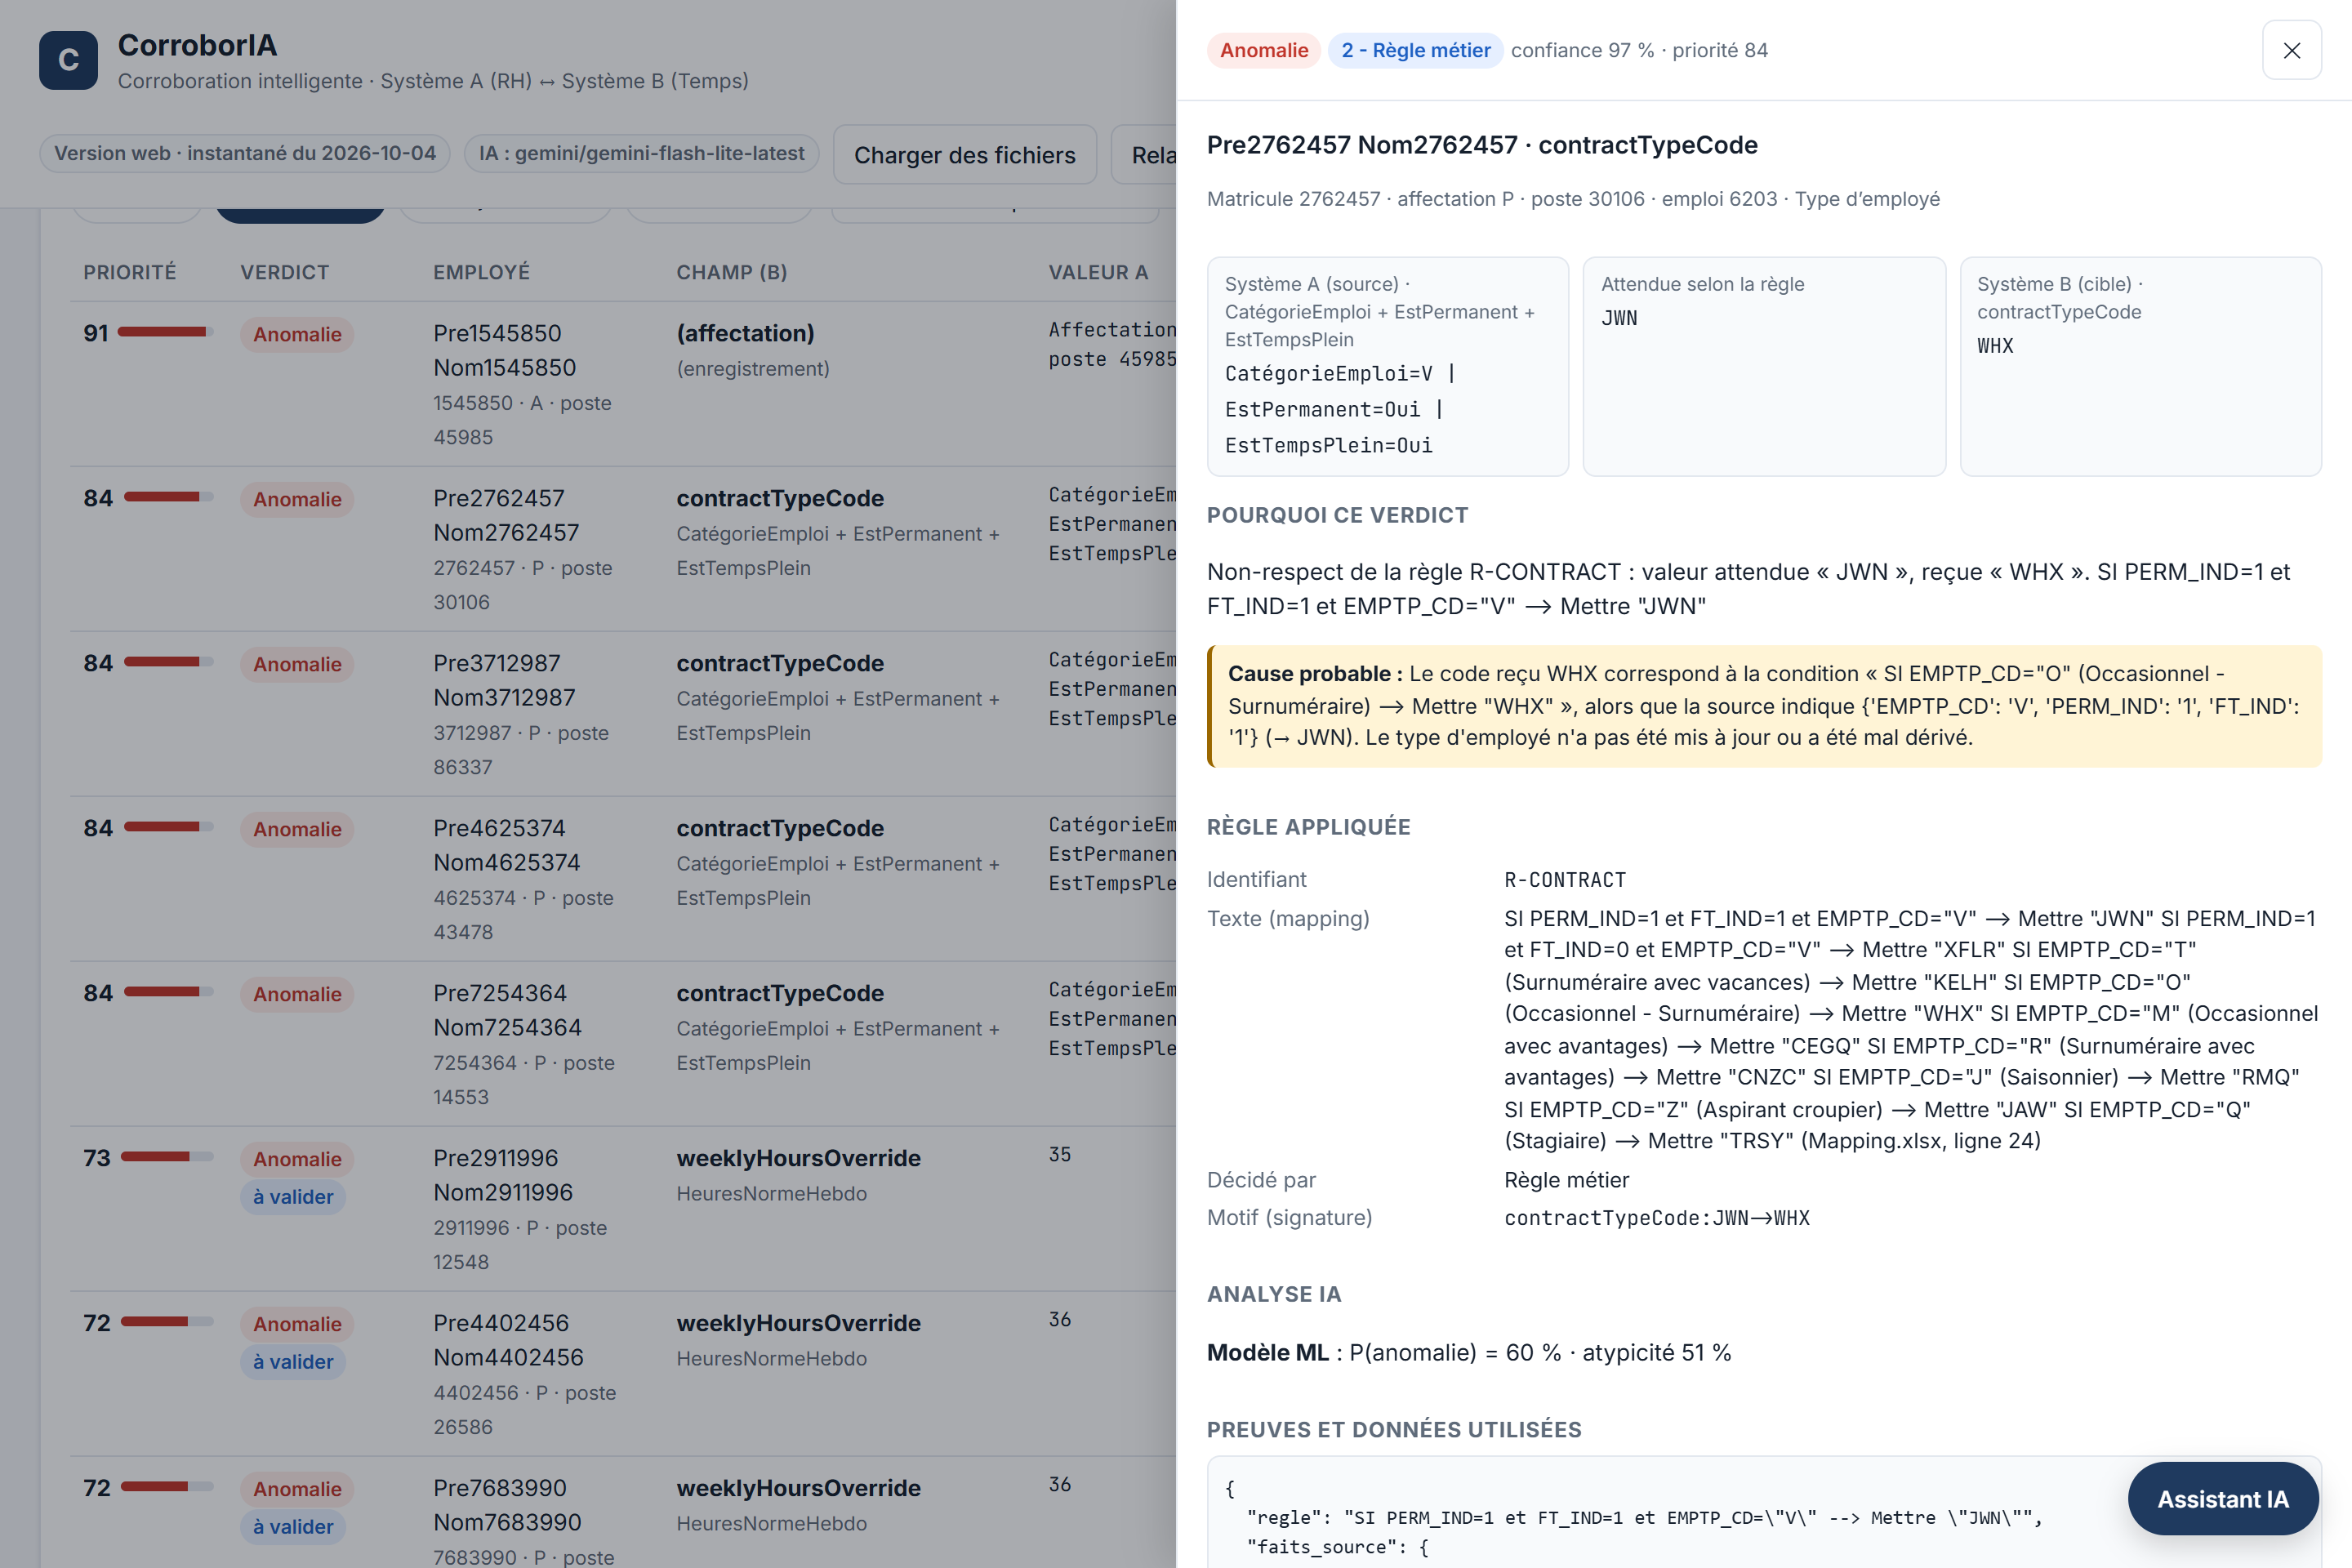
- 13 erreurs nettes : 1 affectation temporaire absente du Système B, 4 types de contrat mal dérivés, 2 libellés d'emplacement incohérents avec leur code, 6 heures non transmises (marquées « à valider » par un expert) ;
- 44 cas de faible priorité, confirmés comme erreurs par Loto-Québec : 22 courriels construits avec un identifiant autre que le matricule (préfixe d'environnement accepté ; erreur d'anonymisation du jeu de test, conservée dans la détection à leur demande) et 22 libellés de rôle dont le préfixe ne correspond pas au code emploi (substitution systématique).
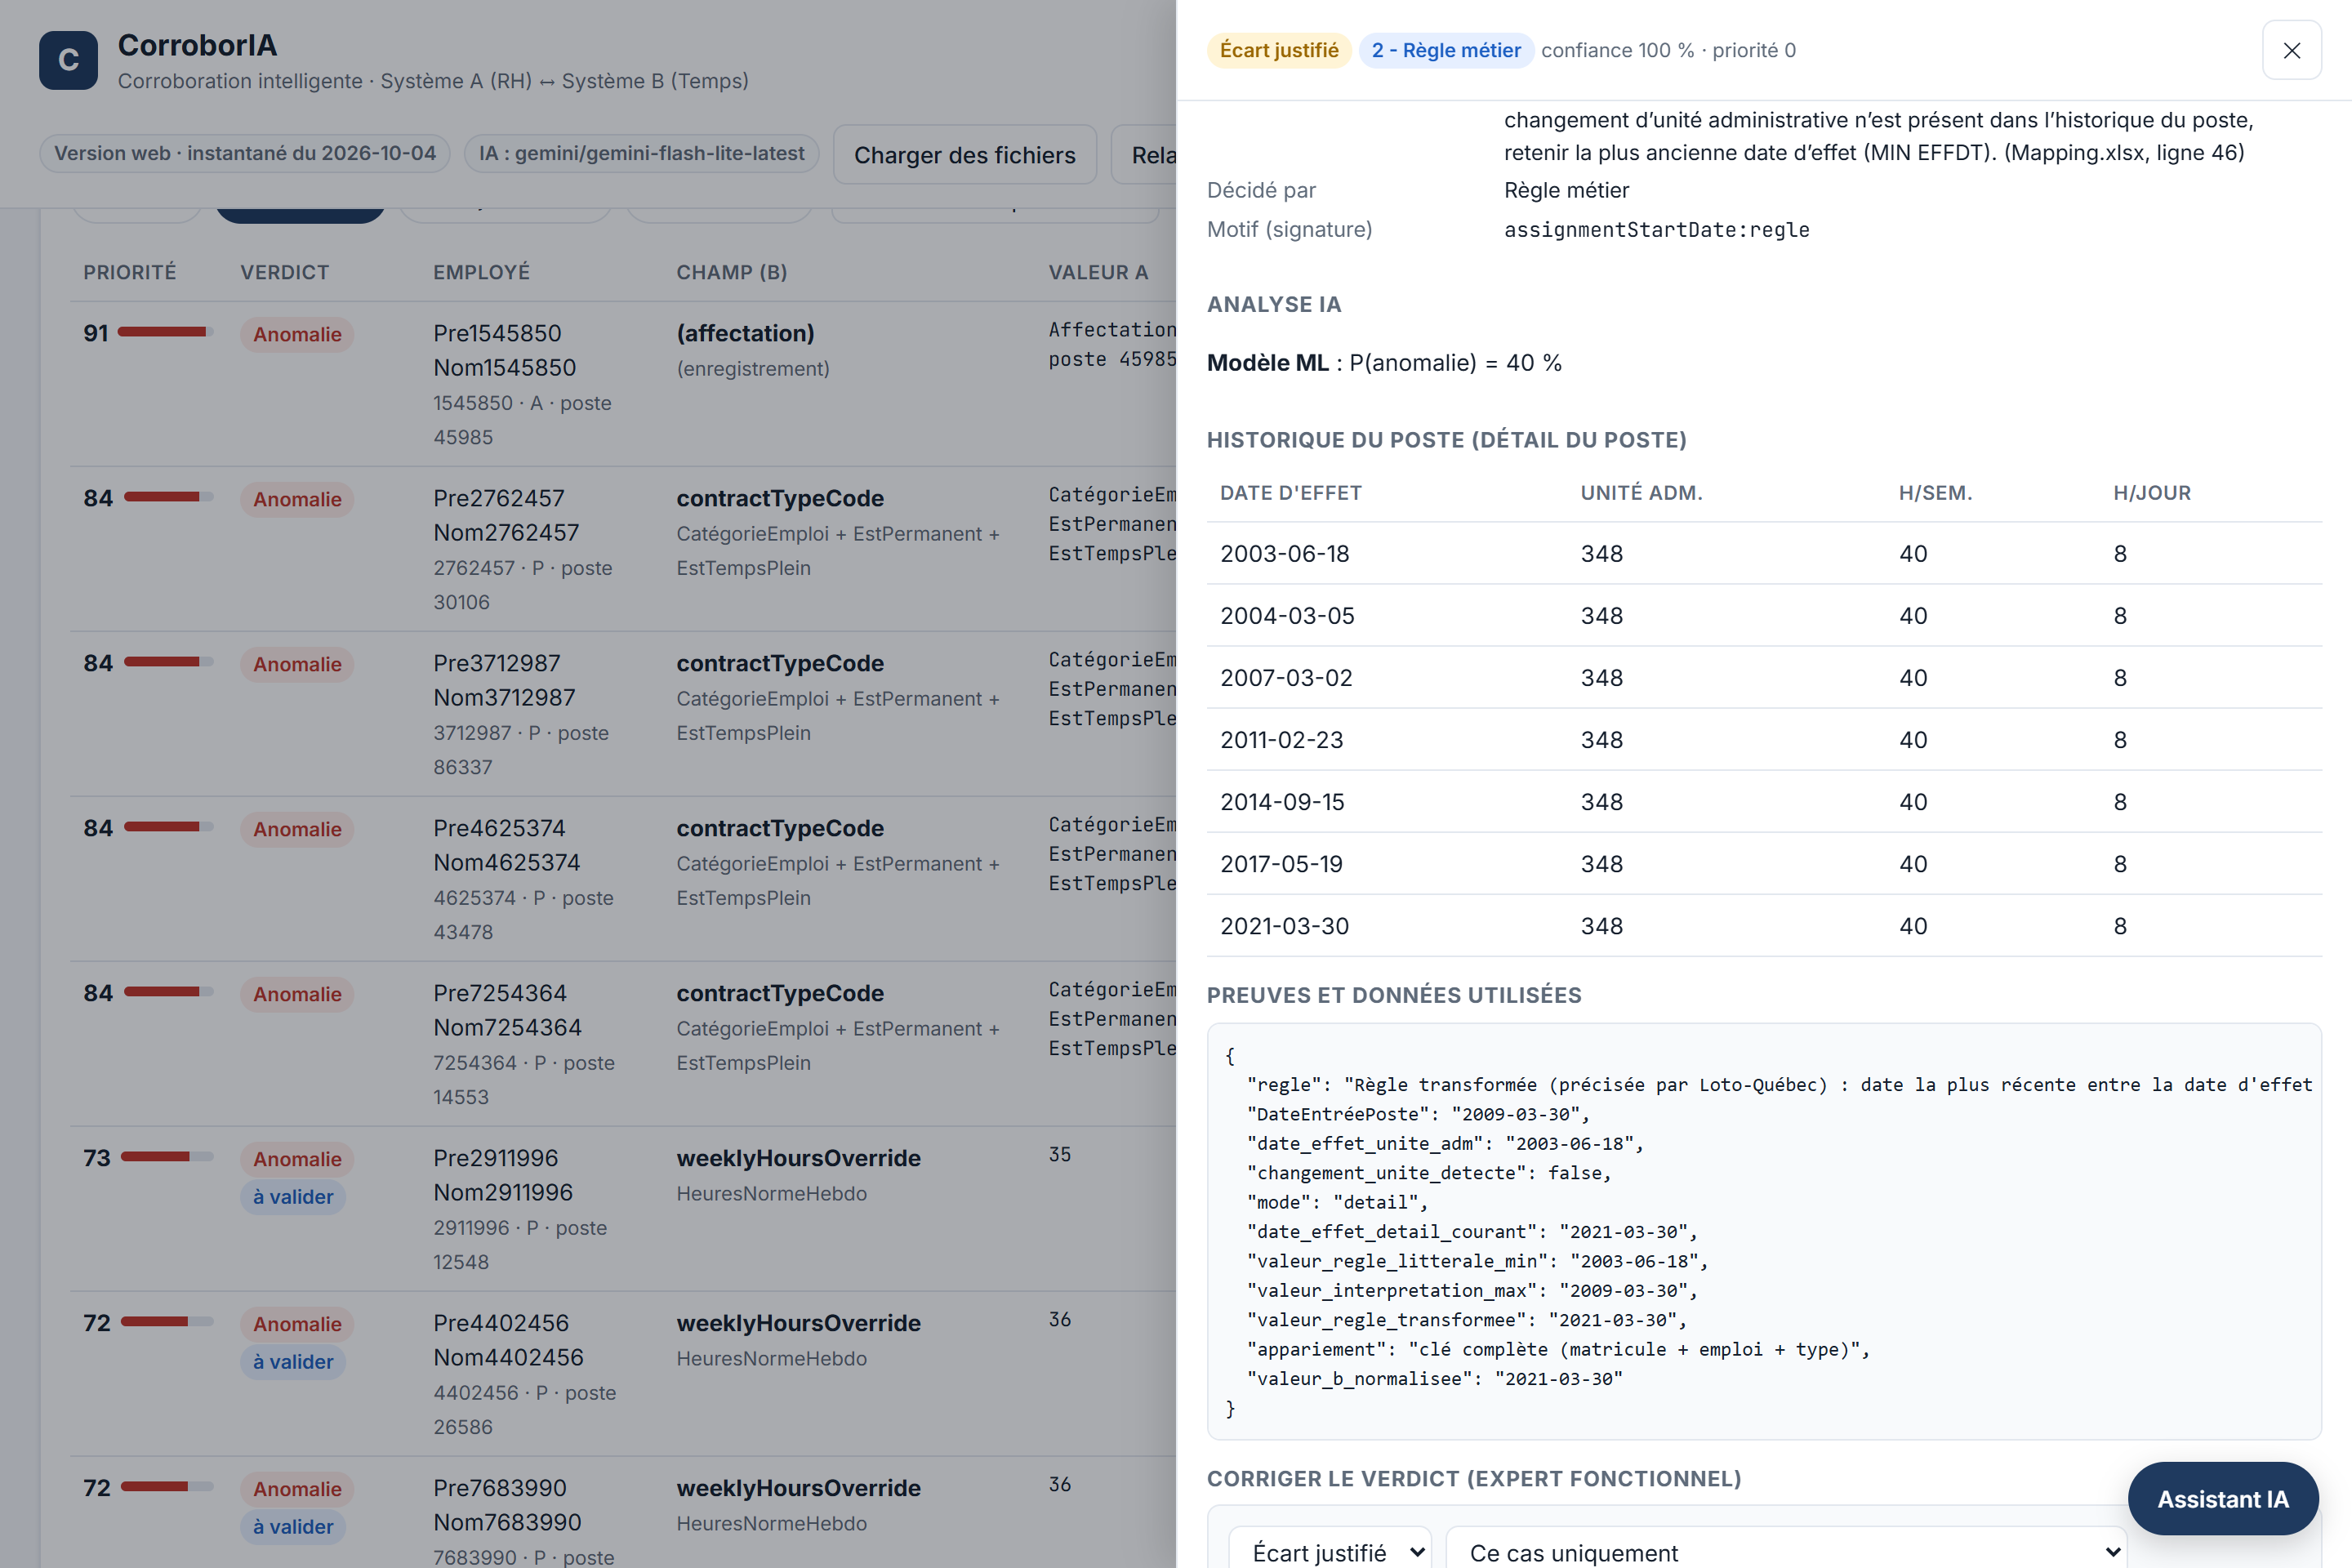
Chaque verdict montre la valeur source, la valeura valeur reçue, le niveau de décision(comparaison, règle métier, IA ou expert), le texte de la règle avec sa ligne dans Mapping.xlsx, les preuves (lignes de jointure, historique du poste), une confiance, unle.
Les résultats se consultent dans une interface wen) et s'exportent en rapport Excel de 10 onglets ou CSV ; le rapport généré est aussi publié dans le dépôt. Les cas ambigus sont arbitrés par Google Gemini, qui rédige aussi la synthèse par cause racine, et un uestions du jury en citant ses sources.
Chaque verdict indique :
- la valeur source, la valeur attendue selon la règle et la valeur reçue ;
- le niveau de décision (comparaison, règle métier, IA ou expert) ;
- le texte de la règle avec sa ligne dans Mapping.xlsx ;
- les preuves utilisées (lignes de jointure, historique du poste) ;
- une confiance et une justification en français.
Les cas ambigus sont arbitrés et expliqués par Google Gemini, qui rédige aussi une synthèse par cause racine avec des recommandations. Les résultats sont consultables dans une interface web et exportables en rapport Excel multi-onglets ou en CSV.
How we built it
Un pipeline hybride à 3 niveaux : les règles tranchent tout ce qui est déterministe, et l'IA intervient là où les règles s'arrêtent.
- Comparaison brute normalisée : dates, vides, booléens, nombres, et réparation de l'encodage (Absence complète → Absence complète).
- Règles métier déterministes, lues directement dans Mapping.xlsx (table des types de contrat, table de situation d'emploi), avec les jointures Motif et Détail du poste et la détection des changements d'unité administrative dans l'historique du poste.
- Analyse IA des écarts qu'aucune règle ne tranche :
- Détecteurs de patterns sur tout le jeu de données :
- vérification de la structure de la règle du courriel, malgré l'identifiant pseudonymisé et le préfixe d'environnement de test ;
- contrôle que la correspondance code d'emploi ↔ libellé est biunivoque (anonymisation cohérente) ;
- comparaison des heures avec les heures contractuelles du poste.
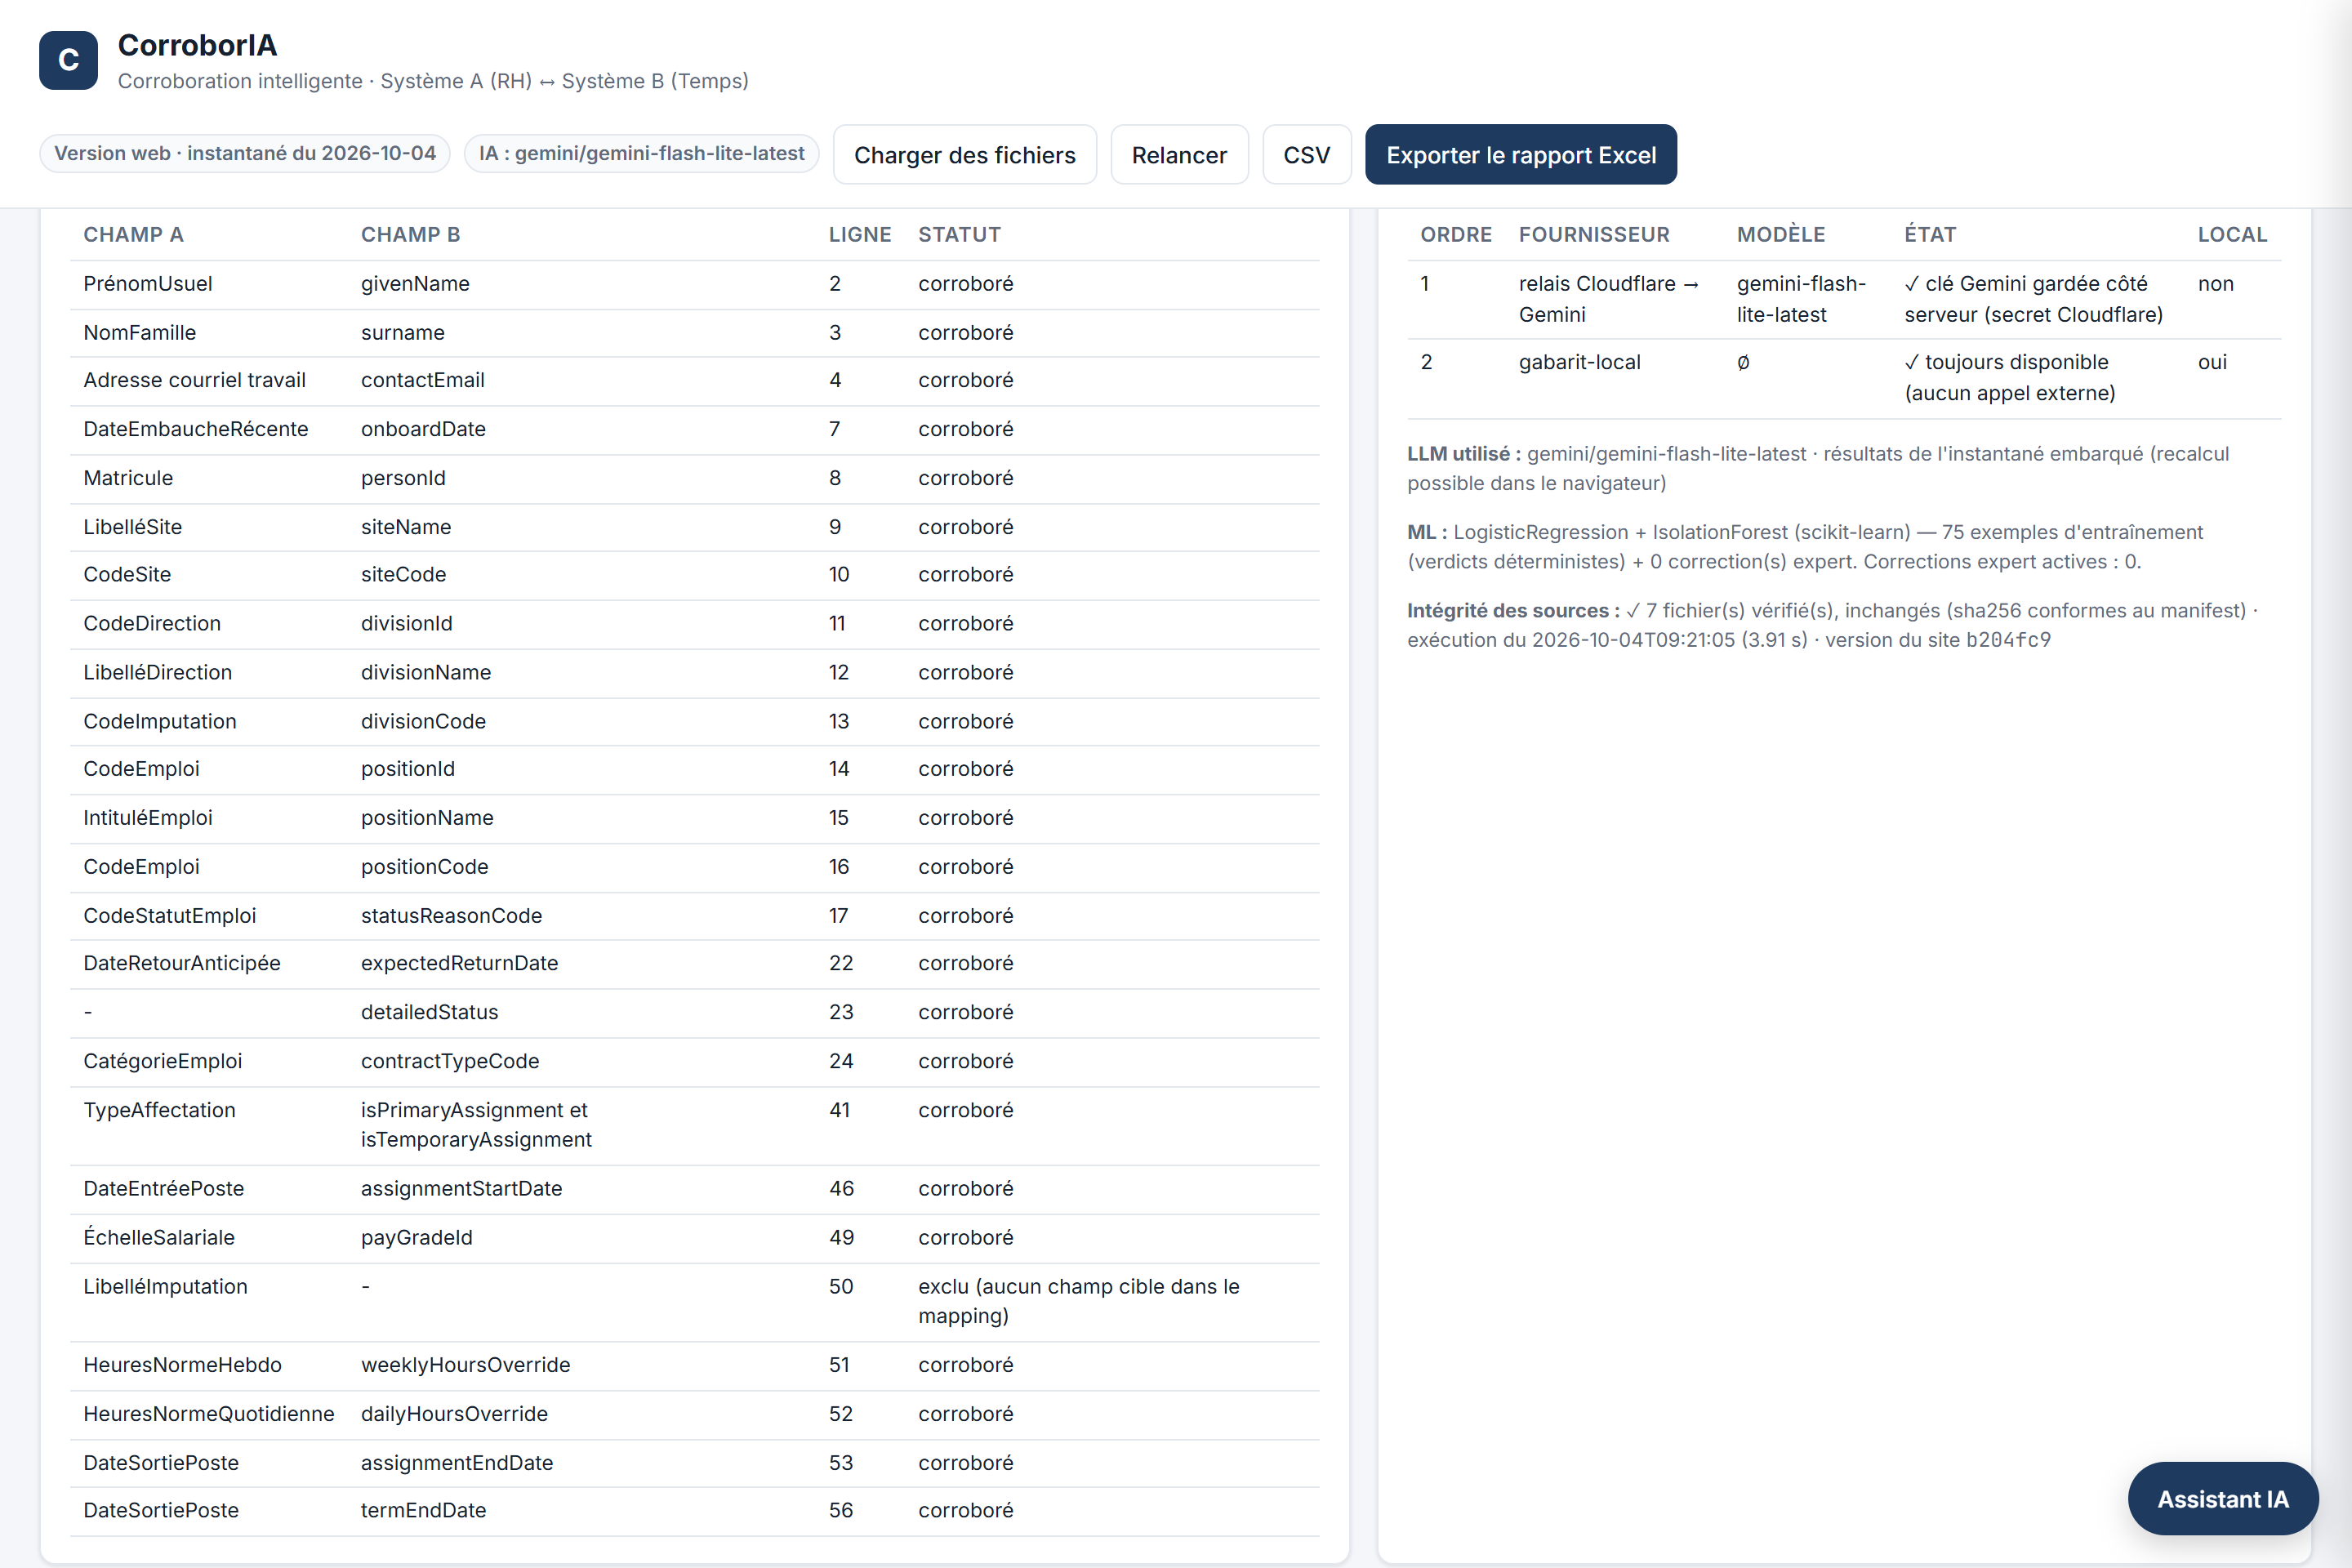
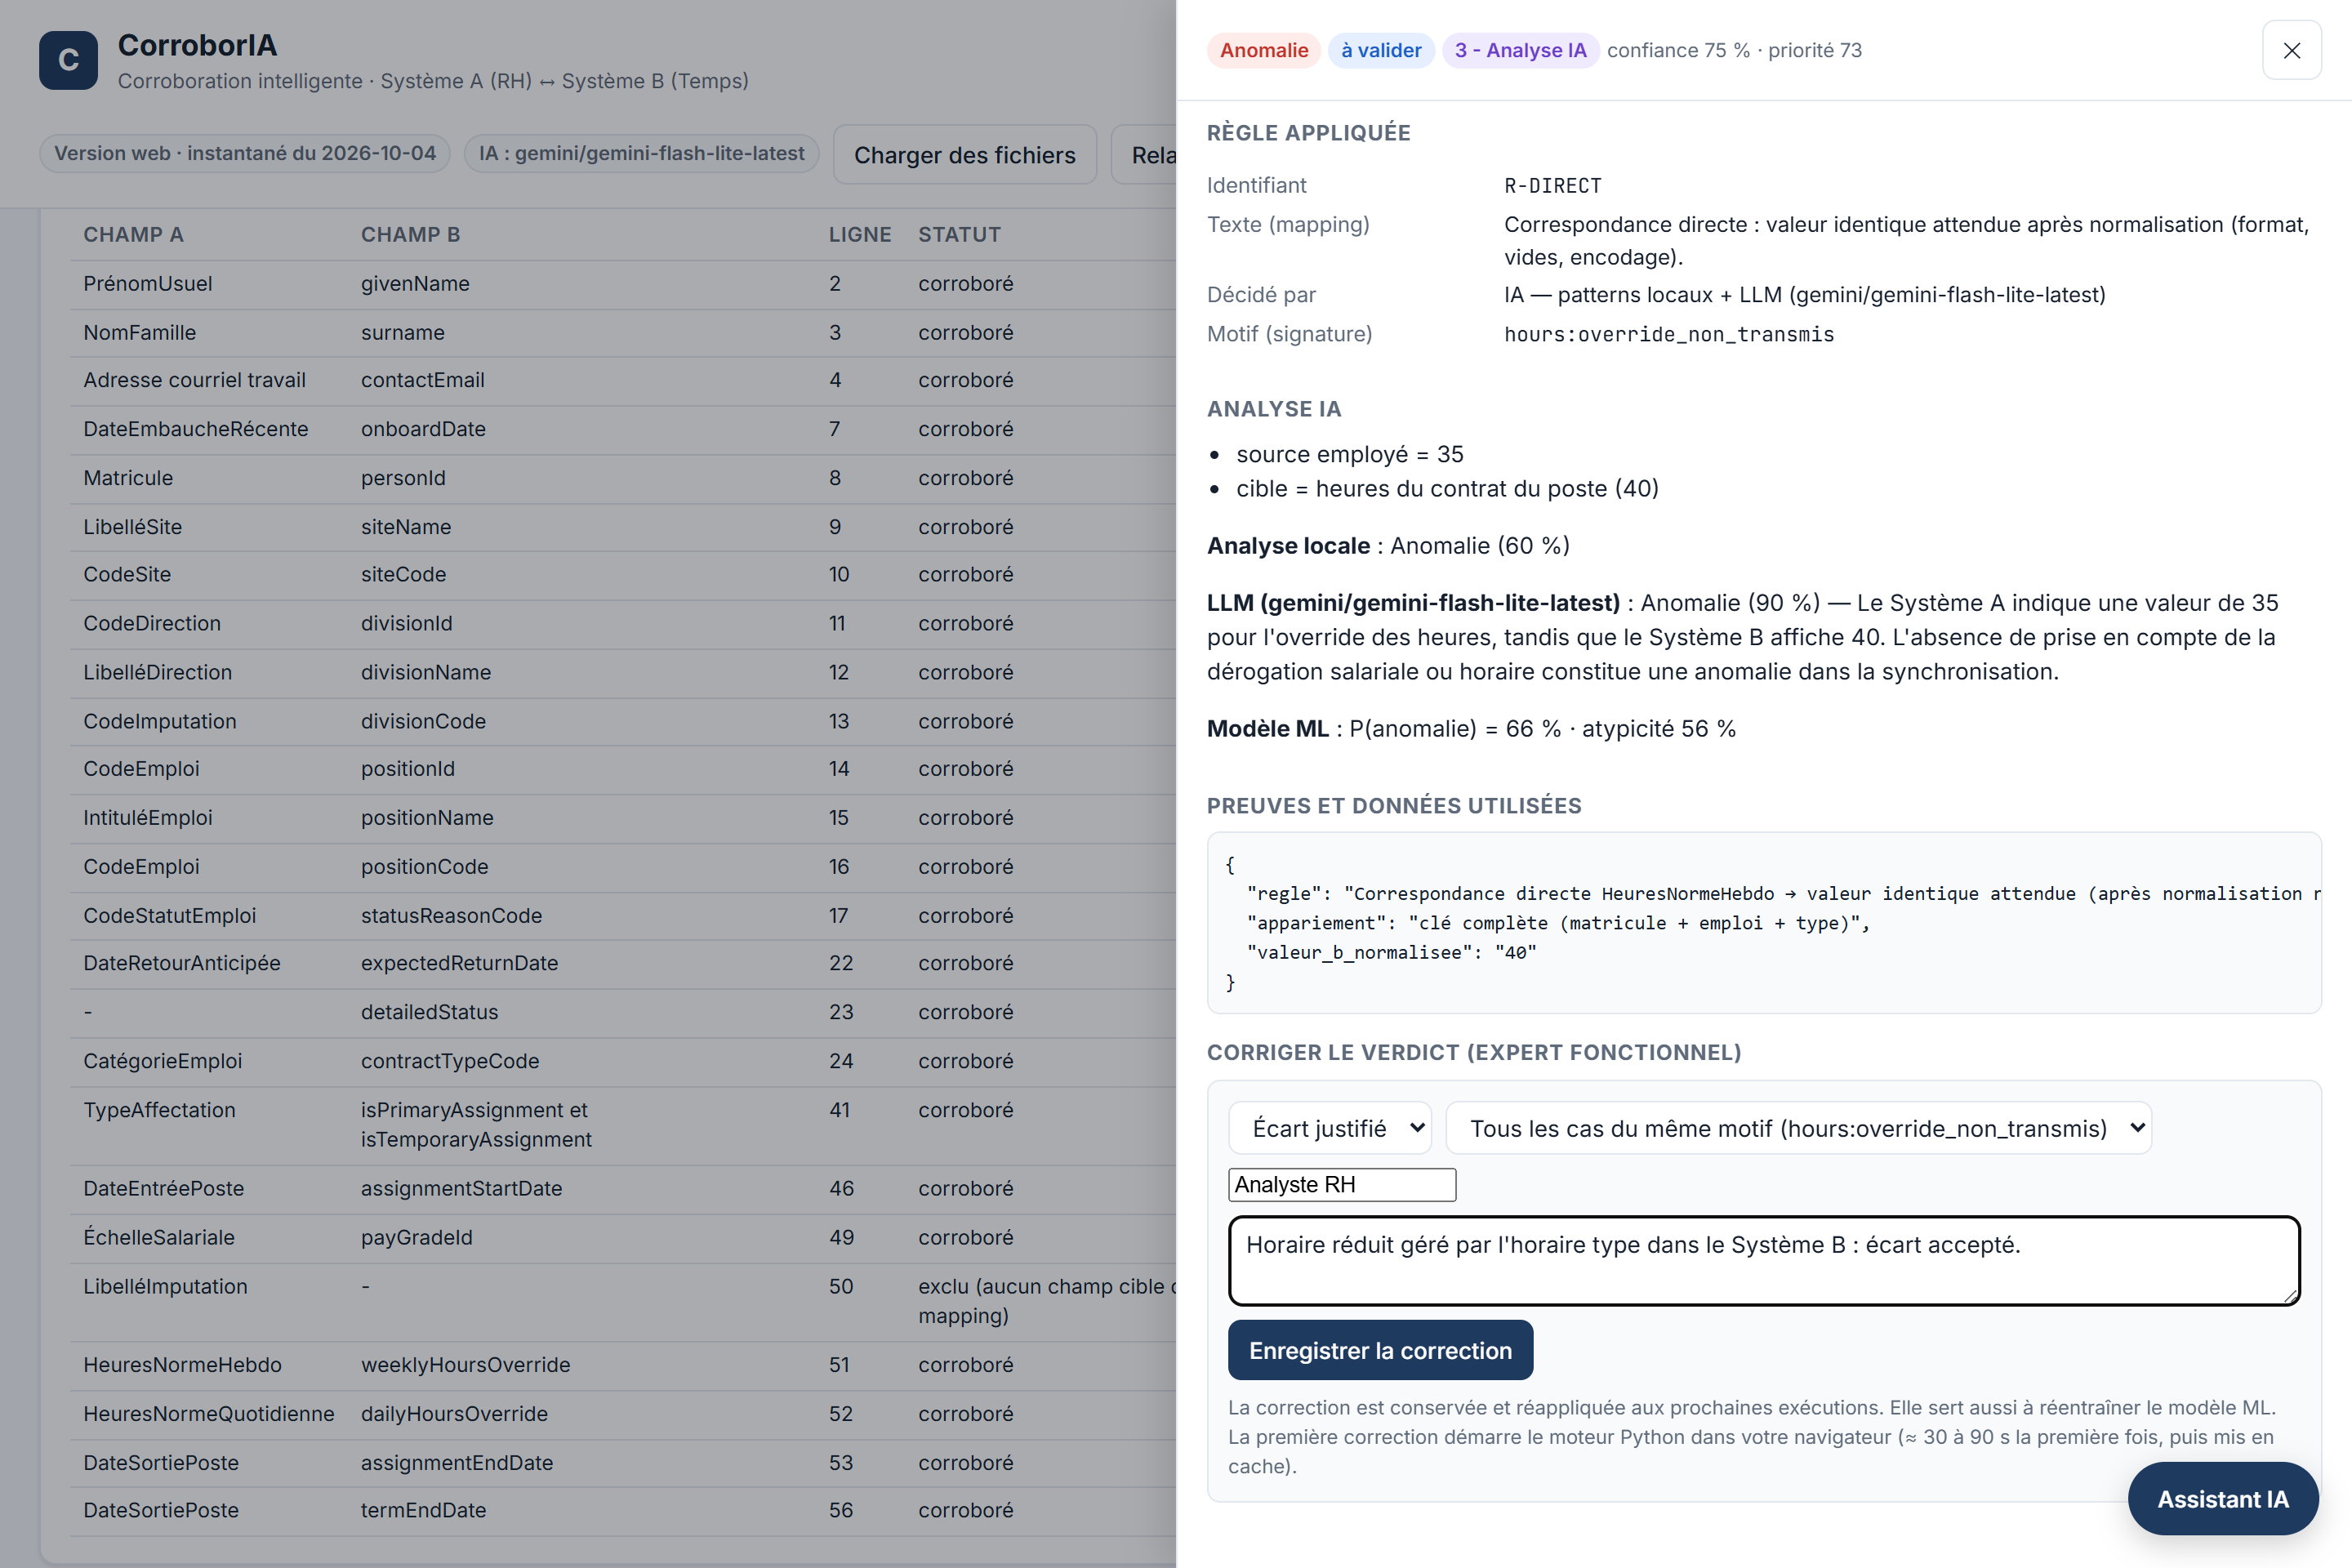
- scikit-learn : une régression logistique, réentraînée à chaque exécution sur les verdicts déterministes et les corrections d'experts (poids ×5), donne une seconde opinion \(P(\text{anomalie})\). Un IsolationForest mesure l'atypicité \(r\) de chaque anomalie.
- LLM -> Google Gemini (gemini-flash-lite-latest) : il arbitre les 50 cas ambigus, envoyés par lots (environ 6 appels par exécution, réponses en cache pour la reproductibilité), en produisant une sortie JSON validée : verdict, confiance et justification en français. Il rédige aussi la synthèse par cause racine. S'il contredit l'analyse locale, le cas est marqué « à valider » et les deux avis restent visibles.
- Détecteurs de patterns sur tout le jeu de données :
La priorité d'une anomalie combine la criticité métier du champ \(c\), la confiance du verdict \(k\), la probabilité ML \(p\), l'atypicité \(r\) et le nombre d'anomalies \(n\) du même employé :
$$ \text{priorité} = 100 \times \left(0{,}50,c + 0{,}25,k + 0{,}10,p + 0{,}10,r + 0{,}05,\min!\left(\tfrac{n}{4},,1\right)\right) $$
Calibration de règle : quand une règle du mapping est ambiguë, le moteur confronte ses interprétations aux données et documente son choix.
Boucle expert : un expert corrige un verdict pour un cas ou pour tous les cas du même motif ; la correction devient une règle apprise traçable et réentraîne le modèle de priorisation.
Version en ligne : site statique sur GitHub Pages (Vite) qui affiche instantanément un instantané des résultats ; le vrai moteur Python tourne dans le navigateur grâce à Pyodide (pandas, scikit-learn) pour le recalcul, le téléversement de fichiers, les corrections et les exports. Les appels LLM passent par un relais Cloudflare Worker : la clé Gemini y est un secret, le relais construit lui-même les consignes et n'accepte que des données structurées, avec CORS, validation stricte, cache KV, limite par IP et plafond quotidien. Chaîne de repli automatique (Claude, Ollama, Groq, Gemini, OpenRouter, gabarit local) : tout fonctionne aussi sans clé, hors ligne.
Qualité : fichiers sources en lecture seule (contrôle sha256), 52 tests automatisés (33 Python, 19 JavaScript — dont un test qui vérifie que chaque repère cité par le chat existe), CLI, API FastAPI, notebook Jupyter, rapport publié.
Challenges we ran into
- Une règle contredite par les données. Le mapping dit « date la plus ancienne » pour assignmentStartDate, mais cette lecture ne concorde avec aucune des 22 lignes du Système B. Nous avons donc ajouté une calibration automatique : le moteur mesure chaque interprétation contre les données (\(0/22\) contre \(19/22\) pour « la plus récente »), retient la plus cohérente, la documente dans le rapport et la rend configurable.
- L'anonymisation fausse les comparaisons. Les courriels et les libellés d'emploi diffèrent toujours. Il a fallu distinguer une pseudonymisation cohérente d'une vraie erreur en raisonnant sur l'ensemble du jeu, et non ligne par ligne.
- Plusieurs affectations par employé (primaire, temporaire, secondaires), alors que la cible n'a pas de numéro de poste : il a fallu concevoir une clé d'appariement avec repli.
- Des extractions imparfaites : un CSV tassé dans une seule colonne Excel, des dates en sériel Excel d'un côté et en ISO de l'autre, des caractères accentués mal encodés.
- Des LLM gratuits peu fiables : quotas, délais dépassés, JSON invalide. D'où la chaîne de repli et la validation stricte de chaque réponse.
Accomplishments that we're proud of
- Les 13 erreurs nettes sont détectées avec leur cause probable (ex. « WHX correspond à un employé Occasionnel alors que la source indique permanent, temps plein »).
- Une traçabilité complète : on distingue toujours une décision par règle d'une décision par IA, et l'on voit la règle et les données qui ont mené au verdict.
- Une IA utile, pas décorative : arbitrage, diagnostic de motifs, priorisation, calibration de règle, synthèse, apprentissage des corrections, chat avec citations.
- Des choix validés avec les organisateurs plutôt que supposés.
- Un prototype en ligne, sans installation, qui fonctionne aussi 100 % hors ligne, couvert par 52 tests.
What we learned
- L'approche hybride est la plus fiable : les règles assurent l'exactitude et l'auditabilité, l'IA traite l'ambiguïté et l'explication.
- Confronter une règle métier aux données révèle des écarts de documentation aussi précieux que les erreurs de données elles-mêmes.
- Pour un jury comme pour une équipe fonctionnelle, l'explication compte autant que le verdict : pourquoi, selon quelle règle, à partir de quelles données.
What's next for the CorroborAI by The Optimizers
- Améliorer le UI/UX pour mieux correspondre aux marqueurs d'identité visuelle de Loto-Québec.
- Généraliser les détecteurs à d'autres interfaces RH et à d'autres systèmes cibles.
- Gérer l'historique et plusieurs utilisateurs pour les corrections d'experts.
- Planifier des corroborations récurrentes avec un suivi des tendances d'anomalies.
- Proposer automatiquement de nouvelles règles métier à partir des corrections validées.
Try it out
- (POUR LE JURY) Application en ligne (aucune installation) : https://louisbarbonet.github.io/CorroborAI/
Built With
- claude
- claude-code
- css3
- ftfy
- gemini
- git
- github
- html5
- httpx
- javascript
- jupyter
- llm
- machine-learning
- numpy
- ollama
- openpyxl
- openrouter
- pandas
- pytest
- python
- scikit-learn
- uvicorn

Log in or sign up for Devpost to join the conversation.