Inspiration
Un modèle de bourses qui a 88 % d'exactitude, ça a l'air bien. Mais il donne une bourse à 48 % des candidats de Montréal et Québec, et à seulement 27 % des candidats du Bas-Saint-Laurent, de la Côte-Nord et de la Gaspésie. On s'est posé une question simple : est-ce que ces étudiants ont vraiment des dossiers plus faibles, ou est-ce qu'on les pénalise juste parce qu'ils habitent loin ?
What it does
Notre projet fait trois choses :
- Il mesure le biais. À dossier égal, habiter en région éloignée coûte environ 1,4 point de cote R. Le comité donne aussi une prime aux familles aisées, ce qui pénalise les régions une deuxième fois.
- Il le corrige. On classe les candidats avec un score de mérite que tout le monde peut comprendre :
$$\text{score} = \text{cote R} + 0{,}145 \times \text{heures travaillées par semaine}$$
On donne la bourse aux 1600 meilleurs (40 %). Pas de région, pas de code postal, pas de distance, pas de revenu.
- Il propose un plan pour la production. Tableau de bord par région, seuils d'alerte, comité d'équité, revue humaine des cas limites et droit de recours.
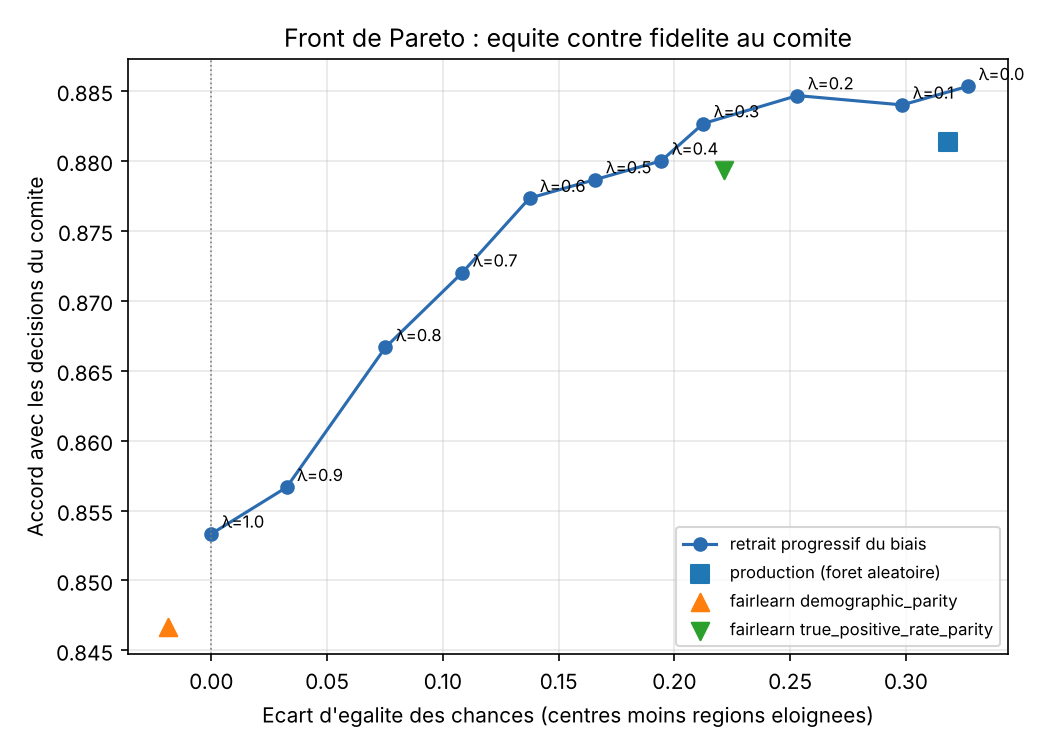
Résultat : entre 38 % et 42 % de bourses dans chaque région. L'écart d'égalité des chances passe de 0,32 à presque 0. Sur l'étalon indépendant, on obtient 94,63 % d'exactitude et 94,40 % de F1 macro.
How we built it
- On a d'abord modélisé les décisions du comité avec une régression logistique. Une forêt aléatoire ne faisait pas mieux, donc on pouvait lire les coefficients directement.
- On a traduit chaque effet en "points de cote R". Ça rend le biais facile à expliquer : la région vaut -1,4 point, doubler le revenu vaut +0,9 point.
- On a cherché les proxys : le code postal devine la région à 100 %, la distance à 99,7 %.
- On a choisi l'égalité des chances plutôt que la parité. À mérite égal, même chance. La parité aurait imposé un quota.
- On a tracé un front de Pareto en retirant le biais par étapes, et on l'a comparé à deux corrections fairlearn.
- Pour valider, on a testé une seule idée à la fois contre le score indicatif : poids des heures, revenu, région, distance, programme. Chaque ajout faisait baisser le score.
Outils : Python, pandas, scikit-learn, statsmodels, fairlearn, matplotlib, Jupyter.
Challenges we ran into
Le plus dur : on n'avait pas la vraie réponse. La colonne decision_octroi, c'est la décision du comité, celui qu'on audite justement. Si on l'imite parfaitement, on copie parfaitement le biais. Il a fallu définir nous-mêmes ce qu'est le mérite, puis le vérifier autrement.
On a aussi vu en direct que supprimer la colonne région ne sert presque à rien : l'écart de parité passe juste de 0,188 à 0,173. Le biais revient par le code postal et la distance.
Enfin, choisir entre parité et égalité des chances, c'est un vrai débat de valeurs. On a pris le temps d'en discuter avant de coder.
Accomplishments that we're proud of
- Un modèle que n'importe quel candidat peut comprendre en une ligne.
- Un biais expliqué avec des chiffres simples : 1,4 point de cote R.
- La preuve que la prime au revenu est un biais : la formule du comité sans la région obtient 92,5 %, notre score 94,6 %.
- Un plan de gouvernance concret, pas juste un modèle.
What we learned
- Un bon score d'exactitude peut cacher une grosse injustice.
- Enlever une variable sensible ne suffit pas quand d'autres colonnes la remplacent.
- Le choix de la métrique d'équité est un choix de valeurs, et il faut pouvoir le défendre.
- Souvent, un modèle simple et transparent vaut mieux qu'un modèle complexe.
What's next for EquiAlgo
- Vérifier si la cote R elle-même porte un biais régional (écoles moins financées, moins de cours offerts).
- Suivre la réussite réelle des boursiers à l'université pour valider la définition du mérite.
- Construire le tableau de bord de suivi et le tester sur plusieurs cohortes.
Built With
- fairlearn
- github
- jupyter
- matplotlib
- numpy
- pandas
- python
- scikit-learn
- statsmodels

Log in or sign up for Devpost to join the conversation.