Inspiration
Nerdearla tiene charlas en español y en inglés, y público que no comparte ninguno de los dos por completo. Interpretación humana simultánea cuesta caro, no escala a diez salas en paralelo y no deja transcripción para después.
La pregunta no era si se puede traducir en vivo. Era por qué cuesta tanto que una conferencia lo tenga. La respuesta resultó arquitectónica: casi todo decodifica el audio una vez por cada idioma. Seis idiomas, seis veces el trabajo caro.
What it does
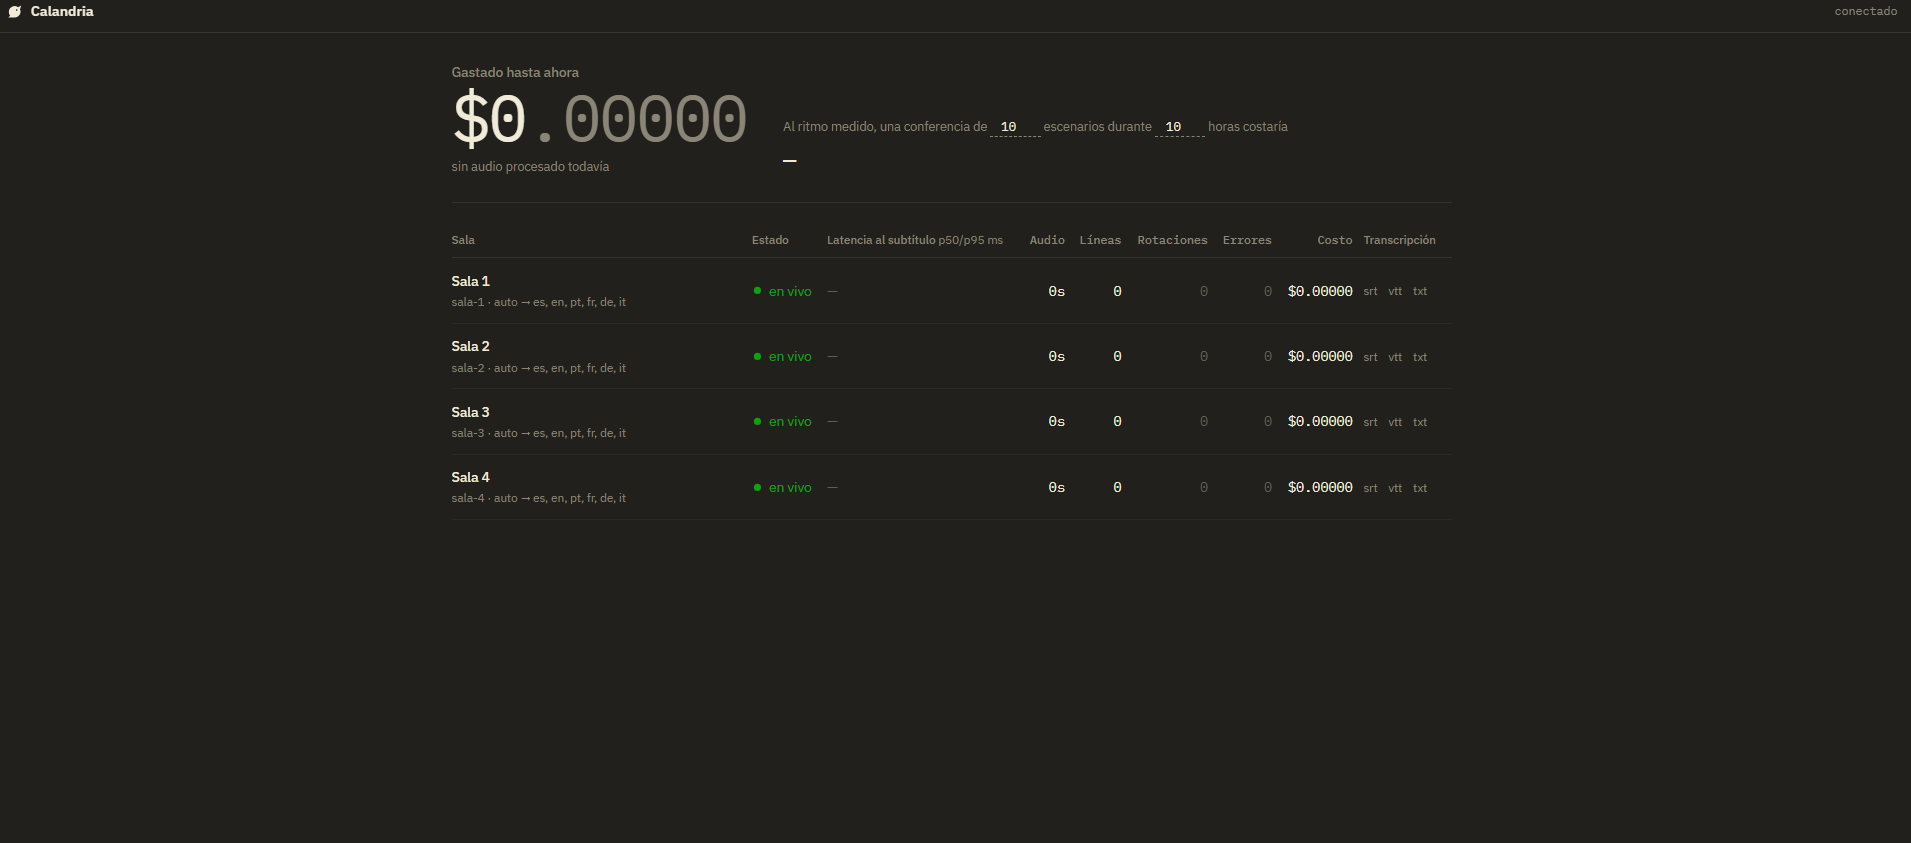
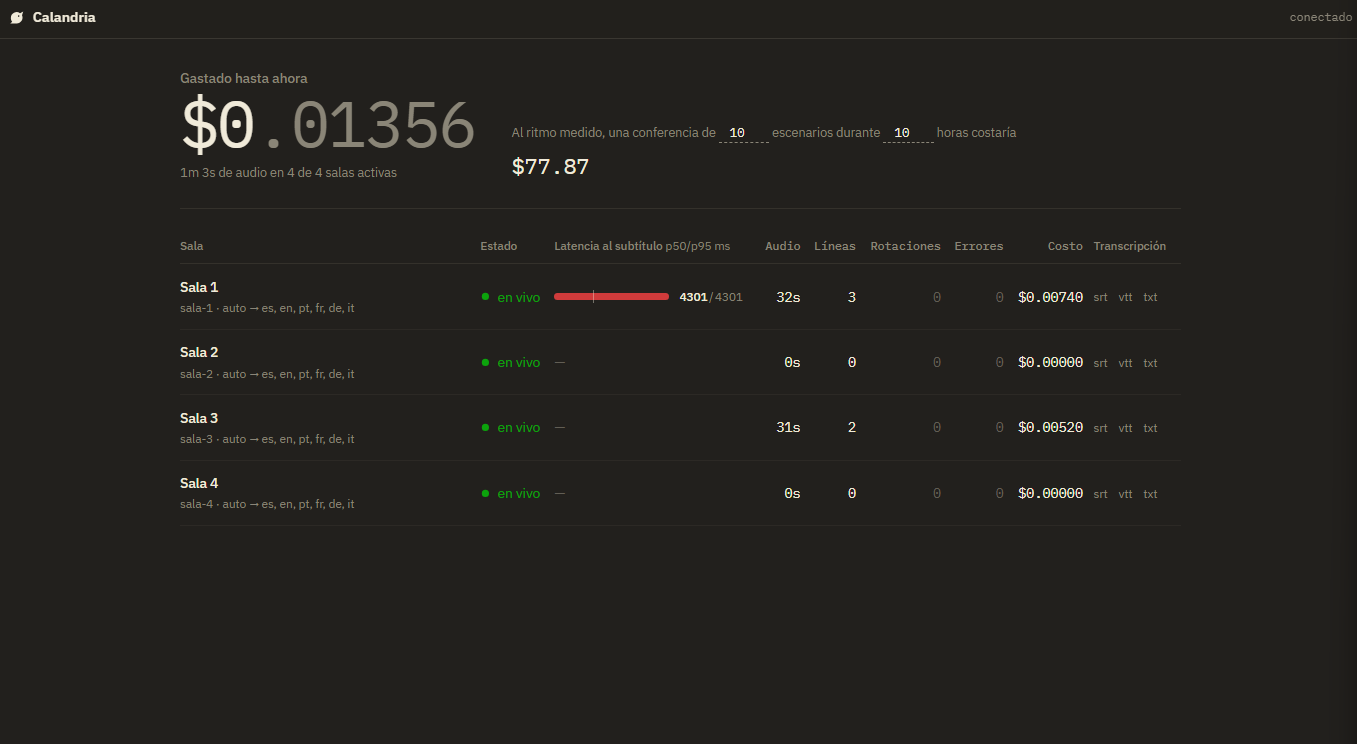
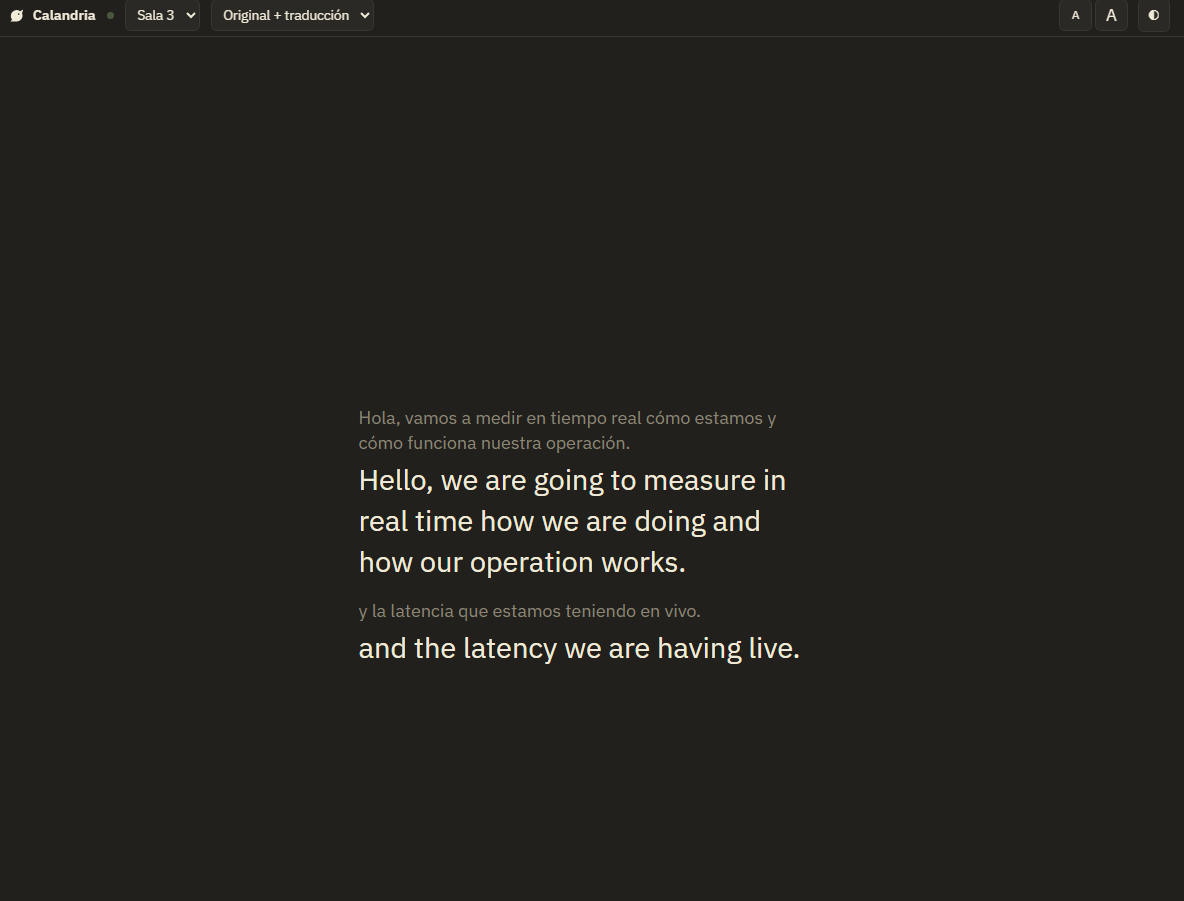
Toma el audio de una sala y devuelve subtítulos en el idioma original y traducidos a cuantos idiomas quiera el evento. El público entra desde el navegador, elige sala e idioma, y lee con 693 ms de atraso (p50).
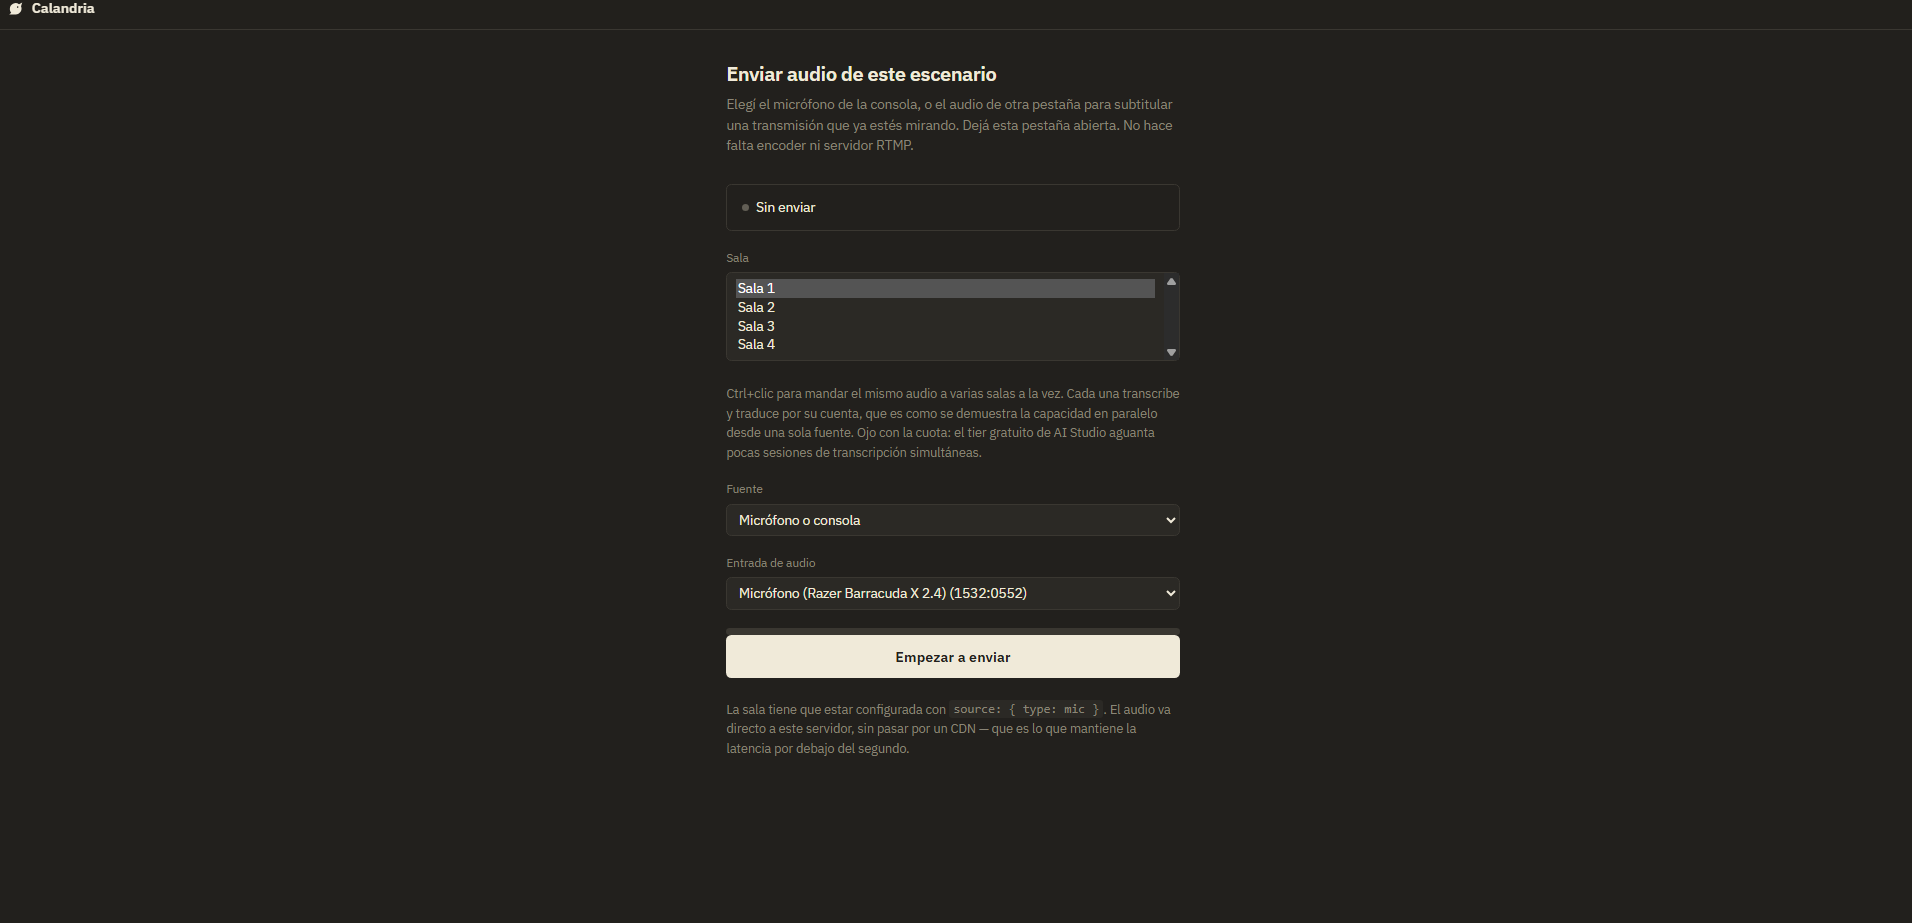
El audio entra de cuatro formas: un archivo, un stream con URL, el micrófono de la consola, o el audio de otra pestaña del navegador. Esto último permite subtitular una transmisión que sólo se puede mirar, como una plataforma detrás de login. No se toca el stream: lo que la pestaña suena es lo que se subtitula.
Una sala puede no declarar su idioma. El modelo lo detecta por enunciado, así que una mesa bilingüe o una pregunta del público se traducen en vez de romperse.
How we built it
El audio se decodifica una vez y el texto se reparte. Transcribir es lo caro; traducir texto es barato. Una sala con cinco idiomas paga una transcripción y cinco traducciones, no seis decodificaciones. De ahí que el costo por idioma extra sea casi plano: USD 0.65 por sala-hora.
Streaming, no troceado. gemini-3.5-transcribe-live por WebSocket. Trocear en pedazos de cuatro segundos da cuatro segundos de latencia como piso.
Y las oraciones se liberan solas: el modelo marca fin de habla cuando el orador pausa, y un orador en pleno vuelo puede no pausar en veinte segundos. Calandria libera una oración cuando el modelo deja de revisarla, sin esperar esa marca.
Python, FastAPI, asyncio, WebSockets. El bus es intercambiable, en memoria o Redis, así que un evento grande reparte salas entre réplicas sin cambiar código.
Challenges we ran into
Lo difícil fue decidir qué texto ya vio el público. Cuatro diseños fallaron. El error estaba en la pregunta: yo preguntaba si algo ya se había mostrado, un booleano, cuando lo correcto es cuánto ya se mostró, una longitud. Un enunciado que vuelve casi siempre trae habla nueva al final, así que "¿ya lo vieron?" no tiene buena respuesta: suprimir pierde lo nuevo, mostrar repite lo viejo.
Después apareció algo que no está documentado: una sesión de Live se deteriora con la edad y no da error. La misma frase corta salió subtitulada en 1,5 s al empezar la sesión y en 19,5 s un minuto después. La rotación existía, pero dimensionada contra el límite de 10 minutos de la API, que es el límite que la documentación menciona y el equivocado. Rotando cada 75 segundos el atraso se mantiene entre −0,4 s y 2,1 s a lo largo de cuatro rotaciones.
También perdí un día midiendo en la capa equivocada. El reporte era "tarda"; yo medía el WebSocket y obtenía menos de un segundo. Mis números eran correctos y respondían una pregunta que nadie había hecho: la demora estaba en la página, que sólo pintaba frases cerradas.
Lo peor son las fallas que ningún contador reporta. Dos pestañas de captura sobre la misma sala mezclan dos copias del ambiente en un solo audio. La latencia se fue de 1 s a 8 s y después los subtítulos pararon, con el panel marcando sala corriendo, cero descartes y cero errores.
Accomplishments that we're proud of
Todos los números están medidos, ninguno estimado, y cada uno se reproduce con un comando que está en el repositorio. La latencia de habla a subtítulo es de 693 ms en la mediana sobre audio real de Nerdearla. El costo es de USD 0.65 por sala hora con un idioma extra. Cien salas y cuatrocientos espectadores corren en el 18.6 por ciento de un núcleo. La precisión de palabra es de 92.7 por ciento en inglés y 95.4 en castellano. Y hay 143 tests, todos corriendo sin credenciales.
La latencia sale de seis minutos de una charla real, con público, risas y un orador con acento, no de audio de laboratorio.
Lo que más me importa es que cualquiera puede clonar el repositorio y correr los 143 tests sin una sola credencial, porque hay un backend falso que ejercita el sistema entero sin red.
What we learned
Aparecieron varias cosas probando que no están en la documentación de Google. El modo inteligente de transcripción es incompatible con los timestamps por palabra, y el servidor cierra el socket sin explicar por qué. El marcador de fin de habla llega después del texto que le corresponde, así que medir contra el más reciente da la duración de la oración y no la latencia, un bug que reportaba catorce segundos donde la verdad eran medio segundo. Ajustar el detector de voz no sirve para que un orador sin pausas produzca frases cerradas.
El modelo de transcripción en vivo no existe en Vertex AI, en ninguna región, y la traducción sí está en los dos, así que terminé usando un proveedor distinto para cada rol. El modelo de traducción más grande tarda el doble que el chico y devolvió la traducción idéntica, así que subir de modelo empeora el resultado cuando la latencia es el producto.
Las sesiones concurrentes están limitadas por proyecto y pasarse no encola: cierra sesiones en las salas que estén hablando, no en la que pidió de más, con lo cual el síntoma es salas sin relación fallando juntas.
La lección de método costó más que todas las anteriores. Los tests unitarios prueban que un componente es correcto, no que alguien lo llame bien. Dos bugs de este proyecto fueron exactamente eso.
What's next for Calandria
Traducir también las hipótesis parciales, con un umbral de estabilidad para no gastar una llamada por cada revisión. Que la reconexión recupere el contexto perdido, porque hoy la primera frase después de una caída pierde continuidad. Diarización, para saber quién habla en un panel con varios oradores. Alineado palabra por palabra en los subtítulos exportados, que hoy son por oración. Y un detector de deriva que avise cuando una sala se está atrasando, en vez de esperar a que alguien lo note desde la butaca.
Built With
- asyncio
- audioworklet
- css
- docker
- fastapi
- ffmpeg
- gemini
- gemini-live-api
- google-ai-studio
- html
- javascript
- pydantic
- pytest
- python
- redis
- srt
- uvicorn
- vertex-ai
- web-audio-api
- websockets

Log in or sign up for Devpost to join the conversation.