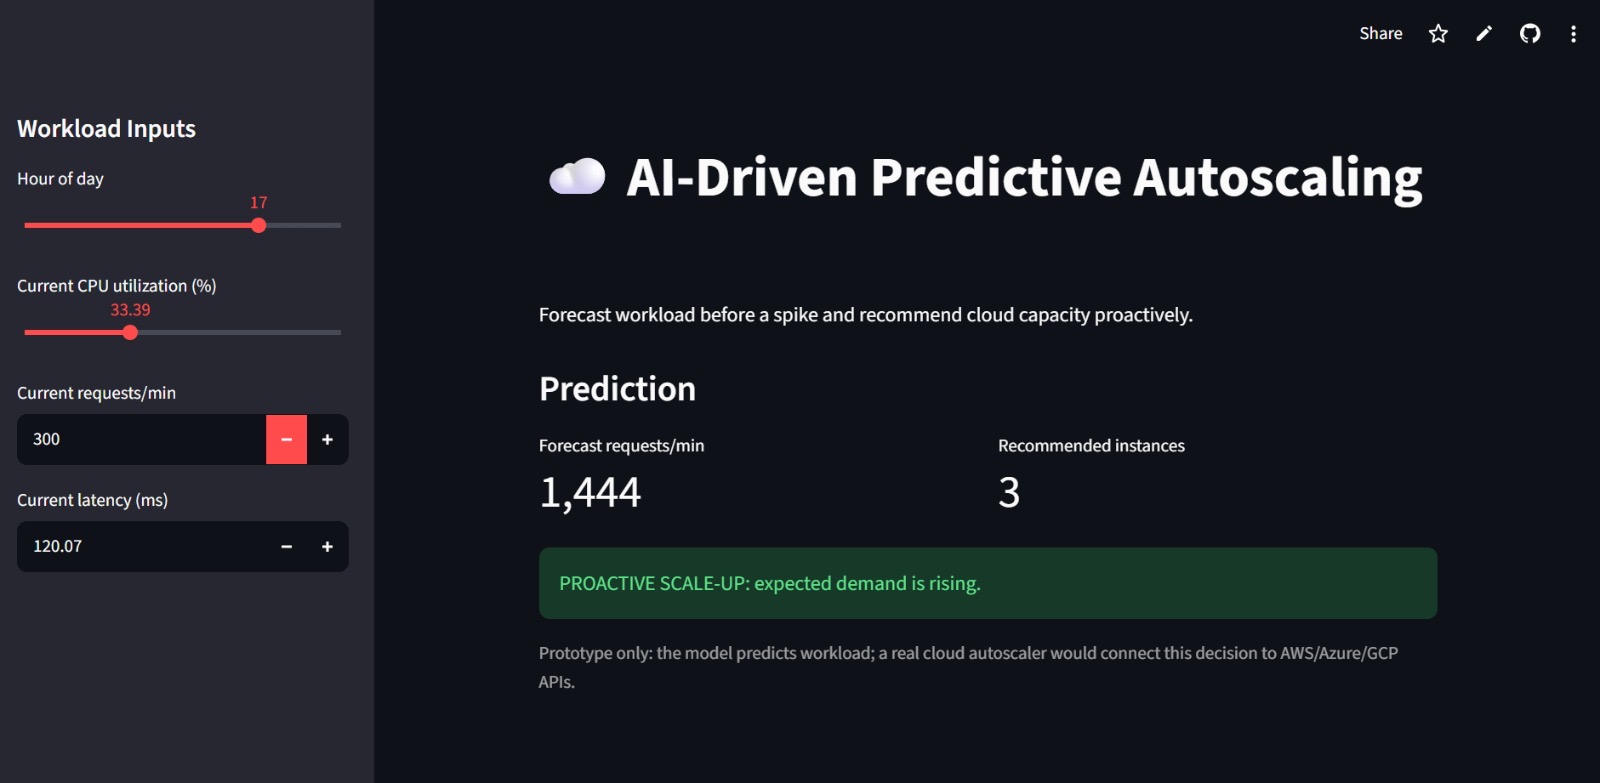
Inspiration Traditional cloud infrastructure management relies heavily on reactive autoscaling—waiting for CPU or traffic thresholds to spike before taking action. This lag causes performance drops, SLA breaches during sudden traffic surges, and costly over-provisioning during low-demand periods. Inspired by modern AI advancements, we wanted to build a system that shifts cloud operations from "responding to demand" to "anticipating demand" through predictive intelligence. What it does Our system is an AI-driven intelligent cloud resource management platform that transforms telemetry monitoring into proactive cloud provisioning. Key features include: Predictive Autoscaling: Pre-allocates resources before demand surges hit. Intelligent Workload Scheduling & Load Balancing: Distributes workloads dynamically across nodes to prevent congestion. Energy & Cost Optimization: Consolidates idle instances to reduce cloud spending and carbon footprint. Continuous Feedback Loop: Continuously measures telemetry to refine forecasting accuracy and adapt to changing conditions. How we built it We designed a four-stage predictive pipeline:
- Data Collection: Ingests real-time and historical telemetry (CPU, latency, traffic, memory).
- AI Analysis & Forecasting: Uses time-series ML models to forecast resource demand patterns.
- Decision Engine: Translates forecasts into proactive scaling policies and scheduling actions.
- Cloud Execution: Provisions and balances instances across targeted cloud infrastructure. Challenges we faced Model Drift: Adapting forecasting algorithms to maintain precision as workload behaviors shift over time. Handling Sudden Anomalies: Balancing proactive AI scaling with rules to mitigate unexpected prediction errors. Data Quality: Cleaning and processing noisy telemetry metrics to ensure high prediction accuracy. What we learned Predictive AI models outperform traditional static threshold rules (\text{Utilization} > 70\%) by anticipating demands before SLA violations occur. Continuous feedback loops are critical for maintaining continuous optimization and autonomous adaptability in cloud environments. What's next for the project Implementing Deep Reinforcement Learning (DRL) for dynamic, multi-objective scheduling. Expanding fault prediction capabilities to detect hardware/system failures before they impact service uptime. Moving closer toward fully autonomous, self-optimizing cloud infrastructure.


Log in or sign up for Devpost to join the conversation.