Historia del Proyecto: Aqua-Priority Qro
1. La Inspiración: Un Problema Colectivo en Querétaro
Como equipo de ingeniería viviendo y estudiando en Querétaro, no podíamos ignorar la crisis hídrica que nos rodea. La inspiración para este proyecto nació de una realidad estadística alarmante: en nuestra zona metropolitana, entre el 40% y el 50% del agua potable se pierde en fugas e infraestructura obsoleta antes de llegar a los hogares. Esto equivale a un desperdicio de aproximadamente 2,329 millones de litros anuales.
Lo que realmente nos movilizó fue el impacto social. Investigamos que cerca de 50,000 personas en la capital carecen de acceso regular al agua, mientras que el 9% de los hogares conectados sufren tandeos constantes. Además, la problemática de los "recibos locos" nos hizo entender que la solución no solo debía ser técnica, sino también justa para el ciudadano. Queríamos crear una herramienta que permitiera a la CEA (Comisión Estatal de Aguas) pasar de una reacción lenta a una intervención inteligente y priorizada.
2. Desarrollo: Una Carrera Contra el Reloj (24 Horas)
Desarrollar Aqua-Priority Qro fue un desafío de ingeniería y sincronización. Dividimos el trabajo en roles especializados para cubrir todos los frentes en un sprint de 24 horas:
Fase 1: Cimentación (Horas 0–6)
Mientras el equipo de DB/DevOps levantaba la infraestructura con Docker y MongoDB, el área de PM/QA definía los contratos de API en JSON para que el Frontend y el Backend pudieran trabajar en paralelo. Simultáneamente, el equipo de IA/NLP comenzó a entrenar el clasificador de texto, estableciendo un sistema de doble modo: un modelo avanzado basado en GPT-4o-mini y un fallback de keywords para emergencias.
Fase 2: El Núcleo de Inteligencia (Horas 6–13)
El equipo de Backend integró la plataforma mediante un Bot de Telegram. El corazón del sistema es nuestro algoritmo de Scoring Inteligente, que cruza el tipo de reporte con el contexto demográfico (ej. prioridad máxima si la fuga es cerca de un hospital). Para la validación técnica, integramos la capacidad de procesar modelos físicos mediante la fórmula de flujo volumétrico:
$$Q = C_d \cdot A \cdot \sqrt{2 \cdot g \cdot h}$$
Donde:
- $Q$ es el flujo volumétrico.
- $C_d$ es el coeficiente de descarga.
- $A$ es el área del orificio de la fuga.
- $g$ es la aceleración de la gravedad ($9.81 m/s^2$).
- $h$ es la presión de carga.
Fase 3: Visualización e Integración (Horas 13–24)
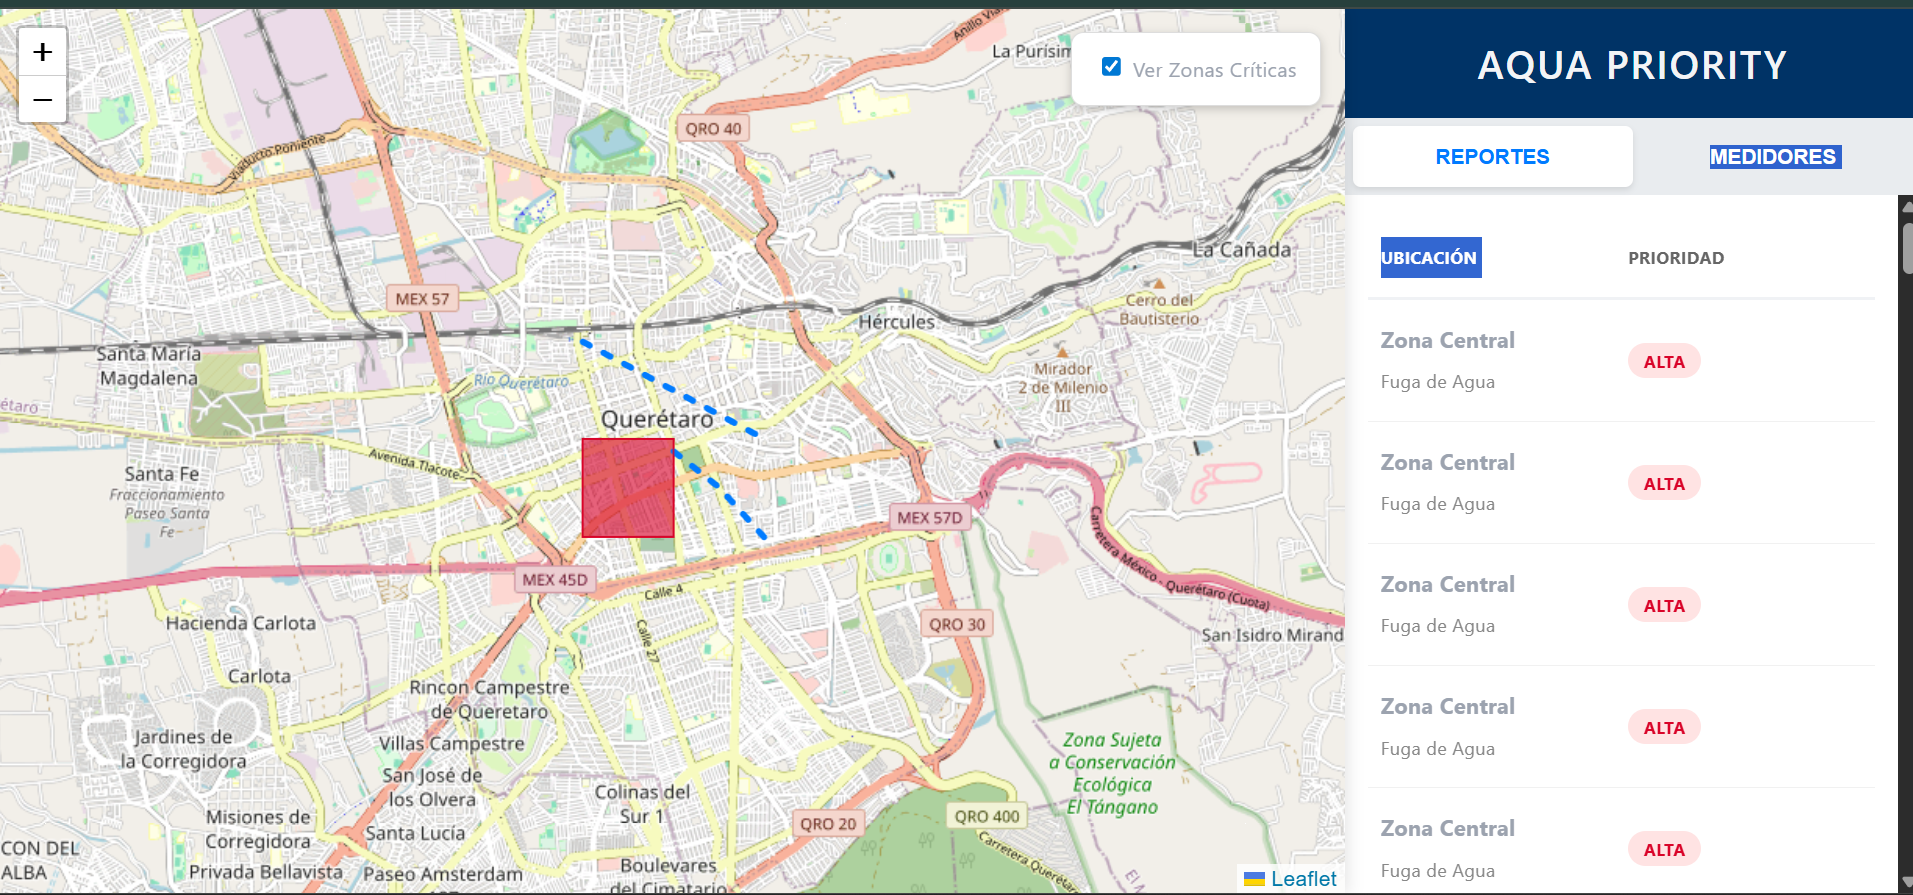
El equipo de Frontend desarrolló un Dashboard interactivo en React utilizando Leaflet. Implementamos capas de GeoJSON para visualizar las zonas más vulnerables y mapas de calor (heatmaps) que se actualizan en tiempo real cada 10 segundos.
3. Desafíos Enfrentados
Trabajar bajo una presión de tiempo tan extrema trajo retos significativos:
- Sincronización de Dependencias: El Frontend dependía de los endpoints del Backend. Aprendimos que el uso de datos mock es vital para no detener el desarrollo.
- Gestión de Tiempos en Webhooks: Twilio requiere respuesta en menos de 15 segundos. Optimizamos el procesamiento de IA para que fuera asíncrono, respondiendo al usuario de inmediato mientras el sistema calculaba la prioridad en segundo plano.
- Integración de Datos Reales: Conseguir coordenadas exactas de zonas críticas en Querétaro para que la demo fuera verosímil para un operador real.
4. Aprendizajes del Equipo
Este proyecto transformó nuestra visión sobre la Ciencia y Analítica de Datos. Aprendimos que:
- La tecnología debe ser humana: Un sistema por WhatsApp es mucho más inclusivo que una app compleja.
- La eficiencia es logística: El valor real está en el algoritmo de rutas que ordena la atención para reducir el tiempo de respuesta a menos de 18 horas.
- Sinergia Multidisciplinaria: La división de tareas fue lo que permitió que un proyecto de esta magnitud fuera funcional en solo un día.

Log in or sign up for Devpost to join the conversation.