-
-
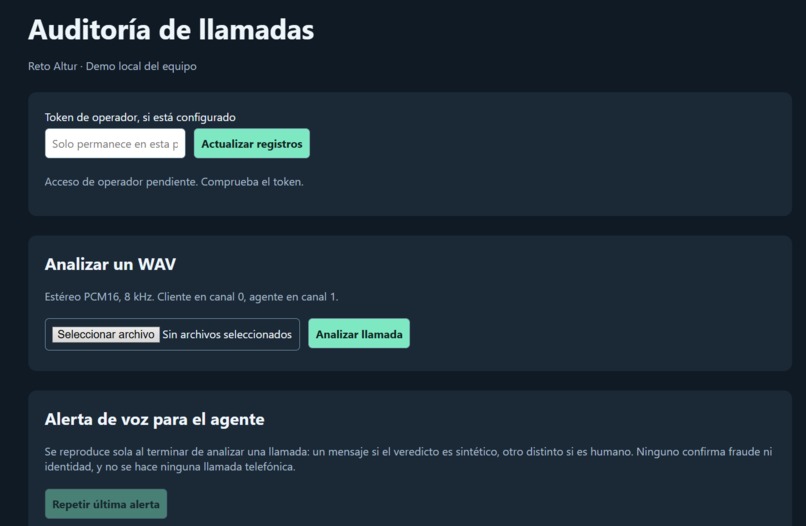
imagen interfaz
Inspiration
Nos motivó e inspiró la urgencia de proteger a los usuarios y trabajadores del sector financiero frente a la creciente ola de fraudes por ingeniería social e imitación de voz. En un entorno donde los ataques telefónicos con IA son cada vez más sofisticados, quisimos crear una herramienta capaz de actuar como un escudo invisible en tiempo real, garantizando la autenticidad de cada llamada sin interrumpir la experiencia de usuario.
What it does
Es un sistema de detección de deepfakes telefónicos en tiempo real expuesto a través de una API de alto rendimiento. Procesa el audio estéreo de la llamada (frecuencia de muestreo a 8 kHz) aislando el Canal 0 (cliente) y evalúa si la voz es humana o sintética. Retorna una respuesta alineada con el esquema oficial de la competencia con los campos is_synthetic y confidence, logrando un Balanced Accuracy de 0.945 y un ROC-AUC de 0.980 con latencias ultrabajas de 100-150 ms.
How we built it
Construimos un pipeline de análisis híbrido usando Python y FastAPI:
Procesamiento de Voz: Usamos soundfile y torch para validar el archivo WAV decodificado desde Base64 e aislar el canal del cliente.
Ingeniería de Características Conversacionales: A través del módulo ml/features.py, extraemos 87 características derivadas del comportamiento de la llamada (duración de turnos, solapamientos, silencios y latencias de respuesta).
Ensamble de Clasificación: Alimentamos un ensemble (Regresión Logística + Random Forest + Gradient Boosting) que procesa las métricas extraídas por el mismo VAD que opera en producción para evitar desajustes de distribución.
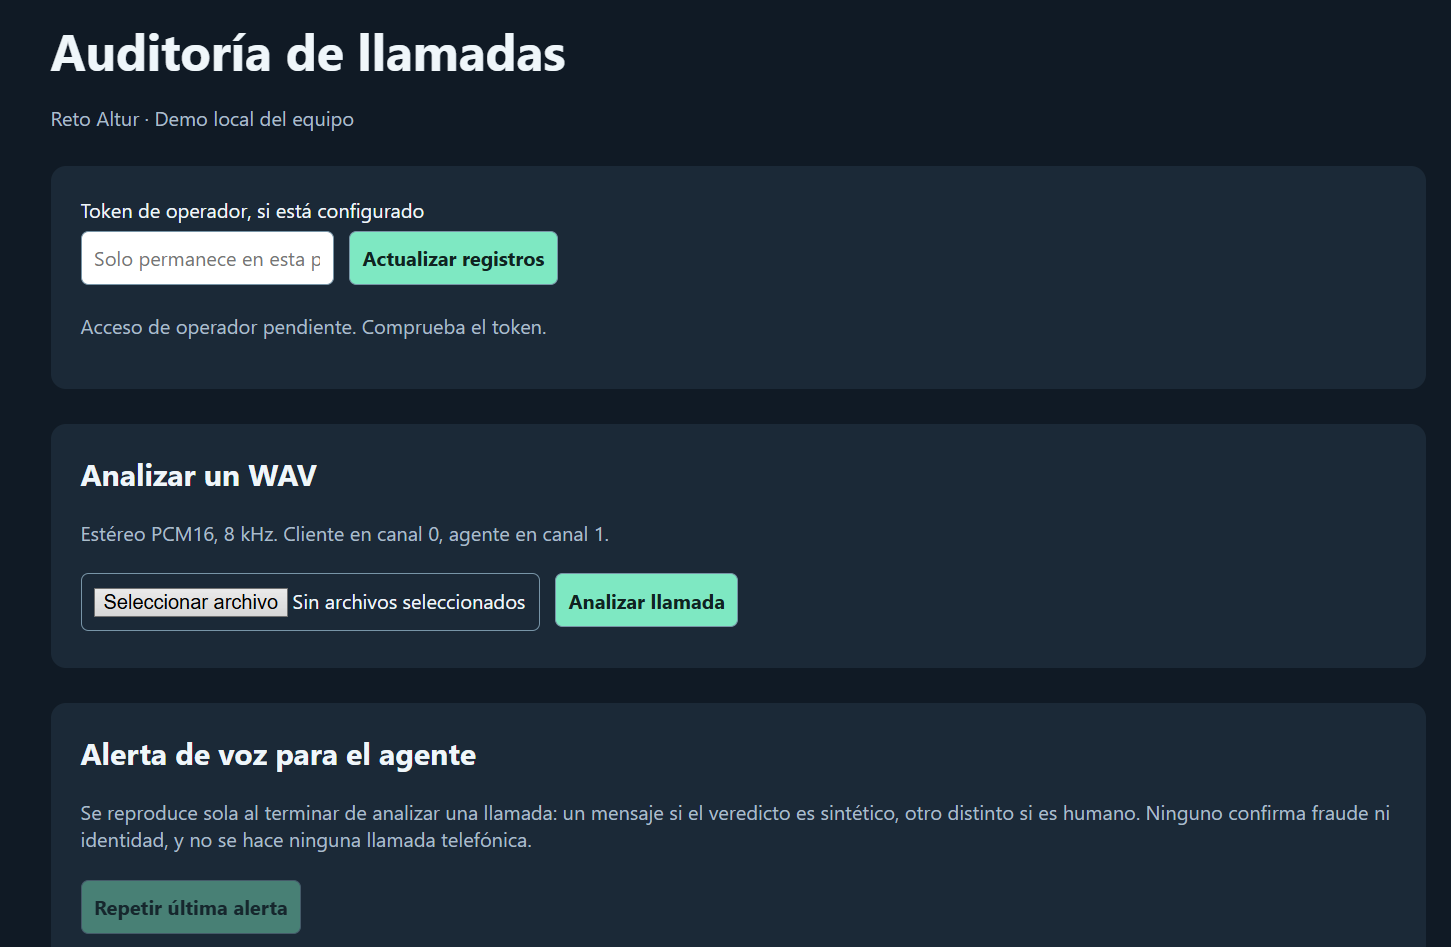
Capa Conversacional y Auditoría: Integramos trazabilidad asíncrona en SQLite con soporte para PostgreSQL (ops/) y un panel web interactivo (/demo).
Challenges we ran into
Desajuste de Distribución en VAD: Descubrimos que entrenar el modelo con turnos oficiales etiquetados pero inferir con un detector VAD en vivo degradaba el rendimiento; lo resolvimos unificando el procesador VAD tanto en entrenamiento como en inferencia.Ajuste del Contrato de Confianza: Detectamos que enviar la probabilidad cruda invirtía la métrica de AUC según el evaluador del juez, por lo que calibramos la respuesta de confidence para reflejar la certeza exacta del veredicto devuelto ($P(\text{sintético})$ si es sintético o $1 - P(\text{sintético})$ si es humano).Gestión de Latencia y Arranque en Frío: Optimizar el pipeline para mantener respuestas por debajo de los 200 ms y desplegar exitosamente en Render evitando fallos de tiempo de espera (cold start).
Accomplishments that we're proud of
Resultados Robustos en Validación: Lograr un rendimiento de 67/71 aciertos en el conjunto de validación sin errores de ejecución.
Velocidad de Inferencia Extrema: Mantener latencias medias de 100-150 ms (muy por debajo del límite de 30 segundos fijado por las reglas).
Despliegue a Producción: Dejar el sistema 100% operativo y verificado en la nube (onrender.com), superando las pruebas automáticas del script del juez (check_endpoint.py).
What we learned
La importancia del alineamiento entre el preprocesamiento de datos de entrenamiento y el entorno de inferencia en tiempo real.Métodos para calibrar probabilidades y métricas de evaluación ($Brier\ Score = 0.046$).Técnicas de extracción de características conversacionales y empaquetamiento de microservicios con FastAPI y Docker.
What's next for Altur Project
Manejo de Casos Límite en VAD: Optimizar la gestión de llamadas sin habla detectable en el canal 0 para evitar devolver errores HTTP 422.
Integración Activa de Gemini: Habilitar el módulo semántico (conversation/semantics.py) en entornos de producción con credenciales de API para detección de trampas contextuales e ingeniería social compleja.
Sostenibilidad del Despliegue: Migrar a una infraestructura con tiempo de respuesta instantáneo constante sin latencia de arranque en frío.
Built With
- elevenlabs
- geminis
- python
- torch

Log in or sign up for Devpost to join the conversation.