-
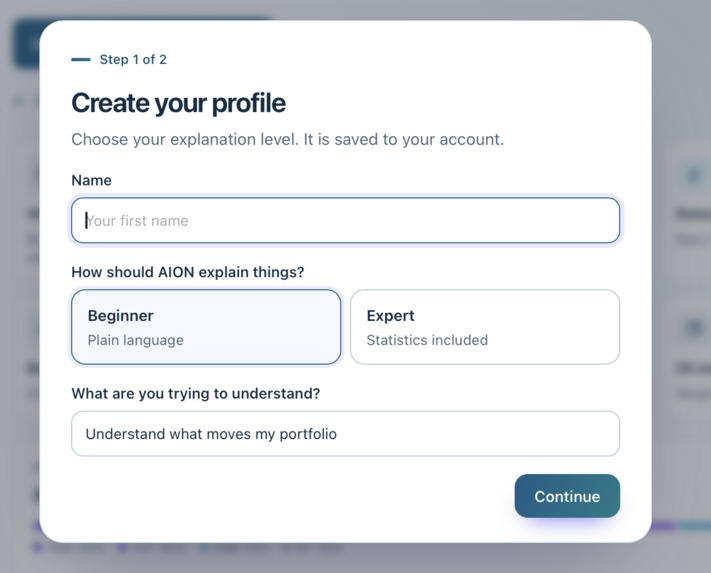
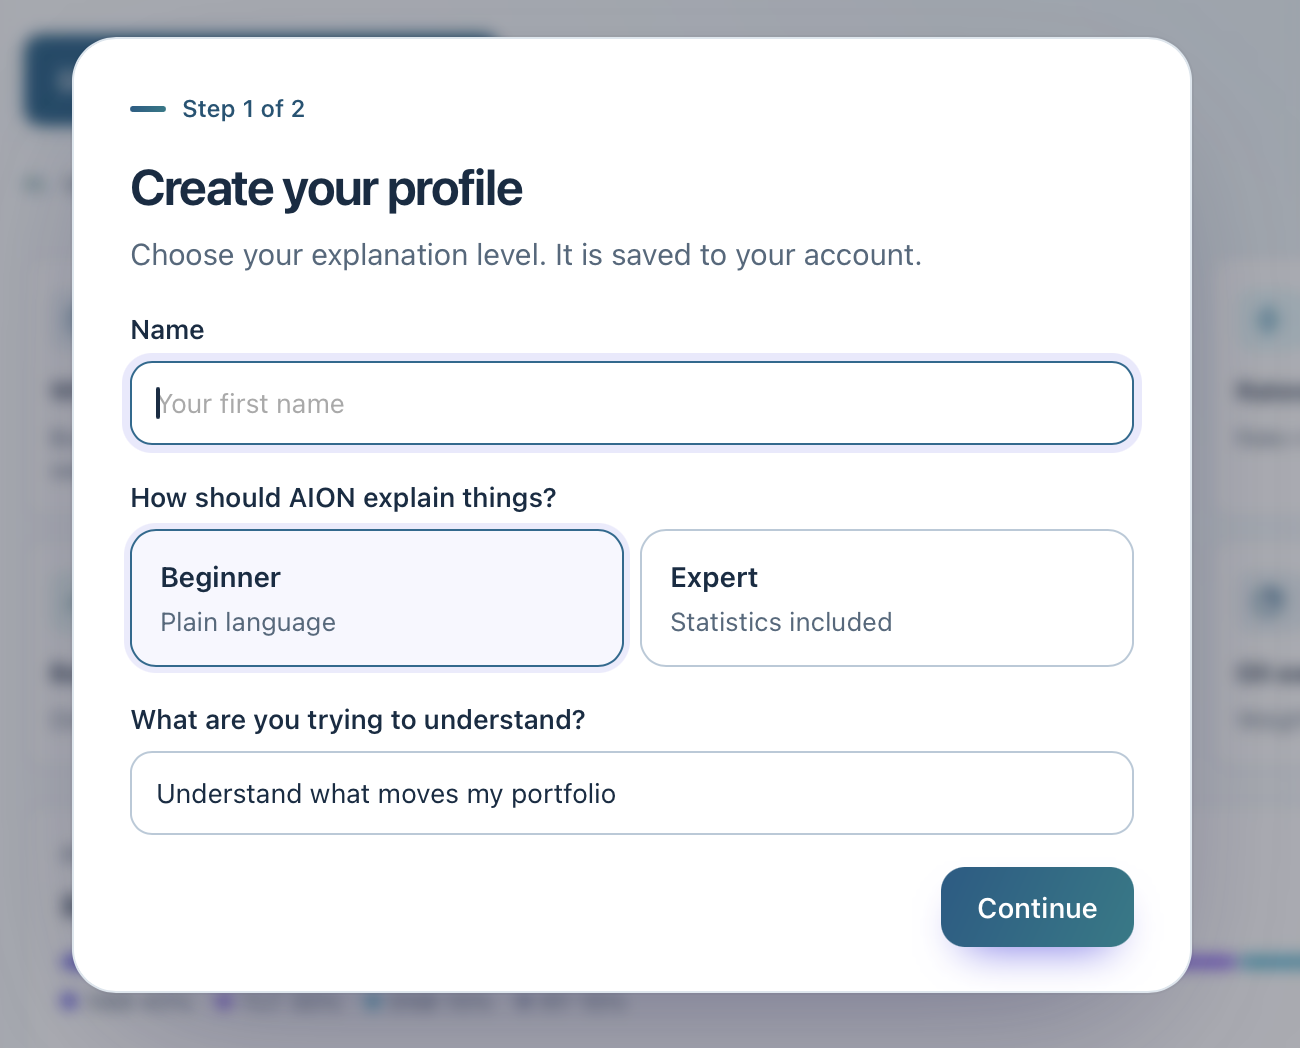
Onboarding partie 1. L'utilisateur choisit son niveau d'expertise (influence la complexité des réponses).
-
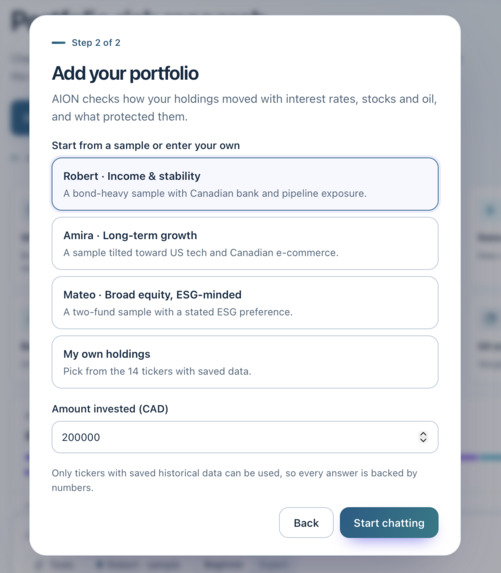
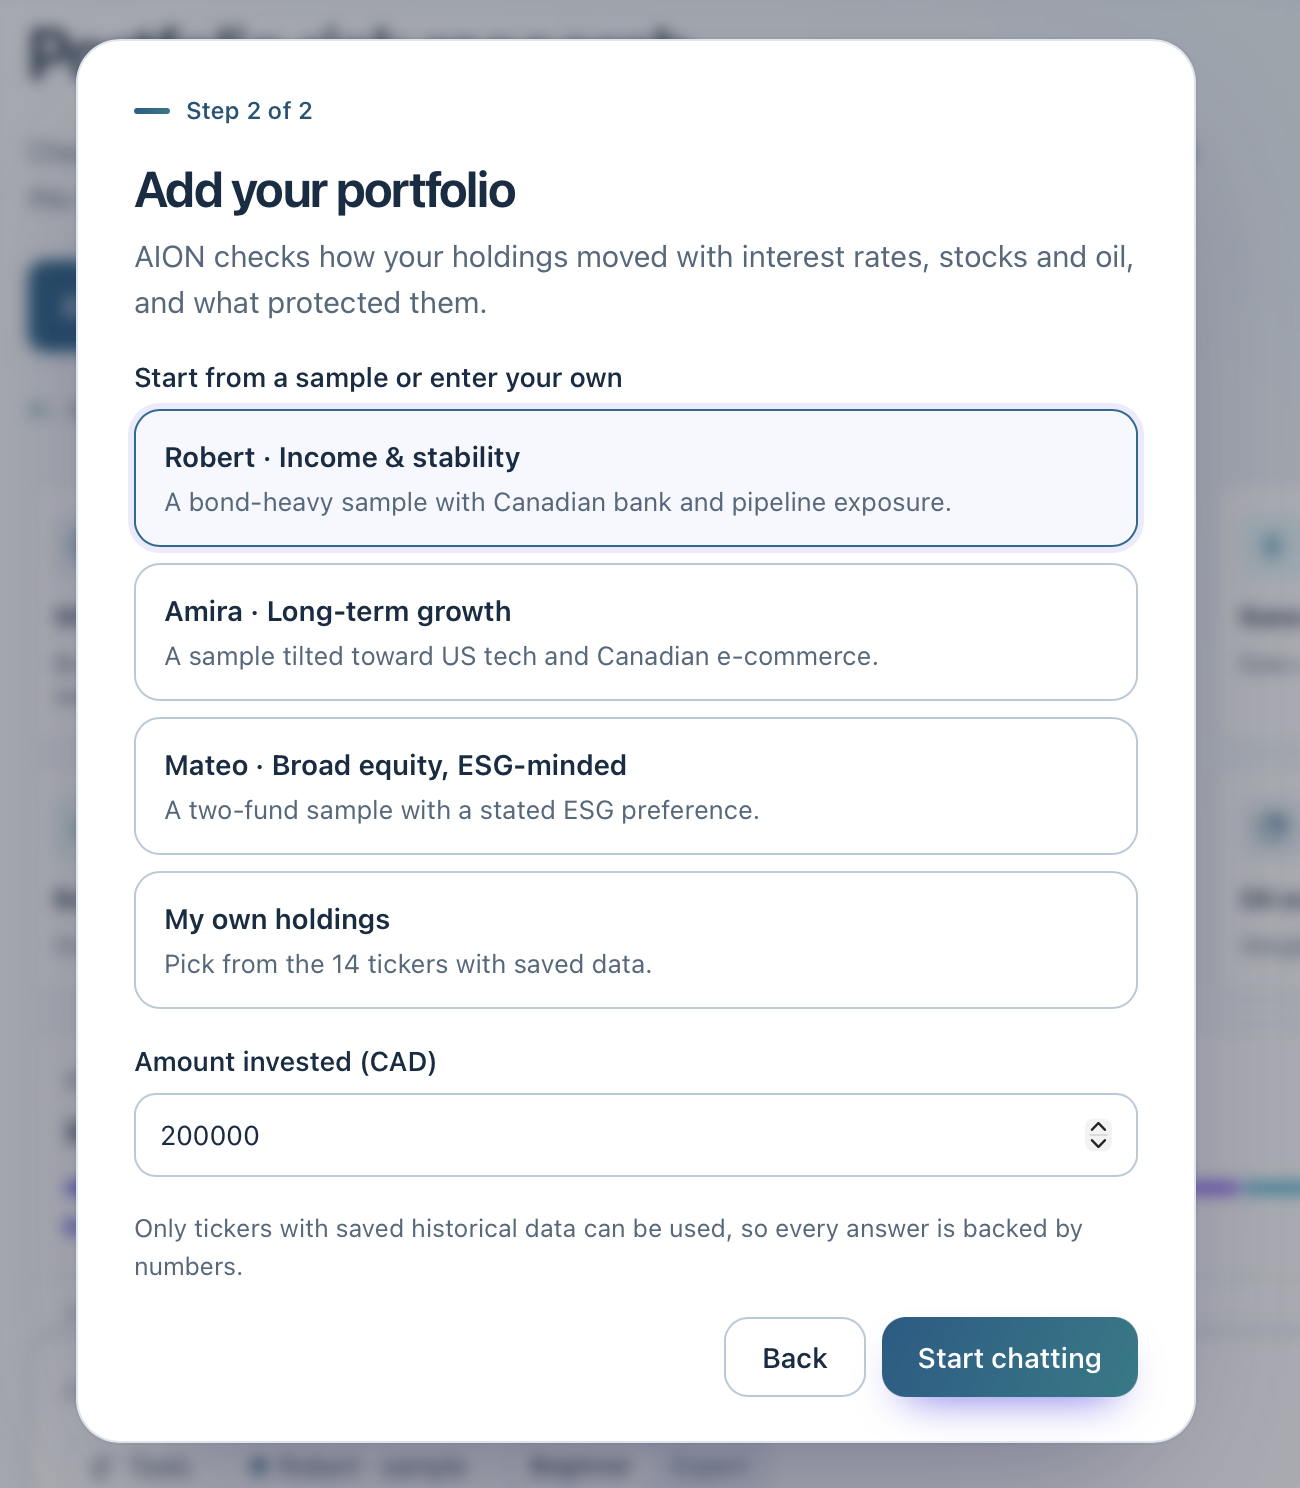
Onboarding partie 2. L'utilisateur décrit son portfolio et sa tolérence au risque, ou créé son portfolio lui-même.
-
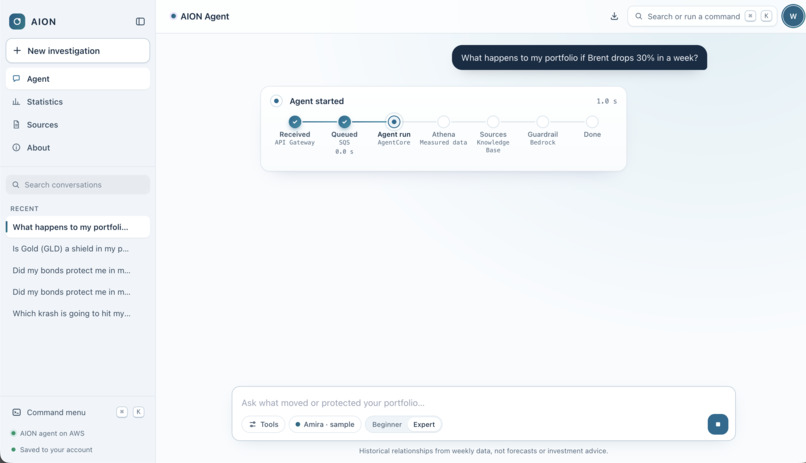
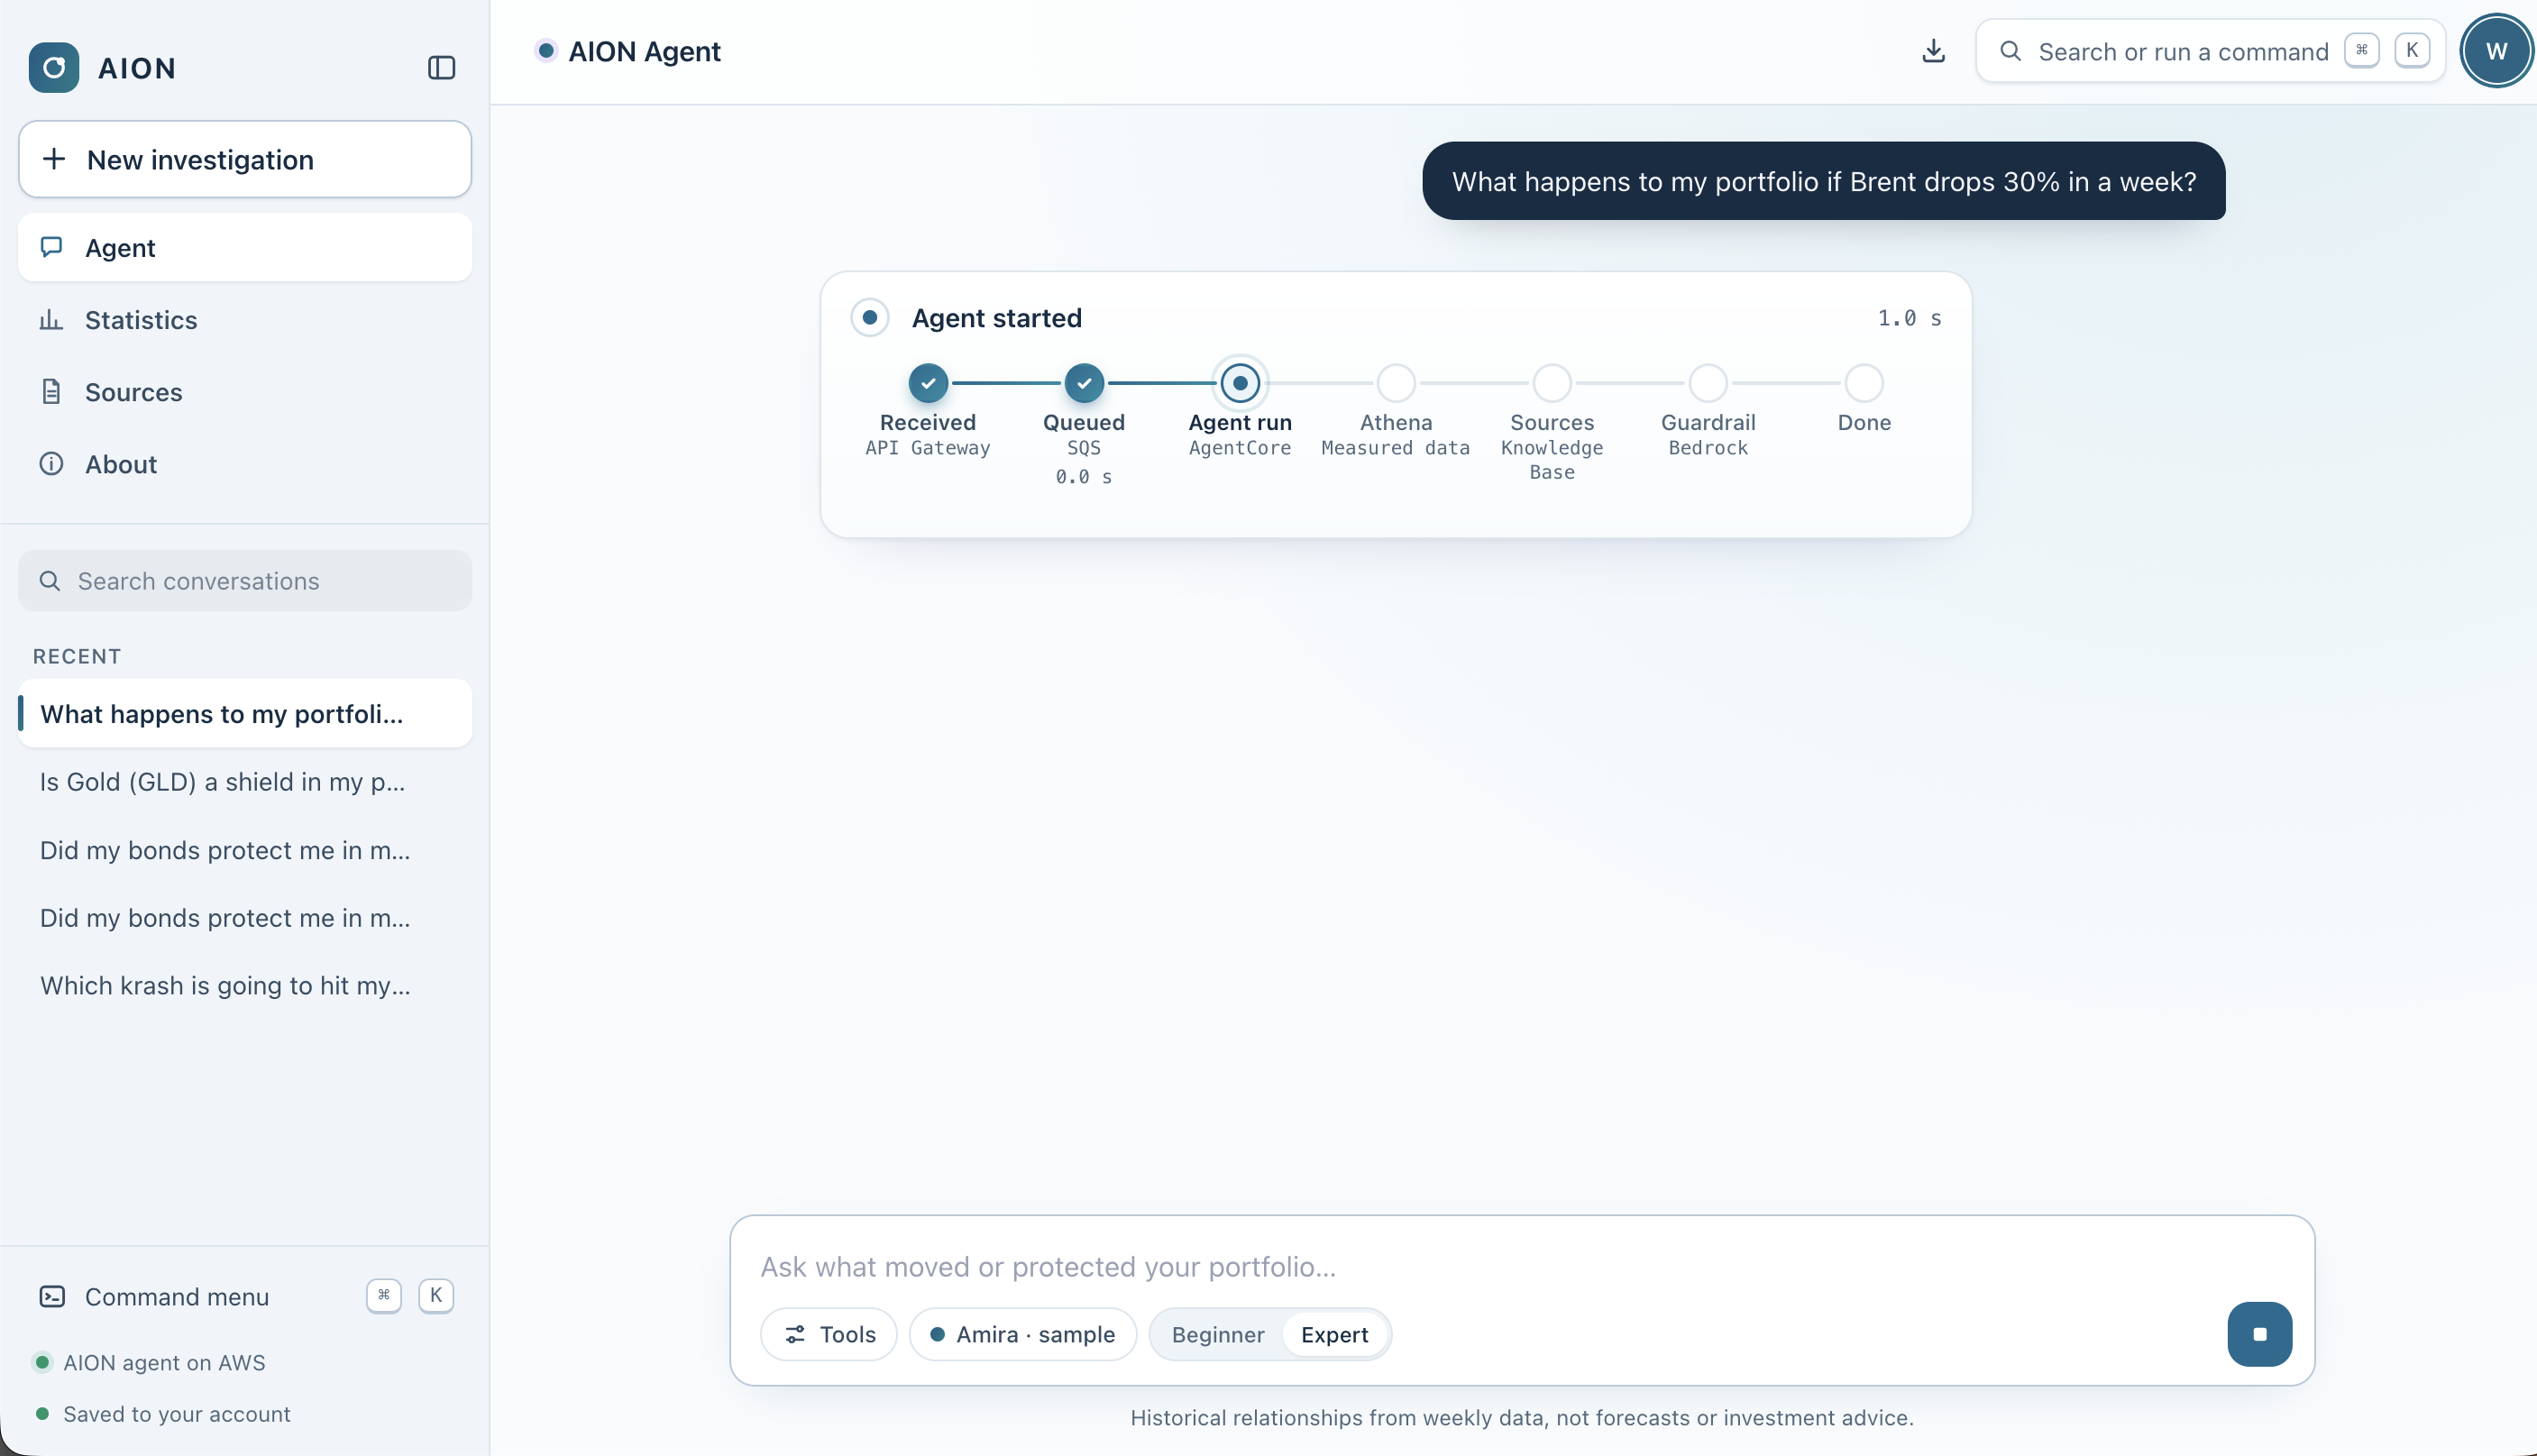
La barre de chargement suit l’état réel de chaque question à chaque seconde, de sorte que l’usager voit le pipeline AWS en marche.
-
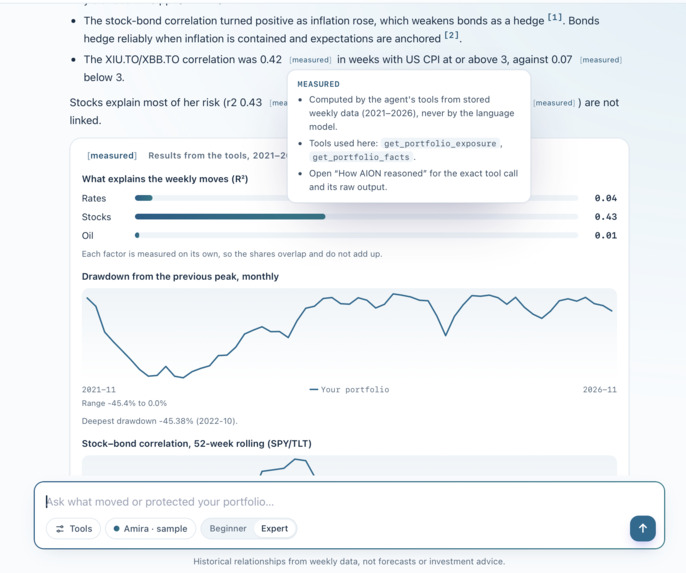
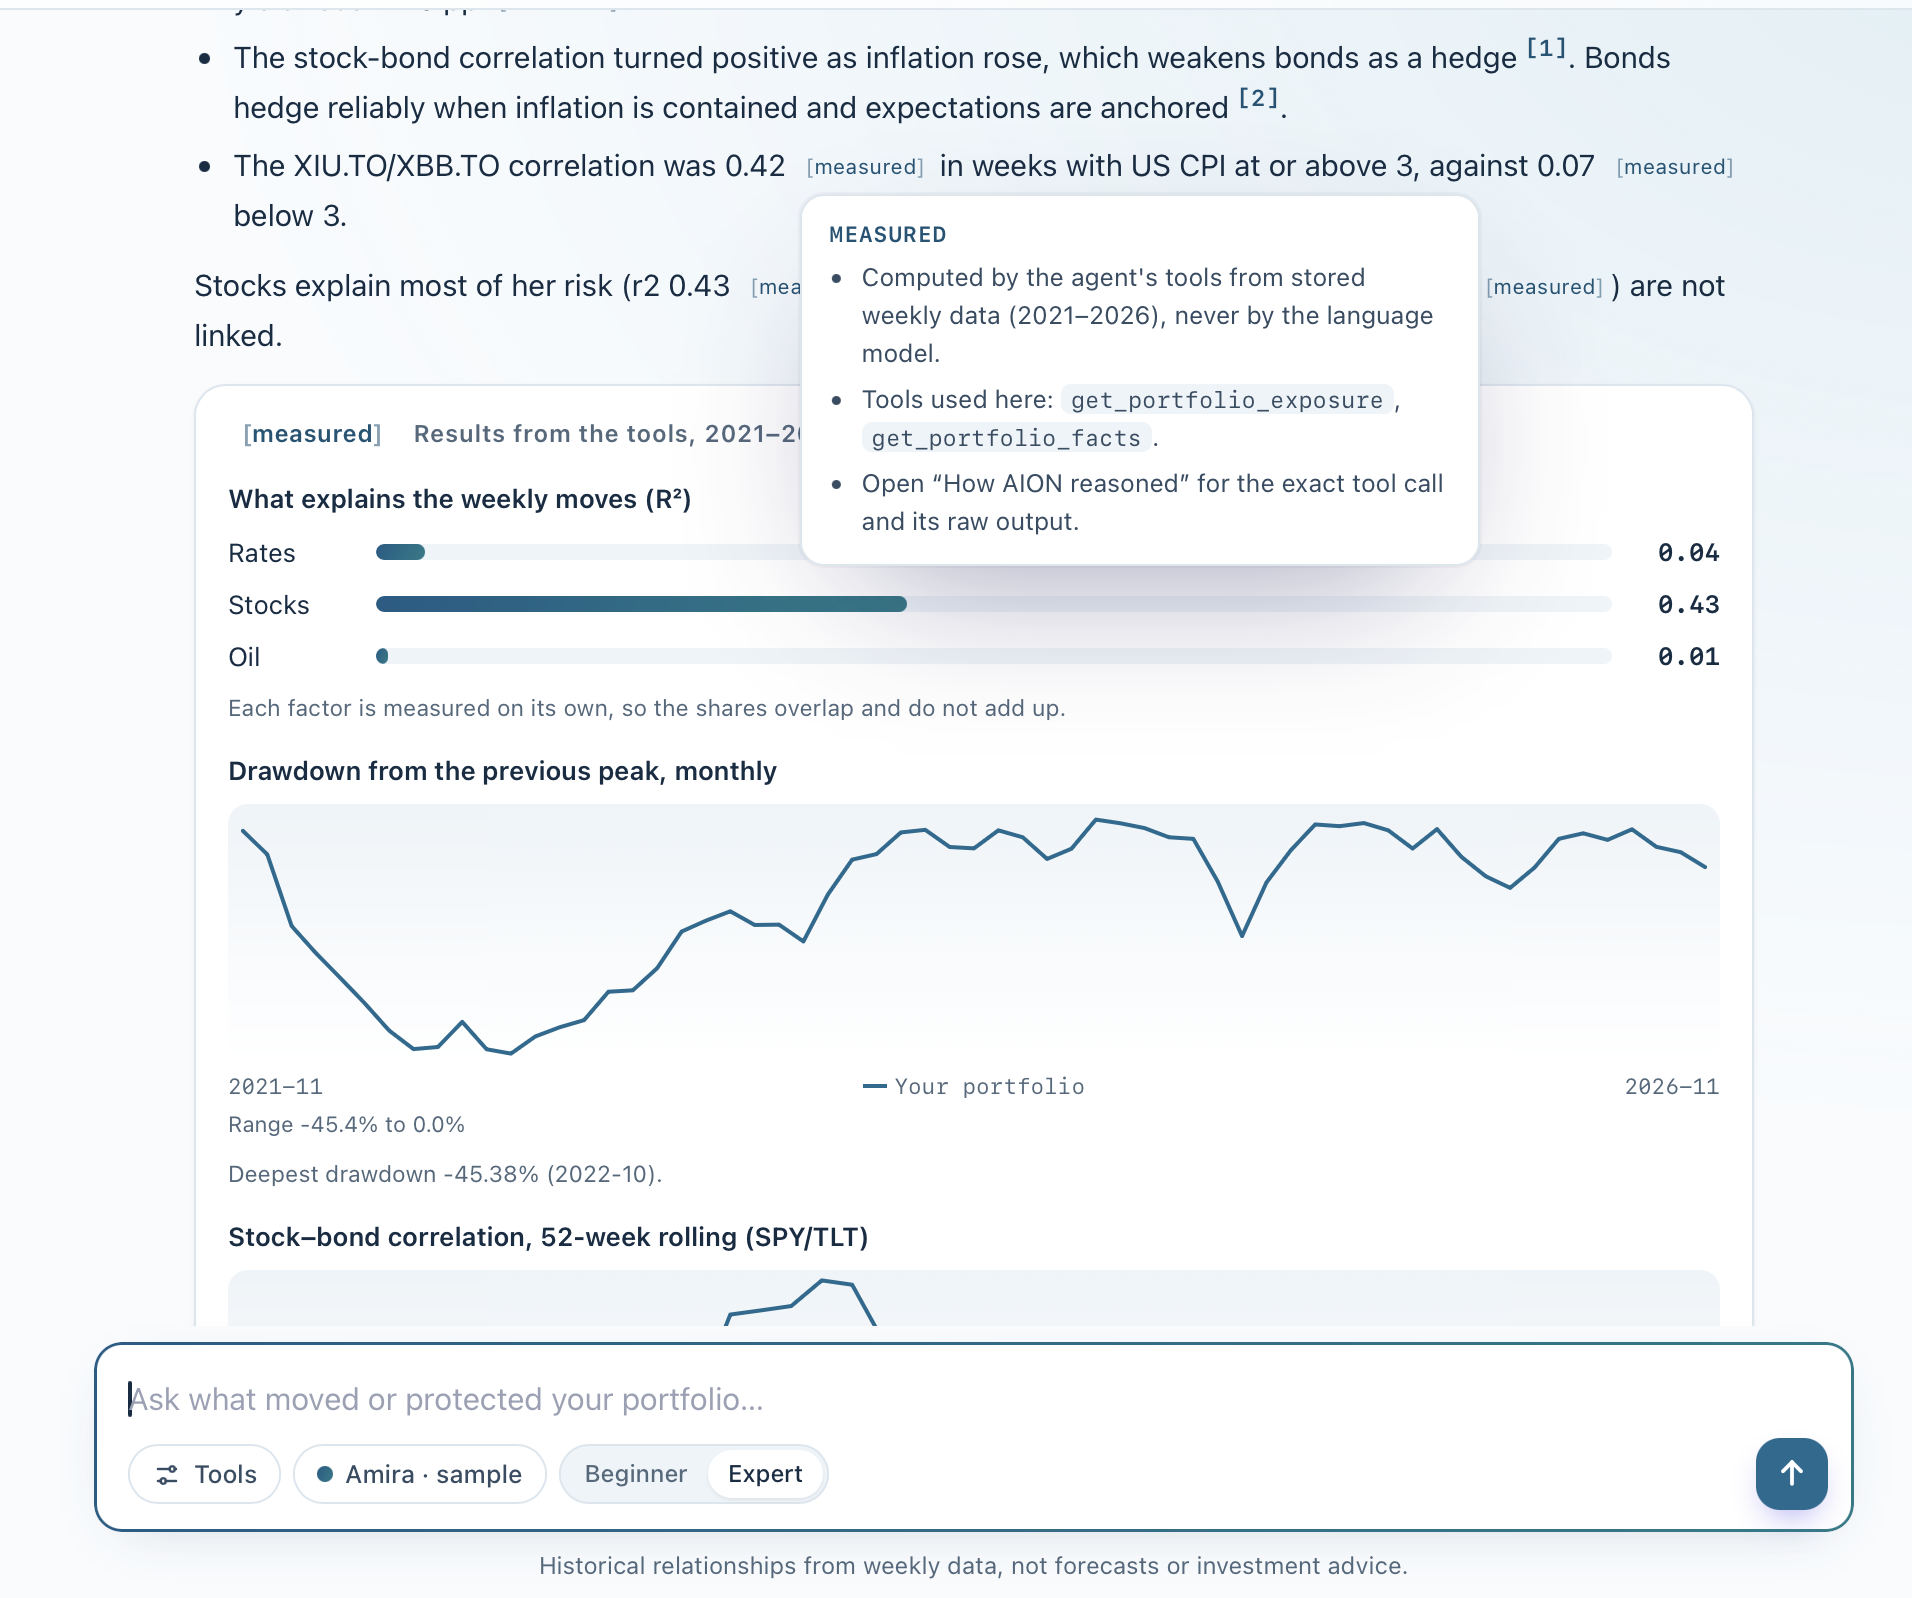
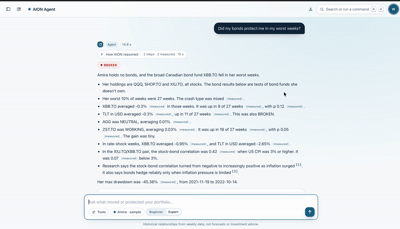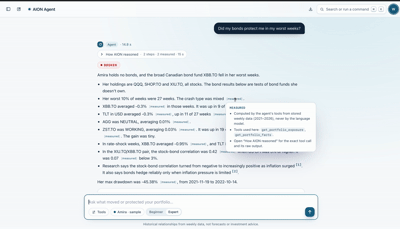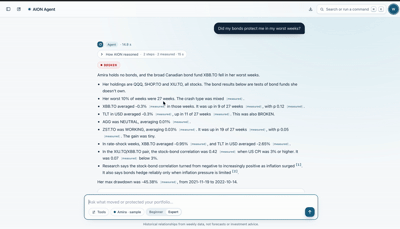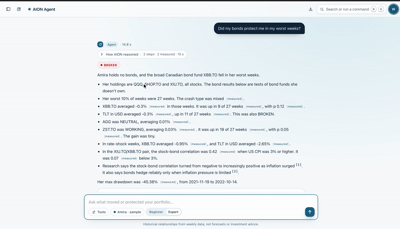
Visualisation(s) graphique(s) pour chaque réponse (utilisateurs experts).
-
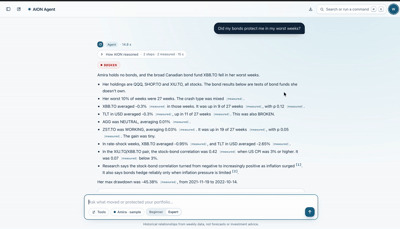 GIF
Toutes les informations sont sourcées et calculs mesurés.
-
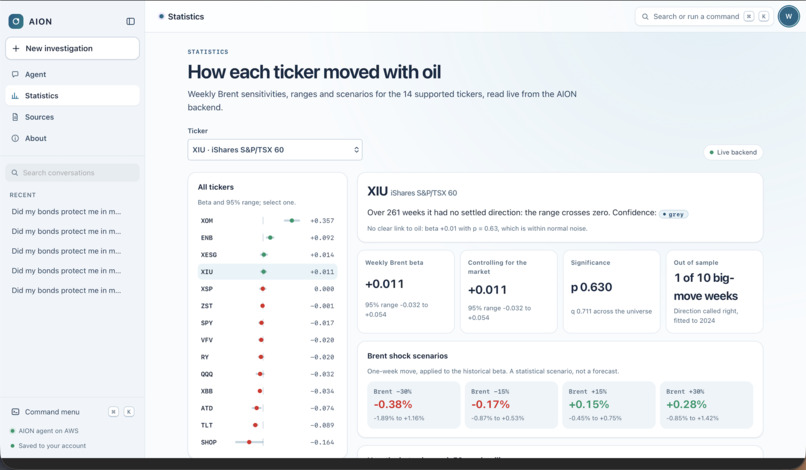
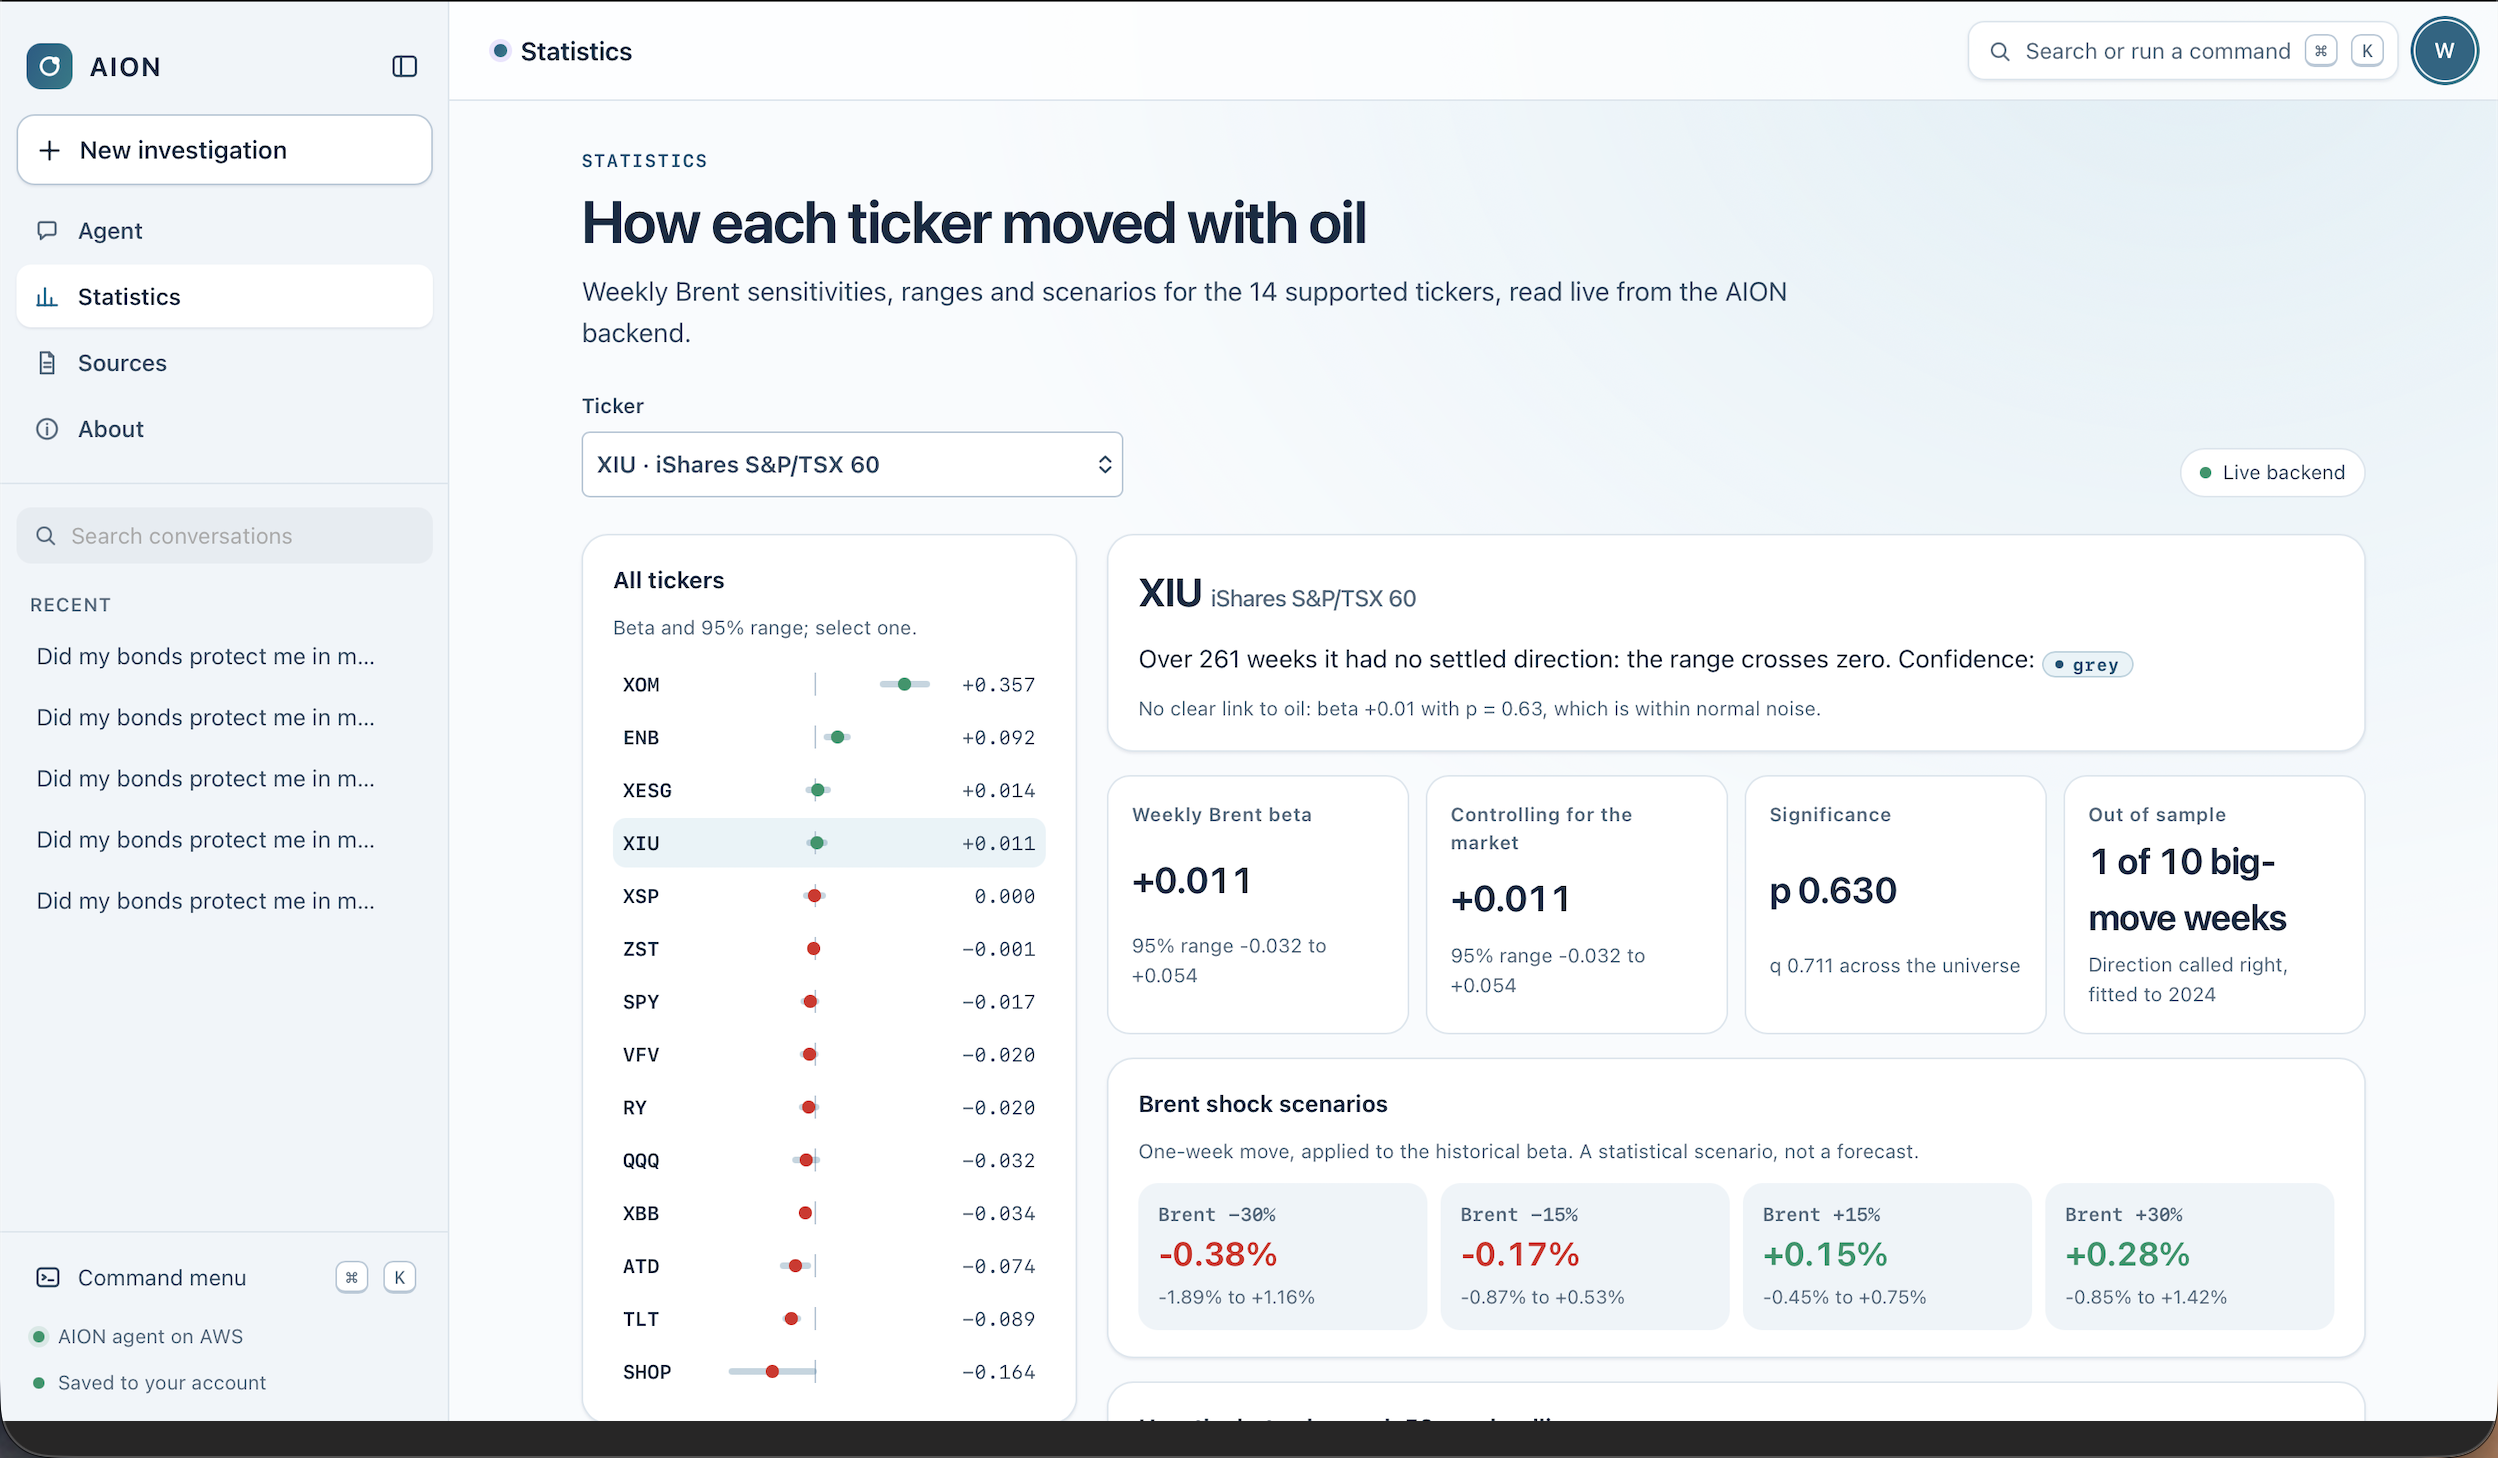
Un écran qui décrit comment chaque ticker a réagi aux variations d'une commodité (ici le pétrole mais on pourrait en ajouter bien plus).
-
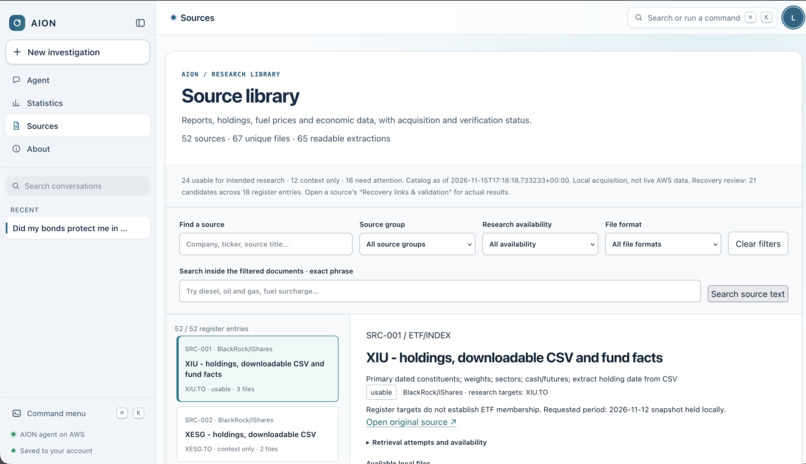
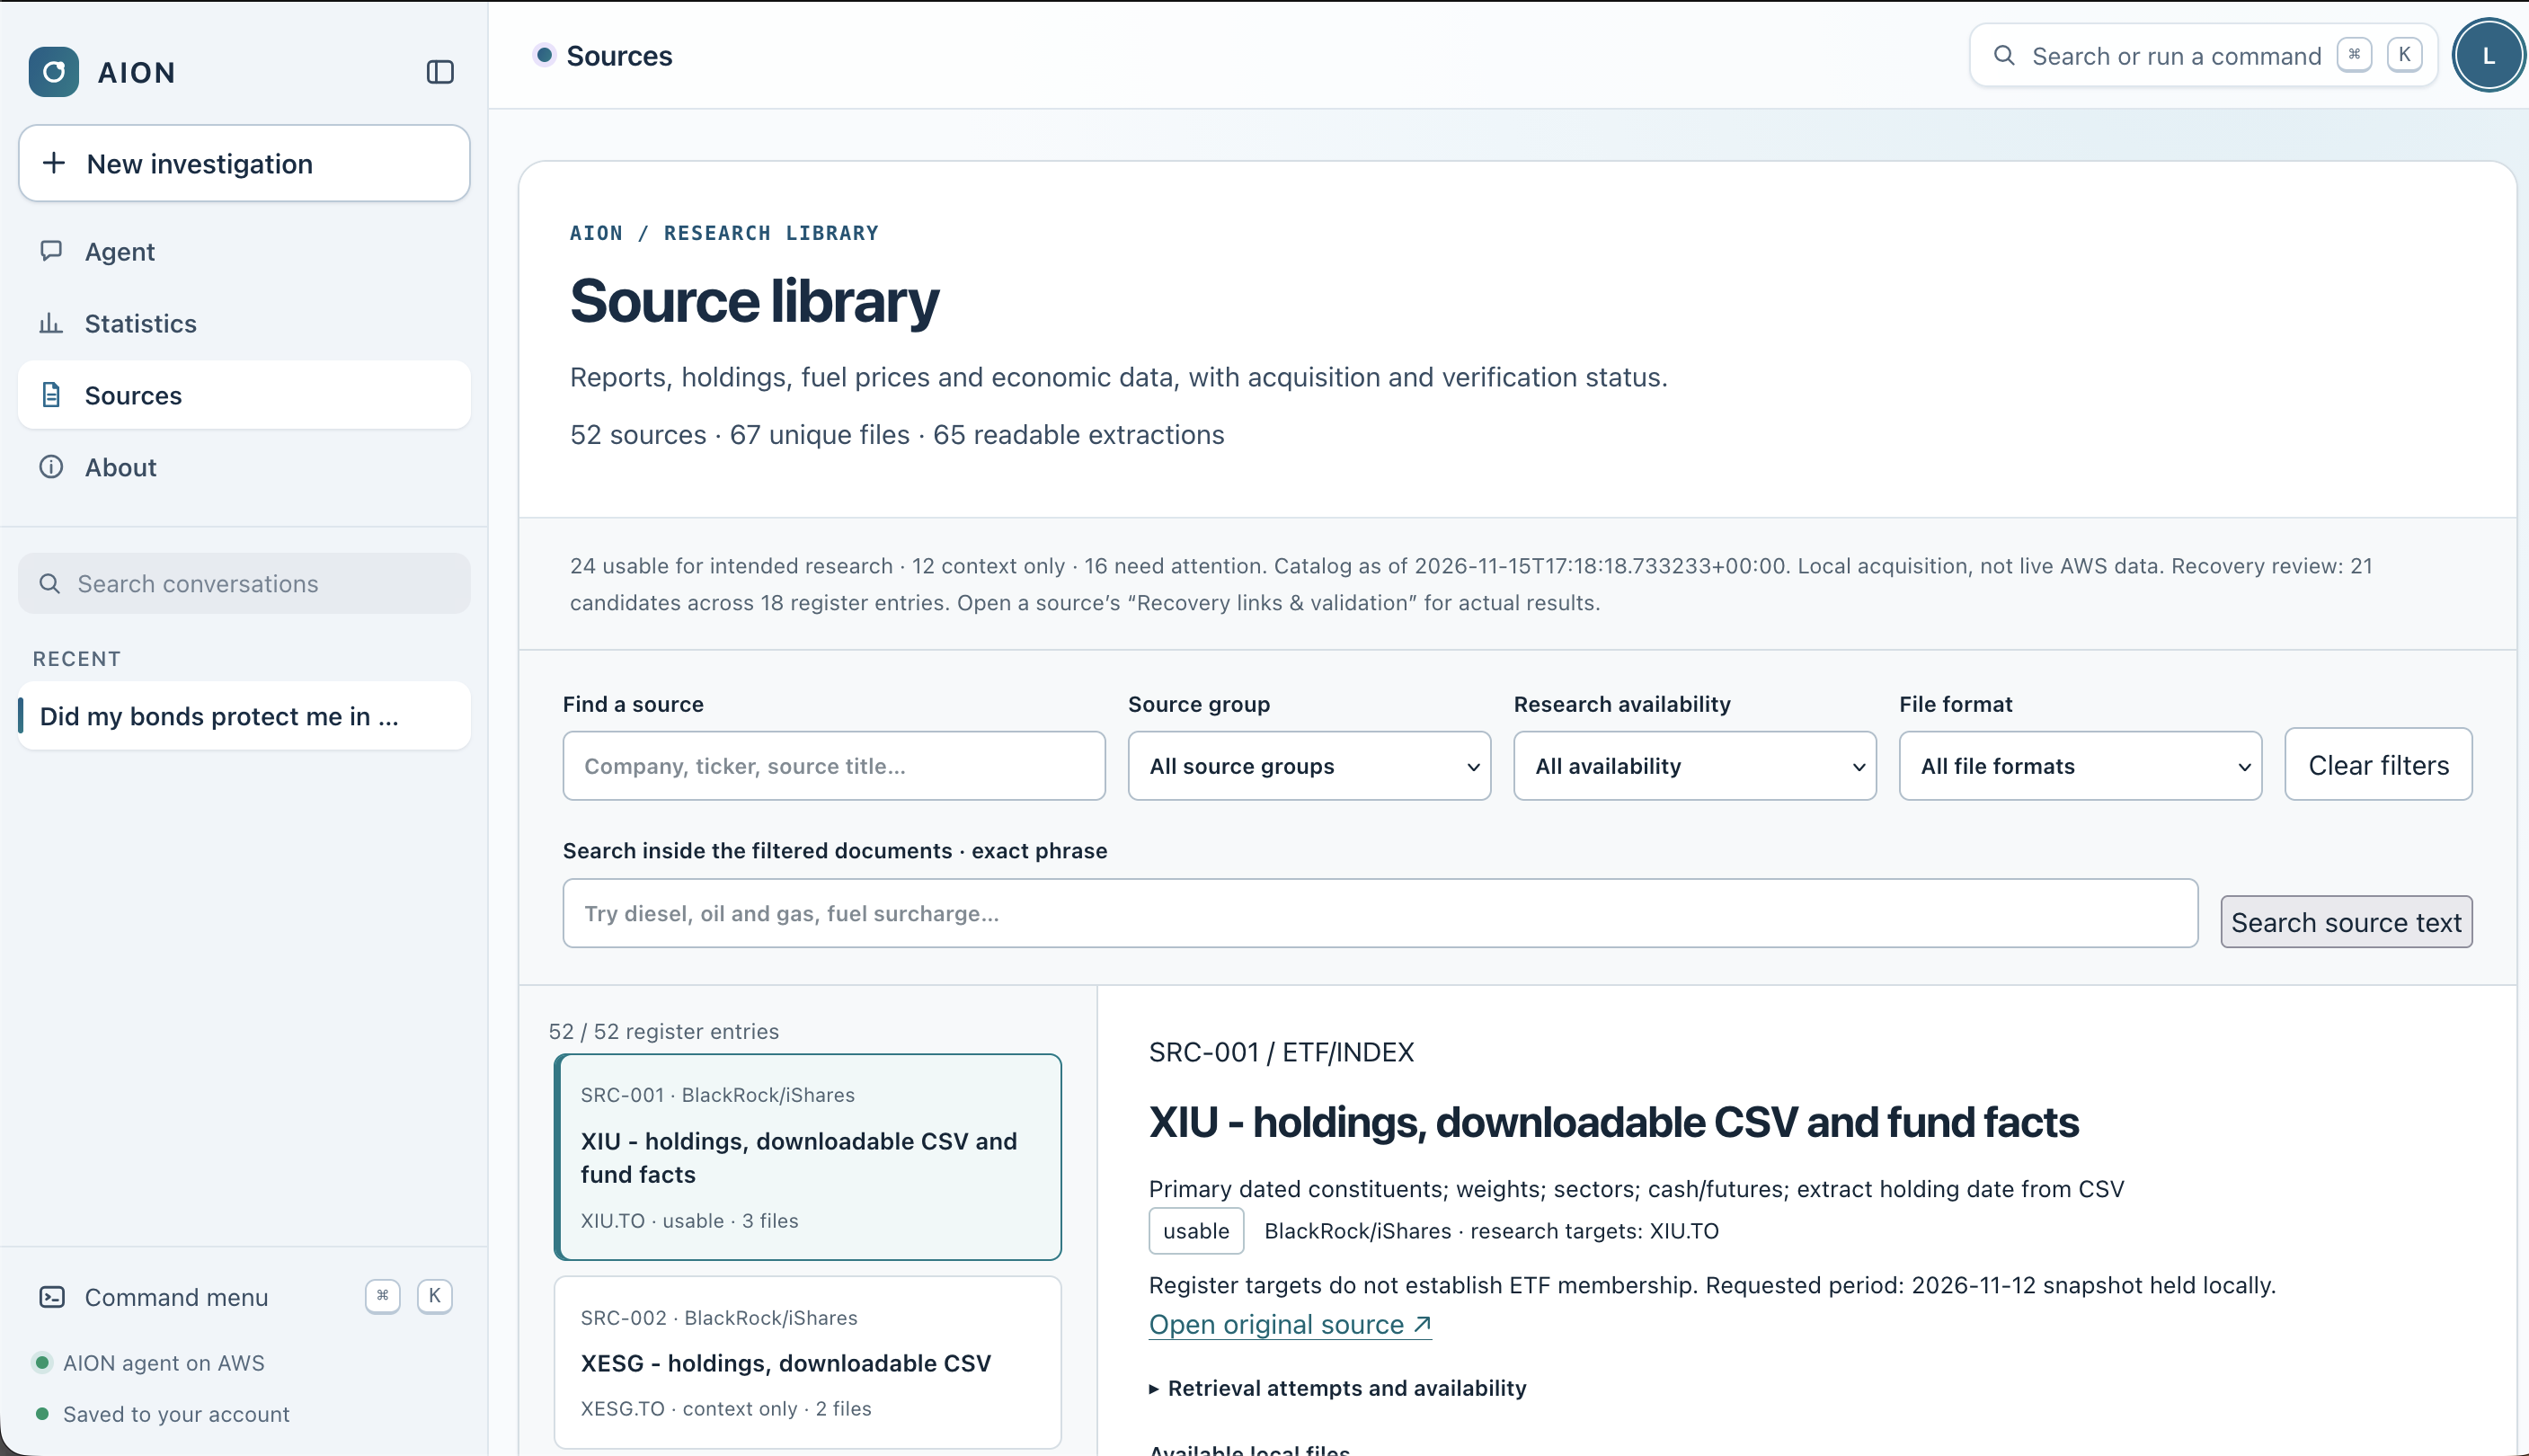
Une page exposant la totalité de la knowledge base, et des liens directs vers les documents.
AION — Comprendre les risques de son portefeuille
Aperçu du projet
AION (Autonomous Intelligence & Observation Network) est un agent de recherche financière déployé sur AWS. Il aide les investisseurs à examiner le comportement de leur portefeuille sur la période 2021–2026 et à comprendre son exposition aux taux d’intérêt, aux marchés actions, au pétrole et au dollar américain.
L’utilisateur sélectionne un portefeuille, puis pose une question : « Mes obligations ont-elles amorti mes pertes ? », « Quel facteur est le plus associé aux variations de mon portefeuille ? » ou « Que donne un scénario de hausse des taux ? »
L’agent choisit les outils adaptés, consulte les résultats statistiques et recherche les documents utiles à l’explication. L’interface présente la réponse, les résultats disponibles, les références et la trace des outils utilisés. Deux niveaux de lecture permettent de passer d’une explication accessible à une analyse plus détaillée.
Pile technologique
Technologies essentielles
- Python 3.13 pour les traitements et les services backend.
- Amazon Bedrock, Claude Sonnet 5.5 et Strands Agents pour le raisonnement de l’agent et l’utilisation des outils.
- Amazon Bedrock AgentCore Runtime pour héberger l’agent.
- Amazon Bedrock Knowledge Bases, avec S3 Vectors et Titan Embeddings, pour la recherche documentaire.
- Amazon Bedrock Guardrails pour encadrer les demandes de conseil personnalisé et de prévision.
- Amazon S3, AWS Glue et Amazon Athena pour stocker, cataloguer et interroger les données.
- Amazon SageMaker AI pour les notebooks de calcul statistique.
- AWS Lambda, Amazon API Gateway, Amazon SQS et Amazon DynamoDB pour traiter les demandes de manière asynchrone.
- AWS Amplify pour héberger l’interface web.
- Amazon CloudWatch, GenAI Observability et Amazon Bedrock Evaluations pour le suivi et l’évaluation.
- Pandas, statsmodels et pypdf pour préparer les séries financières, calculer les statistiques et extraire les documents.
Données
- Un univers de 35 actions et fonds, avec des prix quotidiens transformés en rendements hebdomadaires exprimés en dollars canadiens.
- Des séries de taux américains et canadiens, de pétrole Brent, d’anticipations d’inflation et d’IPC, provenant notamment de FRED et de la Banque du Canada.
- Le taux de change USD/CAD pour analyser l’effet des devises sur les placements américains.
- Des publications de banques centrales, des recherches de la BIS, des fiches d’émetteurs et des rapports annuels.
- Des portefeuilles de démonstration aux compositions définies, ainsi que la possibilité de saisir un portefeuille personnalisé parmi les instruments pris en charge.
Architecture agentique : un pipeline en trois temps
Étape 1 — Mesurer les expositions et les comportements historiques
Le moteur statistique prépare les résultats que l’agent peut consulter :
- Sensibilités historiques : estimation des relations entre les rendements et les facteurs étudiés, avec intervalles de confiance et erreurs standards robustes.
- Contrôles de robustesse : réestimation sans 2022, tests hors échantillon et correction des comparaisons multiples.
- Comparaison des facteurs : calcul des R² associés séparément aux taux, aux actions et au pétrole. Ces valeurs peuvent se recouvrir et ne s’additionnent pas.
- Analyse obligataire : comparaison des mouvements mesurés avec une approximation fondée sur la duration publiée par l’émetteur.
- Périodes difficiles : identification des semaines de baisse boursière et de hausse marquée des taux, avec trois jeux de seuils.
- Analyse par portefeuille : examen des pertes maximales, des mauvaises semaines et du comportement des positions pendant ces périodes.
Ces résultats décrivent le passé. Une relation statistique ne suffit pas à démontrer un lien de causalité.
Étape 2 — Relier les résultats aux documents
Le pipeline documentaire extrait et organise les passages susceptibles d’expliquer les mécanismes économiques observés.
Les enregistrements conservent les informations disponibles sur le document : éditeur, date, URL, extrait et catégorie de source. Ils sont préparés pour la recherche dans une Knowledge Base Bedrock et pour leur consultation via Athena.
Les documents permettent notamment d’examiner :
- Le lien entre inflation et comportement conjoint des actions et des obligations.
- Le rôle des taux et de la duration dans les variations obligataires.
- L’exposition des entreprises aux coûts du carburant, aux prix de vente et au crédit.
- Le rôle du dollar américain dans les placements non couverts contre le change.
La catégorie de source renseigne sur son origine. Elle ne remplace pas la vérification du passage et de son contexte.
Étape 3 — Construire une réponse adaptée à la question
L’agent reçoit la question et les paramètres du portefeuille, puis :
- Sélectionne les fonctions pertinentes, telles que
get_portfolio_facts,test_shield,run_scenarioou la recherche documentaire. - Récupère les résultats produits par les outils Python et les requêtes Athena.
- Distingue les observations mesurées des explications documentaires.
- Présente une conclusion, les chiffres utiles et, lorsqu’il est disponible, l’impact monétaire du scénario.
- Adapte le vocabulaire et le niveau de détail au mode Beginner ou Expert.
Capacités agentiques clés
- Questions directement exploitables : analyser les facteurs associés au portefeuille, examiner le comportement des obligations ou explorer un choc de taux ou de pétrole.
- Sélection des outils : l’agent choisit les analyses nécessaires à la question au lieu de restituer systématiquement toutes les données.
- Calculs séparés de la rédaction : les outils produisent les résultats numériques ; le modèle les organise et les explique.
- Traçabilité : les réponses peuvent présenter les appels d’outils, les résultats structurés et les références documentaires.
- Scénarios encadrés : variations du Brent de −30 %, −15 %, +15 % ou +30 %, et scénarios de taux pris en charge par l’application.
- Explications progressives : une lecture simple pour comprendre le résultat et une lecture experte pour examiner les statistiques.
- Évaluation : une suite déterministe de 27 cas contrôle notamment les réponses chiffrées, les citations et les refus. Le rapport enregistré obtient 26 réussites sur 27 ; les six cas de refus ont réussi. Le dispositif comprend également la préparation des évaluations dans Amazon Bedrock Evaluations.
Architecture autour de l’agent
Les demandes sont traitées en arrière-plan afin de permettre à l’interface d’afficher leur état pendant l’analyse.
Amplify → API Gateway Le frontend transmet la question, le portefeuille et le niveau d’explication. Des limites de débit encadrent les demandes.
Lambda submit → DynamoDB et SQS La fonction enregistre une tâche, l’ajoute à la file de traitement et retourne immédiatement son identifiant.
SQS → Lambda worker Le worker récupère la tâche et appelle l’agent hébergé sur AgentCore Runtime. Une file de lettres mortes est prévue pour les messages qui épuisent leurs tentatives de traitement.
Agent Strands → Bedrock et outils L’agent utilise Claude sur Bedrock, avec les garde-fous configurés. Il sollicite la Lambda d’outils pour interroger Athena et la Knowledge Base pour rechercher les passages documentaires.
Retour du résultat → DynamoDB Le worker prépare la réponse, les citations, les données destinées aux graphiques et la trace des outils, puis enregistre le résultat.
Lambda status → Interface Le frontend consulte périodiquement l’état de la tâche. Il affiche ensuite l’explication et les résultats disponibles. Les détails des appels d’outils sont ajoutés à leur réception, avec la réponse de l’agent.
Fonctions transversales
- Cache : réutilisation de certaines réponses de démonstration selon l’expérience, le portefeuille et le niveau demandé.
- Sécurité : rôles IAM par composant, contrôle de l’accès aux tâches et limitation des requêtes.
- Observabilité : suivi des exécutions, erreurs, appels et performances avec CloudWatch et GenAI Observability.
Expérience utilisateur
L’application rassemble quatre espaces complémentaires :
- Agent : poser une question et examiner la réponse ainsi que les outils utilisés.
- Portfolio : sélectionner un portefeuille de démonstration, modifier les positions autorisées et sauvegarder des compositions.
- Statistics : consulter la sensibilité d’un actif, son intervalle de confiance et les contrôles disponibles.
- Sources : rechercher les documents, lire les extractions et consulter les informations de provenance.
Les portefeuilles de démonstration disposent des analyses historiques les plus complètes. Pour les portefeuilles personnalisés, les fonctions accessibles dépendent des données et des calculs disponibles.
Impact
AION rend accessibles des questions que l’investisseur peut difficilement examiner à partir d’un simple relevé de compte :
- Quels facteurs sont associés à mes variations ? Comparer les relations historiques avec les taux, les actions et le pétrole.
- Mes obligations ont-elles amorti les baisses ? Examiner leur comportement pendant les périodes définies par l’analyse.
- Que donne un scénario de taux ou de pétrole ? Consulter un impact conditionnel, sans le confondre avec une prévision.
- Quelle est la fiabilité de cette estimation ? Examiner les intervalles et les contrôles statistiques disponibles.
- Sur quoi repose l’explication ? Retrouver les résultats d’outils et les documents cités.
L’objectif est de permettre à l’utilisateur de comprendre et d’interroger les résultats, sans lui dicter une décision d’investissement.
Défis rencontrés
Définir un périmètre utile
Le projet a commencé par l’exposition au pétrole. L’analyse a ensuite intégré les taux, les actions et les devises pour mieux répondre aux questions portant sur l’ensemble du portefeuille. Le défi a été de conserver des questions précises, reliées à des outils et à des données disponibles.
Respecter les différences entre les analyses
Les mauvaises semaines du marché ne correspondent pas nécessairement aux mauvaises semaines d’un portefeuille. De même, une relation faible avec le pétrole ne signifie pas une absence de risque. Le projet doit conserver ces distinctions dans les calculs, les graphiques et les explications.
Préserver la traçabilité
Les statistiques, les scénarios et les extraits documentaires ont des fonctions différentes. Leur intégration demande de conserver les unités, les périodes, les identifiants et les métadonnées, tout en signalant les informations manquantes.
Rendre l’agent utilisable
Le traitement asynchrone, le suivi des tâches, les limites de débit et les évaluations permettent d’encadrer l’expérience. Le frontend doit ensuite rendre ces résultats lisibles : une question claire, une réponse structurée, des outils accessibles et des sources consultables.
Built With
- amazon-api-gateway
- amazon-athena
- amazon-bedrock
- amazon-cloudwatch
- amazon-dynamodb
- amazon-sqs
- amazon-web-services
- aws-amplify
- aws-glue
- aws-lambda
- bedrock-agentcore
- bedrock-evaluations
- bedrock-guardrails
- bedrock-knowledge-bases
- claude
- kiro
- llm-as-a-judge
- pandas
- python
- rag
- sagemaker
- sql
- statsmodel
- strands-agents
